


Is Conditional Generative Modeling all you need for Decision Making?
1.引言
条件生成建模
条件生成建模是一种机器学习技术,用于生成数据样本,这些样本基于给定的条件或上下文。它与传统的生成模型不同,后者生成数据而不依赖于任何条件或输入。条件生成建模常见于深度学习,特别是在生成对抗网络(GANs)和变分自编码器(VAEs)中。这种方法在图像合成、文本生成、语音合成等领域表现出色。它使模型能够在给定特定条件(如标签、描述或其他数据点)的情况下,生成更加精准和特定的输出。
传统强化学习面临的挑战
- 样本效率低:强化学习通常需要大量的数据才能学习有效的策略,这在现实世界应用中是一个重大障碍。
- 稀疏奖励问题:在很多情况下,有效的反馈(奖励)很少,使得学习过程变得困难。
- 探索与利用的平衡:决定何时探索新策略和何时利用已知策略是强化学习中的关键问题。
- 环境模型的复杂性:对于复杂或不确定的环境,建立一个准确的模型非常挑战,这限制了算法的有效性。
- 泛化能力:强化学习模型在从训练环境到新环境转移时,泛化能力往往有限。
作者的研究动机与创新点
探索条件生成建模在顺序决策制定中的应用,特别是在离线强化学习的环境下。作者认为,通过使用条件生成模型(如扩散模型),可以绕过传统离线强化学习中的复杂动态规划过程,并解决价值函数估计的不稳定性等问题。
论文的创新点在于提出了一种名为**“决策扩散器”(Decision Diffuser)的框架**,它使用条件扩散模型来进行决策生成。这种方法不仅可以最大化回报,还可以灵活地结合多种约束和技能,以产生新的行为。这种方法在实验中显示出优于传统方法的性能,展示了条件生成模型在决策制定中的潜力。
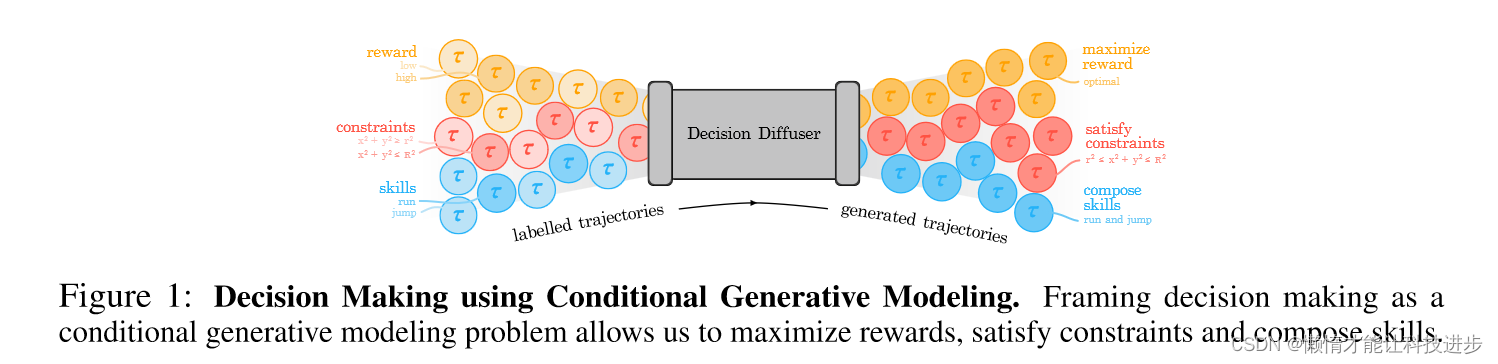
图中展示了利用条件生成模型进行决策制定的框架。在这个框架中,决策扩散器(Decision Diffuser)作为核心组件,接受不同类型的输入并生成轨迹。具体来说,图中的内容可以解释如下:
-
有标签的轨迹(Labelled Trajectories):
- 有标签的轨迹是训练数据,包含了不同的条件,如回报(reward)、约束(constraints)和技能(skills)。
- 这些轨迹按照它们所实现的目标或属性进行了分类。例如,回报可以是低(low)或高(high);约束可以是数学表达式如 x 2 + y 2 ≤ r 2 x^2 + y^2 \leq r^2 x2+y2≤r2;技能可以是运行(run)或跳跃(jump)。
-
决策扩散器(Decision Diffuser):
- 决策扩散器是一个条件生成模型,它使用有标签的轨迹来学习如何生成满足特定条件的新轨迹。
- 它可以同时考虑多个条件,如最大化回报,满足特定的约束,以及组合不同的技能。
-
生成的轨迹(Generated Trajectories):
- 生成的轨迹是模型输出的结果,它们应该反映输入条件的组合。
- 这些轨迹旨在实现特定的目标,如最大化回报(maximize reward)、满足特定的约束(satisfy constraints),以及组合技能(compose skills)。
总体来说,这幅图表展示了如何将决策制定问题框架化为一个条件生成建模问题,通过这种方式可以最大化回报,满足约束,并组合不同的技能。这种方法允许使用机器学习的方法来自动化和优化复杂决策过程。
2.重要概念
强化学习
是一种机器学习方法,它使智能体能够在环境中做出决策以最大化累积奖励。它包括以下关键概念:
- 智能体(Agent):进行决策的实体。
- 环境(Environment):智能体交互的系统。
- 状态(State):环境的当前情况。
- 行为(Action):智能体可以执行的操作。
- 奖励(Reward):智能体行为的即时反馈。
- 策略(Policy):智能体选择行为的规则。
智能体通过探索环境并学习从状态到行为的最佳映射来优化其策略,从而在长期内最大化累积奖励。强化学习在游戏、机器人导航、资源管理等领域有广泛应用。
扩散概率模型
扩散概率模型是一种用于生成数据的机器学习模型,它模拟了一种从无序状态(如高斯噪声)逐步生成有序数据(如图像或文本)的过程。这个过程类似于物理中的扩散过程,从而得名。扩散模型通过逐步减少噪声并逐步引入数据特征的方式工作,最终生成高质量的数据样本。这种方法已经被证明在生成高复杂度和高质量的数据方面非常有效,例如在图像和音频合成中。
扩散概率模型中的关键公式包括:
-
噪声添加公式:它描述了如何逐步将噪声添加到数据中。这通常是通过线性插值的形式实现的,如 x t = α t x t − 1 + 1 − α t ϵ x_t = \sqrt{\alpha_t} x_{t-1} + \sqrt{1 - \alpha_t} \epsilon xt=αtxt−1+1−αtϵ,其中 ϵ \epsilon ϵ是高斯噪声, α t \alpha_t αt是时间步t的噪声比例。
-
逆过程公式:在逆过程中,模型试图预测并去除噪声。这个过程的一个关键部分是估算给定噪声数据下的原始数据分布,通常表示为 p ( x t − 1 ∣ x t ) p(x_{t-1}|x_t) p(xt−1∣xt)。
这些公式是建立扩散模型的基础,涉及概率论和统计学的概念,特别是在处理高斯分布时。模型的训练和优化通常依赖于这些数学表达式。
传统的强化学习到生成建模的转变
体现在几个关键方面:
- 目标变化:在传统RL中,目标是学习一个策略或价值函数来指导行为。而在生成建模中,目标是直接从环境数据中学习决策的概率分布。
- 数据处理:生成建模强调从大量数据中学习模式,而不是专注于单个状态或行动的最优选择。
- 泛化能力:生成模型通常能更好地泛化到新的、未见过的环境状态,这在传统RL中是个挑战。
- 复杂环境处理:生成模型能更有效地处理高维度和复杂的环境,这在传统方法中往往更为困难。
本文提出方法的总体框架
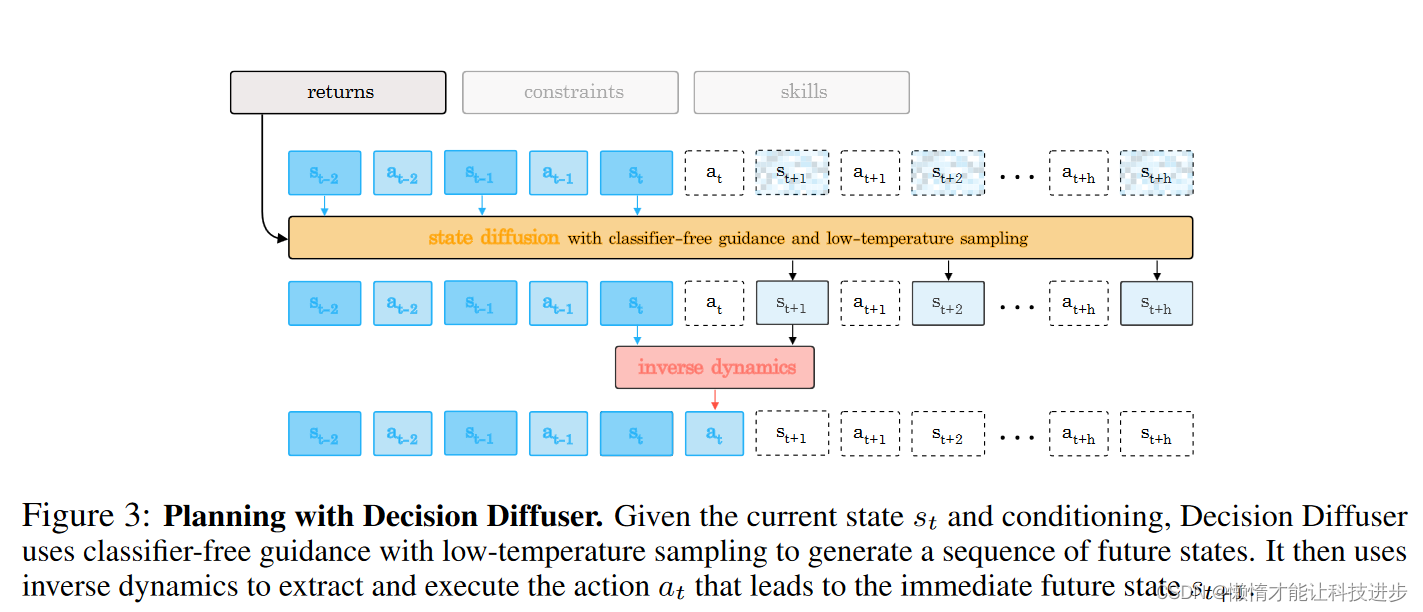
图中描绘了使用决策扩散器(Decision Diffuser)进行规划的过程。以下是该过程的详细解释:
-
输入条件:图中最上方的框表示输入条件,包括回报(returns)、约束(constraints)和技能(skills),这些条件用于指导决策扩散器生成特定特性的未来状态序列。
-
状态扩散(State Diffusion):黄色框代表状态扩散过程,它使用无分类器指导(classifier-free guidance)和低温度采样(low-temperature sampling)来生成一系列未来的状态。无分类器指导是一种避免使用显式分类器的生成方法,而低温度采样则使得生成的状态更加集中于高概率区域,从而提高生成质量。
-
逆向动力学(Inverse Dynamics):红色框代表逆向动力学模型,它用于从状态序列中提取和执行动作。具体来说,它根据当前状态 s t s_t st和下一个状态 s t + 1 s_{t+1} st+1来确定应该执行的动作 a t a_t at。
-
状态和动作序列:蓝色框表示已知的状态和动作序列。每个状态 s s s都对应一个动作 a a a,并且状态之间通过动作相互连接。决策扩散器计划的目标是产生一个未来的状态序列,从 s t s_t st 到 s t + h s_{t+h} st+h,其中 h h


 1249


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


