hdfs原理

HDFS 原理分析 客户端拿到数据存放节点位置信息后,会和对应的DataNode节点进行直接交互,进行数据写入,由于数据块具有副本replication,在数据写入时采用的方式是先写第一个副本,写完后再从第一个副本的节点将数据拷贝到其它节点,依次类推,直到所有副本都写完了,才算数据成功写入到HDFS上,副本写入采用的是串行,每个副本写的过程中都会逐级向上反馈写进度,以保证实时知道副本的写入情况;、NameNode会将子节点的相关元数据信息缓存在内存中,对于文件与Block块的信息会通过。 阅读详情

简介

HDFS(Hadoop Distributed File System )Hadoop分布式文件系统。是根据google发表的论文翻版的。论文为GFS(Google File System)Google 文件系统。

HDFS有很多特点:

① 保存多个副本,且提供容错机制,副本丢失或宕机自动恢复。默认存3份。
(用空间换安全)
② 运行在廉价的机器上。
③ 适合大数据的处理。多大?多小?HDFS默认会将文件分割成block,128M为1个block。然后将block按键值对存储在HDFS上,并将键值对的映射存到内存中(namenode)。如果小文件太多,那内存的负担会很重。
在这里插入图片描述
如上图所示,HDFS也是按照Master和Slave的结构。分NameNode、SecondaryNameNode、DataNode这几个角色。

NameNode:是Master节点,是管理者。管理数据块映射;处理客户端的读写请求;配置副本策略;管理HDFS的名称空间;
NameNode保存的metadata包括文件ownership和permission文件包含的block信息
Block保存在那些DataNode节点上(这部分数据并非保存在NameNode磁盘上的,它是在DataNode启动时上报给NameNode的,Name接收到之后将这些信息保存在内存中)
NameNode的metadata信息在NameNode启动后加载到内存中
Metadata存储到磁盘上的文件名称为fsimage
Block的位置信息不会保存在fsimage中
Edits文件记录了客户端操作fsimage的日志,对文件的增删改等。
用户对fsimage的操作不会直接更新到fsimage中去,而是记录在edits中

SecondaryNameNode:分担namenode的工作量;是NameNode的冷备份;合并fsimage和fsedits然后再发给namenode。
合并fsimage和fsedits文件,然后发送并替换NameNode的fsimage文件,同时自己留下一个副本。这个副本可供NameNode毁灭之后的部分文件恢复。
1可以通过配置fs.checkpoint.period修改合并间隔时间,默认1小时
2也可以通过配置edits日志文件的大小,fs.checkpoint.size规定edits文件的最大值,来让SecondaryNameNode来知道什么时候该进行合并操作了。默认是64M

合并过程如下:

在这里插入图片描述
DataNode:Slave节点,奴隶,干活的。负责存储client发来的数据块block;执行数据块的读写操作。

热备份:b是a的热备份,如果a坏掉。那么b马上运行代替a的工作。

冷备份:b是a的冷备份,如果a坏掉。那么b不能马上代替a工作。但是b上存储a的一些信息,减少a坏掉之后的损失。

fsimage:元数据镜像文件(文件系统的目录树。)

edits:元数据的操作日志(针对文件系统做的修改操作记录)

namenode内存中存储的是=fsimage+edits。

SecondaryNameNode负责定时默认1小时,从namenode上,获取fsimage和edits来进行合并,然后再发送给namenode。减少namenode的工作量。

HDFS优点

高容错性

数据自动保存多个副本
副本丢失后,自动回复

适合批处理:不适合实时性一些需求的时候

流处理:近实时的需求
移动的计算和操作
数据位置暴漏给计算框架

适合大数据处理
GB、TB、PB甚至更大
百万规模以上的文件数量
10K+节点

可构建在廉价的机器上
通过副本提高可靠性
提供了容错和恢复机制

HDFS缺点(做不到的)

低延迟数据访问

毫秒级读取
低延迟与高吞吐量

小文件存取
占用NameNode内存空间
寻址时间超过读取时间
并发写入、文件随即修改
一个文件同时只能由一个写入者
仅支持append


工作原理

写操作:
在这里插入图片描述

在这里插入图片描述
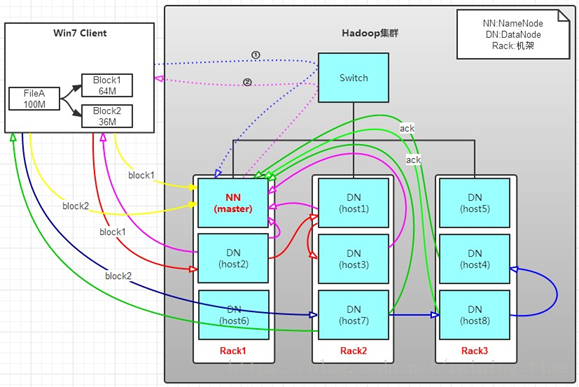
有一个文件FileA,100M大小。Client将FileA写入到HDFS上。
HDFS按默认配置。
HDFS分布在三个机架上Rack1,Rack2,Rack3。

a. Client将FileA按64M分块。分成两块,block1和Block2;
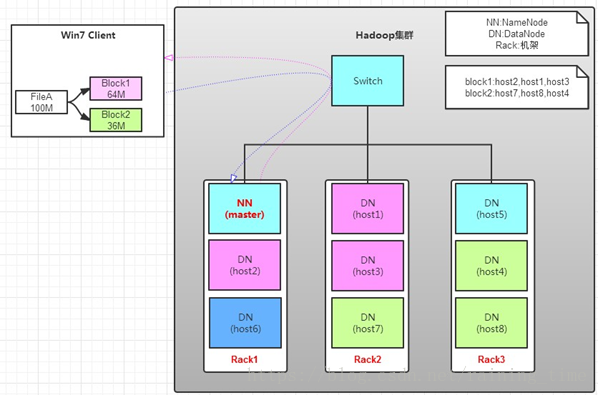
b. Client向nameNode发送写数据请求,如图蓝色虚线①------>。
c. NameNode节点,记录block信息。并返回可用的DataNode,如粉色虚线②--------->。
Block1: host2,host1,host3
Block2: host7,host8,host4

原理:
    NameNode具有RackAware机架感知功能,这个可以配置。
    若client为DataNode节点,那存储block时,规则为:副本1,同client的节点上;副本2,不同机架节点上;副本3,同第二个副本机架的另一个节点上;其他副本随机挑选。
    若client不为DataNode节点,那存储block时,规则为:副本1,随机选择一个节点上;副本2,不同副本1,机架上;副本3,同副本2相同的另一个节点上;其他副本随机挑选。

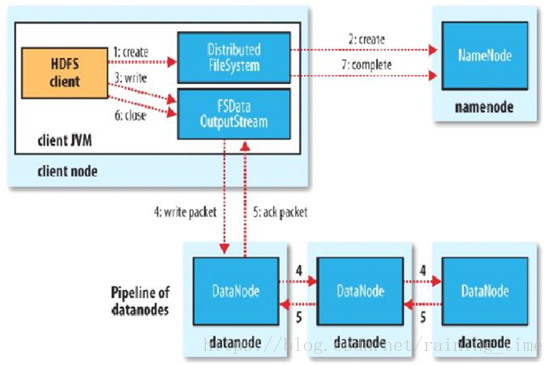
d. client向DataNode发送block1;发送过程是以流式写入。

流式写入过程,
1>将64M的block1按64k的package划分;
2>然后将第一个package发送给host2;
3>host2接收完后,将第一个package发送给host1,同时client想host2发送第二个package;
4>host1接收完第一个package后,发送给host3,同时接收host2发来的第二个package。
5>以此类推,如图红线实线所示,直到将block1发送完毕。
6>host2,host1,host3向NameNode,host2向Client发送通知,说“消息发送完了”。如图粉红颜色实线所示。
7>client收到host2发来的消息后,向namenode发送消息,说我写完了。这样就真完成了。如图黄色粗实线
8>发送完block1后,再向host7,host8,host4发送block2,如图蓝色实线所示。
9>发送完block2后,host7,host8,host4向NameNode,host7向Client发送通知,如图浅绿色实线所示。
10>client向NameNode发送消息,说我写完了,如图黄色粗实线。。。这样就完毕了。

分析,通过写过程,我们可以了解到:
①写1T文件,我们需要3T的存储,3T的网络流量带宽。
②在执行读或写的过程中,NameNode和DataNode通过HeartBeat进行保存通信,确定DataNode活着。如果发现DataNode死掉了,就将死掉的DataNode上的数据,放到其他节点去。读取时,要读其他节点去。
③挂掉一个节点,没关系,还有其他节点可以备份;甚至,挂掉某一个机架,也没关系;其他机架上,也有备份。

读操作:
在这里插入图片描述
在这里插入图片描述
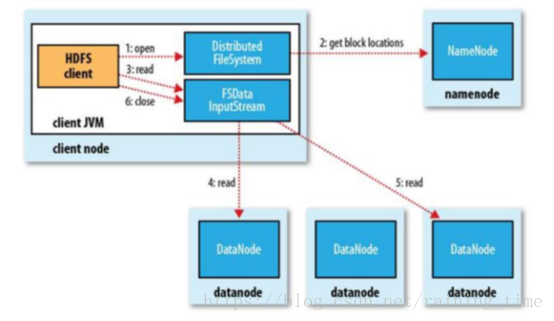
读操作就简单一些了,如图所示,client要从datanode上,读取FileA。而FileA由block1和block2组成。

那么,读操作流程为:
a. client向namenode发送读请求。
b. namenode查看Metadata信息,返回fileA的block的位置。
block1:host2,host1,host3
block2:host7,host8,host4
c. block的位置是有先后顺序的,先读block1,再读block2。而且block1去host2上读取;然后block2,去host7上读取;

上面例子中,client位于机架外,那么如果client位于机架内某个DataNode上,例如,client是host6。那么读取的时候,遵循的规律是:
优选读取本机架上的数据。

HDFS文件权限

与Linux文件权限类似
r:read;w:write;x:execute

如果Linux系统用用户xxx使用hadoop命令创建一个文件,那么,在hdfs中这个文件的owner就是xxx

HDFS的权限目的是将控制权交出去,本身只判断用户和权限,至于用户是不是真的,不管。

HDFS安全模式

NameNode启动的时候,首先讲fsimage载入内存,然后按照fsedits中的各项操作修改内存中的fsimage。

当元数据文件在内存中创建完成之后,在NameNode上创建一个新的fsimage替换原fsimage,同时创建一个空的fsedits文件(无需SecodaryNameNode参与)
这时,NameNode是运行在安全模式的。即对外(客户端)只读,所以此段时间内对hdfs的写入、删除、重命名都会失败。

然后NameNode收集各个DataNode的报告,当block达到最小副本数以上时,会被认为“安全”的了,在一定比例的数据块被确定为“安全”后,再过若干事件后,安全模式结束。

当检测到副本数不足的数据块时,该块会被复制,直到达到最小副本数。

Hdfs中数据块的位置并不是由namenode维护的,而是以块列表的形式存储在datanode中的。


HDFS中常用到的命令

1、hdfs fs

hdfs fs -ls /
hdfs fs -lsr
hdfs fs -mkdir /user/hadoop
hdfs fs -put a.txt /user/hadoop/
hdfs fs -get /user/hadoop/a.txt /
hdfs fs -cp src dst
hdfs fs -mv src dst
hdfs fs -cat /user/hadoop/a.txt
hdfs fs -rm /user/hadoop/a.txt
hdfs fs -rmr /user/hadoop/a.txt
hdfs fs -text /user/hadoop/a.txt
hdfs fs -copyFromLocal localsrc dst 与hadoop fs -put功能类似。
hdfs fs -moveFromLocal localsrc dst 将本地文件上传到hdfs,同时删除本地文件。

2、hdfs fsadmin

hdfs dfsadmin -report
hdfs dfsadmin -safemode enter | leave | get | wait
hdfs dfsadmin -setBalancerBandwidth 1000

3、hdfs fsck

4、start-balancer.sh

负载均衡,可以使DataNode节点上选择策略重新平衡DataNode上的数据块的分布

HADOOP 离线计算机系统【二】HDFS详解 HDFS详解******HDFS基本概念篇******1.HDFS前言2. HDFS的概念和特性******HDFS基本操作篇******3. HDFS的shell(命令行客户端)操作3.1 HDFS命令行客户端使用3.2 命令行客户端支持的命令参3.2 常用命令参数介绍******HDFS原理篇******4.hdfs的工作机制**详细请看 :HDFS 详解:** [https://blog.youkuaiyun.com/wzq18845280610/article/details/110188742](https: 阅读详情

相关推荐

HDFS 之 Topology(Rack) Awareness - 机架感知

机架感知在大型分布式存储系统中非常实用,可以有效保证数据的高可用,同时提升集群稳定性。在HDFS中,也实现了类似Topology Awareness的机制,只不过是采用软件的方式模拟。

qwerty1372431588的博客 396

Hadoop原理之——HDFS原理

  Hadoop 3个核心组件: 分布式文件系统:Hdfs——实现将文件分布式存储在很多的服务器上(hdfs是一个基于Linux本地文件系统上的文件系统) 分布式运算编程框架:Mapreduce——实现在很多机器上分布式并行运算 分布式资源调度平台:Yarn——帮用户调度大量的mapreduce程序,并合理分配运算资源   HDFS的设计特点是: 1、大数据文件,非常适合上T级别的大文件或者一堆大数据文件的存储,如果文件只有几个G甚至更小就没啥意思了。 2、文件分块存储,H..

weixin_41153425的博客 3729

SAP ABAP VL09 BAPI VL 216

ls_batch_item-fact_unit_denom = ls_lips_split-umvkn. "销售数量转换为 SKU 的值(分母)ls_batch_item-fact_unit_nom = ls_lips_split-umvkz. "销售数量转换成SKU的分子(因子)ls_batch_item-sales_unit_iso = ls_lips_split-meins. "被拆分DN基本单位。

ChampaignWolf的专栏 2299

HDFS工作原理

一、HDFS 组成架构 1)NameNode(nn):就是Master,它是一个主管、管理者。 (1)管理HDFS的名称空间 (2)配置副本策略 (3)管理数据块(Block)映射信息 (4)处理客户端读写请求。 2)DataNode:就是Slave。NameNode下达命令,DataNode执行实际的操作。 (1)存储实际的数据块 (2)执行数据块的读/写操作。 3)Client:就是客户端。 (1)文件切分。文件上传HDFS的时候,Client将文件切分成一个一个的Block

NC_NE的博客 3469

CMap数据库学习及结果可视化

CMap是一个生物信息学数据库和工具,旨在通过比较基因表达谱来揭示药物、基因和疾病之间的潜在关联。CMap数据库主要用于寻找药物、化合物和生物过程之间的关系,并用于药物重定位(drug repurposing)和疾病机制研究。

zfyyzhys的博客 5599

解决usbisp不识别无法烧录Atmega328P,Arduino不识别问题

如果使用Arduino IDE里面的烧录,可能会遇到一个问题,就是不识别国产这种廉价的USBISP 点击烧录引导程序,会遭遇到找不到USB设备的问题,选哪个都会提示找不到,比如选择USBasp could not find USB device with vid=0x16c0 pid=0x5dc vendor='www.fischl.de' product='USBasp' 因此,我们需要使用到progisp这一个软件的1.72版本 选择好芯片的型号后,调用编译好的HEX文...

arenascat的博客 7436

HDFS基本原理及数据存取实战

--------------------------------------------------------------------------------------------------------------- [版权申明:本文系作者原创,转载请注明出处] 文章出处:http://blog.youkuaiyun.com/sdksdk0/arti...

weixin_33860553的博客 1055

CloudCompare点云滤波实战:三种植被去除技术的对比与应用

本文详细对比了CloudCompare中三种植被去除技术(低通滤波、CSF滤波和坡度法)的实战应用与效果。通过具体案例和参数优化建议,帮助用户根据地形特征选择最佳滤波方法,提升点云数据处理精度和效率,特别适用于复杂场景下的植被去除需求。

weixin_30689307的博客 84

简单理解HDFS原理

HDFS是分布式文件系统,专为存储处理海量数据设计。其核心架构包括唯一NameNode(管理元数据)和多个DataNode(存储数据块)。工作原理是将大文件切分为128MB的块,默认复制3份存储于不同节点,实现负载均衡与容错。具有"一次写入多次读取"特性,强调高吞吐而非低延迟,采用移动计算而非移动数据的理念。系统自动检测故障并复制缺失副本,确保数据完整性。HDFS通过普通硬件集群提供高可靠存储,广泛应用于日志分析、数据仓库等大数据场景,是构建大数据技术栈的基础组件。

Xuepaoa的博客 2276

YOLOv11火焰识别:从环境搭建到GUI部署的完整工程实践

目标检测是计算机视觉的核心任务之一,它通过定位和分类图像中的物体,为机器赋予“看懂”世界的能力。其原理通常基于深度学习模型,如YOLO系列,通过卷积神经网络提取特征并预测边界框与类别。这项技术的价值在于将算法能力转化为实际生产力,广泛应用于安防监控、工业质检、自动驾驶等场景。在工程实践中,环境配置的稳定性与数据质量往往决定项目成败,而模型部署的易用性直接影响最终用户体验。本文以火焰识别这一具体应用为切入点,详细解析了如何利用YOLOv11完成从零到产品化的全链路流程,其中涉及Conda虚拟环境管理、PyTo

weixin_29483277的博客 234

快手did did_gt edid的注册过程

接口 https://gdfp.ksapisrv.com/rest/infra/gdfp/report/kuaishou/android did 是本地生成的16进制 或者 获取的 android_id did_gt 是did生成时间戳 1595073601970 public static final Random f16237a = new Random(System.currentTimeMillis()); public static long m19668a() {  &n

HURUWO的技术博客 1万+

HDFS 原理 详解

HDFS重要特性--主从架构这是HDFS是Hadoop 核心重要的组件之一 , 解决大数据计算中的海量存储数据下面是HDFS原理 架构 以及模块组成提示:以下是本篇文章正文内容,下面案例可供参考传统情况零拷贝技术:DMA 将一个内存区从一个设备复制到另一个, 当中央处理器初始化这个传输动作,传输动作本身是由DMA控制器来实行和完成1 HDFS是Hadoop Distribute File System 的简称,意为:Hadoop分布式文件系统。

m0_66882197的博客 1690

Anolis 8系统下,手把手搞定Nginx、Redis、JDK8和Tomcat9的完整安装与配置(含开机自启)

本文详细介绍了在Anolis 8系统下搭建Java Web全栈环境的完整流程,包括JDK8、Tomcat9、Nginx和Redis的安装与配置,并实现系统级服务管理。通过深入每个组件的配置细节,揭示服务间的协同关系,最终打造一个生产级可用的标准化环境。

weixin_42556197的博客 158

HDFS的存储原理

在hdfs中,文件是被划分了一堆堆的block块,那如果文件很大、以及文件很多,Hadoop是如何记录和整理文件和block块的关系呢?对于已经存在HDFS的文件,修改dfs.replication属性不会生效,如果要修改已存在文件可以通过命令。edits文件,是一个流水账文件,记录了hdfs中的每一次操作,以及本次操作影响的文件其对应的block。除了配置文件外,我们还可以在上传文件的时候,临时决定被上传文件以多少个副本存储。将全部的edits文件,合并为最终结果,即可得到一个FSImage文件。

weixin_49107940的博客 1621

【报错解决】OpenClaw 报错 FetchError: request to [https://registry.npmjs.org/](https://registry.npmjs.or

在国产基础软件与云原生生态逐步成熟的背景下,越来越多的开发者开始尝试将 Web 前端、AI 推理、系统服务等组件部署到国产操作系统与国产云环境中。我所在的项目正是这样一个场景: 我们基于 OpenClaw 构建一套云端 AI 管理平台,用于统一管理模型服务、前端控制台与后台 API。

博客 1753

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

HDFS原理

1 概述HDFS集群分为两大角色:NameNode、DataNodeNameNode负责管理整个文件系统的元数据(文化的一些信息)DataNode 负责管理用户的文件数据块文件会按照固定的大小(blocksize)切成若干块后分布式存储在若干台datanode上每一个文件块可以有多个副本,并存放在不同的datanode上Datanode会定期向Namenode汇报自身所保存的文件block信息,而...

故人西辞帝都去 493

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

HDFS的基本原理

HDFS 架构原理HDFS采用master/slave架构。一个HDFS集群包含一个单独的NameNode和多个DataNode。Namenode管理文件系统的元数据,而Datanode存储了实际的数据。 一.NameNode概述 1.NameNode是HDFS的核心 2.NameNode也称为Master。 3.NameNode仅存储HDFS的元数据:文件系统中所有文件的目录树,并跟踪整个集群中的文件。 3.NameNode不存储实际数据或数据集。数据本身实际存储在DataNodes中。 4.NameNo

weixin_51999257的博客 443

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

HDFS SnapShot原理

【简介】 HDFS快照简单地说就是对某个文件夹进行备份,创建了快照的文件夹本身不能被删除,但是文件夹里面的文件和文件夹都是可以被删除的。在对一个文件夹创建快照之前,需先允许该文件夹可以创建快照 允许快照hdfs dfsadmin -allowSnapshot <path> 创建快照hdfs dfs -createSnapshot <path> [<snapshot...

ywl470812087的博客 11万+

简述hdfs工作原理_简述HDFS的原理?

Hadoop分布式文件系统(HDFS)是一种被设计成适合运行在通用硬件上的分布式文件系统。HDFS是一个高度容错性的系统,适合部署在廉价的 机器上。它能提供高吞吐量的数据访问,非常适合大规模数据集上的应用。要理解HDFS的内部工作原理,首先要理解什么是分布式文件系统。1、分布式文件系统多台计算机联网协同工作(有时也称为一个集群)就像单台系统一样解决某种问题,这样的系统我们称之为分布式系统。分布式文...

weixin_33480732的博客 2470

HDFS基本的原理

一、HDFS简介 Hadoop分布式文件系统(HDFS)被设计成适合运行在通用硬件(commodity hardware)上的分布式文件系统。HDFS体系结构中有两类节点,一类是NameNode,又叫"元数据节点";另一类是DataNode,又叫"数据节点"。这两类节点分别承担Master和Worker具体任务的执行节点。总的设计思想:分而治之——将大文件、大批量文件,分布式存放在大量独立的服务器...

weixin_44961645的博客 8239
下一篇: spark运行架构
raining_time
博客等级 码龄11年 0粉丝 2原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值