爬取人民邮电新书30页的图书信息

今日头条爬虫实战----爬取图片 点击上方“蓝字”关注我们今日头条爬虫实战Mar 27, 2020本期介绍通过在头条中搜索关键词后,分析ajax内容来爬取相关图片本文约1.8k字,预计阅读10分钟。有时候我们在用 「re... 阅读详情

爬取人民邮电新书30页的图书信息 具体网址:http://ryjaoyu.com//

遇见的问题:

一: 有些图书信息没有价格,
二: 作者有多个
三: 最后一页的图书信息并不完全 。

本次采用xpath的方式:直接上图
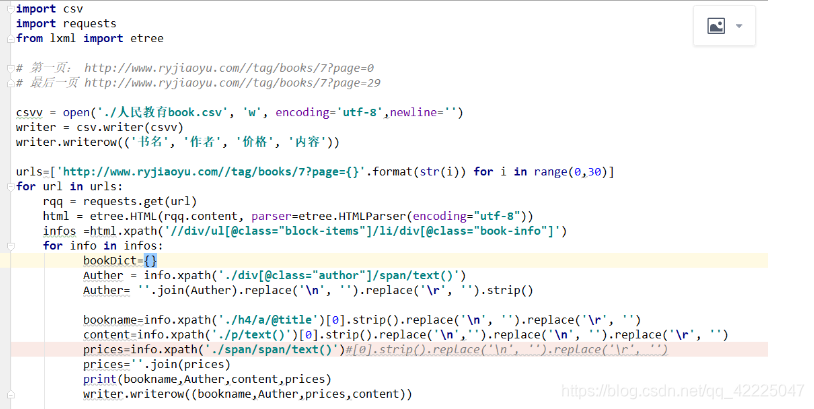
在这里插入图片描述
完成后的感悟:
可以通过列表解析的方式 传入url的30页的具体地址
需要记住的是:在遍历当前节点下面的时候 一定不要用 //(注://是匹配所有)
replace 和 strip() 的区别:
replace 可以全部清除, strip() 只能清楚字符串 的前面和后面的\n\t
’ ‘.join函数 :可以将列表转换位字符串 。 分隔符就为’ ’

Python网络爬虫之动态网络爬取(一) ** 1 Selenium及其他插件安装 ** 1.1 Selenium + PhantomJS T 由于目前最新的SeleniumE经放弃PhantomJs,所以大家在安装时首先要查看下你所安装的Selenium版本信息,在命令行(终端)中输入以下指令来查看Selenium的版本信息: pip show selenium 如果发现你的版本248.0,需要执行以下操作进行卸载重装Selenium ... 阅读详情

相关推荐

python网络爬虫——爬取人民邮电出版社新书推荐信息

这段代码是一个爬取人民邮电出版社新书推荐信息的程序。它使用requests库发送HTTP请求,获取新书列表和每本书的详细信息,然后将数据保存到Excel文件中。具体的步骤如下: 导入所需的库:requests、json和openpyxl。 定义了一个URL变量,用于发送GET请求获取新书推荐列表的数据。 设置请求头信息,包括User-Agent和Cookie。 使用requests库的get()方法发送HTTP请求,并将响应内容解析为JSON格式。 定义了一个函数save_excel(),用于创建Exce

weixin_66547608的博客 1899

爬人邮新书

import requests import pymysql from lxml import etree import csv def getHtml(url): headers = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) ...

qq_43308639的博客 352

数据采集(基础学习).docx

1、爬取人民邮电出版社图书列表 2、百度热点新闻 3、百度学习元素定位 4、使用BeautifulSoup解析,有序列表1,2,3,4(data属性里的),并保存到MySQL数据库,数据库为test,表为data(假设已经存在),用户名为root,密码为root。 5、爬取百度首页导航栏的菜单名和菜单地址

python爬虫实战笔记——爬取图书信息(利用selenium库+chromedriver.exe插件)

准备: 1、插件chromedriver.exe 2、已经安装好谷歌浏览器Chrome 编写代码 from bs4 import BeautifulSoup from selenium import webdriver from selenium.webdriver.support.ui import Select,WebDriverWait from selenium.webdriver.common.by import By from selenium.webdriver.support im

zytmaster的博客 997

Unity开发微信小游戏,使用Addressables管理游戏资源(本地进行远程测试)

快速构建Unity微信小游戏 使用Addressables管理游戏资源 使用小皮助手在本地进行远程资源加载测试

the_vnas的博客 6390

控制台模拟前端请求实现快速刷网课时长

本教程仅用于学习前端技术和网页开发,旨在提供教育与技术指导。对于任何未经授权或违反规定的使用行为,本人不承担任何责任。注意到那个serive后面有timestamp时间戳,暗示它很可能就是每30秒汇报一次进度和播放时长的命令,我们右键——复制——复制为fetch。有的网站上的网课需要的不仅仅是进度,而是时长,所以倍速插件失效,但我们可以使用控制台命令来模拟请求实现快速刷网课时长。尝试修改即可,例如我修改time为800,然后复制粘贴到控制台执行。播放视频,等待前端请求出现,然后复制前端请求为fetch。

m0_74823408的博客 2065

python动态爬虫案例

2.切换图书类型,找到调用的新的接口,找到返回的对应类型下的图书信息(预览部分)。注意,在调用该接口时携带了参数。3.打开一本图书,找到对应接口,根据调用接口时携带的bookId参数获取返回的对应图书的具体信息。1.获取能返回bookTagId的接口,将bookTagId获取下来,以便于批量保存图书信息。

qq_63897791的博客 1263

Windows域账户无管理员权限也能装软件?3步搞定UAC设置(附安全提醒)

本文探讨了在Windows域环境中,如何通过配置用户账户控制(UAC)实现临时提权,让无管理员权限的域账户也能安装软件。文章详细介绍了三步走策略:临时加入本地管理员组、调整UAC行为以及至关重要的权限回收,并提供了脚本化部署方案与安全实践指南,旨在平衡企业IT管理的效率与安全。

fox11的博客 756

用Java编写图书网站信息采集程序教程

最近有个公司想要开发新产品,想要找到一些相关产品的功能以及工艺信息,之前有个负责人就通过传统的百度搜索来查找,但是效率太慢,然后请教我问我有什么办法收集这类产品信息以及配套的产品书籍以及信息,这不,饭都请我吃了,我能说不么?

weixin_44617651的博客 732

Gamit 数据处理,相关的文件配置

一、处理前准备 1、在主文件夹内新建test项目文件,项目内新建brdc、igs和rinex三个文件夹,分别存放广播星历,精密星历几观测值文件,所用的命令分别为sh_get_nav、sh_get_orbits和sh_get_rinex (若文件为.Z,用gunzip命令解压,若仍为d,用命令sh_crx2rnx -f 命令解压为o文件) 2、进入test项目文件夹,链接tables,运行 sh_setup -yr 2015 -apr itrf08_com.apr 3、生成station.info文件。 将t

CodeDoraemon的博客 3375

(project generation have a problem)STM32CubeMX生成工程一直报错项目生成有问题[玄学三步解]

解决办法 第一步,检查自己是不是真的配置的不对,JAVA安装没,pack路径设置的对不对,这里有一位前辈的博文写的非常好,附加链接https://blog.youkuaiyun.com/ybhuangfugui/article/details/52225736#commentBox 第二步,如果按照前辈的博文设置的都一模一样,还是不对,想我下图这样。 那你来对地方了 方法很简单,你把你生成工程文件的路径彻底的...

展桑博客-BenjieBlog 2922

爬虫-豆瓣-2021.7.23-书籍排行榜前30页及每页读者和地址信息

1.环境 python3.7 pycharm2020.1 2.准备工作 2.1安装lxml 在cmd模式下, pip install lxml 在cmd模式下测试 python import lxml 如果没有报错,那么就证明库已经安装好了。 2.2安装BeautifulSoup 在cmd模式下 pip install beautifulsoup4 在python编译器中测试 from bs4 import BeautifulSoup soup = BeautifulSo

qq_37245700的博客 373

姿态传感器/陀螺仪之ICM-42670-P应用原理图设计

ICM-42670-P采用LGA-14封装,尺寸为2.5x3x0.76毫米,工作电压范围为1.71V至3.6V,支持I3CSM、I2C和SPI串行通信接口。其设计目标是提供高精度、低功耗和小型化的解决方案,以满足消费类和工业应用的需求。ICM-42670-P是一款由TDK InvenSense推出的高性能六轴MEMS运动追踪传感器,集成了3轴陀螺仪和3轴加速度计,适用于多种应用场景,包括可穿戴设备、游戏控制器、无人机、AR/VR设备等。

corlin6688的博客 1201

爬虫——第二次试验(网站多页爬取代码)

实验目的 熟练掌握requests库中get方法的使用 掌握利用requests库爬取多页网页内容的方法 2.1 爬取百度贴吧与某主题相关的帖子,并将爬取到的内容保存到文件中(爬取多页) import requests def get_page(url): headers = {'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) ...

qq_45083698的博客 1207

手把手教你学simulink(36.1)--ACAC变换器场景示例:基于 Simulink 的矩阵变换器(Matrix Converter)

矩阵变换器(Matrix Converter, MC)是一种直接将交流电(AC)转换为不同频率和幅值的交流电的电力电子设备。与传统的基于直流环节的变频器不同,矩阵变换器不需要中间的直流环节,而是通过双向开关直接在输入和输出之间进行能量传递。这种结构使得矩阵变换器具有更高的效率、更小的体积和更好的动态响应。在本项目中,我们将使用 MATLAB/Simulink 来建模和仿真一个矩阵变换器,并分析其性能。Simulink 是一个强大的仿真工具,特别适合用于电力电子系统的建模和仿真。

MHD0815的博客 1065

手把手教您windows如何正确的开启局域网共享,如何解决“没权限、空密码访问等诸多问题”,含手动操作教程 + 傻瓜式一键设置工具(局域网共享+打印机管理),二选一总有一款能满足您!

😫 Windows共享总失败?别抓狂!这篇教程带你破解“空密码”访问的核心难题 🔑,四步搞定所有设置。文末还附赠“一键修复”神器 🚀,让文件共享丝滑如德芙!

XiaoqiangClub的博客 1452

嘿!七夕节,送书30本,一份心意!

每逢佳节时,我都会给读者来一波送书福利,今天是七夕情人节,我这里给大家送波书。书单如下:书单1:深度学习入门 x 1Python3网络爬虫开发实战 x 1第一行代码——A...

欢迎关注公众号:【码农突围】,回复9999,可以获取一份LeetCode刷题笔记 915

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

爬取人民邮电出版社书籍信息

一,请求页面,获取bookId import requests import json # 获取bookId url = 'https://www.ptpress.com.cn/masterpiece/getMasterpieceListForPortal' headers = { 'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/95.0

qq_51014805的博客 8662

Camera2Demo

在Camera2 的基础上进行封装,使得Camera2一堆初始化逻辑与Activity分离,降低耦合度,完成预览拍照并保存的操作

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

数据采集与预处理课程 ——课中考试 ——爬取网页书籍信息并保存到excel

记录: 2021-2022第1学期数据采集与预处理课程 课中考试 一、打开人民邮电出版社(http://www.ptpress.com.cn)主页,找到“新书推荐版块” 中对应方向的真实地址。(学号1-2选计算机,3-4选电子,依次类推。) 二、编写代码获取相关图书的基本信息“bookName”、“bookID”、“picPath”保存到excel 中,命名为“某类新书基本信息.xlsx”,例如:“计算机新书基本信息. xlsx”。 三、在第二步的基础上爬取图书的价格和库存信息,保存到Excel表中,命名

qq_30136729的博客 2451

使用Xpath爬取人邮教育社区的书籍信息

爬取链接:https://www.ryjiaoyu.com/tag/details/7 我们只需要获取书名、作者、价格、详情链接的信息 代码如下: import requests #调用requests库 import csv #调用csv模块 from lxml import etree #调用lxml库 def get_html(url): #建立get_html函数,实现网页内容获取 try: headers={"User-Agent":"Mozilla/5.0

饭饭童鞋的博客 3070

爬取某类网站并生成csv文件(人民邮电出版社书籍信息)

import requests #获取网页内容 def get_page(url): #请求头用来表示用户身份的(像上学期的那个就会遇到404的那种情况这里可以解决) headers={'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/81...

qq_46300780的博客 3165

Python |(爬虫 )爬取当当网书籍信息存到Excel中

文献检索作业,小白也很无奈。还好有学霸同学的可以借鉴。 一、任务 获取当当网上至少300本书【均为某类书,如Linux相关的书籍,或C++相关的书籍】的信息,包括书名,网址,价格,作者,并存在excel表格中。 二、分析 (一)、单页面的信息分析 源代码分析 在当当网的搜索框输入“Linux”,出现搜索后的页面,按F12查看源代码。  <li ddt-pit="1" clas...

Sherlock_Homles的专栏 4139

爬虫实例

1. 爬取中国500强企业排行榜数据:企业名称、地址、2020年排名、2019年排名、营业收入、营业收入年增减、利润、利润年增减、资产、市值、股东权益 import re import time import requests import pandas as pd from lxml import etree def get_page(url): headers={ "User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) App...

yy16j的博客 2028

Python一键爬取你所关心的书籍信息

作者:梅破知春近,准数据分析师个人简书专栏:放翁lcf https://www.jianshu.com/u/ea4b6b1d2c22前言平时看到的豆瓣爬虫基本都是爬豆瓣...

数据森麟 675

用scrapy框架爬取人邮出版社新书快递

明确目标 目标url:https://www.ryjiaoyu.com/tag/details/7。 静态网页。 需要进入详情页爬取信息。 scrapy框架 建项目 新建scrapy项目: 1.创建爬虫项目,命令:scrapy startproject 项目名称。 例如scrapy startproject RenYou 2.创建爬虫文件,命令:scrapy genspider 文件名称 域名 例如scrapy genspider ry https://www.ryjiaoyu.com/tag/det

qq_43308639的博客 915

python 爬虫 爬取当当网图书信息

初次系统的学习python,在学习完基本语法后,对爬虫进行学习,现在对当当网进行爬取,爬取了基本图书信息,包括图书名、作者等import requests from time import sleep from lxml import etree class dangdang_spider(): #定义爬虫类 def __init__(self): self.url="ht...

dhissy的博客 1万+
下一篇: python装饰器解释
Keyl丶Yng
博客等级 码龄8年 70粉丝 20原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值