


本文学习自:《Python 源码深度剖析》
- 感谢作者的传授
- 若还不清楚字典的知识, 详细内容和知识点可点击了解
功能
主类(字典):PyDictObject
- (1) add_entry(self, key, value) : 添加元素
- (2)del_entry(self, key) : 删除元素
- (3) get_entry(self, key): 查找键对应的值(与删除采用相同的函数,通过flag 标志区分)
- (4) hash_list : (属性),可以遍历底层hash数组
- (5) entry_list: (属性),遍历底层键值对数组
- (6) 可通过简单的 for循环迭代,很方便
pd = PyDictObject()
''' 查看原始hash表存储情况 '''
# for 循环遍历
for i in pd.ma_keys:
    print(i)

# 或者 生成器表达式, 再转化为字典
a = (i for i in pd.hash_list)
print(list(a))

# 查看底层键值对数组情况
b = (i for i in pd.entry_list)
print(list(b))
内部功能:
- 扩容, 伪扩容,缩容的实现。 hash冲突的预防,探测(线性探测,平方探测)
- 其中探测分为 两种方式(线性探测和平方探测依次循环探测)
- 修改或者是增加使用相同的函数(底层自动监测是否有相同的key,决定是否 更新数据 或者新增数据)
PyDictKeysObject
- 完成主要的所有核心的功能
De_Entries
- 键值对数组
Dk_Indices
- 散列表
Entry
- 散列表数组元素
- 包含状态 和 键值对存储下标 两个属性
PyDictKeyEntry
- 键值对对象
- 定义了几个方法,操作键值对
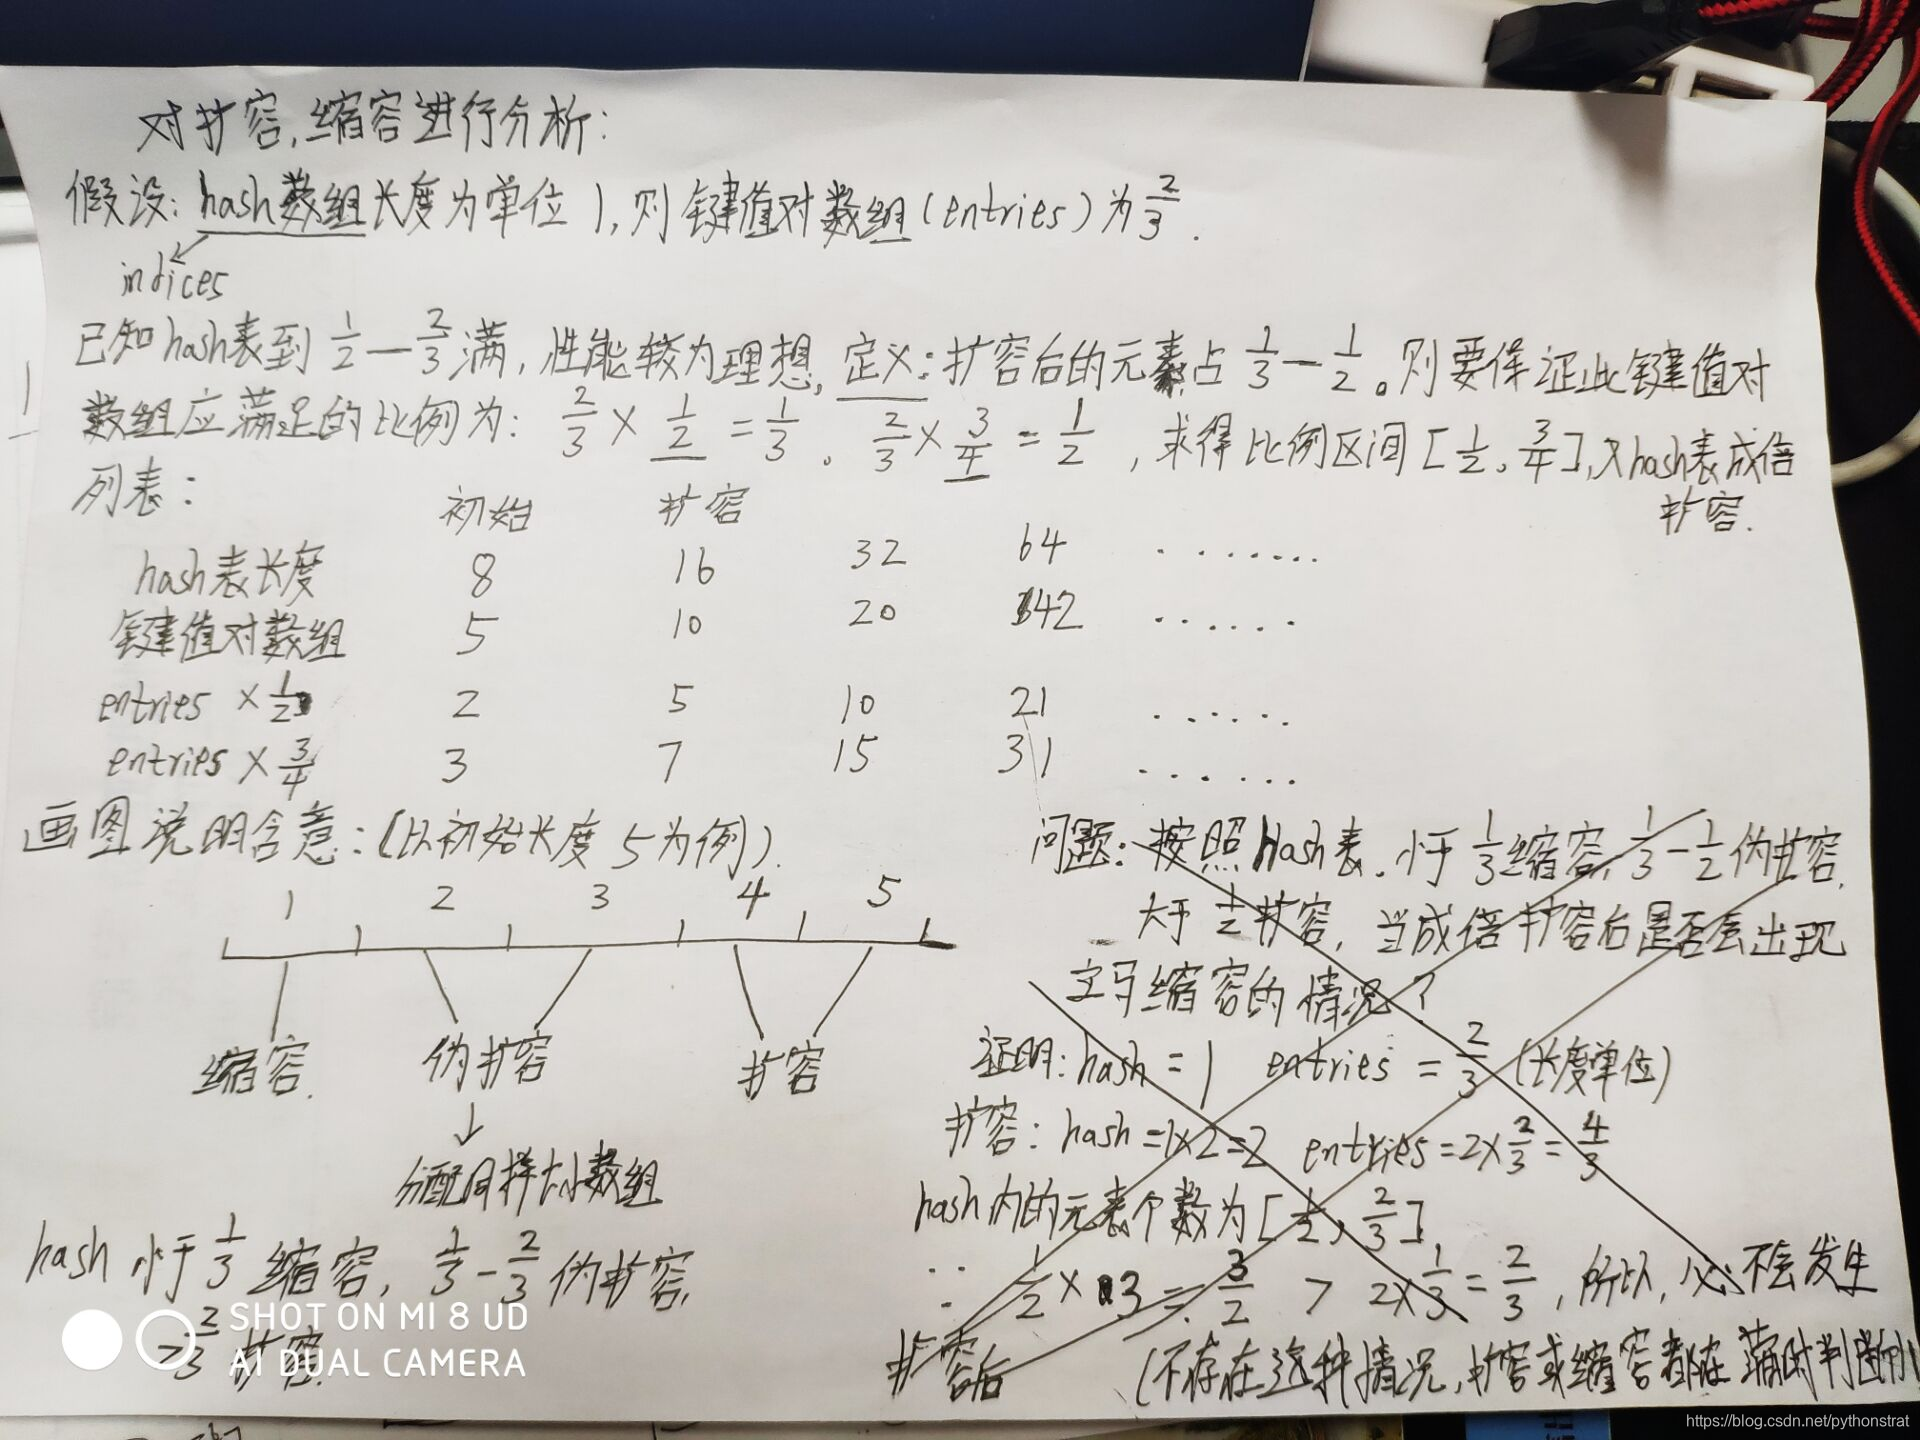
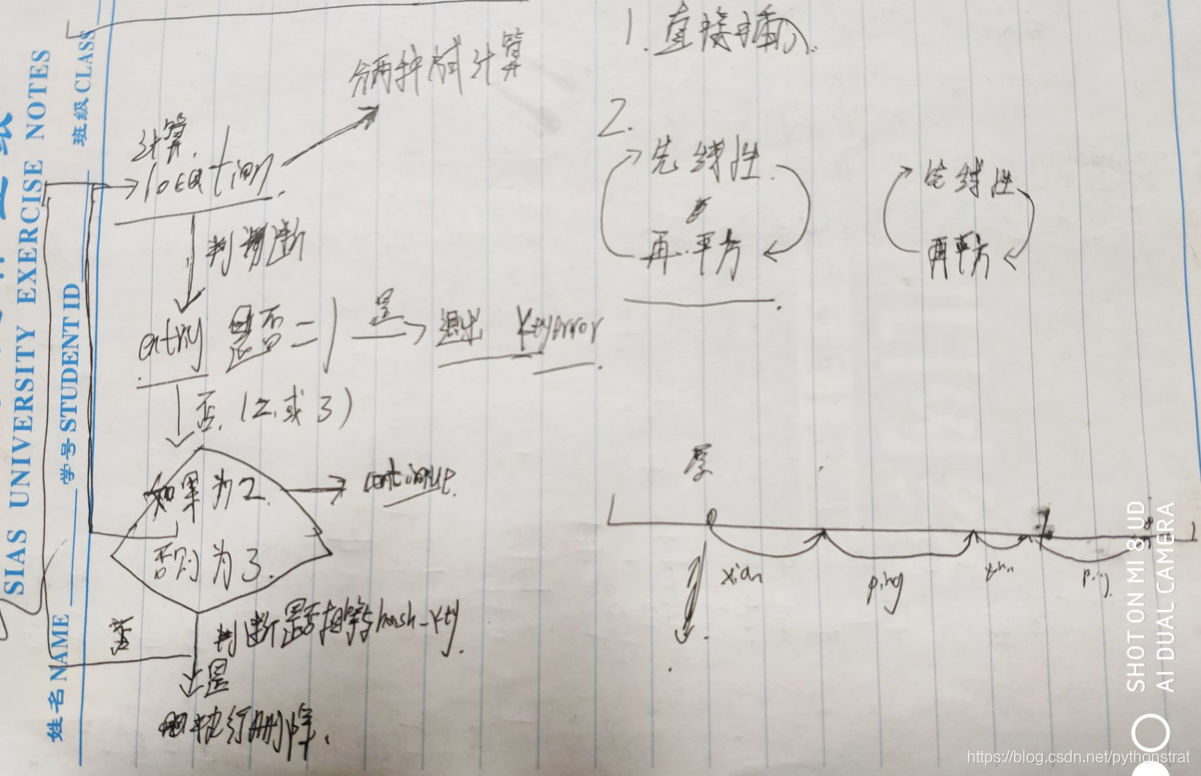
主要的功能示意图:
扩容缩容(可能与源码的实现有些不同)
删除逻辑(字体较为潦草~)
- 因为总是先进行比较,若不相同才会有 探测这一步,所以总觉得是 do while循环,先执行一次,再做做判断循环,但是 python中没有do while循环, 所有就是用了 while True: pass (具体参考删除逻辑的代码)
测试
- 循环10000次,除性能问题外,基本可以排除所有bug,不会因代码本身逻辑问题,导致代码异常出 bug,健壮性还可以。
- 每次哈希探测的次数,均少于10次(异常退出设置的是十次,可能探测次数更低)
问题
- (1) 首先并没有复刻一个对象的 头部,也就是没有考虑到删除或者修改一个对象时,内存管理,垃圾回收的问题。 因为没有设置 refcnt字段去 考虑垃圾回收。
- (2)字典当中,有些字段并没有使用上,也就荒废了。
- (3) 很多功能感觉很简单~,但是测试时会有很多逻辑上的漏洞和bug, 代码不断更新,完善。 即使是一个很小的东西,要想万无一失,都需要钻牛角尖,仔细考虑完善,很佩服 语言的开发者,实现整个语言的功能,还要避免漏洞。
- (4) 本来想复刻一下,字典的遍历, for i in range dict.items等 按照键,按照值 等方式遍历, 但是 底层都是去 遍历 键值对数组, 但键值对数组的迭代器,是共用一个 i变量遍历的, 这就涉及到,当同时去 遍历键, 值等的时候, i值的问题所以就没实现
感悟:
起初设计的时候,感觉要写个很多代码,能实现一个大的功能,结果实现的时候,仅仅用了300行代码~ 另外很多东西只有实践的时候,才能去真正了解他的细节, 包括一个字段, 一段处理逻辑, 一丁点地方都需要去反复求证,才能下手。 另外对 程序的设计 还有思路方面有很大的收获, 诚然现在的代码,质量还不高,很多重要的地方,因为思维局限,写代码时还未考虑,但进步还是有的。
代码展示
class Me_Key():
    """ 定义数据描述器,限定 Me_key 值为可hash的 """

    def __init__(self, name):
        self.attrname = name

    def __get__(self, instance, owner):
        return getattr(instance, self.attrname)

    def __set__(self, instance, value):
        # 当数据是 字典或者列表,我们就认为是不可哈希的,返回错误
        if isinstance(value, dict) or isinstance(value, list):
            raise("键错误,不可哈希")
        setattr(instance, self.attrname, value)


class PyDictKeyEntry():
    """ 定义存储的键值对 对象,PyDictKeyEntry """

    me_key = Me_Key('_key')
    def __init__(self):
        """
        :param    me_hash: 键对象的 哈希值 ,避免重复调用 __hash__ 计算哈希值;
        :param    me_key: 键对象指针;
        :param    me_value: 值对象指针;
        """
        self.me_key = None
        self.me_value = None
        self.me_hash = None

    def set_data(self, key, value):

        self.me_key = key
        self.me_value = value
        self.me_hash = hash(key)

    def del_data(self):   # 默认全部设置为None, 就是删除了
        self.me_key = None
        self.me_hash = None
        self.me_value = None


class Entry():
    """ 定义散列表每一个格子 """

    # 定义三种状态
    EMPTY = 1
    DUMMY = 2
    USED = 3

    def __init__(self):
        self.status = self.EMPTY
        self.index = None

class Dk_Indices():
    """ 定义dk_indices 散列表 """
    entry = Entry

    def __init__(self, n = 8):
        """
            散列表定义初始长度为8
        """
        self.hash_table = [self.entry() for i in range(n)]


class De_Entries():
    """ 定义存储键值对数组 """
    pke = PyDictKeyEntry

    def __init__(self, n = 5):
        self.i = -1
        self.length = n
        self.entries = [self.pke() for i in range(n)]

    def __iter__(self):
        self.i = -1
        return self

    def __next__(self):

        while self.i < self.length -1:
            self.i += 1
            return self.entries[self.i].me_key, self.entries[self.i].me_value
        raise StopIteration


class PyDictKeysObject():
    """ 定义哈希表对象结构 """

    indices = Dk_Indices
    entries = De_Entries
    def __init__(self):
        """
            :param    dk_size: 哈希表大小
            :param    dk_usable: 键值对数组可用个数
            :param    dk_nentries: 键值对已用个数 (因为删除数据了, 可用加上已用,并不等于键值对数组大小,还有的删除状态不再使用了),当数据删除时,已用个数减一,但是可用个数不变
            :param    dk_indices: 存储dk_entries数组对应元素下标(也是hash表)
            :param    dk_entries: 保存键值对的数组
            :param    de_deldatas: 删除元素的个数
        """
        # 初始化数据,散列表总长度8,键值对数组长度5(三分之二长),已用个数为0
        self.dk_size = 8
        self.dk_usable = 5
        self.dk_nentries = 0
        self.de_deldatas = 0
        self.dk_indices = self.indices()
        self.dk_entries = self.entries()

        # 用于迭代器计数
        self.i = -1

    def find_location(self, me_key, me_value):
        """ 寻找数据的 hash表存储位置,并插入 """
        ''' 官网的根据 对象hash值选择,生成不同的探测序列,我们搞简单的,利用线性和平方探测,交替进行,减少冲突 '''

        # 这里用一个技巧,取模运算,被代替为 按位与& 运算, 因为hash表的长度为dk_size =  2的n次方, 则2的n次方减一,二进制恰好是 低位全1,高位为0,相与即是等于 与 dk_size 取模运算,但更速度!https://blog.youkuaiyun.com/u014266077/article/details/80672995
        a = self.add_entries_data(me_key, me_value)
        if not a:
            return
        self.insert_hash_index(a)
        # 数据插入成功,更新 self.dk_usable     self.dk_nentries 字段的值
        self.dk_usable -= 1
        self.dk_nentries += 1
        print("+++++", self.dk_usable)

    def insert_hash_index(self, a):
        location = a.me_hash & (self.dk_size - 1)
        entry = self.dk_indices.hash_table[location]
        s = self.status_1_2(entry)

        if not s:
            sequence = entry.status
            n = 1
            while sequence == 3:
                # 防止冲突算法不好,程序陷入死循环,最多查找十次
                n += 1
                if n > 10:
                    print("这~~ 执行十次都找不到插入的位置。。")
                    raise TimeoutError
                location = self.linear_detect(location)  # 线性探测
                temp =  self.dk_indices.hash_table[location]
                sequence = temp.status
                if sequence == 3:
                    location = self.square_detect(location)  # 平方探测
                    temp =  self.dk_indices.hash_table[location]
                    sequence = temp.status
            self.status_1_2(temp)

    def del_element(self, key, flag = 1):
        """ 定义删除元素的函数 """

        try:
            hash_key = hash(key)
        except TypeError as e:
            print("提示:传入的键是不合法的,请重新尝试!")
            raise(e)
        location = hash_key & (self.dk_size - 1)
        entry = self.dk_indices.hash_table[location]
        n = 0
        while True:
            if n != 0:
                if n & 1 == 1:
                    location = self.linear_detect(location)  # 线性探测
                else:
                    location = self.square_detect(location)  # 平方探测
                entry = self.dk_indices.hash_table[location]

            if entry.status == 1:
                raise KeyError
            elif entry.status == 2:
                n += 1
                continue
            else:
                array_key_value = self.dk_entries.entries[entry.index]
                if hash_key == array_key_value.me_hash:
                    if flag == 2:
                        print("执行get()")
                        return array_key_value.me_value
                    print("执行删除")
                    self.de_deldatas += 1
                    entry.status = 2
                    entry.index = None
                    array_key_value.del_data()
                    break
                else:
                    n += 1


    def add_entries_data(self, key, value):
        """ 向键值对数组插入数据 """

        temp = self.dk_entries.pke()
        temp.set_data(key, value)
        for i in self.dk_entries.entries:
            if i.me_hash == temp.me_hash:
                print("执行修改操作")
                i.me_value = temp.me_value
                break
        else:
            # 判断是否需要扩容
            if not self.cheack():
                # 执行扩容
                self.expansion()
            a = self.dk_entries.entries[self.dk_nentries]
            a.set_data(key, value)
            return a

    def cheack(self):
        """ 插入数据时对 键值对数组进行检查,是否会出现元素溢出,进行相应的扩容,或者缩容操作 """
        return False if self.dk_usable == 0 else True

    def expansion(self):
        """ 扩容函数 """

        # used, 除去删除的,真正已用的, entries就是键值对数组的长度
        used = self.dk_nentries - self.de_deldatas
        entries = (self.dk_size*2 // 3)
        if used > entries*3 // 4 :
            print("执行双扩容")
            # 重新初始化数据
            self.dk_size *= 2
            self.dk_indices = self.indices(self.dk_size)  # 和下面的初始化操作一样,可以 重写一个方法,但是程序执行速度太低了
            self.dk_usable = self.dk_size*2 // 3
            self.dk_nentries = 0
            # 分配键值对数组,与重新插入 hash表
            self.redistribute()
        elif used >= entries // 2 :
            print("执行伪扩容")
            self.dk_indices = self.indices(self.dk_size)
            self.dk_usable = self.dk_size*2 // 3
            self.dk_nentries = 0
            self.redistribute()
        else:
            print("执行缩容")
            # 默认最小长度是8,不允许缩容
            if self.dk_size == 8:
                return
            n = 1
            i = 0
            while n < used * 3:  # 计算最小的满足 键值对为hash大小1/3, 的n (n表示2的n次方)
                n *= 2
                i += 1
            # 初始化数据
            self.dk_size = 2 ** i
            self.dk_indices = self.indices(self.dk_size)
            self.dk_usable = self.dk_size*2 // 3
            self.dk_nentries = 0
            self.redistribute()

    def redistribute(self):
        """ 重新分配 hash,键值对数组 """

        i = 0
        temp = self.entries(self.dk_size*2 // 3)
        for data in self.dk_entries.entries:
            if data.me_hash == None:
                continue
            temp.entries[i] = data
            self.insert_hash_index(data)
            self.dk_usable -= 1
            self.dk_nentries += 1
            i += 1
        self.dk_entries = temp

    def status_1_2(self, b):
        """ 转态转换: EMPTY 与 DUMMY """
        ''' 用来判断状态 1,2 说明不存在hash冲突,返回True,否则返回False '''
        if b.status != 3:
            b.index = self.dk_nentries
            b.status = 3
            return True
        else:
            return False

    def linear_detect(self, index):
        """解决hash冲突,开放地址法,线性探测方法"""
        # 经过试验,当后面 +3时, 循环一万次添加数据时,都不会出现死循环, 为0或 1都不行, 看来解决冲突的算法真的很重要
        return (index * 2 + 3) & (self.dk_size - 1)

    def square_detect(self, index):
        """ 平方探测 """
        return (index ** 2) & (self.dk_size - 1)

    # 定义成迭代器,方便查看 散列表内的元素存储情况
    def __iter__(self):
        self.i = -1  # 当多次for 循环时, i值必须重新初始化,从头开始
        return self

    def __next__(self):
        while self.i < self.dk_size:
            self.i += 1
            if self.i == self.dk_size:
                break
            return self.dk_indices.hash_table[self.i].index, self.dk_indices.hash_table[self.i].status
        raise StopIteration


class PyDictObject():

    pdk = PyDictKeysObject

    def __init__(self):
        """初始化大整数
        :param    ma_used: 对象当前所保存的键值对个数
        :param    ma_version_tag:对象当前版本号,每次修改时更新
        :param    ma_keys:指向映射的hash表结构
        :param    ma_values: 分离模式下指向由所有 值对象 组成的数组
        """

        # 定长对象 公共头字段:PyObject_HEAD, 里面ob_refcnt,
        self.ma_used = 0
        self.ma_version_tag = 1
        self.ma_keys = self.pdk()
        self.ma_values = None

    @property  # hash数组
    def hash_list(self):
        return self.ma_keys

    @property  # 键值对数组
    def entry_list(self):
        return self.ma_keys.dk_entries

    # 添加 键值对数据
    def add_entry(self, key, value):
        self.hash_list.find_location(key, value)

    # 查询一个 键对应的值
    def get_entry(self, key):
        return self.hash_list.del_element(key, flag = 2)

    # 删除键值对数组
    def del_entry(self, key):
        self.hash_list.del_element(key)

    def __iter__(self):
        return self

    # Entry数组的"不可变性", Python3.7中,支持按插入顺序迭代
    def __next__(self):
        pass


pd = PyDictObject()
# pd.add_entry(123, 789)

for i in range(0, 42):
    pd.add_entry(i, i)


for i in range(37):
    pd.del_entry(i)
pd.add_entry(48, 34)

pd.add_entry(39, "hash")

print(pd.get_entry(37))
''' 查看原始hash表存储情况 '''
# for 循环遍历
# for i in pd.ma_keys:
#     print(i)

# 或者 生成器表达式, 再转化为字典
a = (i for i in pd.hash_list)
print(list(a))

b = (i for i in pd.entry_list)
print(list(b))


 1161


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


