通过Python爬取当当网,学正则表达式

当当网读书排行榜爬虫 本论文论述了基于python开发爬取的当当网五星排行榜。在此次开发中运用正则表达式爬取了排行榜中的排名,图片,书名,作者,100%推荐,五星评论数,价格。通过爬取下来的信息对比,可以更好地了解一些高评分的好书。 关键词:python;当当网TOP500 阅读详情

本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,,版权归原作者所有,如有问题请及时联系我们以作处理

作者:啃书君  来源:掘金

原文链接:https://juejin.cn/post/6911667019435737101

PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取

python免费学习资料以及群交流解答点击即可加入


准备工作

工欲善其事,必先利其器。写代码也同样是如此,所以在开始之前请先安装好requestst、pandas库。如果没有安装,请先安装好。

# 安装requests
pip install requests

# 安装pandas
pip install pandas

复制代码

需求分析

本次我们需要提取出当当网TOP500的图书名称、初版时间、价格和作者姓名。

获取书籍名称

首先打开开发者工具,使用选择器定位到书籍名称。
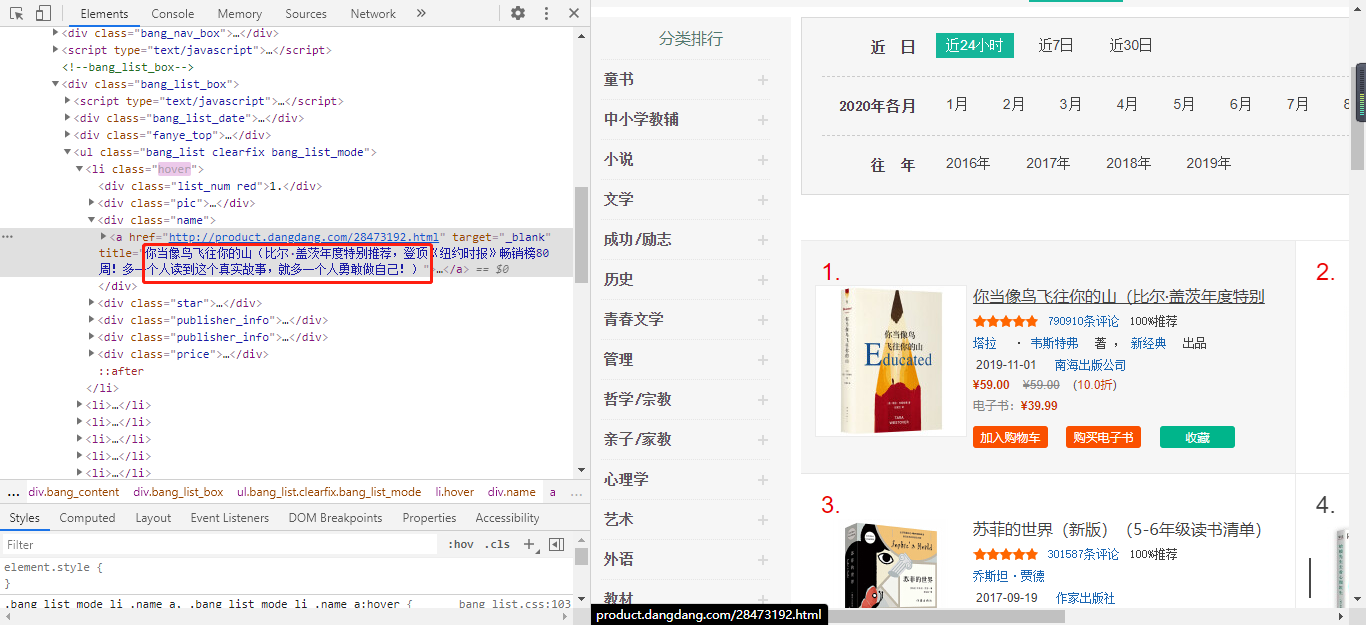
从上图可以看到,书籍名称在title属性值上。

具体正则表达式如下所示:

pattern_name = re.compile('li.*?<div class="name">.*?title="(.*?)".*?</a>', re.S)
复制代码

获取作者姓名
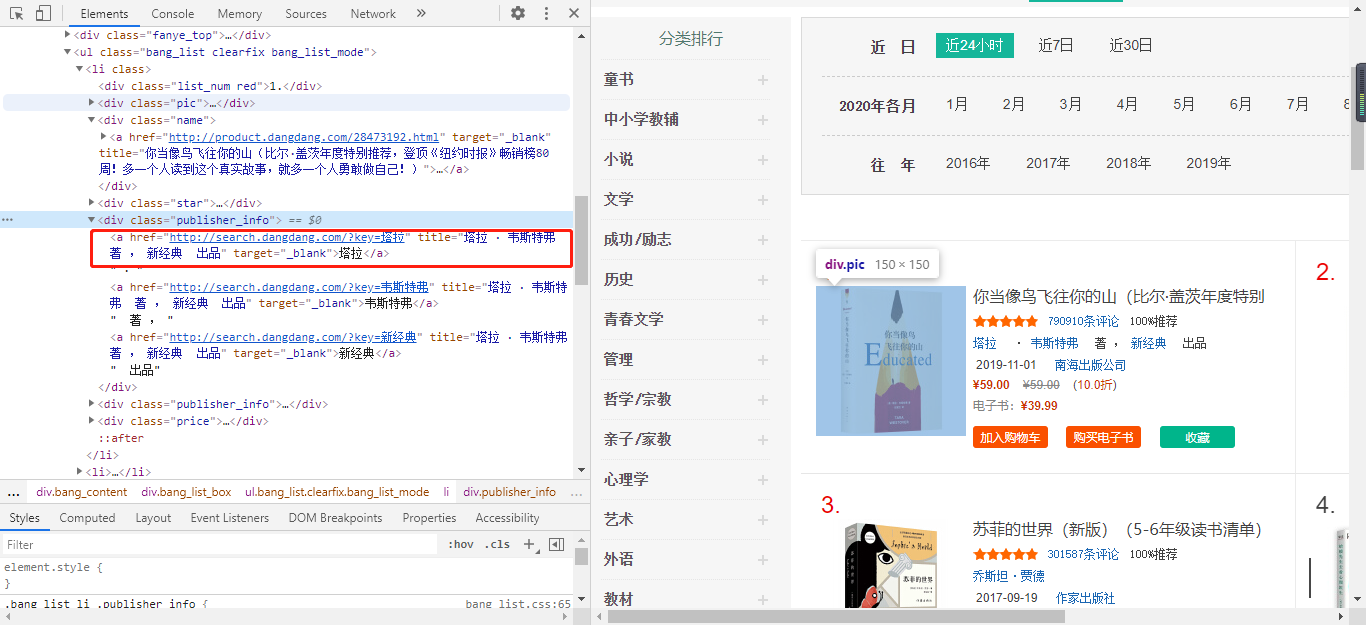
从上图可以看到作者姓名在a标签的文本中,具体正则表达式代码如下所示:

 pattern_author = re.compile('li.*?<div class="publisher_info">.*?<a .*?target="_blank">(.*?)</a>', re.S)
复制代码

获取出版日期
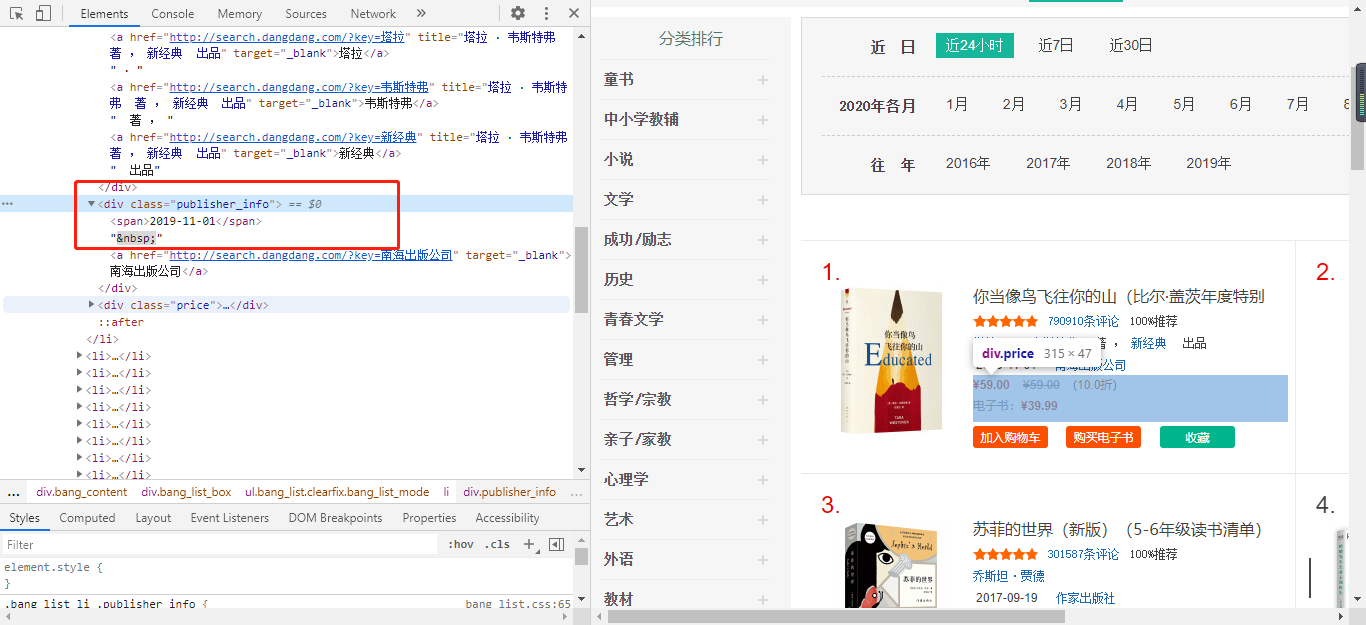
从上图可以看到,出版日期在span标签内。具体正则表达式如下所示:

 pattern_time = re.compile('li.*?<div class="publisher_info">.*?<span>(.*?)</span>', re.S)
复制代码

获取价格
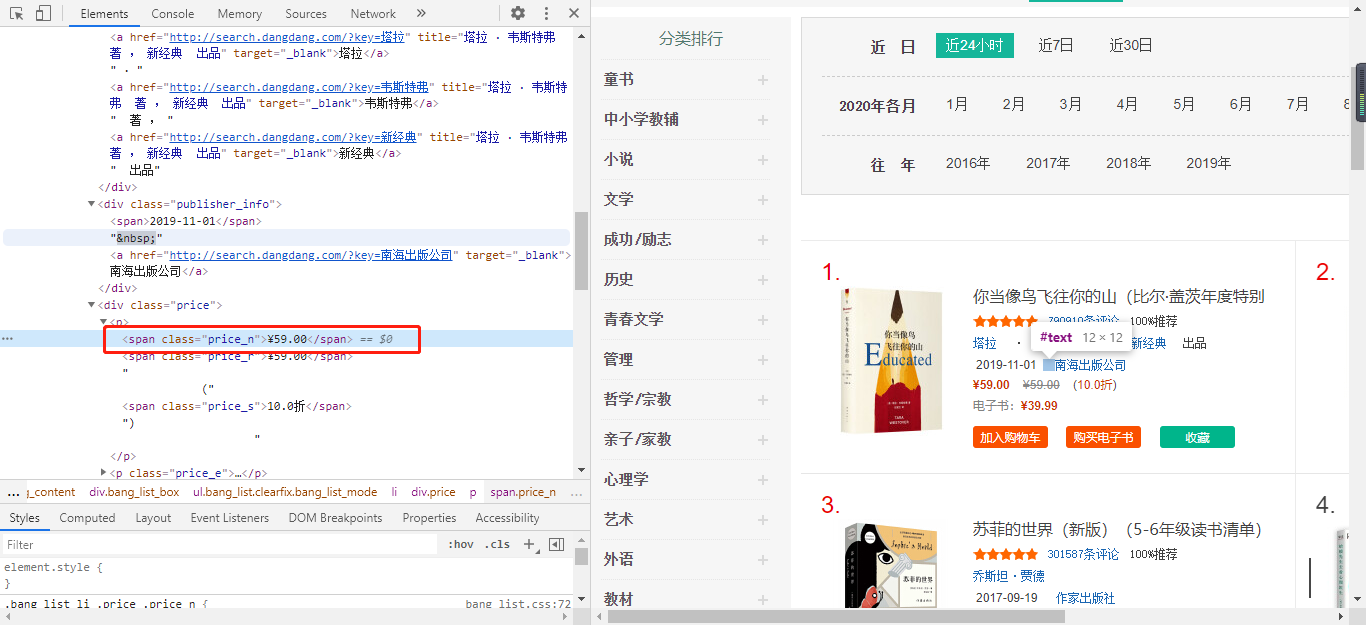
和出本日期一样,都是在span标签内,但是要注意它们之间的区别。具体正则表达式如下所示:

pattern_price = re.compile('li.*?<div class="price">.*?<span class="price_n">(.*?)</span>', re.S)
复制代码

翻页处理

打开网页你会发现并不是所有的的图书都在同一个页面,TOP500共有25页,每页20本书。所以接下来需要分析翻页时URL的变化规律。

# 第一页
http://bang.dangdang.com/books/bestsellers/01.00.00.00.00.00-24hours-0-0-1-1
# 第二页
http://bang.dangdang.com/books/bestsellers/01.00.00.00.00.00-24hours-0-0-1-2
# 第二十五页
http://bang.dangdang.com/books/bestsellers/01.00.00.00.00.00-24hours-0-0-1-25
复制代码

从上面不难看出变化的内容是最后一个数字,并且每一次都按加1的操作。

功能实现

获取每一页的URL地址

    def get_url(self, page):
        url = f'http://bang.dangdang.com/books/bestsellers/01.00.00.00.00.00-24hours-0-0-1-{page}'
        return url
复制代码

可以通过循环的方式,将1-25传值给page

获取每一页的网页信息

    def get_html(self, url):
        html = self.session.get(url).content.decode('gb2312', 'ignore')
        return html
复制代码

将信息保存至csv文件

    def get_info(self, html):
        pattern_name = re.compile('li.*?<div class="name">.*?title="(.*?)".*?</a>', re.S)
        pattern_author = re.compile('li.*?<div class="publisher_info">.*?<a .*?target="_blank">(.*?)</a>', re.S)
        pattern_time = re.compile('li.*?<div class="publisher_info">.*?<span>(.*?)</span>', re.S)
        pattern_price = re.compile('li.*?<div class="price">.*?<span class="price_n">(.*?)</span>', re.S)
        name = re.findall(pattern_name, html)
        author = re.findall(pattern_author, html)
        print('清洗前:',author)
        # author = [i for i in author if '出版社' not in i]
        if page == 3:
            author = [i for i in author if '出版社' not in i]
        if page == 14:
            author = [i for i in author if '机械工业出版社' not in i]
        print('清洗后:',author)
        print(len(author))
        time = re.findall(pattern_time, html)
        price = re.findall(pattern_price, html)
        price = [i.replace('&yen;', '¥') for i in price]
        df = pd.DataFrame({
            'book_name': name,
            'author': author,
            'edition_time': time,
            'price': price
        })
        print(list(df['author']))
        return df
复制代码

在这里我需要说两个坑,也就是上面代码的两个if语句。

这两个坑是这样的,当匹配到第三页和第第十四页的时候,分别有一本书会出现两个作者信息,一个是作者,一个是出版社信息。那这样就会出现21个作者,20本书21个作者显然是不合理的,所以我使用两个if语句将这两个多余内容清理掉。

最后

本次爬取当当网的内容分享到这里就结束了,你将正则表达式学会了吗?

如果你看到这里,相信本文对你还是有些许帮助的,这也是我写文章的初衷。



Python获取当当平台商品数据信息可视化效果展示 嗨喽,大家好呀~这里是爱看美女的茜茜呐。 阅读详情

相关推荐

python爬取虎嗅网首页新闻超链接、图片链接、标题

要求:爬取该网站首页内容,即获取每一个超链接、图片链接、标题,以.CSV存储(一行就是一个新闻的超链接、图片链接、标题) 文章目录用不上的思考过程正文1.观察新闻页面源码2.编写代码提取信息3.观察首页源码并编写正则表达式源码 建议直接点正文???? 用不上的思考过程 1.新闻超链接存在于a的herf属性中,/article/408795.html,前面要加上https://www.huxiu.com 2.图片链接暂时还不知道存在哪 https://img.huxiucdn.com/article/cove

m0_50123831的博客 2586

python 网络爬虫技术 运用正则表达式爬取当当网(实战演练)

爬取网络:当当网 代码 import re import requests import time import xlwt url_basic = 'http://search.dangdang.com/?key=' heads = { 'Connection': 'keep-alive', 'Accept-Language': 'zh-CN,zh;q=0.9', ...

Python领域优质萌新学习笔记 1465

python爬虫教程(4)-正则表达式解析网页

欢迎来到python爬虫大讲堂,现在开始你的爬虫旅程吧! 正则表达式解析网页 正则表达式就是对字符串进行操作的逻辑公式,相当于‘过滤’这个字符串。 我们可以把网页源码变成字符串,再用正则表达式对其进行提取,一开始学正则表达式会感到有点困难,但是加油! 接下来就是一个难懂的表格: . * 匹配除了换行符外的任意字符 匹配前一个字符0或多次 + ? 匹配前一个字符1或多次 匹配...

pynickle的博客 3104

python爬虫要不要学正则_Python爬虫学习(四)正则表达式

经过前面的学习之后,大家现在应该可以顺利地得到一个网页源码字符串,对于Python中的字符串,Python提供了很多操作,大家可以其去尝试提取网页源码字符串中想要的信息。在这里,给大家推荐的是正则表达式!文章最后还有爬取糗事百科的实例哦!什么是正则表达式说白了,正则表达式就是描述我们需要提取的那部分信息的规则的工具。举个栗子,比如,我们想要提取'Stay hungry, 123 stay fool...

weixin_39583751的博客 248

不用学正则!3行代码爬取猫眼电影TOP100,新手也能搞定文本保存

好的代码不是写得少,而是把复杂性转移到了正确的地方。把解析复杂性转移给parsel(专业解析器)把存储复杂性转移给pandas(专业数据工具)把网络复杂性转移给requests(专业HTTP库)你的业务代码自然就只剩下“获取→解析→存储”这三步。“这个问题真的需要正则吗?大多数时候,答案是否定的。参考资料parsel官方文档pandas.to_csv参数详解Python爬虫合规指南(2025版)📌免责声明:本文代码仅供学习交流,请严格遵守目标网站的使用条款和相关法律法规。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 209

Python爬取当当、京东、亚马逊图书信息代码实例

主要介绍了Python爬取当当、京东、亚马逊图书信息代码实例,具有一定借鉴价值,需要的朋友可以参考下。

Python自学第4周反馈:大盘股指,从爬取到预测

目标:爬取大盘数据,并简单预测 本次实践极为不专业,忽视了股市的其他影响因素,仅对数据进行移动平滑预测,旨在练习数据的爬取及函数编写,文末会附上自己写的几个常用函数和完整的整个过程代码 #1.解析网页,找到目标数据 找到日K线图,点开开发者工具,数据量这么大的肯定就是这个日数据了 点开看下,一目了然 找到数据对应的位置 日期 开盘 收盘 最高 最低 成交量 成交额 振幅 201...

Samle的博客 1658

java 二维码生成及其标签打印

本文主要内容 二维码生成 二维码标签预览及打印 二维码生成 笔者此次的二维码是通过调用第三方接口生成的,具体流程如下: 根据规范要求调用第三方接口,返回二维码下载地址及二维码图片的属性值(图片大小等) 根据返回的值获取二维码下载地址,根据地址下载二维码图片,保存至本地磁盘及记录数据信息 扫描二维码跳转相应地址,显示资产的基本信息 最终生成的二维码如下图所示: 预览并批量打印二维码标签 先...

孙小牟的博客 4940

Python(爬虫篇)--- 正则表达式

文章目录一、为什么要学正则表达式二、基础正则表达式语法(一)元字符(二)python 中正则表达式模块——re1. match方法2. search方法3. findall方法4. finditer方法5. split方法6. sub方法7. 贪婪模式和非贪婪模式8. 爬虫的万能表达式9. 匹配中文三、案例----猫眼电影TOP100榜单信息爬取 一、为什么要学正则表达式 实际上爬虫一共就四个主要步骤: 明确目标(要知道你准备在哪个范围或者网站去搜索) 爬(将所有的网站的内容全部爬下来) 取(去掉对我们

Zachary579的博客 1114

软硬件协同设计的大小端问题

缘起 最近需要在soc系统内做协处理器,加速AES加密运算,寄存器一次读取32bit,AES一次处理128bit,因此在数据拼接的时候,需要考虑大小端的问题,特来记录一番。 一、什么是大小端 大小端的问题发生在寄存器和内存间传递数据,这点非常重要,很多地方简单地说是数据存储方式,其实不准确。追根溯源,大小端问题是在设计load,store指令的时候考虑的,因此本质是寄存器和内存交互的问题,其他地方不会发生。 比如c语言里定义一个变量int a=ox1234,那么查看在线汇编平台的对应汇编代码: # 给2号寄

http://www.icfgblog.com/ 612

软件工程导论实践:从需求到架构的机票预订系统全流程解析

本文深入解析机票预订系统从需求分析到架构设计的全流程实践,涵盖业务流程、功能建模、模块化设计、性能优化等关键环节。通过实际项目经验,分享软件工程导论在复杂系统开发中的应用技巧,包括数据流图绘制、E-R图设计、微服务架构及高并发处理等实战策略,助力开发者构建高效可靠的机票预订系统。

weixin_29202213的博客 412

取等于号后面数字正则表达式_python之正则表达式进阶——从网页摘取信息

经过之前一段时间关于正则表达式和re模块的学习和梳理,现在尝试从复杂网页中爬取信息。学习从网页中摘取信息确认数据源练习从网页爬取数据时,为了不触发网站的反爬机制,建议打开网页另存为html文件。我从某网站保存了一页关于房产信息的网页,尝试从中爬取信息。然后用notepad++打开该文件,看看文件内容。编写正则表达式是不是感觉有点无从下手?别慌,慢慢来。通过对比网页和网页代码我们确认信息特征。房产名...

weixin_39589394的博客 670

HFSS线圈仿真避坑指南:从建模到寄生参数分析的完整流程

本文详细介绍了HFSS线圈仿真的完整流程,从精准建模到寄生参数优化,特别针对Ansys Electronics Desktop用户提供实用指南。涵盖线圈几何构建、材料属性配置、端口激励设置及寄生电阻与电感分析等关键步骤,帮助工程师避免常见错误,提升仿真精度与效率。

weixin_29209801的博客 548

Python-正则表达式(爬虫篇)

一、为什么要学正则表达式 实际上爬虫有四个主要步骤 明确目标:要知道去哪个范围或者网站去搜索 爬:将所有的网站的内容全部爬下来 取:去掉对我们没用处的数据 处理数据:按照我们想要的方式存储和使用 我们爬下来的数据大部分都是全部的网页,这些数据有时候是很庞大并且混乱的,大部分的董事是我们不关心的,所以我们需要将之按我们的需要过滤和匹配出来。 那么对于文本的过滤或者规则的匹配,最强大的就是正则表达式,是 Python 爬虫世界 里必不可少的神兵利器。 二、基础正则表达式 正则表达式,又称规则表达式,通常被用

zyx13513314194的博客 708

Codesys.运动控制修改凸轮点

通过改凸轮曲线的主从轴缩放比例或者偏置。 新建多个凸轮曲线,对CAM曲线进行切换。 程序中动态修改,仅修改中间的关键点(凸轮末点修改or凸轮曲线运行中修改)。 程序中动态修改,修改首未关键点及关键点个数,需要重新触发MC_TableSelect。 使用程序新建凸轮表代码,实现电子凸轮基本运动。 我们讲的凸轮表切换、关键点修改、程序新建电子凸轮,这些方法没有本质区别,总之都是“趁曲线不注意,把凸轮表改了。

傻响雨 6826

芯片ATE测试PAT(Part Average Testing)学习总结-20250916

文章摘要:零件平均测试(PAT)是半导体制造中基于统计学的质量控制方法,分为静态和动态两种类型。静态PAT通过预先设定的固定限值(每6-8批次更新)筛选异常芯片,计算采用稳健平均值和四分位间距。动态PAT则根据实时数据调整限值,能更精确识别异常而不误判合格芯片。两种方法均采用"均值±6倍标准差"的计算公式,但动态PAT具有更好的适应性和准确性。该方法通过统计分析提高了芯片产品的质量和可靠性。

歌颂苦难的行为是无耻的; 1190

【Python 爬虫】正则表达式的简单使用

一、综述 为什么要学正则:处理数据(按照我们想要的方式存储和使用) 正则匹配规则:因为太长了,所以见本文最后 match方法:从起始位置开始查找,一次匹配,返回object对象,使用group()获取对象中存储的匹配值 search方法:从任何位置开始查找,一次匹配,返回object对象,使用group()获取对象中存储的匹配值 findall方法:全部匹配,返回列表,若匹配表达式,要求同时还有其他匹配,则返回元组列表,r'<img src2="(.*?)" alt="(.*?)"' findite

风一样的少年 424

【同等学力】2025-数学✨

本文主要涵盖了谓词逻辑、集合论、图论和排列组合等多个数学领域的题目。在谓词逻辑部分,要求用全称量词和存在量词表达“没有两个人的指纹完全相同”。集合论部分涉及集合运算的证明,如证明(A-B)-C=(A-C)-(B-C)。图论部分包括计算给定10个点的联通图的边与面数。排列组合部分则要求计算从8个人中选6个并分为三组的不同方法。此外,还涉及偏序、长链、反链、二项式定理等相关内容,参考了多个优快云博客中的解题思路。

super_mochi1 676

手把手教你学python第二十一讲(爬虫之正则表达式一:实战爬取小姐姐图)

这里先对代理ip做一点补充,查自己ip上一讲给的是一个网站。那么还有另外2个网站也是可以查到访问的ip的,会出现网站查到的ip不一样,这是因为。需要注意的是这两个都有反爬虫的,但是也简单,你只需要修改一个user-agent就可以了。当然这仅限于你不用代理的时候。不加user-agent虽然不会报错,但是返回的内容是空的加上去之后来试验一下代理这里需要说明,对于有反爬虫机制检查user-agent...

工科僧的博客 506

171、运动控制中的标定:摩擦力与死区补偿标定

摘要(149字) 运动控制系统中的摩擦力与死区补偿是提升精度的关键。摩擦力分为静摩擦、库仑摩擦和粘滞摩擦,其中Stribeck效应是低速抖动的主因;死区则表现为控制信号的无效区间。有效标定方法包括恒速测试(摩擦力)和斜坡响应法(死区)。补偿策略需采用分段前馈和动态调整,避免过度补偿导致振荡。实践中要注意机械状态检查、补偿量限幅,并定期重新标定。硬件升级配合算法补偿才能实现最优控制,标定工作应优先于PID参数调整。

m0_50546716的博客 226

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

今爬取糗事百科图片----文科生的python自学之路(8)

python正则爬取糗事百科图片 刚学正则,最终没有成功,错误信息附后 # -*- coding: utf-8 -*- # coding:unicode_escape # @Time : 2020/4/22 23:00 # @Author : Compass # @File : day3_5-zhengze.py # 糗事百科 import urllib.parse import urll...

weixin_44118714的博客 690

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

python爬取豆瓣电影 Top 250里的内容

1.开始分析页面,找到所抓取的文字所在标签,如图所示。 2.通过requests.get获取整个页面代码,并通过正则表达式匹配出所需字符。 关于正则表达式 https://www.cnblogs.com/chuxiuhong/p/5885073.html 经过分析匹配出电影名称,导演等的正则为 '&amp;amp;lt;span class=&amp;quot;title&amp;quot;&amp;amp;gt;(.*?)&amp;amp;lt;/sp

naonao77的博客 546

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

python多级网址爬取_『Python』爬行搜索引擎结果获得指定主机所有二级域名

0x 00 前言前天自己在玩的时候,自己通过百度搜索主机的二级域名感觉好麻烦,自已要一页页的去翻而且人工识别是否是重复的二级域名也够蛋疼的,正好最近在学正则表达式,权当练手了0x 00 代码# coding=utf-8# author:Anka9080import urllibimport urllib2import cookielibimport reurl = ‘http://www.haos...

weixin_33494995的博客 623

Python爬虫||正则表达式与re模块-以猫眼电影为例

正则表达式 什么是正则表达式 简单来说,就是通配符,比如word中常见的 * 和 ?,最常用的就是读取某一个文件夹中的所有文档,

weixin_45072139的博客 675

python之正则表达式进阶——从网页摘取信息。

经过之前一段时间关于正则表达式和re模块的学习和梳理,现在尝试从复杂网页中爬取信息。 确认数据源 练习从网页爬取数据时,为了不触发网站的反爬机制,建议打开网页另存为html文件。我从某网站保存了一页关于房产信息的网页,尝试从中爬取信息。 然后用notepad++打开该文件,看看文件内容。 编写正则表达式 是不是感觉有点无从下手?别慌,慢慢来。通过对比网页和网页代码我们确认信息特征。 房产名称: 急降60万 急卖全款客户来 宝山二村好位置 复制该信息,到html文件中通过ctrl+F查找该信息,然后认真

m0_47670683的博客 448
上一篇: Python爬虫:静态网址的爬取
下一篇: 爬虫遇到头疼的验证码?教你弹窗处理和验证码识别
pythonputao
博客等级 码龄6年 60粉丝 111原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值