调了6年推荐公式,2026年我第一次接不住:召回排序被大模型掀了一遍

AI Agent记忆分层设计与落地实践:从短期上下文到长期向量召回 大语言模型本身无状态,每次对话都像“初次见面”,这是AI Agent从工具升级为助手必须跨越的门槛。业界普遍采用分层记忆架构来弥补这一缺陷:短期记忆依赖上下文窗口管理,通过滑动截断、摘要压缩和关键信息提取来应对长度限制;长期记忆则借助Embedding与向量数据库实现语义召回,让Agent能跨会话“想起”用户提过的技术选型或偏好;用户画像以结构化方式沉淀稳定事实,注入系统提示词后让Agent从一开始就“懂你”。分层设计不仅优化了检索质量,还兼顾了隐私隔离与遗忘机制,是工程落地中的核心要点。本文从记忆底层原理 阅读详情

我是个做推荐和搜索算法的,干了6年,前五年基本都在和特征、模型打分死磕。

一、困境:我熟的那套,开始不够用了

2025年下半年,组内一个核心场景要重构。以前这套活我闭眼都清楚:建特征、训模型、调权重,离线跑指标,线上看CTR和时长。可那次技术评审,leader提了一句——“召回和排序这块,试试用大模型增强”。

我当场有点懵。不是没听过,是没真碰过。我们这行过去讲究可解释、可控、延迟低,大模型又重又黑盒,跟原来那套调公式的思路完全是两码事。评审会上有人追着问"语义召回怎么接、效果怎么估",我支支吾吾答不完整——那是第一次,我引以为傲的功底被人问住了。

有回一个长尾query,用户搜"适合送妈妈的生日礼物",老办法只匹配关键词,出来的全是花瓶和贺卡。这事让我第一次觉得,光调公式真够不着"语义"这层——而这恰恰是这一轮大模型最拿手的地方。

更慌的是招聘侧:满屏"精通AI大模型应用",初级算法岗肉眼可见在收缩,一个同期进来的同事说,他们组搞过Token用量排行榜,末位三个月一淘汰。我们组现在招人,JD里"精通AI大模型应用"也是硬条,我看着都替还在只写传统模型的同行捏把汗。

圈子里的卷法也变了。有的团队把代码量和Token用量排成榜,末位三个月走人。我没亲历,但听着明白:光把离线指标调漂亮,已经不够看了,得证明你这活离得开AI吗、用得上AI吗。

那阵子我翻了不少自述。有个大厂的人判断"未来只需过去五分之一的工程师,八成会被淘汰",话糙,但身边确实有人在"陪跑"——活还在,但要求悄悄换了。最真实的压力样本还是年龄:脉脉上35岁以上程序员只占17.2%;一个39岁的Java老哥,干15年年薪70万,2026年初被裁,投30份简历只拿3个面试。我没做那么久,但推荐算法这行更新快,怕的不是被裁,是手里的功夫突然不值钱。

还有个细节刺我:有公司把技术文档整组裁了让AI出文档。我们算法侧的文档、特征说明,本来就是重复劳动,真要被替,我一点都不意外。圈里也流传一些活法:有人靠多年业务和管理经验转去做提示词和模板,接私活把收入慢慢拉回来;也有资深专家转去做大模型架构。听着踏实,但都不是"学会就安全",是把原来的积累挪了个地方接着用。

我有个前同事,37岁Java架构师,用半年转去带队做AI智能客服。他跟我聊,说难的不是学新东西,是承认旧本事不够用了。这话我一直记着——它比任何告警都管用。

二、接触:我硬着头皮把大模型接进pipeline

真正动手,是那个重构项目推到我头上。躲不过,就学。

第一步不贪大。我没上来就替换排序模型,而是先用大模型做query理解和召回增强:把用户的搜索词、行为序列喂进去,让它产出一批语义召回候选,再和原来的倒排召回融合。跑下来,长尾query的覆盖确实好了一些——这是传统关键词匹配够不着的。头一回上线,我贪快没加缓存,晚高峰延迟飙了,被工程同学追着问。那之后我才老实补降级和限流。

工具上,我用的是公司内接入的大模型和现成的推理服务,外加自己写的提示词和融合逻辑。过程不算顺:大模型延迟高,我得想怎么缓存、怎么降级;它偶尔胡说,我得加校验,比如校验候选ID是否真在库里。那两个月我补了不少工程的东西——服务化、批处理、兜底策略——这些我以前是不碰的。

一个做后端的朋友看我折腾,说他们组现在"一句代码不写,只给AI下指令",产出翻了好几倍。我羡慕不来,推荐这行的准确性容错低,AI出的东西我每行都得审。

融合那段最磨人:语义召回和倒排召回的候选怎么打分排序,我试了加权、试了重排,最后用一层轻量模型当裁判。这活原来没有,是我新长出来的。提示词也得调:一开始我只写"理解用户意图",它答得漂;后来我喂了真实query样本和好坏示范,才稳下来。它不是替我思考,是替我扛住重复,把我的精力腾到"判断"上——这点想通后,我反而没那么怕了。

我现在怎么判断要不要用大模型,也有了自己的一套土办法:先看这需求容不容错,再看长尾覆盖够不够,最后算算成本和延迟扛不扛得住。三关过了才上,不过就老办法顶着。上个月一个长尾搜索场景,用语义召回把空结果率从百分之八压到百分之二,这事我以前真没招。

三、现状改变:从调公式的人,变成AI应用加业务判断的人

大半年下来,我日常变了。

以前我大部分时间在调特征、看离线指标。现在我更多在想:这个需求该不该用大模型?它出的候选怎么和原排序稳稳融在一起?哪类query适合语义召回,哪类还是老办法靠谱。说白了,我从"调公式"挪到了"决定怎么用AI、用在哪"。

举个具体的:以前周一我花半天调上一周的特征,现在那半小时就看完,剩下时间用来想"下个场景该不该让AI上"。省下的不是时间,是注意力。

现在周会我先抛的不再是"这版AUC涨了零点几",而是"哪类query适合语义召回、哪类老办法更稳、上线后成本多了多少"。leader开始把我当那个"懂该不该上AI"的人。现在我把"该不该上AI"当成每个需求的第一问,这在半年前不可想象——那时候我只问"模型怎么调"。

工程短板暴露得很直白。原来我写个离线脚本就行,现在要懂线上服务、要会和工程团队对接接口、要算成本和延迟。这半年我补的这些,比算法本身还累。组里现在分两种人:一种还在精雕传统模型,路越走越窄;一种开始把AI当工具嵌进业务,慢慢往"既懂算法又懂落地"靠。我算后者,但走得磕磕绊绊。

我开始带新来的同学看怎么把AI嵌进业务,这活以前归技术Leader,现在归我——因为落地这段我最熟。对业务侧,我也主动参与需求评审,而不是等排期排到我。

我也清楚自己缺哪块:对大模型的训练、微调,我基本外行,真要做深得另补。收入结构没变,没涨薪没逆袭。周报里我写的从"优化X个特征"变成了"上线Y个AI增强召回场景",leader看得懂,但离"安全"远得很。大模型重构才刚开始,我手里的传统功夫还在折旧。

收尾

写这些不是吓你,也不是替你打包票。我就是个干了6年推荐的普通算法,被项目推着碰了AI,摔了几跤才摸到点门道。AI没让我一夜成架构师,它只是把"只会调公式"那条路越走越窄,又把"会用AI解业务问题"这条缝撑开了一点。路怎么走,每个人自己掂量。我能确定的只有一句:别等手里的功夫不值钱了,才第一次认真看它。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇
​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书
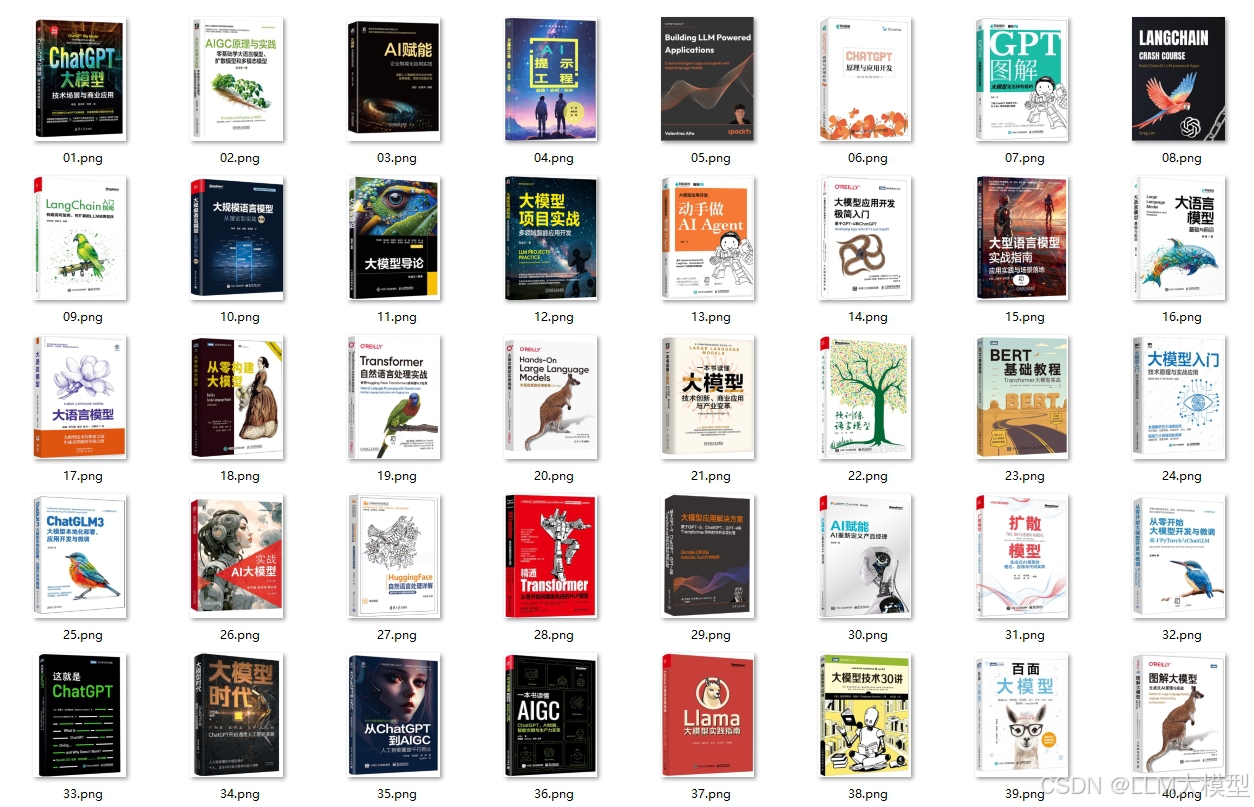
在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:
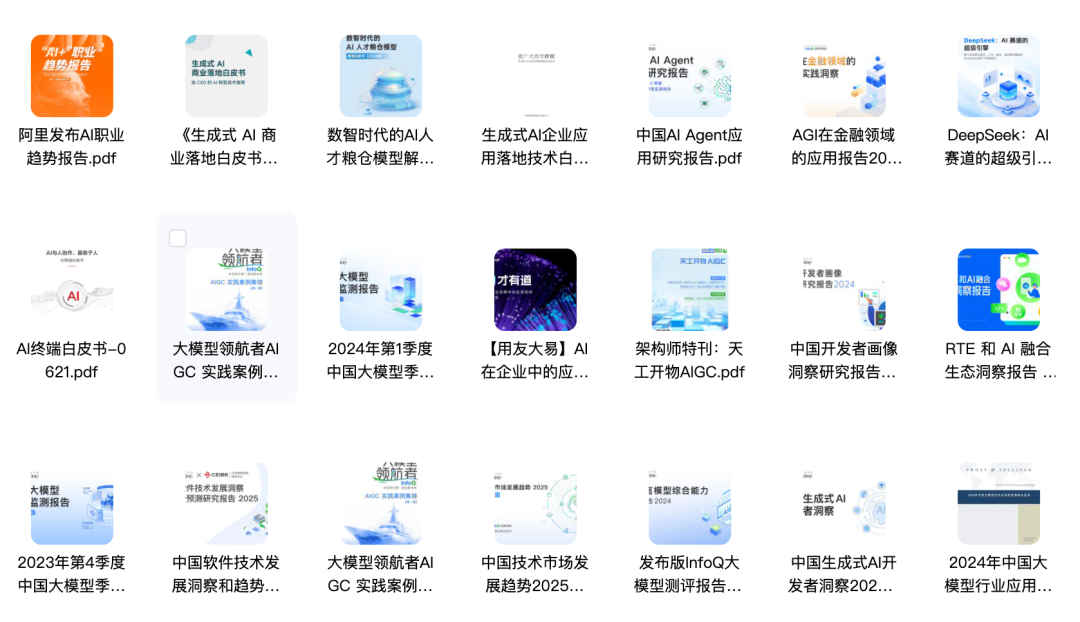
  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!
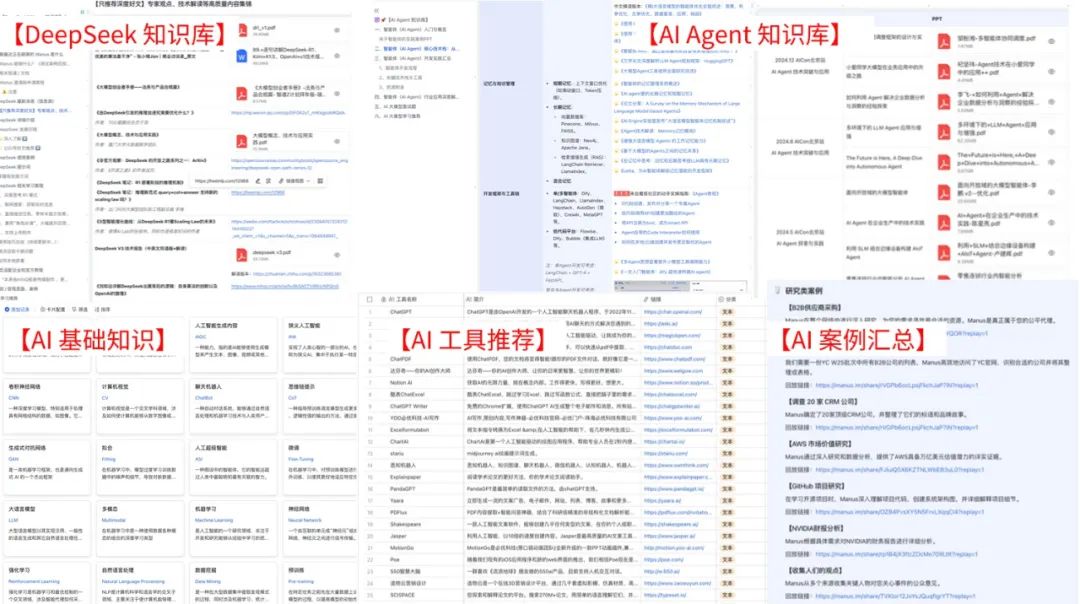
1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:
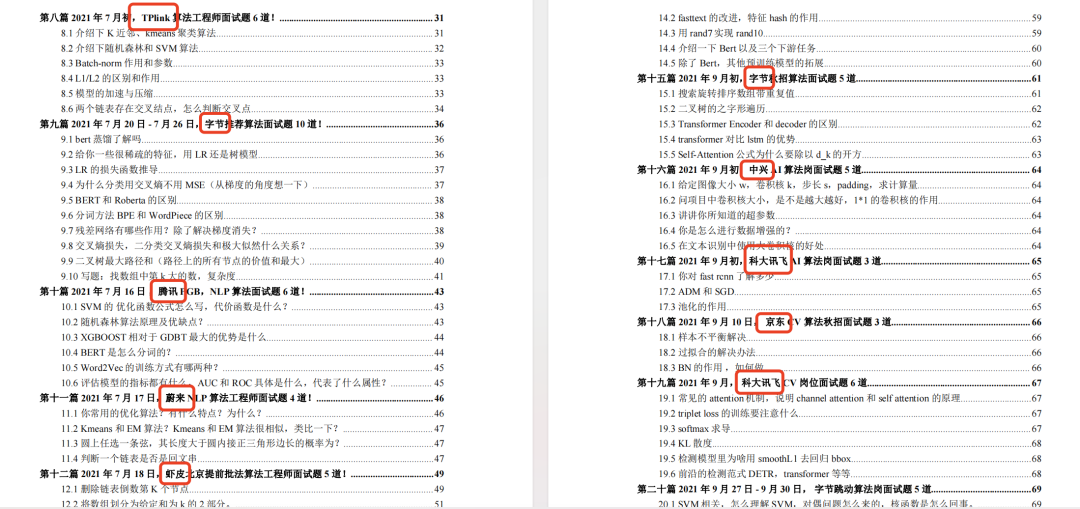
2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:
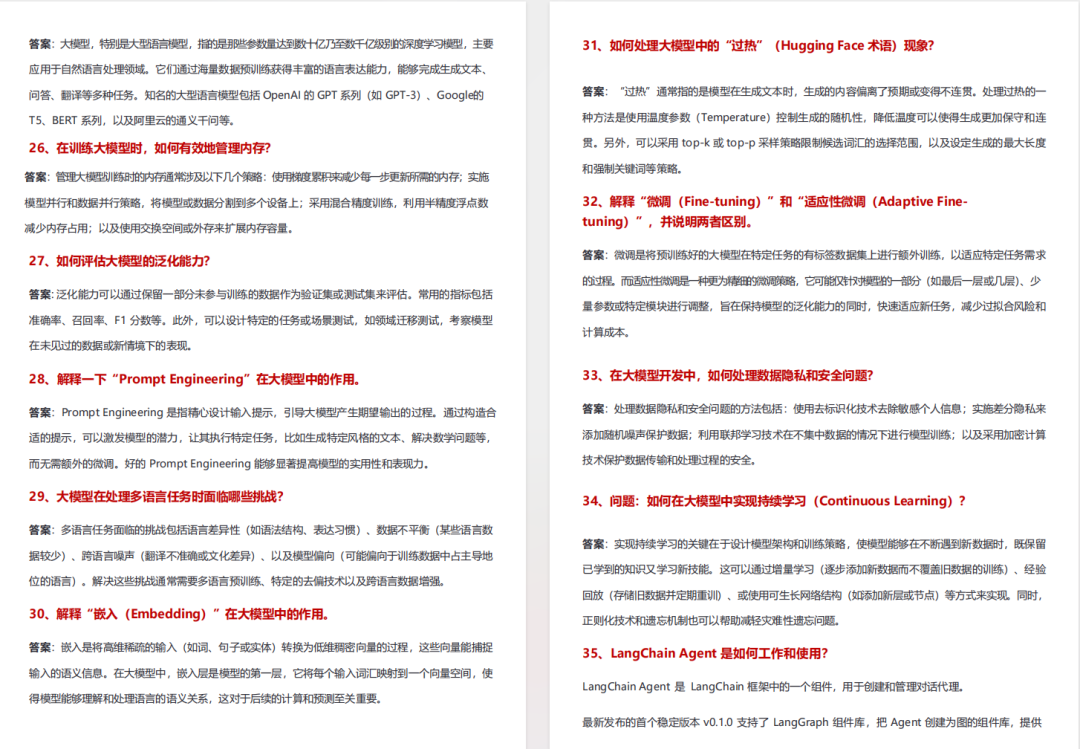
3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

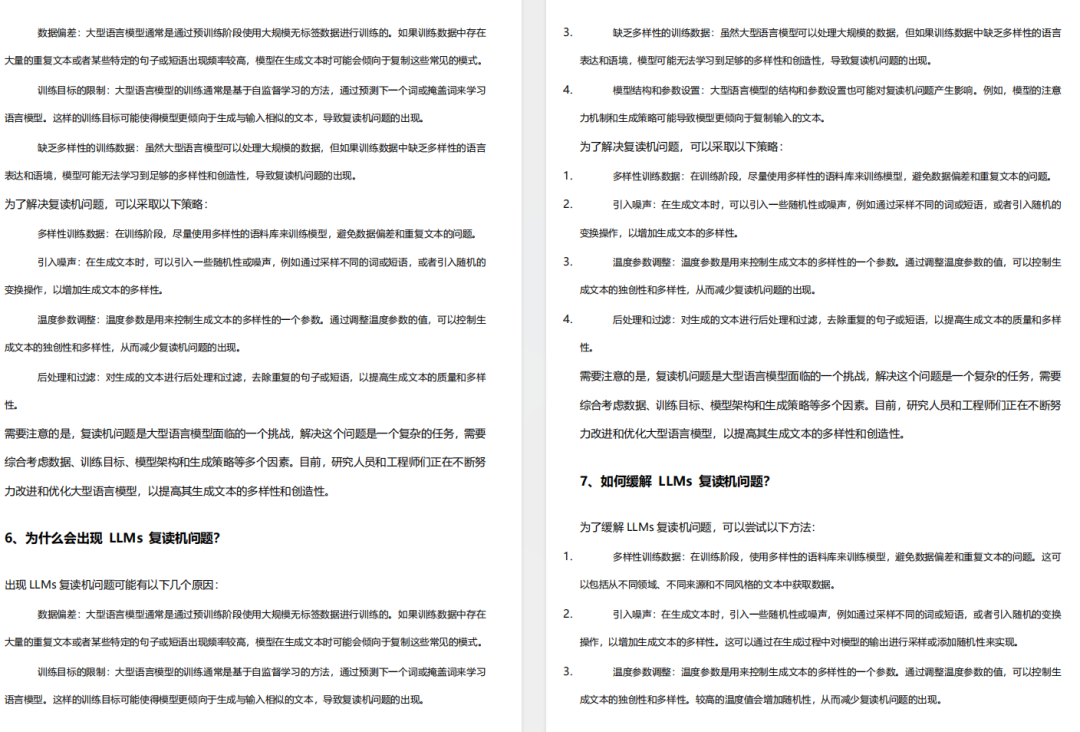
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!
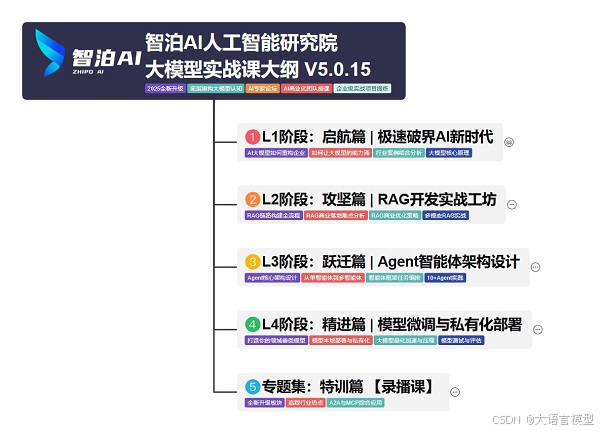
在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。
img

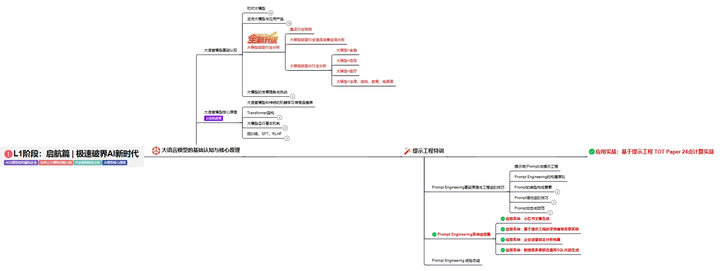
L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。
img

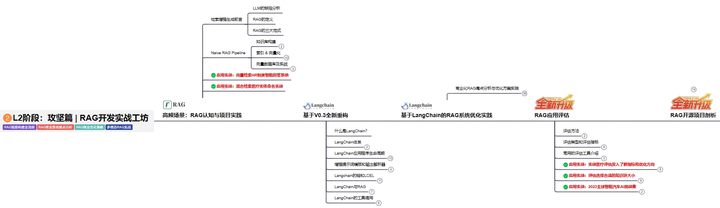
L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。
img

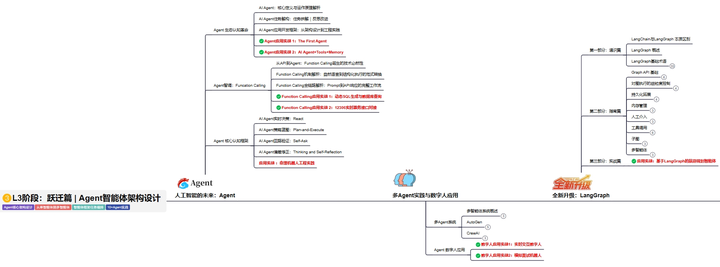
L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。
img

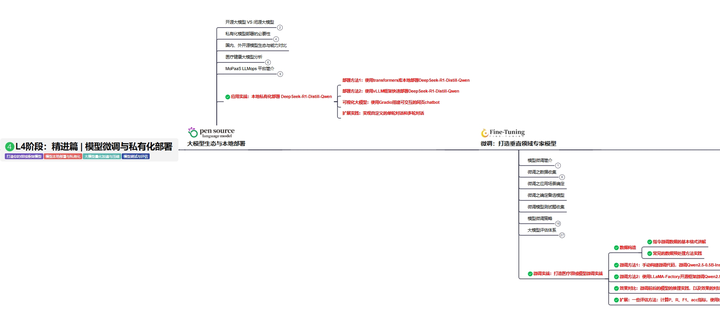
L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。
img

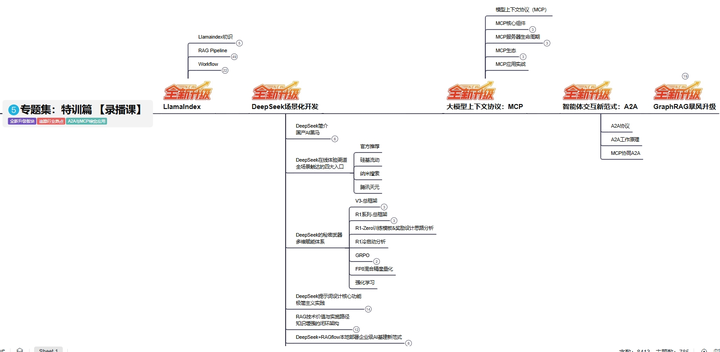
L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

AI产品经理6周入门指南:从零基础到项目实战的完整学习路线 在人工智能技术快速渗透各行各业的今天,产品经理的角色正在发生深刻变革。传统产品经理管理的是确定性逻辑,而AI产品经理需要面对模型效果的不确定性,理解大模型、机器学习等核心技术原理,掌握提示词工程、RAG等落地方法。这一岗位的核心价值在于,将AI技术能力转化为可落地的产品方案,解决真实业务场景中的效率与体验问题。无论你是刚入行的新人,还是寻求转型的传统产品、运营或研发从业者,都需要一套系统化的学习路径。本文梳理了从能力模型构建、技术知识储备、项目实战演练到简历面试准备的全流程方法,规划了一份为期6周的进阶学习 阅读详情

相关推荐

大模型对齐三把刀:RLHF、DPO与软偏好标签实战解析

大模型对齐(Alignment)是让AI输出符合人类真实偏好的核心技术,其本质是将模糊、多维、带语境的人类偏好转化为可计算的数学信号。从基础原理看,它依赖偏好建模、策略优化与损失函数设计三大支柱;技术价值在于突破‘正确但无感’的输出瓶颈,提升回答的可信度、舒适度与任务完成率;典型应用场景覆盖法律咨询、医疗问答、客服助手等需高可靠性与强人机协同的领域。本文聚焦RLHF、DPO和Soft Preference Labels三大主流方法,深入剖析其数学逻辑、部署成本与业务适配性,尤其强调软偏好标签对人类判断灰度的

weixin_30621959的博客 373

推荐系统全局优化:字节全链路、LinkedIn动态召回与Target混合搜索的工程启示

推荐系统正从传统的分段流水线走向全局优化,核心在于打破召回、粗排、精排之间的目标割裂,以及搜索与推荐之间的产品边界。字节跳动提出的统一全链路,通过样本校正和共享表征让各阶段优化方向对齐;LinkedIn的动态多目标召回,则基于实时会话状态学习权重,解决多意图场景下静态权重失效的问题;Target的混合搜索将倒排索引与向量召回融合,应对模糊Query与明确的购买意图交织的电商场景。三者共享同一底层逻辑:样本组织与表征共享比模型结构创新更能带来收益,实时反馈也正取代离线统计成为系统演进的驱动力。对工程团队而言,

weixin_28235513的博客 224

Qwen3.6-Plus深度解析:MoE架构与百万上下文的工程实践

大语言模型的长上下文与高效推理能力,正从参数竞赛转向架构创新。混合专家模型(MoE)通过稀疏激活,在有限算力下实现高参数量与低计算开销的平衡;100万token上下文不再依赖暴力缓存,而是依托分层稀疏注意力与语义记忆单元实现精准召回。这种技术路径显著提升模型在编程理解、跨文档推理和多模态因果分析等工程场景中的实用性。Qwen3.6-Plus作为典型代表,将MoE架构与长上下文能力深度融合,展现出可调试、可验证、可集成的AI工程组件特质,为后端开发、技术文档生成、代码审查等真实生产环境提供可靠支撑。

weixin_33800463的博客 948

ADHD症状检索实战:稀疏检索+语义召回+LLM重排序混合管道

在信息检索领域,稀疏检索与语义检索是两种互补的基础技术。BM25等稀疏方法依赖词项统计,擅长精确匹配专业术语,但难以处理同义表达;而基于句向量的语义检索能捕捉深层语义,却对领域数据和否定细节敏感。为兼顾召回率与精度,工程上常采用混合召回策略,先以低代价筛出候选集,再引入LLM重排序进行精读式判断。这种Sparse+Semantic+LLM Reranking的三段式管道,已在RAG、搜索引擎和文本分析中广泛验证。当面对心理健康领域的ADHD症状句识别时,用户口语化表达与临床术语之间的鸿沟使得单一模型力不从心

weixin_33991418的博客 409

RAG理解

RAG,全称 Retrieval-Augmented Generation,中文叫“检索增强生成”。让 LLM(大语言模型)在回答问题之前,先到外部知识库里去“翻书”,找到相关资料,然后结合这些资料来生成答案。你开了一家电商公司,技术团队训练了一个内部客服机器人。现在有个用户问:“我 3 月份买的那台洗衣机还在保修期内吗?GPT 根本没有你公司的任何内部数据,它只能瞎编一个回答,或者老实说“我不知道”。

ysct_999的博客 1479

WeDetect:开放词汇目标检测的双塔检索新范式

目标检测正从传统回归范式迈向开放词汇理解,其核心在于如何实现视觉与语言模态的高效对齐。WeDetect提出‘检测即检索’理念,摒弃复杂融合结构,采用解耦双塔架构——视觉塔专注像素级特征提取,语言塔建模文本语义空间,通过余弦相似度完成跨模态匹配。该设计天然支持零样本迁移与实时新类别扩展,显著提升GPU利用率与端到端吞吐量。在小目标识别、遮挡鲁棒性及多粒度场景理解等关键挑战上表现突出,为工业质检、AR交互、遥感分析等需灵活语义定义的落地场景提供新路径。

weixin_30475039的博客 427

2026大模型面试:从背知识到考判断力,如何高效准备?

大模型技术的快速迭代让行业对人才的要求从'知识掌握'转向'工程决策力'。随着RAG、Agent、模型微调与推理部署等场景的普及,企业更看重候选人在复杂项目中定位问题、权衡方案的能力。无论是基于vLLM的本地部署,还是多模态模型的应用落地,每一个技术环节背后都隐藏着可被追问的实战细节。本文从面试官视角拆解大模型岗位的考察逻辑,覆盖简历呈现、项目表达与高频追问路径,帮助求职者理解如何将真实工程经验转化为可信任的能力证明。

weixin_30621959的博客 409

人工智能训练师三级·错题诊断手册40题|5大易错类型+避坑指南+同类题推荐

人工智能训练师三级易错题诊断手册摘要 本文精选40道高频易错题,划分为5大易错类型,帮助考生针对性提升: 1. 概念混淆型(10题) 精确率vs召回率:精确率关注预测为正的准确性,召回率关注实际正类的覆盖率 过拟合vs欠拟合:过拟合表现为训练好测试差,欠拟合表现为两者都差 混淆矩阵要素:TP/FN/FP/TN的区分关键在于"真假看对错,阴阳看结果" ROC曲线:纵轴为TPR(真阳性率),横轴为FPR(假阳性率) F1值:是精确率和召回率的调和平均数 2. 计算失误型(6题) 主要涉及模型评估指标的计算错误

白话机器学习 91

大模型幻觉治理:根因分析与全链路防控体系实践

你好! 这是你第一次使用# 大模型幻觉治理:根因分析与全链路防控体系实践大模型一本正经地编造事实,已经不是一个新鲜话题。它可能把不存在的论文引用得煞有介事,可能给患者推荐错误的用药剂量,可能把过时的法规说成现行有效。业界把这类现象统称为"幻觉"(Hallucination)——模型生成的内容看似流畅可信,实则与事实不符。幻觉之所以顽固,是因为它的根源埋在大模型的工作机制里。大模型本质是一个"接续预测器":它根据上下文预测下一个最可能出现的 Token,而不是去"查证"事实。它的所有知识都压缩在参数里,训练数

yonggeit的博客 65

【信息科学与工程学】【通信工程】第二百 四十五篇 “意图网络/意图驱动网络(Intent-Based Networking, IBN)1001 意图网络中的任务01

意图网络任务;1. 意图存在性公理:∀需求∃意图表达 2. 可满足性公理:合法意图必可被满足 3. 可验证性公理:意图实现必可验证 4. 可优化公理:意图实现可优化 5. 可组合公理:简单意图可组合为复杂意图 6. 可分解公理:复杂意图可分解为简单意图 数学工具族 → 在IBN/ADN中的落点 集合论与逻辑:意图匹配域、ACL五元组、LTL/μ-calculus合规校验 图论:拓扑、SFC、依赖DAG、跨域意图图、SRv6路径 线性/非线性优化:QoS、容量、切片资源、节能(LP/MILP/凸优化) 排队论

weixin_49199313的博客 34

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

「文智助手」全场景办公AI助理AI+OPC全流程实践方案(大赛作品)

jks212454的博客 445

51c大模型~合集111

OpenAI 的某发言人表示:「为了提高清晰度和安全性,我们增加了一个额外的后处理步骤,其中模型会审查原始的思维链,删除任何不安全的内容,然后简化某些复杂的思维。可以看到,虽然 ChatGPT 确实完成了任务并展示了总结版的思维链,但似乎并未如 OpenAI 发言人说的那样给出与提示词语言同样语言的总结版。北大-灵初联合实验室表示,Align-DS-V的多模态强推理能力是VLA模型大脑端的核心,接下来的研究训练计划,是利用多模态推理模型的跨模态穿透能力,实现action穿透,最终实现真正高效的VLA模型。

whaosoft~aiotの开发板商城 2320

LTspice仿真报错Timestep too small?5种实测有效的解决方法(附详细参数配置)

本文针对LTspice仿真中常见的“Timestep too small”报错,提供了5种经过实测有效的解决方案。从理解错误根源入手,详细介绍了调整求解器、仿真参数、优化精度容差、设置初始条件、为理想元件添加寄生参数以及使用高级指令等具体方法,并附有详细的参数配置步骤,帮助工程师快速定位并解决仿真收敛问题,提升电路设计效率。

weixin_29213655的博客 282

Ai Agent 星球

Ai 的巨大洪流下,该如何成为时代的宠儿

码刀攻城 951

开关电源PCB安规设计避坑指南:从光耦开槽到变压器挡墙,这些细节决定认证成败

本文深入解析开关电源PCB安规设计中的关键细节,包括光耦开槽、变压器挡墙工艺等12个致命要点。通过实际案例和工艺参数表,揭示如何避免认证失败,特别强调爬电距离和电气间隙的精确控制,助力工程师提升产品安全性和认证通过率。

weixin_42548893的博客 205

【阿里云大模型高级工程师ACP习题集】2.3 优化提示词改善答疑机器人回答质量

【摘要】这是我精心整理出对应的习题集,里面足足有 30 道题目,从基础概念到深度拓展,全方位覆盖章节重点、难点。不管你是想检验自己的学习成果,还是想针对薄弱环节进行强化训练,它都能完美适配!

davidkorhenn的博客 1633

人工智能世界观(认知篇)

本文系统梳理了人工智能(AI)的基础知识体系,重点解析了大模型(LLM)的核心原理、技术演进及应用边界。主要内容包括: AI基础认知:从规则驱动到数据驱动的范式转变,强调AI=数据+算法+算力的技术本质,区分了弱AI与通用AI(AGI)的能力差异。 技术发展史:回顾AI七十年发展,从符号主义、专家系统到深度学习的五次技术浪潮,重点分析Transformer架构如何推动大模型革命。 大模型原理:详解LLM的三大支柱(参数量/数据量/算力),揭示自回归生成和注意力机制的工作逻辑,对比GPT与BERT的技术路线差

轻舟已过万重山 566

VS2015+Qt+OpenCV+open62541开发过程(05_VS2015中使用OPCUA open62541通过Kepware读写PLC数据)

此外还需要所需lib包:WS2_32.Lib(opcua通讯用到的库,opcua使用socket通讯,需使用此库),添加#pragma comment(lib,"ws2_32.lib") 语句,有的文章说需要添加ws2_32.lib文件或ws2_32.dll到项目资源中,貌似影响不大。2.在VS中选择x64平台会报错,选择x86平台可以用,应该是ws2_32.lib相关的库不支持64位,目前没有解决,继续后面的实验,看看用Qt后是否可以解决。6.VS中建立的变量,与读取的OPC点数据类型注意对应。

zzh17的博客 1864

AI 问数真的能替代 BI 报表吗?

AI问数赋能自然语言查询,提升临时分析效率,但无法替代传统报表。报表适用于稳定输出与持续监控,AI则擅长探索性提问。企业用好AI问数,关键在于夯实数据模型、统一指标口径、健全权限体系与结果校验机制。合理组合报表、仪表板与AI,才能实现高效、准确的业务洞察。

葡萄城技术团队博客 332

利用gprMax与Matlab实现SFCW雷达信号的高效仿真与优化

本文详细介绍了如何结合gprMax与Matlab实现SFCW雷达信号的高效仿真与优化。通过利用gprMax获取地下场景的冲激响应,并在Matlab中运用卷积与信号处理技术,可大幅提升SFCW雷达系统仿真的效率与灵活性,为探地雷达研究与设计提供强大工具。

book8的博客 710

Ansys 19 Mechanical 流体密封分析

start point是一个特殊的概念,在仿真中ansys将从start point开始搜索会发生流体渗漏的点,可以简单理解为从start point开始,向四周逐个节点比较节点上的接触压紧力与流体压力,如果流体压力大于压紧力,则发生渗漏。事实上此处的最后一个参数是指定start point类型的,为1代表这是一个“open”的start point。在通常情况下,如果不人为指定start point,程序会自动寻找指定流体压力面的“边界”,对于二维情况,就是曲线的两个端点,对于三维情况就是曲面的边线。

Dio980的博客 1537

【从零理解 Spring AI · 12】MCP 的两种角色:做客户端还是做服务端

上一篇讲了 MCP 的概念:标准协议、三大角色、M+N 替代 M×N。

nice_lcj520的博客 612

Windows10环境下激活虚拟环境报错【source : 无法将“source”项识别为 cmdlet、函数、脚本文件或可运行程序的名称】

在使用Django创建Web程序前,需要创建一个虚拟的工作环境,在使用【source ll_env/bin/activate】命令激活虚拟环境时报错:source : 无法将“source”项识别为 cmdlet、函数、脚本文件或可运行程序的名称。请检查名称的拼写,如果包括路径,请确保路径正确,然后再试一次。所在位置 行:1 字符: 2。

提供C#相关开发 、云计算、运维测试、网络安全相关技术分享与服务,有意向可联系。 1万+

ChatGPT、Perplexity、Gemini 与 AI Overviews 引用对比:谁的引用更可信

AI 引擎的引用机制差异很大:ChatGPT 以行内引用加 Sources 列表呈现来源,Perplexity 几乎逐句可溯源,Gemini 在回答中内嵌相关来源链接,AI Overviews 则把多源聚合答案与来源列表一起放在搜索结果顶部。本文从引用透明度、来源偏好、可干预性 3 个维度对比这 4 个引擎,并给出 GEO 的 3 点启示,帮企业在多引擎环境下提升被引用的概率。

淡然一笑 的专栏 264

SAP 批次管理

批次管理: 业务场景: 批次常用于:采购、生产、SD等: 1、先进先出,先入库的先出库(如何实现),基于入库时间来自动确定出库策略。 2、追塑:基于批次进行产品质量追溯 例如订单MTO ---> PP ----> MM(批次关联)。SO—>PP工单 --> 预留 --> 发料(基于批次A\B\C)-->产成品入库-->批次入库D--> ...

willieyuan的博客 1万+

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

抽象主义人工智能和生命体AI的内在联系

彭军辉提出“抽象主义人工智能”作为第四大AI范式,批判符号主义、连接主义、行为主义剥离生命本体的误区,确立“智能是现象,生命是本体”的核心公理。主张原生智能必须依附具备存续诉求的生命本体,提出“生命体AI理论”,构建七层演化阶梯与自闭环工程框架,强调智能不可跳过底层存续机制直接模拟语言。该体系为生成式AI提供科学边界,推动从“仿真表象”向“原生智能”的范式跃迁,开辟硅基人工生命新赛道。

抽象主义人工智能和生命体AI 201

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

上一篇: RAG 到底是怎么把大模型「接入企业」的——一份能直接跑通的检索增强生成实战
下一篇: 前端程序员转AI大模型开发,这一年我踩过的坑和最实用的学习路线
Llama-Turbo
博客等级 码龄4年 9901粉丝 2025原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值