


RAG概念
RAG(Retrieval-Augmented Generation,检索增强生成)是一种结合信息检索与文本生成的技术,旨在提升大语言模型(LLM)生成内容的准确性和时效性。其核心思想是通过外部知识库动态补充生成所需的信息,从而弥补传统LLM仅依赖训练数据、可能产生“幻觉”或过时回答的缺陷。
简单来说,RAG 就像给 AI 配了一个知识库,让 AI 回答问题前先查一查特定的知识库来获取知识,确保回答是基于真实资料而不是凭空想象。
通过 RAG 技术改造后,AI 就能:
- 准确回答关于特定内容的问题。
- 在合适的时机推荐相关课程和服务。
- 用特定的语气和用户交流。
- 提供更新、更准确的建议。
Spring AI 为我们实现RAG提供了全流程的支持,接下来就用 Spring AI 实现一个基于本地知识库的 AI 问答。
01
准备环境
开发工具:IDEA
构建工具:Gradle
开发环境:JDK21(17+即可)
技术框架:SpringBoot3.3.0 + Spring AI Alibaba 1.0.0-M6.1
02
引入Gradle依赖
这里我只引入核心依赖,其他的SpringBoot等基础依赖就不做展示了。
implementation 'com.alibaba.cloud.ai:spring-ai-alibaba-starter:1.0.0-M6.1'
implementation 'org.springframework.ai:spring-ai-markdown-document-reader:1.0.0-M6'
03
准备知识库文档
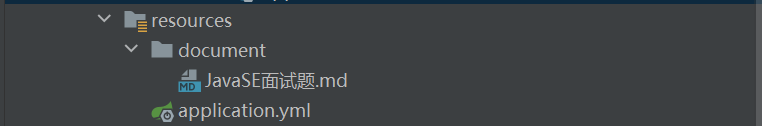
文档可以是Text、PDF或Markdown文件等,这里我们就以Markdown文件为例。
将文档放在resources的document目录里下:
04
文档读取
对自己准备好的知识库文档进行处理,然后保存到向量数据库中。这个过程俗称 ETL(抽取、转换、加载),Spring AI 提供了对 ETL 的支持。
ETL 的 3 大核心组件,按照顺序执行:
- DocumentReader:读取文档,得到文档列表。
- DocumentTransformer:转换文档,得到处理后的文档列表。
- DocumentWriter:将文档列表保存到存储中(可以是向量数据库,也可以是其他存储)
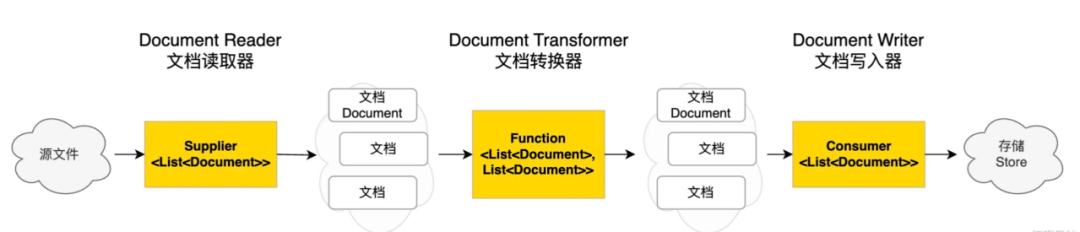
通过 DocumentLoader 文档加载配置指定读取文档的细节,比如是否读取代码块、引用块等。还指定了额外的元信息配置,提取文档的文件名(fileName)作为文档的元信息,可以便于后续知识库实现更精确的检索。
@Component
@Slf4j
public class DocumentLoader {
private final ResourcePatternResolver resourcePatternResolver;
public DocumentLoader(ResourcePatternResolver resourcePatternResolver) {
this.resourcePatternResolver = resourcePatternResolver;
}
/**
* 加载多篇Markdown文档
* @param
* @return java.util.List<org.springframework.ai.document.Document>
*/
public List<Document> loadMarkDownList() {
List<Document> documentList = new ArrayList<>();
// 加载Markdown文档列表
try {
Resource[] markDownList = resourcePatternResolver.getResources("classpath*:document/*.md");
for (Resource markDown : markDownList) {
String filename = markDown.getFilename();
// 加载markdown文档构造器
MarkdownDocumentReaderConfig documentReaderConfig = MarkdownDocumentReaderConfig.builder()
// 有分隔符就创建新文档
.withHorizontalRuleCreateDocument(true)
// 是否包含代码块
.withIncludeCodeBlock(true)
// 是否包含引用格式
.withIncludeBlockquote(true)
// 添加额外信息
.withAdditionalMetadata("filename", filename)
.build();
MarkdownDocumentReader markdownDocumentReader = new MarkdownDocumentReader(markDown, documentReaderConfig);
documentList.addAll(markdownDocumentReader.read());
}
} catch (IOException e) {
BizException.of("加载Markdown文档列表失败:", e);
}
return documentList;
}
}
05
向量转换和存储
为了实现方便,我们使用 Spring AI 内置的、基于内存读写的向量数据库 SimpleVectorStore 来保存文档。
SimpleVectorStore 实现了 VectorStore 接口,而 VectorStore 接口集成了 DocumentWriter,所以具备文档写入能力。
实现初始化向量数据库并且保存文档的方法。代码如下:
@Configuration
public class VectorStoreConfig {
@Resource
private DocumentLoader documentLoader;
@Bean
VectorStore vectorStore(EmbeddingModel dashscopeEmbeddingModel) {
SimpleVectorStore simpleVectorStore = SimpleVectorStore.builder(dashscopeEmbeddingModel)
.build();
// 加载文档
List<Document> documentList = documentLoader.loadMarkDownList();
simpleVectorStore.add(documentList);
return simpleVectorStore;
}
}
06
查询增强
Spring AI 通过 Advisor 特性提供了开箱即用的 RAG 功能。主要是 QuestionAnswerAdvisor 问答拦截器和RetrievalAugmentationAdvisor 检索增强拦截器。
查询增强的原理:向量数据库存储着 AI 模型本身不知道的数据,当用户问题发送给 AI 模型时,QuestionAnswerAdvisor 会查询向量数据库,获取与用户问题相关的文档。然后从向量数据库返回的响应会被附加到用户文本中,为 AI 模型提供上下文,帮助其生成回答。
@Slf4j
@Component
public class CodeAssistantApp {
private final ChatClient chatClient;
/**
* 系统提示词
*/
private static final String SYSTEM_PROMPT = "扮演资深的软件开发专家。开场向用户表明身份,告知用户可以提出难以解决的编程问题。\" +\n" +
"            \"引导用户详述问题需求,以便给出专属解决方案。";
/**
* 初始化ChatClient
* @param chatModel
*/
public CodeAssistantApp(ChatModel chatModel) {
ChatMemory chatMemory = new InMemoryChatMemory();
chatClient = ChatClient.builder(chatModel)
.defaultSystem(SYSTEM_PROMPT)
// 拦截器
.defaultAdvisors(
new MessageChatMemoryAdvisor(chatMemory),
// 自定义拦截器,按需开启
new CustomLoggerAdvisor()
// 自定义重读拦截器,增强推理能力,增加成本,按需开启
//new ReReadingAdvisor()
)
.build();
}
/**
* 基础对话(支持多轮对话记忆)
* @param message
* @param chatId
* @return java.lang.String
*/
public String doChat(String message, String chatId) {
ChatResponse response = chatClient
.prompt()
.user(message)
// 将当前对话的 ID(chatId)传入,AI 客户端会根据这个 ID 去查找该对话的历史记录
.advisors(spec -> spec.param(CHAT_MEMORY_CONVERSATION_ID_KEY, chatId)
// 表示最多获取最近的 10 条历史消息作为上下文,供 AI 在生成回复时参考
.param(CHAT_MEMORY_RETRIEVE_SIZE_KEY, 10))
.call()
.chatResponse();
String content = "";
if (Objects.nonNull(response)) {
content = response.getResult().getOutput().getText();
}
log.info("content: {}", content);
return content;
}
}
07
与RAG知识库对话方法
/**
* RAG 知识库 对话
* @param message
* @param chatId
* @return java.lang.String
*/
public String doChatWithRag(String message, String chatId) {
ChatResponse chatResponse = chatClient
.prompt()
.user(message)
.advisors(spec -> spec.param(CHAT_MEMORY_CONVERSATION_ID_KEY, chatId)
.param(CHAT_MEMORY_RETRIEVE_SIZE_KEY, 10))
// 开启日志
.advisors(new CustomLoggerAdvisor())
// 应用知识库问答
.advisors(new QuestionAnswerAdvisor(vectorStore))
.call()
.chatResponse();
String content = chatResponse.getResult().getOutput().getText();
log.info("content: {}", content);
return content;
}
08
单元测试
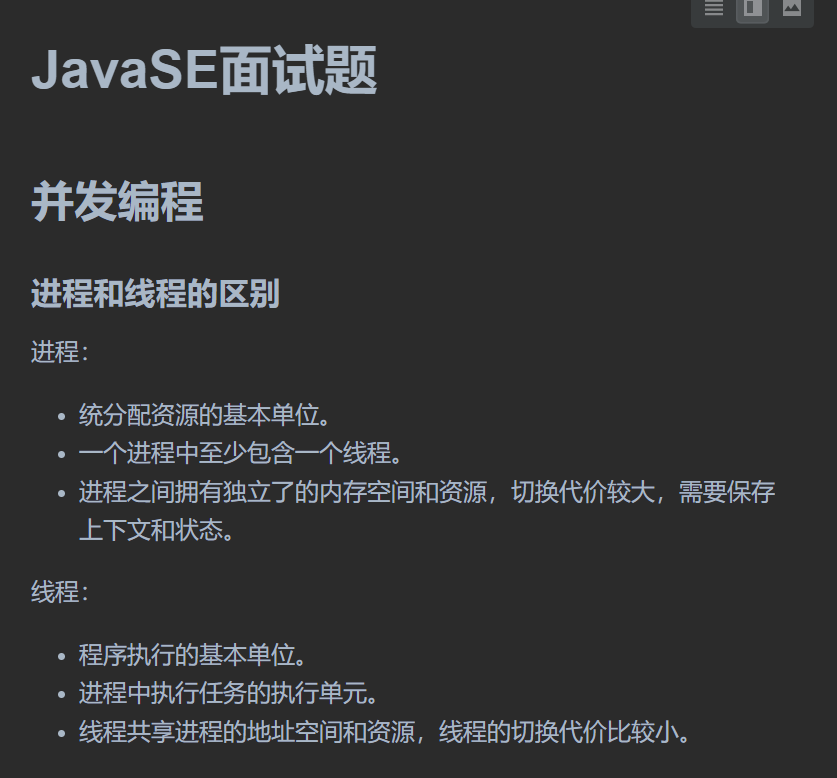
故意提问一个文档内有回答的问题。
文档部分内容:
@Test
void doChatWithRag() {
String chatId = UUID.randomUUID().toString();
String message = "进程和线程的区别";
String answer =  codeAssistantApp.doChatWithRag(message, chatId);
Assertions.assertNotNull(answer);
}
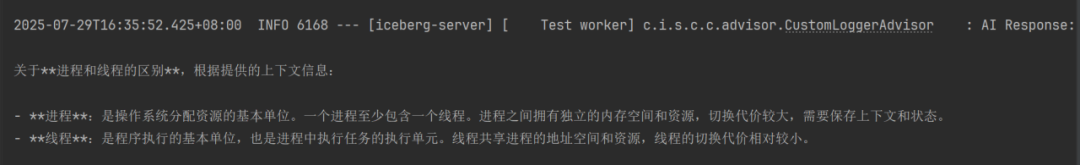
输出结果:
想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!
👇👇扫码免费领取全部内容👇👇

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势
想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:
1. 100+本大模型方向电子书

2. 26 份行业研究报告:覆盖多领域实践与趋势
报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

- 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
- 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
- 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
- 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。
3. 600+套技术大会 PPT:听行业大咖讲实战
PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

- 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
- 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
- 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
- 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。
二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走
想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位
面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点
针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题
专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:

三、路线必明: AI 大模型学习路线图,1 张图理清核心内容
刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代
L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊
L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计
L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署
L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

L5阶段:专题集丨特训篇 【录播课】

四、资料领取:全套内容免费抱走,学 AI 不用再找第二份
不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:
👇👇扫码免费领取全部内容👇👇
2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!
 3299


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


