[特殊字符] DeepSeek-R1原理解析及项目实践(含小白向概念解读)

怎么能使用DeepSeek-R1 模型? 综上所述,DeepSeek-R1 在编程辅助方面的独特优势在于其强大的推理能力、可视化的思维过程、长思维链推理能力、对标 OpenAI O1 的性能、开源与模型蒸馏支持、高效的 API 服务以及针对复杂推理问题的优化。对于需要本地部署 DeepSeek Coder V2 的用户,确保您有足够的硬件资源(236B 模型需要 80GB*8 GPU),并使用 Hugging Face 的 Transformers 库进行模型推理。通过以上步骤,应该能够顺利地使用 DeepSeek-R1 模型。 阅读详情

一、概念解读(小白向)

我们打开deepseek官网,会发现对话框之下:有两个按钮,那他们的含义如何理解🤔?最近爆火的deepseek究竟指的是哪个模型?深度思考R1与联网搜索的作用?
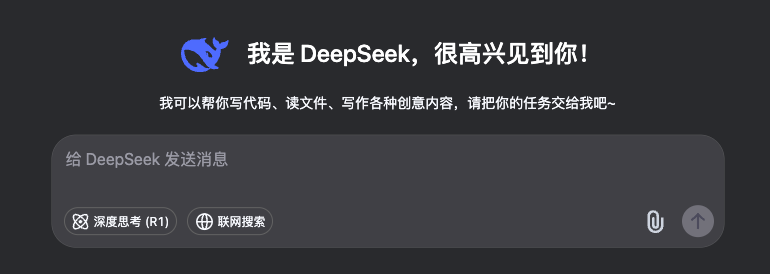
接下来对常用概念做一些入门性质的介绍:

1、联网搜索:

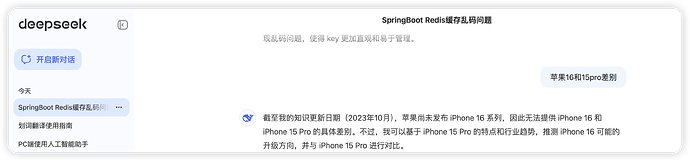
比较好理解,我们知道LLM(大语言模型)的知识是有时效性的,因为大模型知识来源于海量的离线数据训练,而一般来说,其训练数据大约滞后于其发布时间半年到一年以上。比如在 OpenAI 的模型介绍网页上,可以看到 o1 模型的训练数据截止时间为2023年十月份,而deepseek(此处指V3基座),参考其回复发现时间大约也是2023年10月。【所以对于时效性问题,LLM回答不出来实属正常。】而联网搜索,解决的就是时效性问题,当你勾选联网搜索时,你可以把其视为一个能理解你的任意自然语言问题(传统搜索引擎仅仅为关键词搜索)的AI搜索引擎。
2、深度思考(R1)

在介绍深度思考之前,我们先来了解如下常见名词的含义:

deepseek:泛指性的概念,指任意deepseek系列模型。

deepseek V3:对话模型,最新版deepseek基座模型(无深度思考能力),其指令版本具备对话能力,与gpt-4o,qwen2.5系列等模型属于同阶段模型。参数量671B,当前最强开源基座模型,但参数量巨大,完整部署大约需1300G+显存。

deepseek R1:推理模型,【也就是最近爆火的模型,由于其在相对低资源的条件下,SFT+多阶段强化学习训练出能力超强推理能力而闻名】。擅长复杂问题的推理,准确率相较于deepseek V3更高,但思考过程过长。

deepseek R1-zero:推理模型,可以理解deepseek R1的先验版本,R1-zero的训练是一个探索性的过程,它验证了RL本身对于激励base模型产生推理的能力。在这个探索结论上,才开始正式进入R1的训练。【此模型为实验性质,其能力低于deepseek R1,因而也未面向C端用户上线】

DeepSeek-R1-Distill-Qwen-xxxB:知识蒸馏版的推理模型,使用deepseek R1中间阶段的80w条训练数据,对Qwen2.5系列进行SFT指令微调的模型。(无强化学习过程,可以理解为COT思维链数据的SFT)大家平时听到的残血版,蒸馏版,大多指此版本。

二、训练原理解析

1、训练流程

Deepseek R1的训练过程可分为两阶段迭代优化,核心是通过高质量推理数据生成和RL策略提升逻辑推理能力,具体流程如下:


阶段一(Phase 1):COT数据质量提升

1.基座模型

◦使用Deepseek V3 Base(预训练模型)作为初始基座。

2.训练步骤

◦SFT训练:用初始逻辑推理数据(如COT轨迹)进行监督微调。

◦RL强化训练:进一步优化得到Model RL-1,提升推理轨迹的生成质量。

3.核心目的

◦利用Model RL-1生成更高质量的新COT数据,随后弃用Model RL-1,仅保留新数据。


阶段二(Phase 2):干净基座再训练

1.基座模型回退

◦关键策略:重新使用原始Deepseek V3 Base(非Phase 1的Model RL-1,是为了避免使用低质量数据污染的基座)。

2.数据混合

◦新COT数据:Phase 1生成的高质量逻辑推理数据使用拒绝采样的方式来筛选轨迹数据。

◦Post-training数据:加入deepseekV3非逻辑推理类数据(如通用任务),防止模型遗忘其他能力。

3.训练流程

◦再次回到base模型上,首先用这80w的新数据对它做2个epoch的sft。

◦接着执行2个阶段的RL:

▪第1阶段RL:旨在增强模型推理方面的能力。采取类似r1 zero的RL方法,使用基于规则的RM,对模型进行RL训练,以提升模型在数学、代码和逻辑方面的推理能力。(这里用的数据集应该不是那80w,是类似于zero直接构建prompt)

▪第2阶段RL:旨在针对模型的helpfulness和 harmlessness,类似于dpsk v3的训练pipeline


核心训练技巧

1.迭代数据增强

◦通过前阶段模型生成更优质数据,用于后阶段训练(类似微软rStar-Math的MSCT方法)。

2.基座模型重置

◦每轮迭代均从原始干净基座出发,避免误差累积,最大化高质量数据效用。

3.防遗忘机制

◦混合逻辑与非逻辑数据,保持模型多任务平衡性。
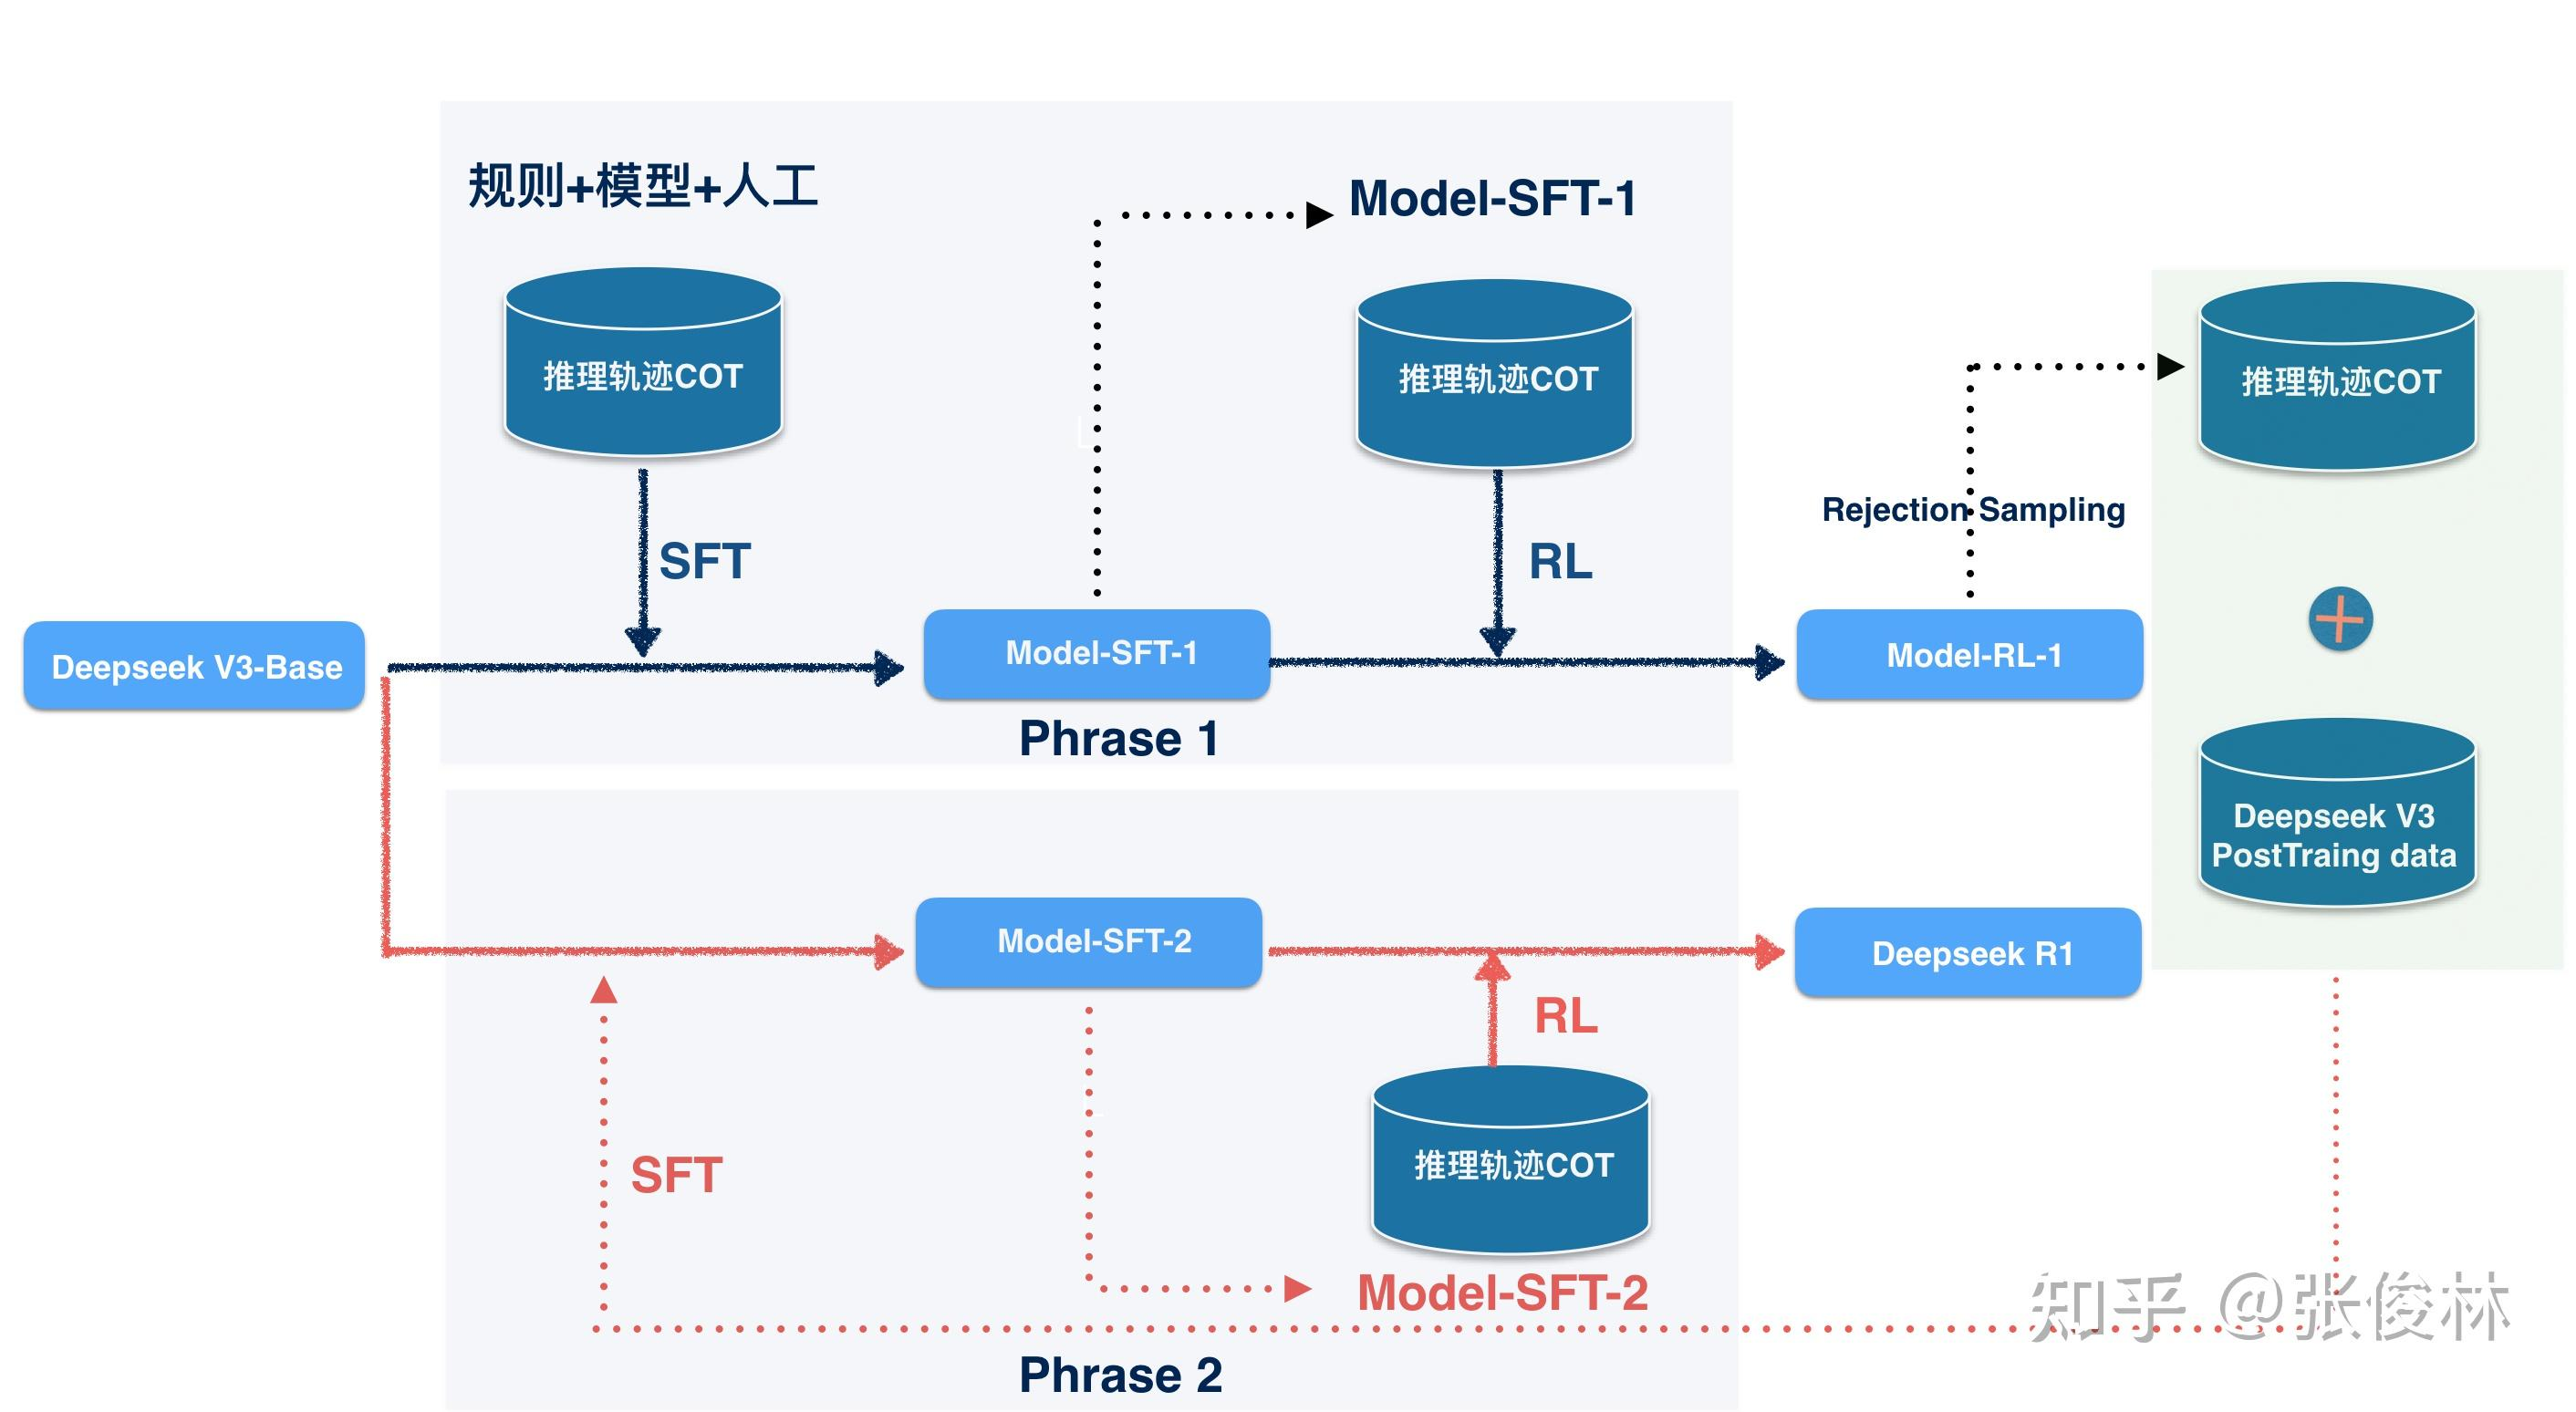

参考图片来源:复刻OpenAI O3之路:Deepseek R1、Kimi K1.5及MCTS技术路线探析-知乎

2、DeepSeek R1 的技术价值思考:

1、r1 zero证明了无需sft,直接用base model做单纯的RL,已经可以取得强大的reasoning能力。这里单纯的RL是指:没有显式提供一些真正的long cot数据让模型去背去学,我只是在sys_msg里告诉模型先思考,再回答。接着通过RL一轮又一轮的训练,模型产出的responses越来越长,且在某个时刻出现了自我评估和反思的行为。

2、随着训练steps的增加,r1 zero倾向于产出更长的response(long cot),并且还出现了反思行为。这些都是在没有外部干预的情况下,r1 zero模型在训练中自我进化的结果。

3、对于小模型,不需要依然RL,只用蒸馏就可以使得其推理能力得到显著提升(对于大模型会是怎么样的,技术报告中没有提)

三、deepseek复现-实践项目

1、高考数学测试

测试数据:《2024年高考新课标一卷数学真题》,一共19道题,满分150分。

测试方式如下

1.Claude sonnet 3.5 (直接把题目输入给模型)

2.Claude sonnet 3.5 + COT

3.Claude sonnet 3.5 + MCTS+ COT(Agent模式)

4.O1-preview (直接把题目输入给模型)

5.Qwen2.5-Math-72B (直接把题目输入给模型)

6.Deepseek-R1 (直接把题目输入给模型)

7.Deepseek-R1-Distill-Qwen-32B (直接把题目输入给模型)
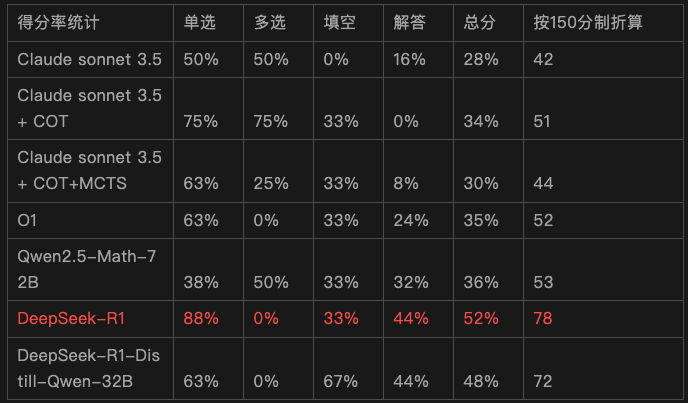
详见:

https://mp.weixin.qq.com/s/jUIHibLdO59fWTAKFMX79A

2、deepscaler

UC伯克利的研究团队基于Deepseek-R1-Distilled-Qwen-1.5B,通过简单的强化学习(RL)微调,得到了全新的DeepScaleR-1.5B-Preview。在AIME2024基准中,模型的Pass@1准确率达高达43.1% ——不仅比基础模型提高了14.3%,而且在只有1.5B参数的情况下超越了OpenAI o1-preview!

Deepseek-R1发现,直接在小型模型上用强化学习,效果不如知识蒸馏。在Qwen-32B模型上做对比实验,强化学习只能让AIME测试的准确率达到47%,但只用知识蒸馏就能达到72.6%。不过,要是从更大的模型中,通过蒸馏得到高质量的SFT数据,再用强化学习,小模型的推理能力也能大幅提升。研究证明了这一点:通过强化学习,小型模型在AIME测试中的准确率从28.9%提高到了43.1%。

https://github.com/agentica-project/deepscaler

3、Logic-RL

中科大某大四科研小组复现,在Logic Puzzle Dataset数据集下。

证明了:原始基座模型在测试集上只会基础的step by step逻辑。 但在无 Long CoT冷启动蒸馏,三阶段Rule Based RL后,模型学会了:

- 迟疑 (标记当前不确定的step等后续验证),

- 多路径探索 (Les't test both possibilities),

- 回溯之前的分析 (Analyze .. statement again),

- 阶段性总结 (Let's summarize, Now we have determined),

- Answer前习惯于最后一次验证答案(Let's verify all statements)

https://github.com/Unakar/Logic-RL

4、Open R1

国外huggingface团队复现,旨在做到完全开放复现 DeepSeek-R1,补齐 DeepSeek 所有未公开的技术细节。

https://github.com/huggingface/open-r1

四、本地实践

1、本地化部署与产品使用

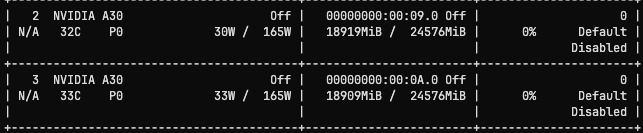
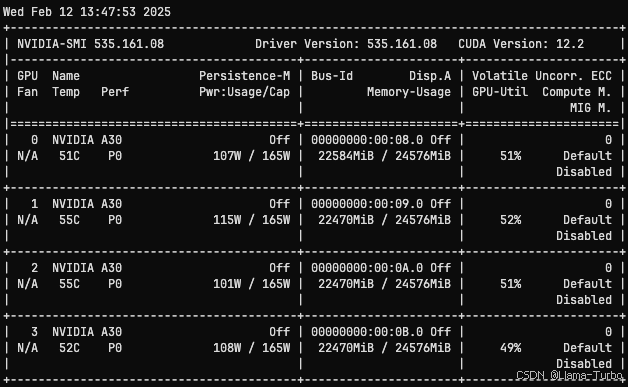
我们在RAG知识增强的问答助手5starAI项目上实践。使用VLLM部署了DeepSeek-R1-Distill-Qwen-32B-4bit版本,显存占用如下。速度实测约50Tokens/S。
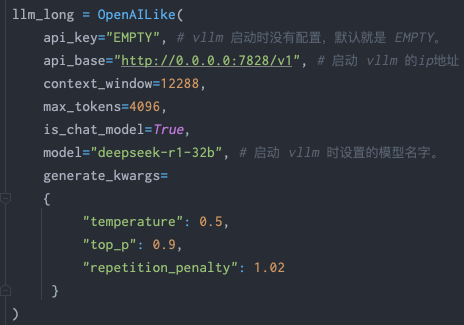
RAG场景,在Llamaindex框架下集成,部分代码如下:
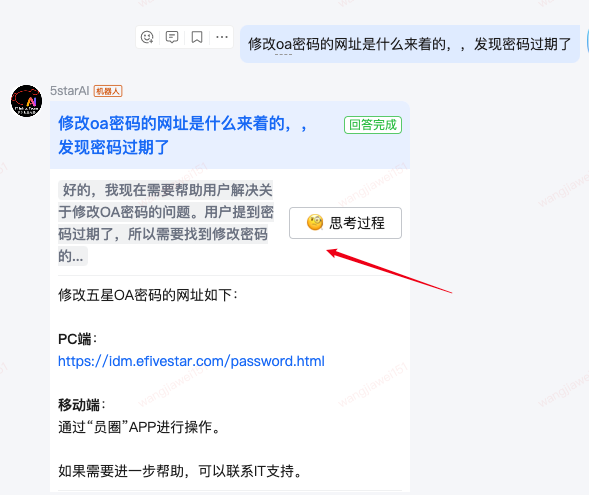
以下是应用效果截图,含思考过程:(ps欢迎大家来尝试使用或者合作,京Me搜索机器人5starAI)
2、强化学习训练实践

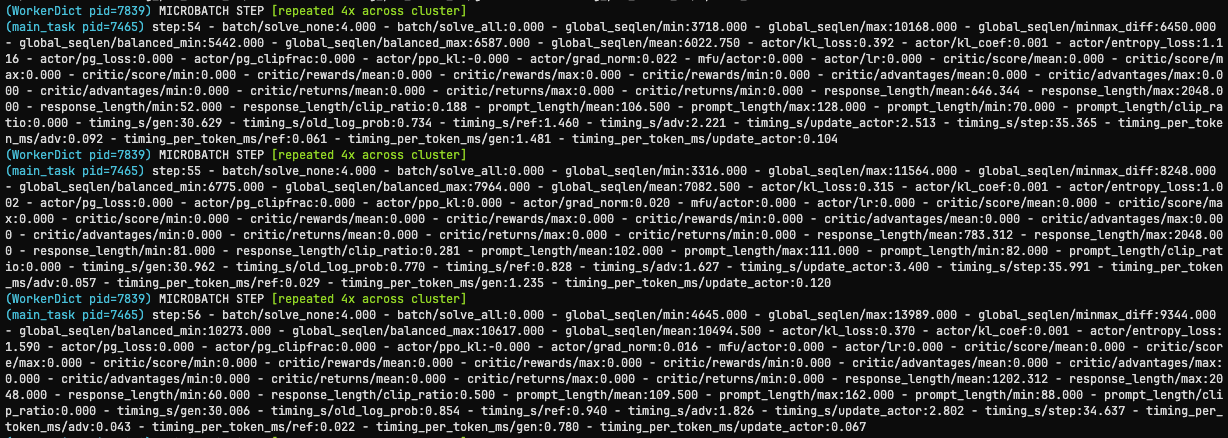
由于本地有text2SQL前置实践经验【http://xingyun.jd.com/shendeng/article/detail/31804?forumId=38&jdme_router=jdme://web/202206081297?url%3Dhttp%3A%2F%2Fsd.jd.com%2Farticle%2F31804】,并积累了相关数据集,我们计划在text2SQL任务上,使用DeepSeek-R1-Distill-Qwen-1.5B为基座(资源限制),参考https://github.com/agentica-project/deepscaler的项目经验,进行RL训练。目前正在尝试复现该项目效果中,后续将更新。
我们该怎样系统的去转行学习大模型 ?

很多想入行大模型的人苦于现在网上的大模型老课程老教材,学也不是不学也不是,基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近100余次后,终于把整个AI大模型的学习门槛,降到了最低!

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来: 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

​

一、大模型经典书籍(免费分享)

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套大模型报告(免费分享)

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、大模型系列视频教程(免费分享)

在这里插入图片描述

四、2025最新大模型学习路线(免费分享)

我们把学习路线分成L1到L4四个阶段,一步步带你从入门到进阶,从理论到实战。

L1阶段:启航篇丨极速破界AI新时代

L1阶段:我们会去了解大模型的基础知识,以及大模型在各个行业的应用和分析;学习理解大模型的核心原理、关键技术以及大模型应用场景。

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段是我们的AI大模型RAG应用开发工程,我们会去学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,我们会去学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造我们自己的Agent智能体。

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,我们会更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调。

L5阶段:专题集丨特训篇 【录播课】

全套的AI大模型学习资源已经整理打包,有需要的小伙伴可以微信扫描下方二维码,免费领取

​

大模型MoE架构原理与实战:参数规模背后的激活机制 大语言模型中的‘稀疏专家混合’(MoE)是一种突破传统稠密计算范式的新型架构,其核心在于通过动态路由机制,在每次前向传播中仅激活少量专家子网络,从而在保持模型容量的同时显著降低计算开销。该技术并非简单‘关闭’参数,而是基于语义特征实现精准计算调度,兼具高表达力与工程可行性。MoE的价值体现在推理效率提升、显存带宽优化及长尾任务建模能力增强,广泛应用于GPT-4、DeepSeek-R1等前沿模型的部署落地。理解MoE的关键,在于区分总参数量与单token激活参数,并掌握Router决策、专家负载均衡与硬件适配 阅读详情

相关推荐

中文大模型能力地图:DeepSeek、通义、混元、文心、豆包实战选型指南

大语言模型不是参数堆砌的黑箱,而是基于训练数据密度、推理优化路径和指令理解颗粒度形成的场景化智能体。理解其底层原理,才能摆脱‘谁更强’的误区,转向‘谁更适配’的工程实践。DeepSeek在代码与逻辑推演中展现高结构化+高语义优势,通义凭借政务语料密度成为体制内文书首选,混元依托方言词典与地域感知实现文化适配突破,文心擅长教育认知路径设计,豆包则以社交语料驱动情绪化内容生成。本文聚焦真实API调用表现、响应稳定性与长程记忆衰减等隐形指标,为金融、政务、制造、教育等垂直领域提供可落地的混合调用策略。

weixin_34115824的博客 495

最强开源推理大模型 DeepSeek-R1 最清晰的免费本地部署使用教程

本文带来 DeepSeekR1 模型免费本地部署教程,因官网下载慢,在文末附上百度网盘链接。教程分两步,第一步,先前往 ollama 官网下载安装程序,在命令行输入 “ollama -h” 测试安装并查看命令。再依据显存选 DeepSeek-R1 模型,复制下载代码在命令行运行,用 “ollama list” 查看安装情况并运行模型。第二步,从 chatbox 官网下载安装程序,打开后在设置里将模型提供方设为 ollama,选好模型保存即可开启对话。最后,分享安装包百度网盘链接,欢迎点赞收藏支持。

weixin_56619527的博客 1万+

DeepSeek本地一键部署指南:从环境配置到API集成全流程

这次我们来看一个针对 DeepSeek 的本地部署项目。如果你之前觉得本地部署 AI 模型很复杂,需要配置各种环境、处理依赖冲突、还要担心显存不够,那么这个“一键安装”方案可能就是你要找的入口。它的核心目标很简单:让没有编程基础的用户,也能在几分钟内,在自己的电脑上跑起一个功能完整的 DeepSeek 智能助手。 这个项目最值得关注的几个特点是: 安装过程极度简化 ,通常只需要运行一个脚本或点击一个安装包; 硬件门槛相对友好 ,虽然具体需求取决于模型版本,但通常会提供 CPU 和 GPU 两种推理选项; 提

weixin_34265814的博客 505

Deep Seek R1本地化部署

【说明】操作系统:win10。使用工具:ollama

晨曦之光Wing的博客 7072

万字长文详解DeepSeek-R1模型工作原理

以往的研究通常依赖大量监督数据来提升模型性能。DeepSeek证明了即使不使用监督微调作为冷启动,通过大规模强化学习依然可以显著提升模型的推理能力。此外,适量冷启动数据的引入可以进一步提高性能。

具身机器人和通用AI 2669

DeepSeek-R1蒸馏数据集全流程实践指南——从数据准备到生产部署的完整解决方案

文章结构说明*:全文通过20+个代码片段和配置示例,完整呈现了工业级知识蒸馏系统的实现细节,适合需要将前沿研究成果转化为实际生产力的AI工程师参考实践。

理论都是虚的,代码才是王道。 581

生物DeepSeek实战:用蛋白质语言模型+大模型API实现智能序列解读

人工智能技术正在从自然语言处理延伸到生命科学领域,其中基于Transformer架构的蛋白质语言模型,将氨基酸序列视为一种“生物语言”,通过大规模无监督学习捕捉进化与功能信息。这类模型与DeepSeek等通用大模型协同工作,形成“特征提取—预测—生成解释”的完整链路。本文从技术原理出发,剖析生物序列为何能像语言一样被建模,并展示如何用ESM-2提取序列特征,结合分类器完成抗菌肽预测,再通过DeepSeek API生成自然语言解读报告。整个流程无需深厚生物背景,只需Python基础即可复现。该方案可扩展至突变

weixin_30832405的博客 334

《用 R 探索医药数据科学》目录(持续更新,已超 250 万字)|订阅前说明

我们重磅推出《用 R 探索医药数据科学》专栏!本文作为专栏【订阅后首读】的核心内容,堪称开启学习之旅的 “入门钥匙”,也是整个专栏最关键的一篇指引文。文中不仅完整呈现了专栏 9 大核心篇章 + 问答板块的详细目录,更囊括了订阅后必知的核心要点 —— 从阅读设备、实操工具的使用建议,到学习路径、更新规则的清晰说明,再到问题反馈、感悟记录的实用方法,一站式帮你摸清专栏框架、找准学习方向。建议各位订阅者务必认真阅读、吃透内容,这能让你后续的学习更高效、少走弯!

MD Code 1万+

RStudio作为R语言的集成开发环境,因其强大的功能和易用性

除了用于编写和运行代码,RStudio还提供了强大的项目管理功能,帮助用户有效地组织和管理数据分析项目。本篇文章将详细介绍如何用RStudio进行项目管理,包括项目的创建与结构、文件管理、版本控制、协作工具和自动化工作流程。

MD Code 340

什么是PCIe Relaxed Ordering

什么是PCIe上的Relaxed Ordering呢?直接翻译的话就是宽松排序。在理解这个东西之前,需要先了解下什么是PCIe的基本事务排序法则。

qq_42824983的博客 1510

手持式激光测距仪全套方案

激光测距全套方案,包括原理图、源代码、PCB、BOM、光学部分资料,结构、特殊元件数据手册及供应商联系方式,提供调试技术文档。全套方案已成功打板验证,实现0.05~50m测量范围,精度在+/—1.5mm,激光波长635~650nm,功率《1mW。方案预留了TTL串口、RS485接口,可通过串口助手看到测量数据,可自行DIY或者商业开发。无论是电路小白,还是技术大拿,都能通过方案资料成功做出一套激光测距仪。

Laser01的博客 2055

R的包(packages)是由R函数、数据和预编译代码组成的一种结构化集合

R的包(packages)是由R函数、数据和预编译代码组成的一种结构化集合。在R安装时,自带了一些基础包,这些基础包提供了常用的默认函数和数据集。除此之外,我们还可以根据需要下载和安装其他扩展包。安装完扩展包后,必须将其载入内存才能使用。

MD Code 259

Windows Server安装Intel I219-V网卡驱动完整教程

在Windows Server系统上安装Intel I219-V网卡驱动的方法。

小白成长历程 5177

R语言的一个重要特点是其开放源码的性质

另外,R语言的安装文件体积轻便,系统负担小。R语言的大部分功能都存在于扩展包中,这些扩展包涵盖了各行各业中数据分析的前沿方法。用户可以根据需要安装和使用不同的扩展包,为数据分析提供了一个庞大、连贯和集成的工具集合。这种模块化的设计使得R语言具有很高的灵活性和可扩展性。

MD Code 311

思科路由器、交换机组网实验报告

通过思科模拟器搭建路由交换网络

ghj528的博客 1335

2026最新openclaw(clawbot/moltbot)真正在自己个人电脑上搭建部署,配置飞书远程远程让AI助理操控电脑完成任务,以及结合ollama无限token实现7*24小时工作(附配置)

2026最新openclaw(clawbot/moltbot)真正在自己个人电脑上搭建部署,配置飞书远程远程让AI助理操控电脑完成任务,以及结合 ollama 无限token实现7*24小时工作,以及部署安装需要的 skills 完成复杂的工作任务(附完整可以运行的配置文件)。 很多人已经会配置安装 openclaw 了 ,但是 安装完成之后真正让电脑自动运行起来的很好,完成出色工作的更少,最常见的就是聊聊天,或者执行一些简单的命令,理解要让电脑自动化工作,openclaw、skills、大模型这三样。

代码讲故事 2963

在R中使用SQL语言

sqldf是R语言的一个包,专为在R数据框上运行SQL语句而设计,极大地提高了数据操作的便利性。用户无需繁琐地创建数据库和表格,只需简单地在R脚本中指定SQL查询语句,将数据框名称代替SQL中的表名,sqldf即可完成以下步骤:

MD Code 312

mapbox 从入门到精通 - 目录

欢迎大家来到gis分享者的《mapbox 从入门到精通》专栏。博主列出学习大纲,如果有什么问题,欢迎留言。

我哎GIS博客 5846

为什么导师更青睐会 R 的学生?

在医药科研领域,R语言正成为课题组内的关键技能分水岭。掌握R语言的研究生能高效完成Meta分析复现(meta包)、临床数据清洗(dplyr包)和论文格式转换(RMarkdown)等核心工作,效率远超传统SPSS/Excel操作。该技能不仅提升科研产出速度,更培养独立解决复杂问题的能力,成为导师青睐的核心竞争力。

MD Code 349

Nerf 训练自有数据

colmap相机位姿转为LLFF格式数据

zfjBIT的专栏 2309

【ROS2】RViz2加载URDF模型文件

1)运行RViz2rviz22)添加组件:RobotModel3)选择通过文件添加4)选择URDF文件,此时会报错,需要修改Fixed Frame为map即可

郭老二 1450

AI 时代,学会R之后,很多人后悔了

《用R探索医药数据科学》专栏摘要 本专栏系统讲解R语言在医药科研中的高效应用,覆盖从基础操作到SCI发表的完整路径。通过9大核心模块(数据预处理、统计分析、可视化、机器学习等)和10个公共数据库实战案例,帮助研究者解决四大痛点。

MD Code 302

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

在R语言中,基本的算术运算是数据分析和计算的基础

在R语言中,基本的算术运算是数据分析和计算的基础。掌握这些运算不仅是进行统计分析的前提,也是处理医学数据和进行医学研究的关键步骤。本文将详细讲解R语言中的基本算术运算,并通过医学实例进行说明,帮助大家更好地理解和应用这些运算。

MD Code 314

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

为什么90%的R语言学习者都半途而废?

《用R探索医药数据科学》专栏针对医学研究者学习R语言的痛点,提供系统性解决方案。专栏指出90%学习者因目标模糊、案例脱离医学、报错困扰而放弃。为此设计了明确医学应用目标(如发SCI)、真实医疗数据集案例、常见报错指南、结构化学习路径和快速成果反馈机制。内容涵盖从基础操作到高级统计、机器学习、公共数据库挖掘等9大模块,包含临床试验分析、Meta分析、文献计量学等医学特色专题。通过医学场景化教学(如NHANES数据分析)、分阶段学习计划和社区支持,帮助临床医生跨越学习障碍,掌握用R进行医学研究的完整技能链。

MD Code 305

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

使用R的函数安装和查看扩展包

在R中,可以使用函数来安装和管理包。要第一次安装一个包,可以使用 install.packages() 函数(注意括号内需要用英文字符的双引号 " ")。例如,要安装 ggpubr 扩展包,只需输入以下代码:

MD Code 259
上一篇: Agent应用实战:从广告智能助手落地到平台化赋能,大模型入门到精通,收藏这篇就足够了!
下一篇: 用Qwen Code打造你专属的Linux智能运维专家,大模型入门到精通,收藏这篇就足够了!
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值