


RAG(检索增强生成)知识系统是 Dify 的核心组件,它使 AI 应用程序能够检索和利用外部知识。该系统管理从文档提取到知识检索的整个流程,支持不同的索引技术、文档处理方法和检索策略。
接下来将分别介绍各个子系统:
模型提供者系统(Model Provider System) ✅
RAG 知识系统(RAG Knowledge System) ✅
对话系统(Conversation System)
工作流系统(Workflow System)
架构概述
RAG 知识系统遵循三阶段提取-转换-加载 (ETL) 流程进行文档处理,并结合复杂的检索机制进行知识访问。
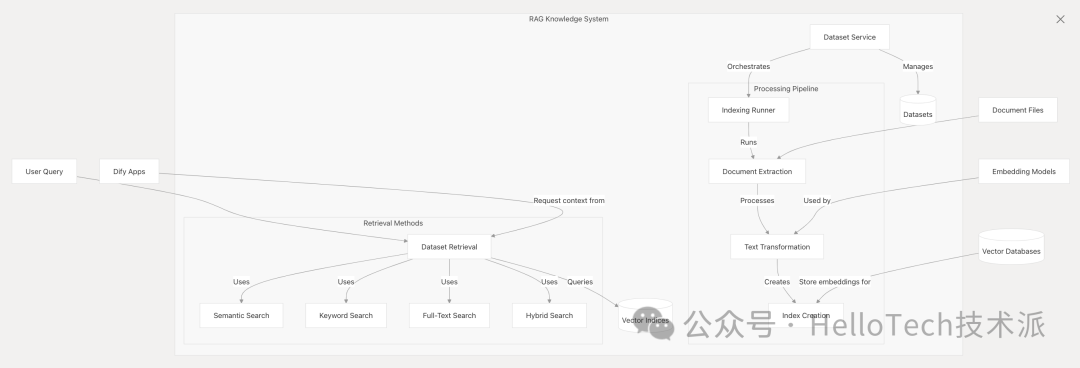
RAG 系统架构图
RAG(检索增强生成)知识系统使应用程序能够通过以下方式利用基于文档的知识:
-
文档提取 :处理各种文档格式
-
分块和嵌入 :将文本转换为矢量表示
-
知识检索 :查找与用户查询相关的信息
数据集管理
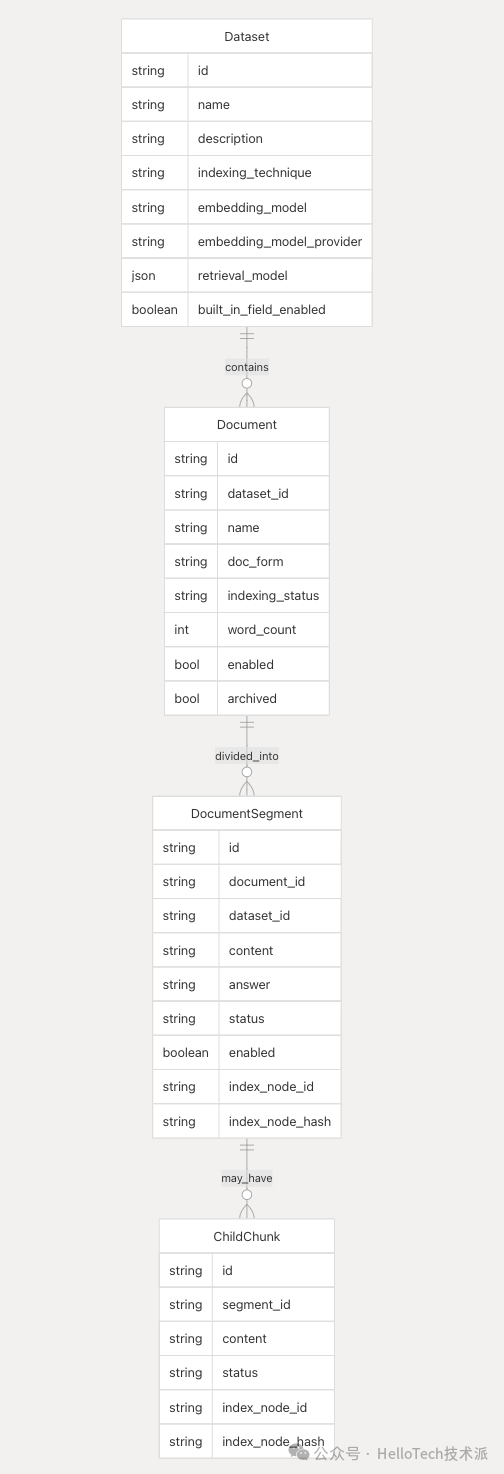
数据集结构
数据集是 RAG 知识体系的基本组织单元。每个数据集包含文档,文档被划分为多个段,以便于索引和检索。
数据集创建
为了创建数据集,系统接受包括名称、描述、索引技术和检索配置在内的参数。
POST /datasets
数据集创建工作流程:
-
验证参数
-
创建数据集记录
-
如果使用高质量索引,请配置嵌入模型
-
设置检索配置
-
设置权限
索引技术
该系统支持两种主要索引技术:
|
技术 |
描述 |
向量数据库 |
Embedding 模型 |
用例 |
|---|---|---|---|---|
high_quality |
使用嵌入模型将文本转换为向量 |
必需 |
必需 |
更好的语义理解,处理细微的查询 |
economy |
使用基于关键字的倒排索引 |
不需要 |
不需要 |
更低的资源占用,精准的关键字匹配 |
文档形式
文档可以以三种不同的形式进行处理和索引:
|
形式 |
描述 |
索引方法 |
|---|---|---|
text_model |
直接嵌入的默认文本文档 |
直接嵌入文档内容 |
qa_model |
问答对 |
生成问答对并嵌入问题 |
hierarchical_model
(父子模型) |
带有子段的父块 |
创建具有父块和子块的层次结构 |
文档处理 Pipeline
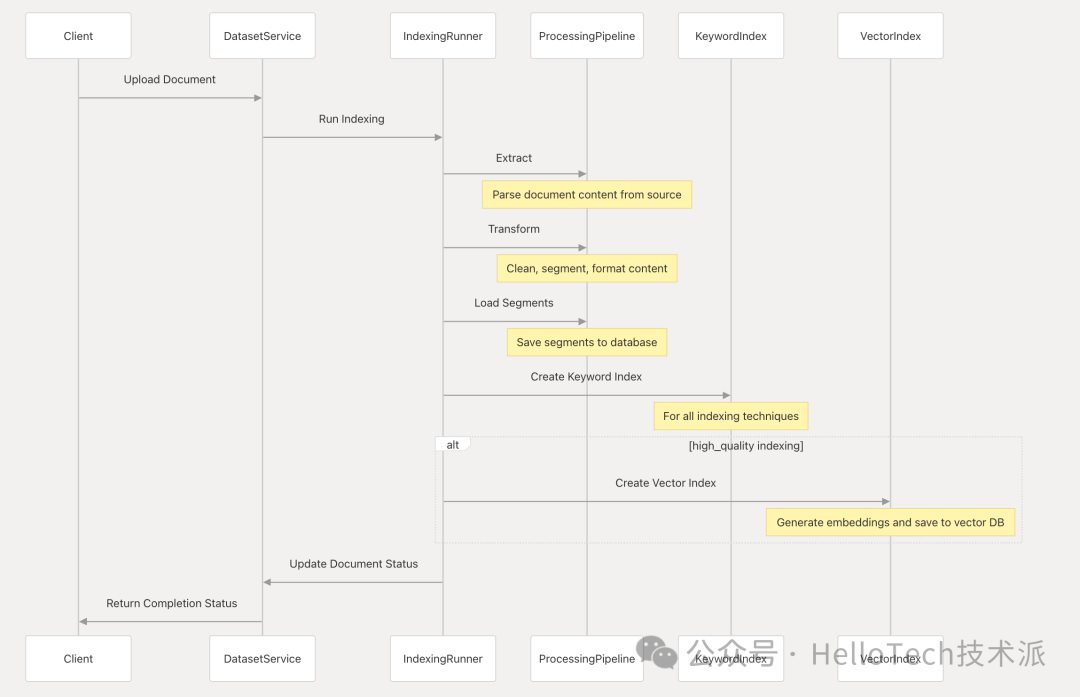
文档处理管道遵循提取-转换-加载(ETL)模式:
提取阶段
提取阶段处理不同的数据源:
-
上传文件 :处理上传的文件,如 PDF、DOCX 等。
-
Notion 导入 :从 Notion 页面提取内容
-
网站抓取 :从抓取的网站中提取内容
提取过程将不同的内容源规范化为统一的文本文档格式。
转换阶段
转换阶段处理:
-
文本清理 :根据配置的规则删除多余的空格、URL、电子邮件
-
分割(Segmentation) :根据配置的规则将文档分成块
-
格式化 :根据文档形式(文本、问答、分层)准备索引文本
关键分割参数:
-
分隔符(Separator) :用于分割文本的字符序列(默认值:
\n\n) -
最大令牌数(Max Tokens) :每个段的最大令牌数(默认值:1024)
-
块重叠(Chunk Overlap) :段之间的标记重叠(默认值:50)
加载阶段
-
将片段保存到数据库
-
为所有文档创建关键字索引
-
为了实现高质量索引,生成嵌入并将其存储在向量数据库中
该过程包括:
-
为段创建数据库记录
-
使用配置的嵌入模型生成文本嵌入
-
建立搜索索引(关键字和/或向量)
检索系统
检索系统负责根据用户查询从索引数据集中查找相关信息。
检索方法
系统支持多种检索方式:
|
方法 |
描述 |
要求 |
优势 |
|---|---|---|---|
|
语义搜索(Semantic Search) |
使用向量相似性来查找语义相关的内容 |
嵌入模型,向量数据库 |
最适合基于含义的查询 |
|
关键词搜索(Keyword Search) |
使用精确关键字匹配 |
关键词索引 |
适合精确的术语搜索 |
|
全文搜索(Full-Text Search) |
使用全文索引技术 |
全文索引 |
平衡精度和召回率 |
|
混合搜索(Hybrid Search) |
结合多种方法 |
所有索引 |
最佳整体表现 |
检索策略
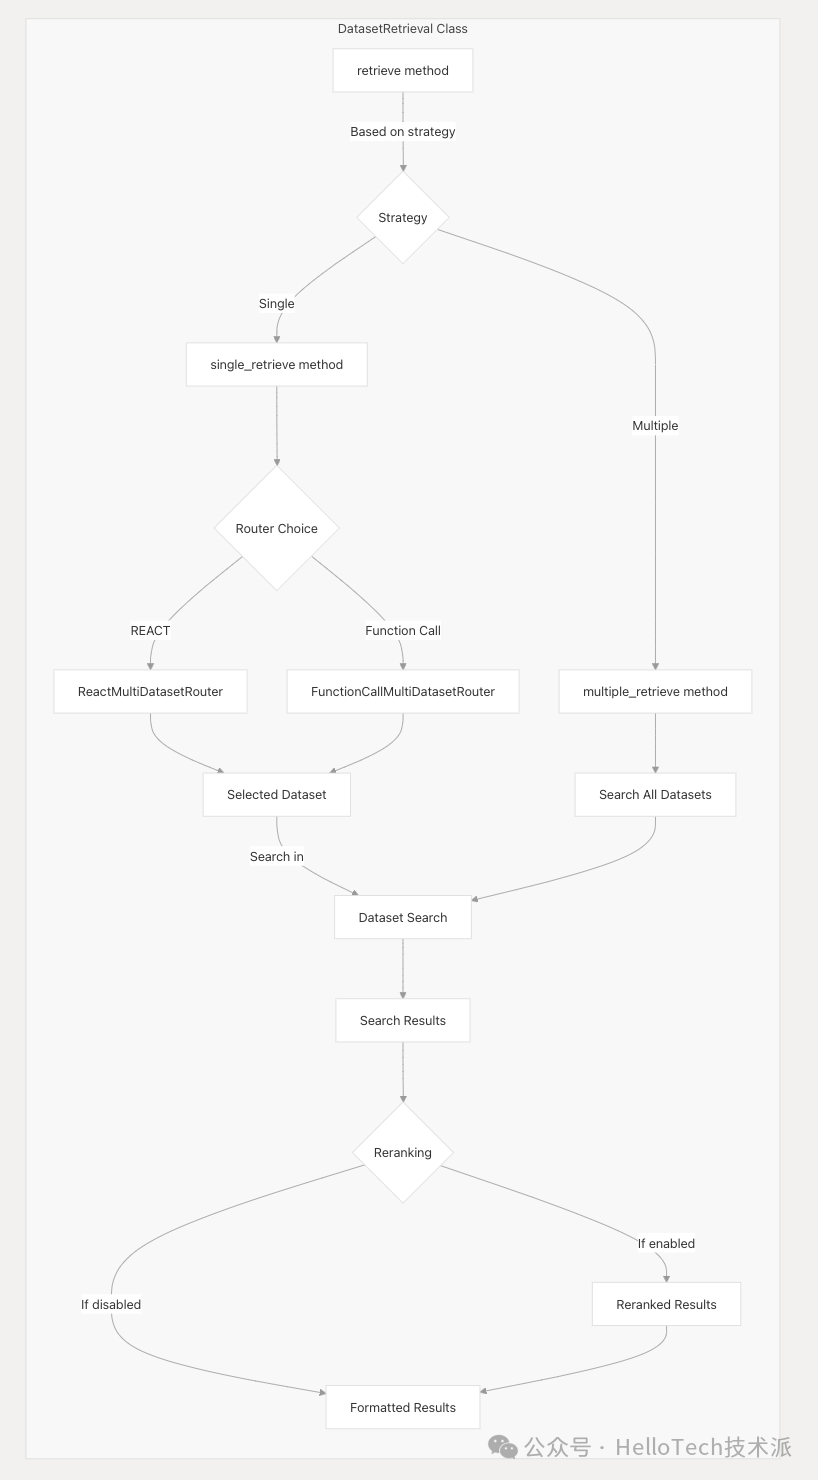
系统支持两种主要的检索策略:
-
单一检索(Single Retrieval) :使用带有 AI 模型的单一数据集来路由查询
-
多重检索(Multiple Retrieval) :使用可配置的权重和评分在多个数据集中进行搜索
结果处理
-
格式化为文档上下文
-
可能使用重新排序模型进行重新排序
-
根据相关性阈值进行评分和过滤
-
按相关性排序
-
准备返回调用应用程序
与工作流集成
RAG 知识系统通过知识检索节点与 Dify 的工作流系统集成:
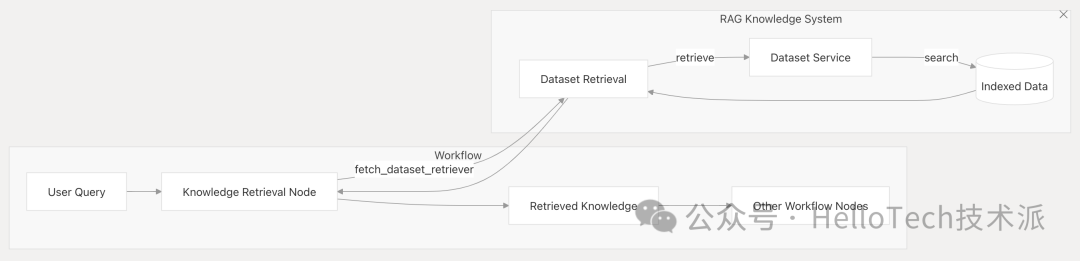
知识检索节点:
-
从工作流中获取查询输入
-
配置检索参数
-
调用数据集检索系统
-
将格式化的知识返回到工作流
API 集成
服务 API
RAG 知识系统公开了 RESTful API 以与客户端应用程序集成:
|
接口 |
Method |
描述 |
|---|---|---|
/datasets |
POST |
创建新数据集 |
/datasets |
GET |
列出可用数据集 |
/datasets/{dataset_id} |
GET |
获取数据集详细信息 |
/datasets/{dataset_id} |
POST |
更新数据集设置 |
/datasets/{dataset_id} |
DELETE |
删除数据集 |
/datasets/{dataset_id}/document/create-by-text |
POST |
从文本创建文档 |
/datasets/{dataset_id}/document/create-by-file |
POST |
从文件创建文档 |
/datasets/{dataset_id}/documents/{document_id}/update-by-text |
POST |
通过文本更新文档 |
控制台 API
对于内部控制台使用,存在其他端点:
|
接口 |
Method |
描述 |
|---|---|---|
/console/datasets |
多种方式 |
控制台的数据集管理 |
/console/datasets/{dataset_id}/documents |
多种方式 |
文档管理 |
/console/datasets/{dataset_id}/documents/{document_id}/segments |
多种方式 |
段管理 |
速率限制和配额
该系统实施速率限制和配额执行,特别是在云部署中:
知识检索速率限制
对知识检索操作强制实施速率限制
# Simplified rate limiting logic
knowledge_rate_limit = FeatureService.get_knowledge_rate_limit(tenant_id)
if knowledge_rate_limit.enabled:
    current_time = int(time.time() * 1000)
    key = f"rate_limit_{tenant_id}"
    redis_client.zadd(key, {current_time: current_time})
    redis_client.zremrangebyscore(key, 0, current_time - 60000)
    request_count = redis_client.zcard(key)
    if request_count > knowledge_rate_limit.limit:
        # Add rate limit record and return error
资源限制
对各种资源实施限制:
|
资源 |
描述 |
执行点 |
|---|---|---|
|
向量空间 |
限制嵌入存储 |
在文档创建/索引期间 |
|
Documents |
限制文档数量 |
文档上传期间 |
|
知识率 |
限制检索频率 |
在知识检索过程中 |
总结
RAG 知识系统是 Dify 中用于知识索引和检索的综合解决方案。它提供了灵活的文档处理、索引技术和检索策略选项,使其能够适应各种用例。该系统的模块化架构允许与工作流和对话系统等其他组件无缝集成。
参考资料
https://github.com/langgenius/dify
如何系统的去学习大模型LLM ?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑……
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!
在这个版本当中:
第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

五、AI产品经理大模型教程

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
 4247


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


