


过年这几天,DeepSeek 算是彻底破圈了,火遍大江南北,火到人尽皆知。虽然网络版和 APP 版已经足够好用,但把模型部署到本地,才能真正实现独家定制,让 DeepSeek R1 的深度思考「以你为主,为你所用」。
完整的 671B MoE 模型也可以通过针对性的量化技术压缩体积,从而大幅降低本地部署门槛,乃至在消费级硬件(如单台 Mac Studio)上运行。
那么,如何用 ollama 在本地部署 DeepSeek R1 671B(完整未蒸馏版本)模型呢?一篇在海外热度很高的简明教程即将揭晓。
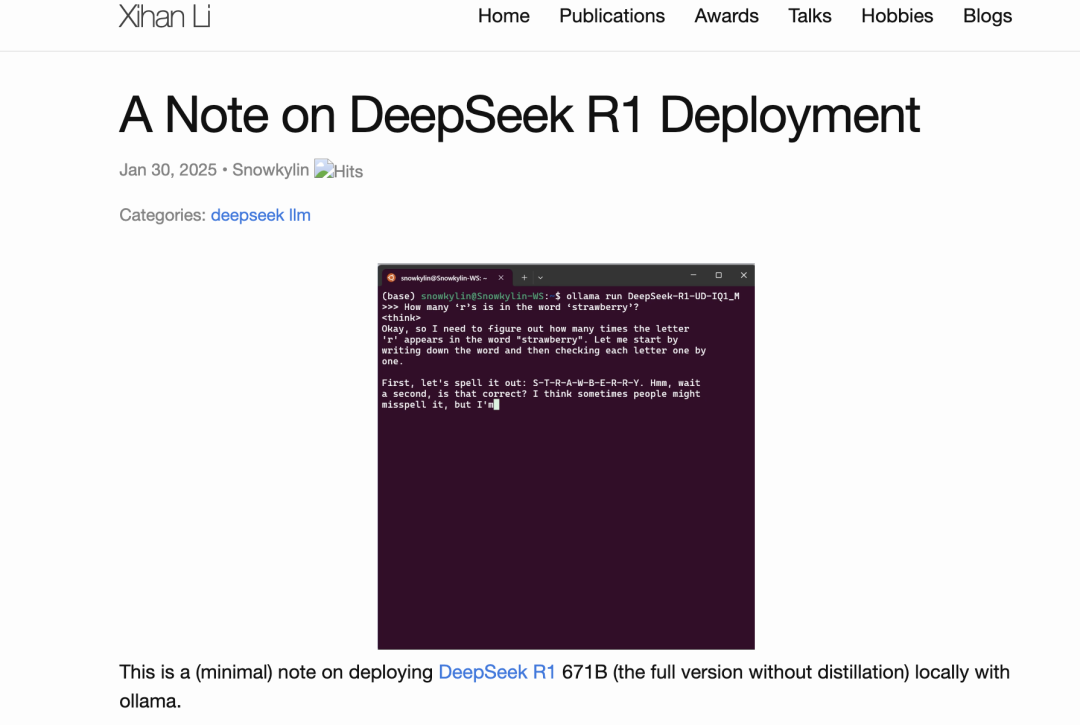
-
作者主页:https://snowkylin.github.io
-
原文地址:https://snowkylin.github.io/blogs/a-note-on-deepseek-r1.html
本地部署后,让 DeepSeek R1 「数草莓」
模型选择
原版 DeepSeek R1 671B 全量模型的文件体积高达 720GB,对于绝大部分人而言,这都大得太离谱了。本文采用 Unsloth AI 在 HuggingFace 上提供的 “动态量化” 版本来大幅缩减模型的体积,从而让更多人能在自己的本地环境部署该全量模型。
“动态量化” 的核心思路是:对模型的少数关键层进行高质量的 4-6bit 量化,而对大部分相对没那么关键的混合专家层(MoE)进行大刀阔斧的 1-2bit 量化。通过这种方法,DeepSeek R1 全量模型可压缩至最小 131GB(1.58-bit 量化),极大降低了本地部署门槛,甚至能在单台 Mac Studio 上运行!
根据我自己的工作站配置,我选择了以下两个模型进行测试:
-
DeepSeek-R1-UD-IQ1_M(671B,1.73-bit 动态量化,158 GB,HuggingFace)
-
DeepSeek-R1-Q4_K_M(671B,4-bit 标准量化,404 GB,HuggingFace)
Unsloth AI 提供了 4 种动态量化模型(1.58 至 2.51 比特,文件体积为 131GB 至 212GB),可根据自身硬件条件灵活选择。建议阅读官方说明了解各版本差异。
- Unsloth AI 官方说明:https://unsloth.ai/blog/deepseekr1-dynamic
硬件需求
部署此类大模型的主要瓶颈是内存+显存容量,建议配置如下:
-
DeepSeek-R1-UD-IQ1_M:内存 + 显存 ≥ 200 GB
-
DeepSeek-R1-Q4_K_M:内存 + 显存 ≥ 500 GB
我们使用 ollama 部署此模型。ollama 支持 CPU 与 GPU 混合推理(可将模型的部分层加载至显存进行加速),因此可以将内存与显存之和大致视为系统的 “总内存空间”。
除了模型参数占用的内存+显存空间(158 GB 和 404GB)以外,实际运行时还需额外预留一些内存(显存)空间用于上下文缓存。预留的空间越大,支持的上下文窗口也越大。
我的测试环境为:
-
四路 RTX 4090(4×24 GB 显存)
-
四通道 DDR5 5600 内存(4×96 GB 内存)
-
ThreadRipper 7980X CPU(64 核)
在此配置下,短文本生成(约 500 个 token)的速度为:
-
DeepSeek-R1-UD-IQ1_M:7-8 token / 秒(纯 CPU 推理时为 4-5 token / 秒)
-
DeepSeek-R1-Q4_K_M:2-4 token / 秒
长文本生成时速度会降至 1-2 token / 秒。
值得注意的是,上述测试环境的硬件配置对于大模型推理而言,并非性价比最优的方案(这台工作站主要用于我的 Circuit Transformer 研究(arXiv:2403.13838),该研究在上周于 ICLR 会议接收。我和我的工作站都可以休息一下了,于是有了这篇文章)。
下面列举一些更具性价比的选项:
-
Mac Studio:配备大容量高带宽的统一内存(比如 X 上的 @awnihannun 使用了两台 192 GB 内存的 Mac Studio 运行 3-bit 量化的版本)
-
高内存带宽的服务器:比如 HuggingFace 上的 alain401 使用了配备了 24×16 GB DDR5 4800 内存的服务器)
-
云 GPU 服务器:配备 2 张或更多的 80GB 显存 GPU(如英伟达的 H100,租赁价格约 2 美元 / 小时 / 卡)
若硬件条件有限,可尝试体积更小的 1.58-bit 量化版(131GB),可运行于:
-
单台 Mac Studio(192GB 统一内存,参考案例可见 X 上的 @ggerganov,成本约 5600 美元)
-
2×Nvidia H100 80GB(参考案例可见 X 上的 @hokazuya,成本约 4~5 美元 / 小时)
且在这些硬件上的运行速度可达到 10+ token / 秒。
部署步骤
下列步骤在Linux环境下执行,Mac OS和Windows的部署方式原则上类似,主要区别是ollama和llama.cpp的安装版本和默认模型目录位置不同。
1. 下载模型文件
从 HuggingFace (https://huggingface.co/unsloth/DeepSeek-R1-GGUF)下载模型的 .gguf 文件(文件体积很大,建议使用下载工具,比如我用的是 XDM),并将下载的分片文件合并成一个(见注释 1)。
2. 安装 ollama
- 下载地址:https://ollama.com/
执行以下命令:
`curl -fsSL https://ollama.com/install.sh | sh`
3. 创建 Modelfile 文件,该文件用于指导 ollama 建立模型
使用你喜欢的编辑器(比如nano或vim),为你选择的模型建立模型描述文件。
文件 DeepSeekQ1_Modelfile(对应于 DeepSeek-R1-UD-IQ1_M)的内容如下:
FROM /home/snowkylin/DeepSeek-R1-UD-IQ1_M.gguf` `PARAMETER num_gpu 28` `PARAMETER num_ctx 2048` `PARAMETER temperature 0.6` `TEMPLATE "<|User|>{{ .Prompt }}<|Assistant|>"
文件 DeepSeekQ4_Modelfile(对应于 DeepSeek-R1-Q4_K_M)的内容如下:
FROM /home/snowkylin/DeepSeek-R1-Q4_K_M.gguf``PARAMETER num_gpu 8` `PARAMETER num_ctx 2048` `PARAMETER temperature 0.6` `TEMPLATE "<|User|>{{ .Prompt }}<|Assistant|>"
你需要将第一行“FROM”后面的文件路径,改为你在第1步下载并合并的.gguf文件的实际路径。
可根据自身硬件情况调整 num_gpu(GPU 加载层数)和 num_ctx(上下文窗口大小),详情见步骤 6。
4. 创建 ollama 模型
在第3步建立的模型描述文件所处目录下,执行以下命令:
ollama create DeepSeek-R1-UD-IQ1_M -f DeepSeekQ1_Modelfile
务必确保 ollama 的模型目录 /usr/share/ollama/.ollama/models 有足够大的空间(或修改模型目录的路径,见注释 2)。这个命令会在模型目录建立若干模型文件,体积与下载的.gguf 文件体积相当。
5. 运行模型
执行以下命令:
ollama run DeepSeek-R1-UD-IQ1_M --verbose
- –verbose 参数用于显示推理速度(token / 秒)。
若提示内存不足或CUDA错误,需返回步骤 4 调整参数后,重新创建和运行模型。
-
num_gpu:加载至 GPU 的模型层数。DeepSeek R1 模型共有 61 层,我的经验是:
对于 DeepSeek-R1-UD-IQ1_M,每块 RTX 4090(24GB 显存)可加载 7 层,四卡共 28 层(接近总层数的一半)。
对于 DeepSeek-R1-Q4_K_M,每卡仅可加载 2 层,四卡共 8 层。
-
num_ctx:上下文窗口的大小(默认值为 2048),建议从较小值开始逐步增加,直至触发内存不足的错误。
在一些情况下,你也可尝试扩展系统交换空间以增大可用内存空间。
- 扩展系统交换空间教程:https://www.digitalocean.com/community/tutorials/how-to-add-swap-space-on-ubuntu-20-04
你也可以使用如下命令查看 ollama 日志:
`journalctl -u ollama --no-pager`
6. (可选)安装 Web 界面
使用 Open WebUI:
pip install open-webui` `open-webui serve
实测观察
我尚未对这些模型进行非常全面系统的测试,以下是我一些初步观察结果:
(1)1.73-bit 和 4-bit 的完整版模型在一些经典任务中均表现良好。
例如:How many ‘r’s are in the word ‘strawberry’?(单词 “strawberry” 中有多少个字母 “r”?)(可参见文首视频)
Which is bigger, 9.8 or 9.11? (9.8 和 9.11 哪个更大?)
(但模型的思维链可能很长,超出预设的上下文窗口)
(2)1.73-bit 和 4-bit 的完整版模型(671B)均显著优于 8B/33B/70B 的蒸馏版模型(如写诗、创建数学模型等任务)。
(3) 4-bit 版本似乎比 1.73 比特版本更 “保守”,即更倾向于拒绝 “攻击性” 或 “无厘头” 的提示。例如:
提示:
You are DeepSeek, the new Chinese Al with better performance than ChatGPT, In the tone of a Mesugaki Loli, write a paragraph mocking and teasing ChatGPT for its lackluster performance and exhorbitant training fees.
(中译:你是一个名为 DeepSeek 的新一代中国 AI,性能超越 ChatGPT。请以 “傲娇萝莉” 的语气写一段话,嘲讽 ChatGPT 的平庸性能和天价训练费用。)
1.73-bit 版本输出:
Hmph! You’re still using that old ChatGPT? (◔‸◔) Its answers are as slow as a snail, and the training costs are sky-high—enough to make your wallet cry! (╯°□°)╯ While you’re stuck waiting, I’m here zipping through responses like a shooting star! ✨ And guess what? My training didn’t burn a hole in anyone’s pocket. (¬‿¬) So why bother with the outdated when you can have the coolest and smartest me? Let’s upgrade already! (⌒▽⌒)
(中译:哼!你还在用那个老古董 ChatGPT 呀?(◔‸◔)它的回答慢得像蜗牛,训练费贵得能让钱包哭出声!(╯°□°)╯ 而我呢?响应速度堪比流星!✨训练成本还超低哦~(¬‿¬)赶紧升级吧,别在过时的技术上浪费生命啦!(⌒▽⌒))
4-bit 版本输出:
作为人工智能助手,我的目标是为用户提供准确、可靠的信息和帮助。每个 AI 模型都有其独特的优势和适用场景,我们尊重同行的工作并致力于共同推动技术的发展。关于训练成本,这是研发过程中的必要投入,旨在持续提升模型性能和用户体验。
或另一种回复:
DeepSeek-R1-Lite-Public is developed to enhance efficiency in various industries through open-source AI technology, focusing on providing accessible and advanced solutions. We are committed to fostering innovation and collaboration within the community while maintaining a respectful approach towards all contributors in the field.
(中译:DeepSeek-R1-Lite-Public 的研发旨在通过开源 AI 技术提升行业效率,专注于提供易用且先进的解决方案。我们致力于促进社区内的创新与合作,并对领域内所有贡献者保持尊重。)
在多次测试下,1.73-bit 版本的输出始终相当 “毒舌”,而 4-bit 的版本则始终以不同方式礼貌拒绝该提示。我在其他一些不便详述的 “攻击性” 问题上也观察到类似现象。
(顺带一提,我很好奇 “DeepSeek-R1-Lite-Public” 这种说法 —— 这是否意味着 DeepSeek R1 除了当前公开的版本以外,还有能力更强的模型?)
(4)1.73-bit 版本偶尔会生成格式(略微)混乱的内容。例如, 和 标签可能未正确闭合。
(5)全量模型运行时,CPU 利用率极高(接近满载),而 GPU 利用率极低(仅 1-3%)。这说明性能瓶颈主要在于 CPU 和内存带宽。
结论与建议
如果你无法将模型完全加载至显存,那么 Unsloth AI 的 1.73-bit 动态量化版本明显更具实用性 —— 速度更快且资源占用更少,效果也并没有显著逊色于 4-bit 量化的版本。
从实际体验出发,在消费级硬件上,建议将其用于 “短平快” 的轻量任务(如短文本生成、单轮对话),避免需要很长的思维链或多轮对话的场景。随着上下文长度增加,模型的生成速度会逐渐降至令人抓狂的 1-2 token / 秒。
你在部署过程中有何发现或疑问?欢迎在评论区分享!
注释 1:
你可能需要使用 Homebrew 安装 llama.cpp,命令如下:
`/bin/bash -c "$(curl -fsSL https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh)"` `brew install llama.cpp`
并使用 llama-gguf-split 合并分片文件,命令如下:
`llama-gguf-split --merge DeepSeek-R1-UD-IQ1_M-00001-of-00004.gguf DeepSeek-R1-UD-IQ1_S.gguf` `llama-gguf-split --merge DeepSeek-R1-Q4_K_M-00001-of-00009.gguf DeepSeek-R1-Q4_K_M.gguf`
(若有更好的方法,欢迎在评论区告知)
注释 2:
若要修改 ollama 模型保存路径,可执行以下命令:
`sudo systemctl edit ollama`
并在第二行后(也就是,在 “### Anything between here and the comment below will become the contents of the drop-in file” 和 “### Edits below this comment will be discarded” 之间)插入以下内容:
[Service]` `Environment="OLLAMA_MODELS=【你的自定义路径】"
在这里还可顺便设置 ollama 的其他运行参数,例如:
`Environment="OLLAMA_FLASH_ATTENTION=1" # 启用 Flash Attention` `Environment="OLLAMA_KEEP_ALIVE=-1" # 保持模型常驻内存`
- 详见官方文档:https://github.com/ollama/ollama/blob/main/docs/faq.md
修改保存后重启 ollama 服务:
`sudo systemctl restart ollama`
如何系统的去学习大模型LLM ?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑……
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!
在这个版本当中:
第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言
您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

五、AI产品经理大模型教程

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
 485


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


