5 分钟在 Mac 上搭建自己的 deepseek r1智能体

从零复现DeepSeek R1 Zero:基于PyTorch与TRL的强化学习大模型实战 强化学习作为机器学习的重要分支,通过智能体与环境的交互学习最优策略,其核心原理在于奖励机制引导下的试错优化。在自然语言处理领域,结合大语言模型的强化学习技术展现出巨大价值,能够使模型在代码生成、数学推理等复杂任务上实现能力涌现。PyTorch作为主流深度学习框架,配合Hugging Face的TRL库,为研究者提供了高效的Transformer模型强化学习微调工具链。本文聚焦于DeepSeek R1 Zero模型的复现实践,详细解析如何构建代码生成环境、设计奖励函数,并利用PPO算法进行模型优化,为开发者提 阅读详情

如今,deepseek 烈火烹油火爆天,有用没用的大家都想看看人工智能到底能干啥。上一次AI 这么出圈,还是 ChatGPT 刚发布的时候。

我相信绝大部分凑热闹的群众用不了多久就会发现,自己除了问一些有的没的脑筋急转弯,并不能拿 deepseek 解决什么实际问题。但这不妨碍热情,特别是海对岸还有人在泼冷水,祭出各种手段让 deepseek 访问受阻。

开源的 deepseek 其实自己在本地就可以部署,有能力的人还能添加联网功能,把官方因屡遭攻击而暂时关闭的能力再加回来。

deepseek 在 huggingface 上完整放出了自己 671b 的模型文件,如果你的资源足够,理论上有可能自建一套 deepseek r1。什么叫资源足够?英伟达的 CEO 黄仁勋对此想法的配置建议是买 8 张他家的 H200 显卡。

完整版的 deepseek r1 需要大量显存,即使使用量化技术压缩到极致的模型,也需要 50G 显存。所谓量化,相当于压缩。量化程度越高,模型生成的结果精度越差。huggingface 上下载的模型,1.5bit,2bit,4bit,6bit,8bit 就是这个意思。bit 前面的数字越小,模型文件越小,精度越差。

这几天国内另一家公司,硅基流动,用华为的显卡部署了完整版 deepseek r1。我用了一下,它家显然接不住泼天的流量,推理速度实在太慢。原本 deepseek r1 的推理过程就会过度纠结在细节上,8-10token/s 的回答生成速度,相当于你用老式按键打字机敲字,太慢了。

其实尝试一下带思维链的 deepseek r1 不用那么复杂,也无需硬上满血版。deepseek r1 是用 deepseek v3 蒸馏出来的模型。deepseek 也用同样的技术蒸馏了好几个小模型,适合本地部署。

蒸馏技术可以理解为老师带学生。r1 是大师哥,其他尺寸小的模型算师弟们。综合能力,师弟不如师哥,但师弟们吃得也少,贫苦人家也能养得起。

deepseek 官方推荐的两个模型,分别是蒸馏阿里通义千问的 14b 和 32b。阿里通义千问模型本身的能力就不错,蒸馏后多了思维链,能力更强。
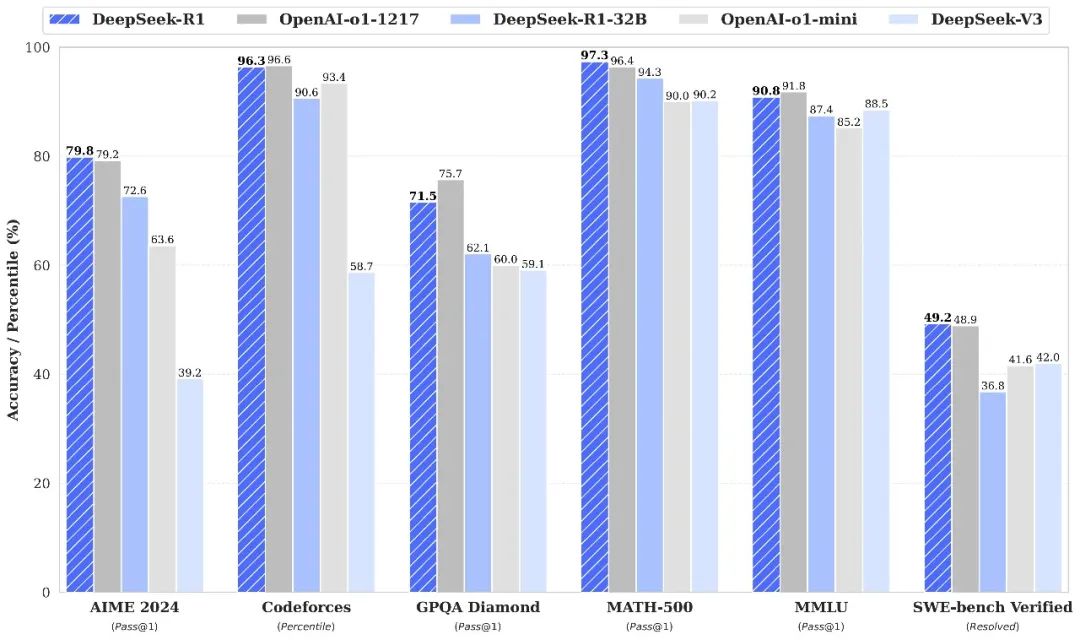
在 Mac 上,根据内存大小不同,很容易部署上面两个模型。最简单的方法是下载 lm studio,Mac,Windows,Linux 三平台都有客户端。

lm studio 不仅提供客户端,而且有自己量化的模型可供直接下载。我的 Macmini M4Pro 内存 24G,加载 14B的量化版本比较合适。32B 的 4bit 量化版大约 16G 左右,也能加载,但推理速度太慢,小于 10token/s。

我比较了 lm studio 自家的 14b,4bit 模型和下载数更多的第三方量化模型bartowski/DeepSeek-R1-Distill-Qwen-14B-GGUF的 6bit 版本,精度可以接受,速度快很多。

下载很简单,直接在 lm studio 上搜索 deepseek 即可。
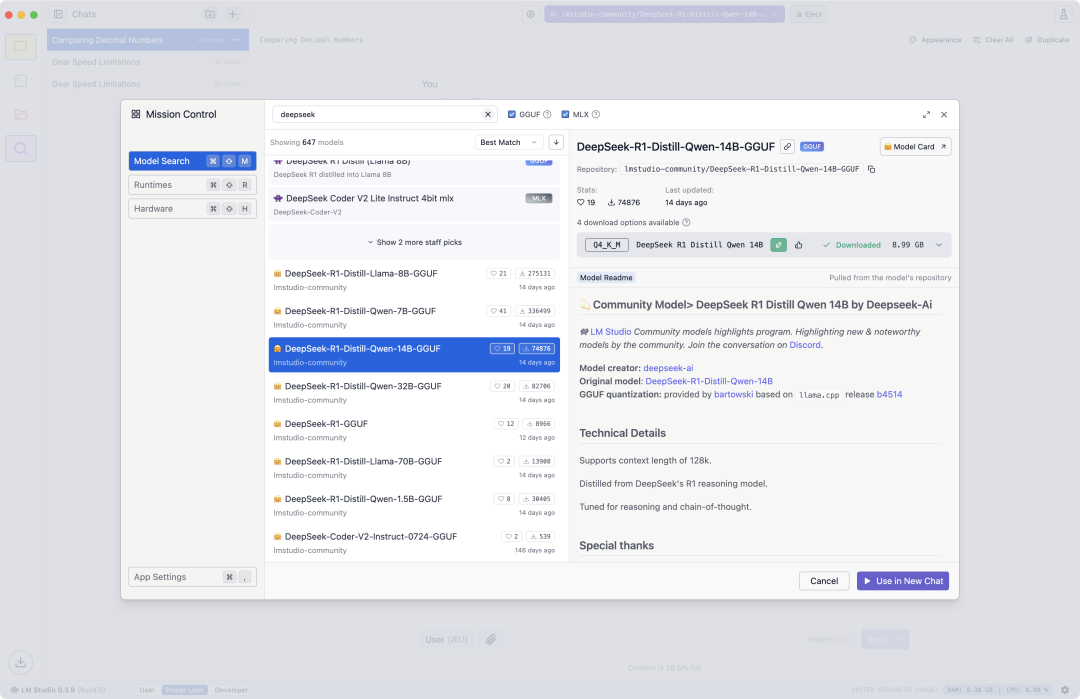
lm studio 提供聊天窗口,全图形化操作,加载模型之后,可以直接开启对话。另一个命令行工具 ollama 速度虽然更快,但上手要复杂。
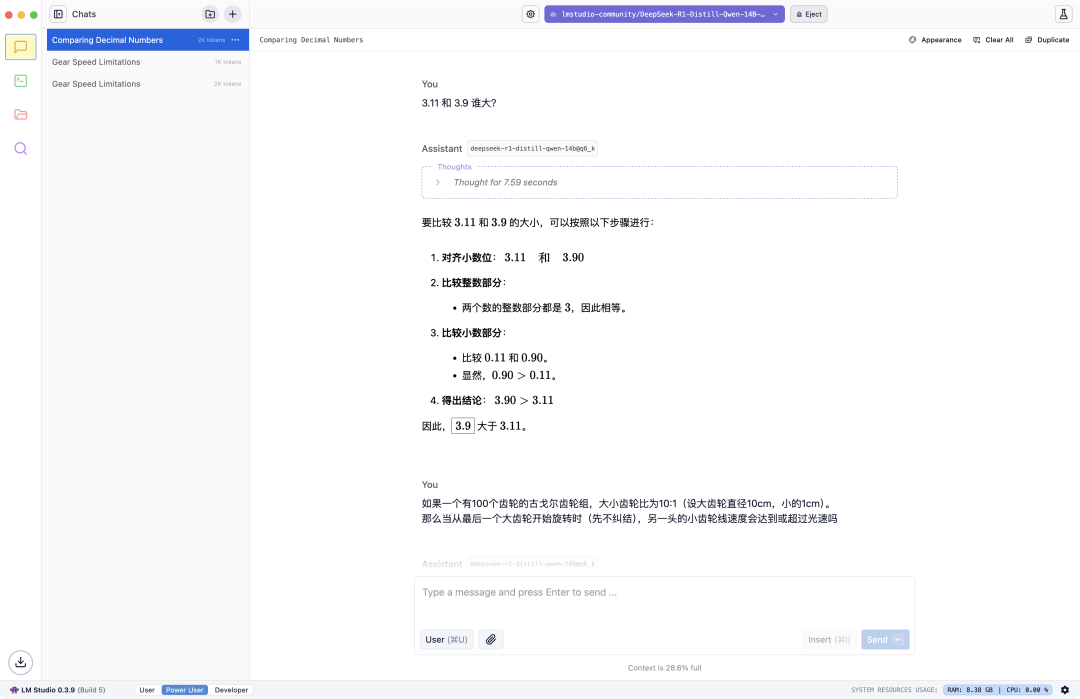
运行效果还是不错的,不联网也能做数学题,编写脚本和 python 程序。

推荐 lm studio 的原因有下面几个:

1. 本地文档聊天

LM Studio 支持与本地文档进行互动,用户可以上传文档(如TXT、PDF、Word等格式),然后与模型进行对话,获取文档中的信息。文件最多 5 个,每个不超过 30M。

2. 多模型同时运行

通过“Playground”模式,LM Studio 支持同时运行多个AI模型,你可以利用不同模型的组合能力来增强性能和输出。例如,可以同时加载一个擅长写作的模型和一个擅长编程的模型,根据需求切换使用。

3. OpenAI 兼容服务器

LM Studio 提供了一个与 OpenAI API 兼容的本地服务器,用户可以通过 HTTP 请求与模型交互。

4. 模型下载与管理

LM Studio 内置了模型发现功能,用户可以从 Hugging Face 等平台搜索和下载兼容的模型。此外,它还支持模型的管理和更新,方便用户随时切换不同的模型版本。

5. 硬件加速与优化

LM Studio 支持多种硬件加速,包括 NVIDIA GPU 和苹果 M 系列芯片。特别是对于 M 系列芯片,LM Studio 提供了经过优化的 MLX 模型,能够充分利用苹果的统一内存架构,提升运行效率。

6. 离线操作与隐私保护

LM Studio 支持完全离线操作,用户可以在不联网的情况下使用模型。这不仅保证了数据的隐私和安全,还避免了网络延迟问题,使得模型运行更加流畅。

如果你想用 lm studio 构建个人知识库,那么它不太合适。更适合的高级玩法可以从下面的组合里寻找:

Ollama + AnythingLLM

Ollama 是一个本地大模型管理工具,支持运行多种大语言模型。

AnythingLLM 是一个开源项目,支持将PDF、Word、网页等多种格式的文件转化为结构化的知识库。它与Ollama集成,可以实现文件加载和知识问答功能。

优点:支持多种文件格式,与Ollama集成方便,适合个人用户快速搭建知识库。

缺点:需要一定的技术基础来搭建和配置环境。

MaxKB + Ollama

MaxKB 是一个开源的本地知识库工具,支持与Ollama集成。

优点:MaxKB提供了简单易用的界面和强大的知识库管理功能,适合个人用户快速搭建和管理知识库。

缺点:需要使用Docker等工具进行部署,对技术要求有一定门槛。

Whoosh + Ollama

Whoosh 是一个纯Python实现的全文搜索引擎,可以用于快速检索本地文件。

方案:结合Whoosh进行文件索引,然后通过Ollama加载大模型进行问答。这种方式可以支持大量本地文件的检索和问答。

优点:Whoosh轻量级且易于集成,适合对性能要求较高的用户。

缺点:需要自行搭建和配置索引系统,对技术有一定要求。

Obsidian

Obsidian 是一款基于Markdown的笔记应用,专注于构建个人知识库。

优点:支持反向链接和图形视图,能够创建互联的知识网络,适合用于知识整理和管理。

缺点:虽然Obsidian本身不直接支持大模型集成,但可以通过插件或外部工具与Ollama等大模型工具结合使用。

1 和 4 比较适合不会编程的人。但总的来说,折腾这一套的时间成本不低,效果嘛,不见得能满足预期。个人知识库受限于两个因素:1. 向量化查询个人知识库的准确程度。2. 大模型的幻觉。

这两条实操的时候需要一定技术能力才能调整到相对满意的程度。如果只是自己的一些记账数据,生活琐事,对大模型了解不多,动手能力一般。不建议入坑。大概率看了半天,喊一句:擦,烦死了。然后结束。

再等半年,OpenAI已经在压力下放出专家版 o3。未来全图形化,一步到位集成个人知识库的解决方案肯定会有。

AI 的重点是提高我们的生活效率而不必掌握复杂的技术,不是反过来。

如何系统的去学习大模型LLM ?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

基于此,我用做产品的心态来打磨这份大模型教程,深挖痛点并持续修改了近70次后,终于把整个AI大模型的学习门槛,降到了最低!

在这个版本当中:

第一您不需要具备任何算法和数学的基础
第二不要求准备高配置的电脑
第三不必懂Python等任何编程语言

您只需要听我讲,跟着我做即可,为了让学习的道路变得更简单,这份大模型教程已经给大家整理并打包,现在将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)
在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

五、AI产品经理大模型教程

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

零代码!5分钟在Mac上搭建专属AI知识库:Ollama+AnythingLLM保姆级教程 本文提供了一份在Mac电脑上快速搭建本地AI知识库的保姆级教程。无需编程,通过安装Ollama和AnythingLLM两款工具,即可在5分钟内完成部署。教程详细介绍了如何下载运行DeepSeek-R1模型,并利用AnythingLLM的图形界面创建、管理专属知识库,实现与私有文档的安全、智能对话,特别适合Mac M4等Apple Silicon芯片用户。 阅读详情

相关推荐

零基础部署DeepSeek Harness:一键安装AI智能体开发框架

AI智能体(Agent)作为连接大语言模型与实际应用的关键技术,通过工具调用、任务规划和环境交互等核心原理,将通用AI能力转化为解决特定问题的生产力工具。其技术价值在于降低AI应用开发门槛,让开发者无需深入底层模型细节即可构建智能系统。在应用场景上,AI智能体广泛适用于智能客服、代码助手、数据分析等自动化任务。本文聚焦于DeepSeek Harness这一AI智能体开发框架,针对传统部署中涉及的命令行、Docker、环境变量等复杂操作,提供了开箱即用的一键安装方案,帮助用户快速搭建私有化AI应用环境,特别适

weixin_33894640的博客 391

保姆级教程:用Docker在Windows/Mac上5分钟搞定Coze开源版本地部署(含DeepSeek模型配置)

本文提供了一份详细的Coze开源版本地部署教程,适用于Windows和Mac用户,通过Docker快速搭建开发环境并配置DeepSeek模型。教程涵盖从安装Docker到启动服务的完整流程,帮助零基础用户5分钟内完成部署,并解决常见问题。

weixin_30566063的博客 444

Agentic RAG实战:基于CrewAI+DeepSeek+Streamlit的智能法律文档系统

Agentic RAG(代理式检索增强生成)是一种将大模型与任务编排、多智能体协同深度融合的技术范式,其核心在于突破传统RAG依赖向量召回的局限,通过意图分解、角色分工与交叉验证实现精准、可解释、可追溯的文档理解。相比单纯调用大模型API,Agentic RAG强调本地化部署、语义感知切片与渐进式人机交互,显著降低幻觉率并提升业务适配性。在法律、合规、金融等强专业性场景中,它能自动完成条款定位、效力分析、跨文档比对与风险预警,真正服务于‘查得准、查得全、查得懂’的工程目标。本文以CrewAI为编排中枢、De

weixin_30363981的博客 470

AI小白的第一天:本地搭建个DeepSeek吧

人工智能发展太迅速了。我现在进场已经晚了。。。。

weixin_44109245的博客 1247

Mac mini M4本地部署openclaw智能体实战指南

AI智能体是面向终端用户的自动化执行框架,其核心原理在于将大语言模型作为决策中枢,通过声明式技能配置连接本地工具链(如Shell、HTTP、Python),实现数据不出设备的闭环推理。技术价值体现在隐私可控、低延迟响应与离线可用性,广泛应用于家庭自动化、个人知识管理及轻量级办公场景。本文聚焦macOS平台下基于Apple M4芯片的openclaw本地化部署实践,深度融合Metal加速优化与ollama模型后端调优,解决M4专属的GPU初始化、Python环境冲突及微信个人号接入等关键问题。

weixin_30550081的博客 430

Mac mini M4本地部署OpenClaw实战指南:零基础跑通AI智能体

AI智能体(AI Agent)是让大模型具备自主感知、规划与执行能力的技术范式,其核心原理在于将LLM输出结构化为可调用的动作序列,并通过工具集成实现闭环交互。技术价值体现在降低AI使用门槛、提升开发效率与增强上下文理解深度。典型应用场景包括代码辅助(如VS Code内实时生成函数/文档)、网页自动化操作、多源信息检索与跨文件逻辑推理。当前在macOS平台,OpenClaw作为轻量级开源智能体框架,依托Ollama本地模型服务与Mac mini M4芯片的神经引擎加速,实现了高响应、低延迟、免配置的端侧落地

hck341204的专栏 424

使用deepseek本地部署,搭建自己的私人知识库,但是效果并不理想

使用deepseek本地部署,搭建自己的私人知识库教程有人问:deepseek本来就可以在线使用,或者下载APP使用,为什么还要自己搭建呢?回答这个问题,很简单,目前deepseek是免费,不代表以后是免费的,重要的是deepseek使用人数过多,或者受到攻击的时候,可能不能在线使用,而部署在自己的电脑上面,就可以不受网络的影响。但是,最重要的是搭建私人知识库,即内部知识库。不管是个人,还是公司,还是医院、学校等有一些知识、资料是不对外公开的,所以搭建私密数据库,还是有必要的。

2401_84494441的博客 1万+

Mac Mini 部署 OpenClaw 本地智能体:量化模型与 macOS 系统深度适配指南

本地智能体(Local Agent)是近年来兴起的轻量级 AI 自动化范式,强调技能可插拔、执行可审计与数据零出域;其核心依赖模型量化推理、本地向量库与操作系统级资源调度。OpenClaw 作为典型代表,并非 LLM 封装,而是一个需深度耦合硬件特性(如 Apple Silicon 的 Unified Memory 和 Neural Engine)与系统机制(如 macOS 的 SIP/TCC/launchd)的本地智能体运行时。本文聚焦 Mac Mini(M2)这一高性价比部署节点,详解 Q4_K_M 量

weixin_34109408的博客 465

苹果杀疯了!Mac Studio内存狂飙,跑满血DeepSeek R1消耗448GB,M3 Ultra竟然稳住了

所有东西都优化好了,开箱即用。不过值得注意的是,Dave Lee 强调,跑小模型时,M3 Ultra 还能留有余力,但面对 6710 亿参数的 DeepSeek R1,就必须用上最高配的 512GB 内存版本。另外,还有像 TensorRT-LLM 这样的工具,可以把模型量化成 Blackwell 支持的原生 fp4 数据类型,但 Max Weinbach 透露,在尝试给 RTX 5090 编译时,遇到了不少错误,也没时间慢慢调试。不过,这会增加延迟,说实话,有了这么强的显卡,折腾这些其实没啥意义。

优快云资讯 7304

vmware vsphere 证书过期告警处理方法

vSphere Clinet 管理页面出现“证书告警” ,检查证书未发现现有证书有过期现象

m0_51902127的博客 3635

Bybit面经

这段总结描述了求职者在Bybit面试过程中的经历和相关问题,包括面试内容、求职者向面试官提问的问题以及关于Bybit的信息

郑泽洲的博客 2578

DeepSeek在Mac上本地可视化部署,保姆级教程,再也不怕崩了!

DeepSeek,全称为“深度求索”,是由杭州深度求索人工智能技术研究有限公司开发的人工智能产品。这个名字体现了团队的核心理念与追求:DeepSeek 不仅仅是为了回答问题,更是致力于深度理解和探索,让 AI 具备类似人类的思考方式。更重要的是,DeepSeek-R1 的性能足以与 ChatGPT 相媲美,且完全免费供用户使用!

Gaga246的博客 1万+

Python + Google AI 自动修复 Sonar Bug 实践

在工作中总会遇到种种不期而至的需求,比如前段时间突然要修复所有 Sonar Bug,涉及各种琐碎的代码风格问题,包括但不限于语法不规范、废弃注释等问题。这些项目都已经持续开发几年了,Sonar 上的问题层出不穷,各种问题已经累积到了上万个,手动修复不但费时费力,而且过程异常枯燥。

子洋 Blog 2414

【LLM deployment & tuning】在macOS上实现基于MLX框架的LLM的部署和微调

本博客主要实现了在macos上基于MLX格式的LLM的部署、微调等功能的整合,以及一些prompt的设置策略,搭建起了一个较为高效的专用性模型。

gamewolfskin的博客 2182

USB3.0/3.1信号完整性分析仿真

• 1.了解USB3.0通路的互连关系,解读原理图接口电路和PCB的互连电路。对USB布线的通路及阻抗进行检查和分析。 • 2.使用USB3.0实例文件提取互连线的S参数,选择SSRX+,SSRX-,SSTX+,SSTX-,D+,D-组的互连线,使用PowerSI,Clarity,3DFEM等工具提起关键网络的S参数。提取S参数以后需要分析S参数的互连特征,对S参数的结果开展评价。 • 3.使用SYSTEM SI USB3 Compliance工程向导模型,建立USB仿真实例框架,在框架BOLCK中带入S参

小猪配齐电子设计 1万+

零停机更新黑科技:Spring Boot应用实现无缝升级的实战指南

本文介绍了基于Spring Boot和Tomcat实现零停机更新的技术方案,通过动态端口切换和优雅关闭机制,确保服务更新过程中业务不中断。文章详细解析了核心原理,包括内嵌Tomcat的工作机制、零停机更新的三大技术基石(端口动态切换、优雅关闭和进程接管)。同时提供了完整的Java实现代码,重点展示了端口动态检查、参数动态调整、旧进程优雅终止等关键逻辑。该方案适用于高可用系统升级场景,能够有效避免传统部署方式导致的服务中断问题,实现100%无感知的应用更新。

墨夶的博客 818

DeepSeek R1 本地安装部署(保姆级教程)

摘要: DeepSeek R1是一款开源AI模型,性能媲美商业模型,支持本地离线部署,保障数据隐私且免费使用。本文提供Mac、Windows、Linux系统的本地部署教程,适合入门者。DeepSeek基于Qwen 7B架构,提供1.5B到70B参数版本,硬件要求灵活,甚至支持CPU运行。本地部署优势包括隐私保护、零成本和完全自主控制。文章详细介绍了最低配置方案,确保用户轻松上手,避免高硬件需求带来的门槛。通过简单步骤即可实现AI模型的本地化应用。

Trb701012的博客 1152

Unreal从入门到精通之 UE4 vs UE5 VR性能优化实战

这篇文章分享了UE5 VR项目的性能优化经验。作者通过对比UE4和UE5的VR模板性能,发现UE5默认帧率只有45FPS,远低于UE4的100FPS。主要性能瓶颈来自Lumen全局光照、虚拟阴影贴图等新特性。文章详细列出了12项关键优化设置,包括禁用Lumen、关闭虚拟阴影、使用前向渲染等,并分析了各项调整对性能的影响程度。特别指出删除默认的VolumetricCloud可立即提升5帧。最后建议根据场景需求平衡画质与性能,对于高帧率要求的VR项目,可能需要谨慎使用UE5或关闭其部分高级渲染功能。

TxNet 1379

高效本地化AI:DeepSeek R1部署教程让你快速拥有AI助手

2025年春节,AI圈最炸裂的消息莫过于DeepSeek R1开源!这款号称“碾压GPT-4”的国产大模型,不仅数学推理、编程能力超强,还能离线运行、保护隐私,彻底摆脱网络卡顿和敏感数据泄露的烦恼。但网上教程鱼龙混杂,有人卡在安装界面,有人被显存劝退……今天这篇教程,将用最简三步法+实测避坑指南,帮你轻松搞定!

2401_85154887的博客 934

硬件工程师笔记——运算放大电路Multisim电路仿真实验汇总

本文系统介绍了运算放大电路的基础知识及其应用。主要内容包括:1)运算放大器的基本结构、理想特性及分析方法(虚短、虚断、叠加定理);2)比例运算电路(同向、反向、差分)的工作原理与仿真分析;3)求和运算、加减运算电路的实现方法;4)积分、微分、指数和对数运算电路的基本原理;5)过零电压比较器的功能特点。通过理论分析和仿真实验,详细阐述了各类运算放大电路的输入输出特性、相位关系和增益计算,为硬件工程师提供了实用的电路设计参考。

XU157303764的博客 2477

基于DPCNN实现电商情感分析任务

下载链接项目中使用的模型是DPCNN,在模型中我们定义了三个组件,分别是embedding层,卷积层和全连接层。Embedding层:将每个词生成对应的嵌入向量,就是利用一个连续型向量来表示每个词卷积层:提取语句中的语义信息Linear层:将结果映射成2大小用于二分类,即正反面的概率。

优快云 精品推荐 1629

WPS 集成 DeepSeek-R1 实战:用 VBA 宏把推理模型装进文档,实现一键生成与润色

本文是一份可直接落地的实操指南,讲解如何通过 WPS 的「开发工具 + VBA 宏」将 DeepSeek-R1 推理模型接入文档编辑器,实现选中文字即可调用 AI 生成内容、优化表达与逻辑分析。文章完整覆盖 API Key 获取、宏环境配置、VBA 代码逐段解析、功能区按钮定制、模板复用五大环节,并附上本仓库中同系列文档的扩展用法(Word 双模型版本、Excel 单元格调用),读完后你可以在自己

gitblog_00771的博客 154

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

ollama系列01:轻松3步本地部署deepseek,普通电脑可用

本文介绍了如何使用ollama本地部署DeepSeek等大模型,通过干货分享了ollama常用的指令,以及如何获取更多大模型。但是我们目前仍然只是在命令行使用大模型,非常的不友好。下一章我们将介绍如何摆脱命令行的束缚,将ollama集成到本地的AI工具中,实现聊天、自定义智能体等功能。👉关注我,持续分享AI工具,AI应用场景,AI学习资源❤️。

weixin_29408705的博客 99

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

5分钟搭建你的AI投资智囊团:TradingAgents-CN实战指南

你是否曾经想过,如果能拥有一个24小时不间断工作的投资分析团队该有多好?一个能实时监控市场动态、分析财务数据、评估风险并给出专业建议的智能助手。现在,这个梦想通过TradingAgents-CN变成了现实🎯 TradingAgents-CN是一个基于多智能体LLM技术的中文金融交易框架,它将AI大语言模型与传统金融分析完美结合,为你打造一个永不疲倦的投资智囊团。与传统的单一AI工具不同,它采用

gitblog_00356的博客 448

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

TradingAgents-CN:5分钟掌握基于多智能体的中文金融分析框架

在当今信息爆炸的金融市场中,个人投资者往往面临专业分析工具昂贵、操作复杂、信息不对称的困境。TradingAgents-CN作为一款开源的多智能体LLM金融交易决策框架,将华尔街专业投资团队的协作模式数字化、自动化,让普通用户也能享受机构级的智能分析服务。本文将从核心价值、应用场景到快速上手,为您全面解析这款革命性的金融分析工具。 ## 核心价值:重新定义智能投资分析范式 TradingAge

gitblog_00722的博客 334

如何在10分钟内搭建你的AI投资智囊团?TradingAgents-CN多智能体框架实战指南

想象一下这样的场景:凌晨两点,你还在研究某只股票的财报数据,试图从数百页的PDF文件中找出关键指标。第二天开盘前,你需要分析市场情绪、技术指标、行业动态,还要评估风险承受能力。时间紧迫,信息繁杂,决策压力巨大——这是每个投资者都曾面临的困境。 然而,现在有一种全新的方式:让四个专业的AI智能体组成你的投资智囊团,它们各司其职、协同工作,在几分钟内为你提供全面的分析报告。这就是TradingAge

gitblog_07288的博客 545
上一篇: 救命!清华大学最新出了DeepSeek 104页版本使用手册!
下一篇: 小白都能看懂,deepseek本地部署教程(附教程)
Llama-Turbo
博客等级 码龄4年 9901粉丝 2021原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值