


本文将探讨于2024年3月21日发布的LLama-Factory,并学习如何使用 DigitalOcean 旗下的 Paperspace平台对 LLama 3 进行微调。为了完成我们的任务,我们将使用 NVIDIA A4000 GPU,它被认为是功能最强大的单插槽 GPU 之一,能够无缝集成到各种工作站中。
RTX A4000 采用了 NVIDIA Ampere 架构,集成了 48 个第二代 RT Core、192 个第三代 Tensor Core 和 6144 个CUDA 核心,以及带有错误校正码(ECC)的 16GB 图形内存。这些配置确保了它能为创新项目提供精确可靠的计算能力。
一直以来,微调大语言模型一直是一项复杂的任务,主要由深谙机器学习和人工智能的工程师完成。然而,随着人工智能领域的不断发展,这一观念正在迅速改变。类似 LLama-Factory 等新工具的出现,使得微调过程更加便捷和高效。此外,现在还可以使用 DPO、ORPO、PPO 和 SFT 等技术进行微调和模型优化。更进一步说,大家现在可以有效地训练和微调如 LLama、Mistral、Falcon 等模型。
什么是模型的微调?
微调模型涉及调整预训练模型或基础模型的参数,这些参数可用于特定任务或数据集,可以提高模型的性能和准确性。这个过程涉及向模型提供新数据并修改其权重、偏差和某些参数。通过这种方式,可以让这个新模型可以在新任务或数据集上获得更好的表现,而无需为了新任务或数据从头开始开发一个模型,从而节省时间和资源。
通常,当创建新的大语言模型(LLM)时,它会在大量文本数据上进行训练,这些数据可能包含潜在的有害的数据。在预训练或初始训练阶段之后,该模型会被进行微调,并采取一些安全措施,以确保其避免生成有害或有毒的响应。然而,这种方法仍有改进的空间。不过,微调解决了需要让模型适应特定需求的问题。
为什么要用 LLama-Factory?
LLama Factory,这个工具能够高效且低成本地支持对 100 多个模型进行微调。LLama Factory 简化了模型微调的过程,并且易于访问,使用体验友好。此外,它还提供了由 Hiyouga 提供的 Hugging Face 空间,可用于对模型进行微调。
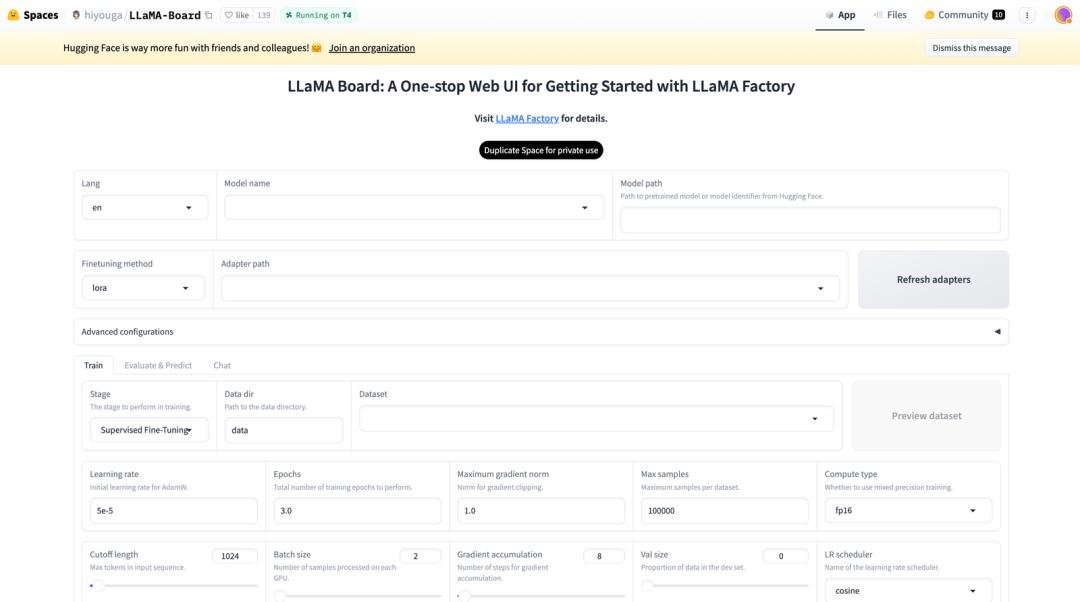
图:LLama Board(Huggingface 空间)
这个空间还支持 Lora 和 GaLore 配置,以减少 GPU 的使用。用户可以通过简单的滑块轻松更改参数,如 dropout、epochs、批次大小等。同时,也有多个数据集选项可供选择以微调你的模型。正如本文所述,LLama Factory支持许多模型,包括不同版本的 LLama、mistral 和 Falcon。它还支持像 galore、badm 和 Lora 这样的高级算法,提供诸如flash attention、位置编码和缩放等各种功能。
此外,你还可以集成像 TensorBoard、VanDB 和 MLflow 这样的监控工具。为了更快地进行推理,你还可以使用Gradio 和 CLI。本质上,LLama Factory 提供了一系列多样化的选项,以增强模型性能并简化微调过程。
LLama Board:LLama Factory 的统一****用户界面
LLama Board 可以帮助人们调整和改进语言模型(LLM)的性能,而无需了解如何编写代码。它就像一个仪表板,让你可以轻松地自定义语言模型如何学习和处理信息。
以下是它的一些关键特性:
-
易于定制:你可以通过在网页上调整设置来改变模型的学习方式。默认设置适用于大多数情况。你还可以在开始之前查看模型将如何查看你的数据。
-
进度监控:随着模型的学习,你可以看到更新和图表,显示它的表现如何。这有助于你了解它是否正在改进。
-
灵活的测试:你可以通过将模型与已知答案进行比较,或自己与其交流,来检查模型理解文本的程度。这有助于你观察模型是否在理解语言方面变得越来越好。
-
支持多种语言:LLama Board 支持英语、俄语和中文,对于说不同语言的人来说很有用。它也被设置为在未来添加更多语言。
使用 Paperspac 微调 LLama3
我们此前也介绍过如何在 Paperspace 上跑 LLama3 Demo。我们这次来对 LLama3 进行微调。如果你还对目前DigitalOcean 的 Paperspace GPU 云服务不熟悉,可以参考 DigitalOcean 英文官网的更多文档。另外,DigitalOcean 提供多种 GPU 可供选择,包括 H100、A100 等,按秒计费,能合理控制成本。
让我们登录到 Paperspace 平台,选择你希望使用的 GPU,并开始使用notebook(Paperspace 上的 IDE)。你还可以点击上面的链接来帮助你启动 notebook。
1、首先,我们将克隆仓库并安装必要的库
!git clone https://github.com/hiyouga/LLaMA-Factory.git``%cd LLaMA-Factory``%ls
2、接下来,我们将安装 unsloth,它允许我们有效地对模型进行微调。此外,我们还会安装 xformers 和 bitsandbytes。
# install necessary packages``!pip install "unsloth[colab-new] @ git+https://github.com/unslothai/unsloth.git"``!pip install --no-deps xformers==0.0.25``!pip install .[bitsandbytes]``!pip install 'urllib3<2'
3、一旦所有东西都安装好了,我们将检查 GPU 规格
!nvidia-smi
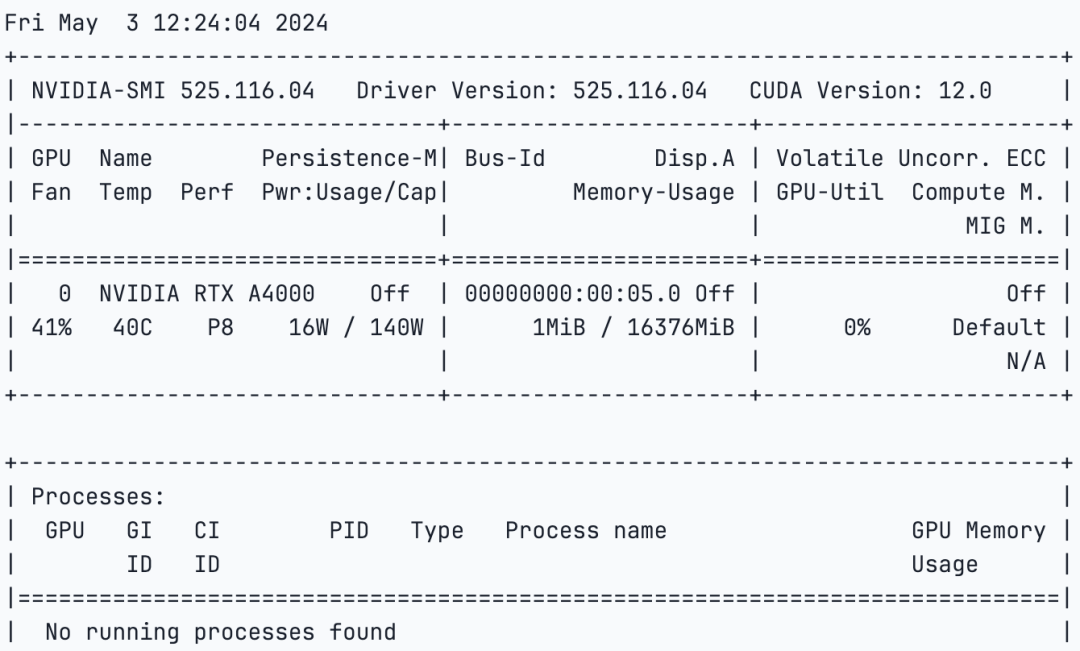
4、接下来,我们将导入torch并检查我们 的CUDA,因为我们正在使用 GPU,
import torch``try:` `assert torch.cuda.is_available() is True``except AssertionError:` `print("Your GPU is not setup!")
5、我们现在将导入我们克隆的 GitHub仓库附带的数据集。我们也可以创建一个自定义数据集并使用它。
import json`` ``%cd /notebooks/LLaMA-Factory``MODEL_NAME = "Llama-3"`` `` ``with open("/notebooks/LLaMA-Factory/data/identity.json", "r", encoding="utf-8") as f:` `dataset = json.load(f)`` ``for sample in dataset:` `sample["output"] = sample["output"].replace("MODEL_NAME", MODEL_NAME).replace("AUTHOR", "LLaMA Factory")`` ``with open("/notebooks/LLaMA-Factory/data/identity.json", "w", encoding="utf-8") as f:` `json.dump(dataset, f, indent=2, ensure_ascii=False)
6、完成上一步后,我们将执行下面的代码,为 Llama Factory 生成 Gradio 网络应用链接。
#generates the web app link` `%cd /notebooks/LLaMA-Factory``!GRADIO_SHARE=1 llamafactory-cli webui
你可以单击生成的链接并按照说明进行操作,也可以使用你的方法。
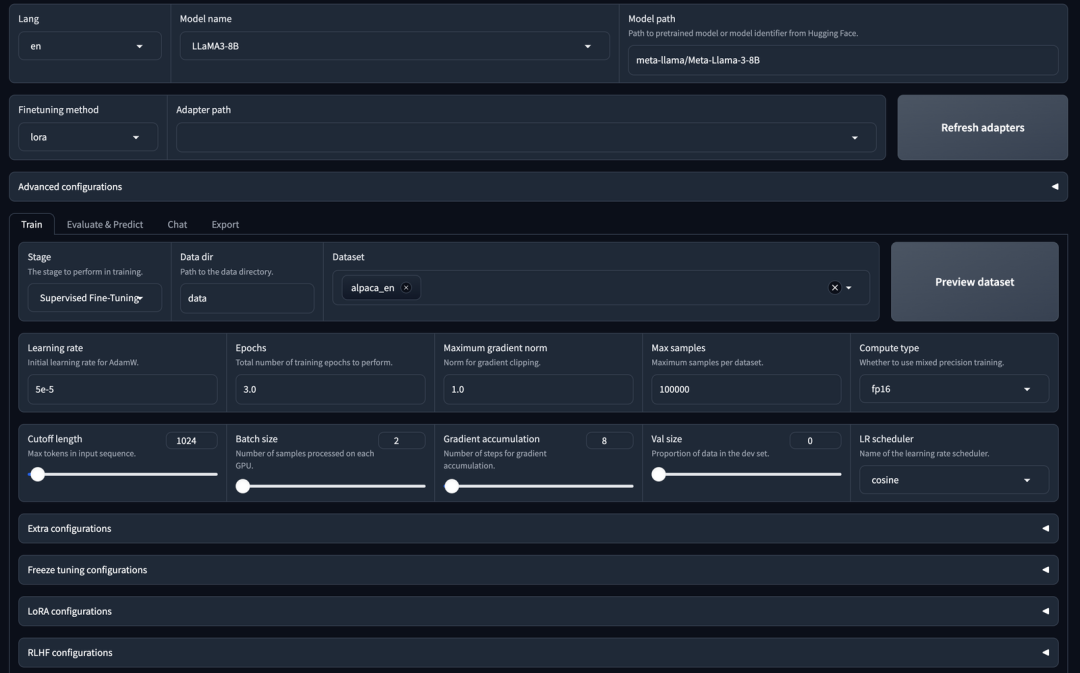
型号选择:
- 你可以选择任何模型;在这里,我们选择具有80亿个参数的Llama 3。
适配器配置:
-
你可以选择指定适配器路径。
-
可用的适配器包括LoRa、QLoRa、freeze或full。
-
如果需要,你可以刷新适配器列表。
培训选项:
-
你可以使用监督微调来训练模型。
-
或者,你可以选择 DPU(数据处理单元)或 PPU(并行处理单元)。
数据集选择:
-
所选数据集用于监督微调(SFT)。
-
你也可以选择自己的数据集。
超参数配置:
- 你可以调整超参数,例如迭代次数、最大梯度范数和最大样本大小。
Laura配置:
- LoRa型号提供详细的配置选项。
开始培训:
- 设置完所有配置后,你可以通过单击“开始”按钮启动训练过程。
下面将开始训练。我们还将使用 CLI 命令开始训练和微调。你可以使用以下代码指定参数。
args = dict(` `stage="sft", # Specifies the stage of training. Here, it's set to "sft" for supervised fine-tuning` `do_train=True,` `model_name_or_path="unsloth/llama-3-8b-Instruct-bnb-4bit", # use bnb-4bit-quantized Llama-3-8B-Instruct model` `dataset="identity,alpaca_gpt4_en", # use the alpaca and identity datasets` `template="llama3", # use llama3 for prompt template` `finetuning_type="lora", # use the LoRA adapters which saves up memory` `lora_target="all", # attach LoRA adapters to all linear layers` `output_dir="llama3_lora", # path to save LoRA adapters` `per_device_train_batch_size=2, # specify the batch size` `gradient_accumulation_steps=4, # the gradient accumulation steps` `lr_scheduler_type="cosine", # use the learning rate as cosine learning rate scheduler` `logging_steps=10, # log every 10 steps` `warmup_ratio=0.1, # use warmup scheduler` `save_steps=1000, # save checkpoint every 1000 steps` `learning_rate=5e-5, # the learning rate` `num_train_epochs=3.0, # the epochs of training` `max_samples=500, # use 500 examples in each dataset` `max_grad_norm=1.0, # clip gradient norm to 1.0` `quantization_bit=4, # use 4-bit QLoRA` `loraplus_lr_ratio=16.0, # use LoRA+ with lambda=16.0` `use_unsloth=True, # use UnslothAI's LoRA optimization for 2x faster training` `fp16=True, # use float16 mixed precision training``)`` ``json.dump(args, open("train_llama3.json", "w", encoding="utf-8"), indent=2)``
接下来,打开一个终端并运行以下命令
!llamafactory-cli train train_llama3.json
下面的代码会开启训练
7、一旦模型训练完成,我们就可以使用该模型进行推断。让我们试着这样做并检查模型是如何工作的。
args = dict(` `model_name_or_path="unsloth/llama-3-8b-Instruct-bnb-4bit", # Specifies the name or path of the pre-trained model to be used for inference. In this case, it's set to "unsloth/llama-3-8b-Instruct-bnb-4bit".` `#adapter_name_or_path="llama3_lora", # load the saved LoRA adapters` `finetuning_type="lora", # Specifies the type of fine-tuning. Here, it's set to "lora" for LoRA adapters.` `template="llama3", # Specifies the prompt template to be used for inference. Here, it's set to "llama3"` `quantization_bit=4, # Specifies the number of bits for quantization. In this case, it's set to 4` `use_unsloth=True, # use UnslothAI's LoRA optimization for 2x faster generation``)`` ``json.dump(args, open("infer_llama3.json", "w", encoding="utf-8"), indent=2)``
在这里,我们使用保存的适配器定义我们的模型,选择聊天模板,并指定用户与助手的交互。
接下来,使用你的终端运行以下代码,
!llamafactory-cli chat infer_llama3.json
建议你可以使用 Llama-Factory 与其它模型做做尝试,调整参数。
小结
有效的微调已成为大型语言模型(LLMs)适应特定任务的必要条件之一。然而,这需要一定的努力,有时也相当具有挑战性。随着 Llama-Factory 的引入,这一全面的框架让训练更加高效,用户无需编写代码即可轻松为超过 100 个 LLMs 定制微调。
现在,很多人对大型语言模型(LLMs)更加好奇,有这样想法的开发者可以试试 Llama-Factory 是否可以调整自己的模型。这有助于开源社区的成长和活跃。Llama-Factory 正变得广为人知,甚至已被列入 Awesome Transformers3 中,作为高效微调 LLMs 的工具。
我们希望本文能鼓励更多开发者使用这一框架来创建有价值的 LLMs。不过请记得,在使用Llama-Factory微调LLMs时,遵守模型的许可规则很重要。
如何系统的去学习大模型LLM ?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
事实上,抢你饭碗的不是AI,而是会利用AI的人。
继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?
与其焦虑……
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。
针对所有自学遇到困难的同学们,我帮大家系统梳理大模型学习脉络,将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

一、LLM大模型经典书籍
AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

二、640套LLM大模型报告合集
这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

三、LLM大模型系列视频教程

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

LLM大模型学习路线 ↓
阶段1:AI大模型时代的基础理解
-
目标:了解AI大模型的基本概念、发展历程和核心原理。
-
内容:
- L1.1 人工智能简述与大模型起源
- L1.2 大模型与通用人工智能
- L1.3 GPT模型的发展历程
- L1.4 模型工程
- L1.4.1 知识大模型
- L1.4.2 生产大模型
- L1.4.3 模型工程方法论
- L1.4.4 模型工程实践
- L1.5 GPT应用案例
阶段2:AI大模型API应用开发工程
-
目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
-
内容:
- L2.1 API接口
- L2.1.1 OpenAI API接口
- L2.1.2 Python接口接入
- L2.1.3 BOT工具类框架
- L2.1.4 代码示例
- L2.2 Prompt框架
- L2.3 流水线工程
- L2.4 总结与展望
阶段3:AI大模型应用架构实践
-
目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
-
内容:
- L3.1 Agent模型框架
- L3.2 MetaGPT
- L3.3 ChatGLM
- L3.4 LLAMA
- L3.5 其他大模型介绍
阶段4:AI大模型私有化部署
-
目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
-
内容:
- L4.1 模型私有化部署概述
- L4.2 模型私有化部署的关键技术
- L4.3 模型私有化部署的实施步骤
- L4.4 模型私有化部署的应用场景
这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓
 1465


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


