【AI大模型】RAG效果优化:高质量文档解析详解

RAG——RAG 索引(文档解析技术) 本文介绍了RAG系统中文档解析的关键技术,重点分析了如何通过LangChain的Document Loaders处理多种格式文档。文章指出高质量文档解析对RAG系统效果的决定性作用,并详细讲解了PDF、TXT、Word等常见格式的解析方法。作者提供了代码示例和Gitee开源项目链接,特别强调了PDF解析的深入方案,同时介绍了相关依赖库的安装配置。文章还展示了如何定义通用文档加载方法,为开发者提供了实用的技术参考。 阅读详情
AI摘要

本文围绕非结构化数据转换为结构化数据展开,介绍了Word和PDF文档解析方法,对比了docx和doc格式特点,分析了PDF解析开源工具及关键问题。还提及阿里云搜索文档内容解析架构和效果。此外,为程序员梳理了LLM大模型学习脉络,分享了经典书籍、报告合集、视频和开源教程等学习资源。

本文关于如何将非结构化数据(如PDF和Word文档)转换为结构化数据,以便于RAG(Retrieval-Augmented Generation)系统使用。

背景

尽管通用大语言模型(LLM)在知识问答方面取得了非常大的进展,但是对于专业领域依然无能为力,因为专业领域的数据不会对外公开,通用LLM没有学习过,自然不会回答。一种思路是将这些专业数据喂给LLM进行微调,但是对技术和成本要求往往太高,而RAG系统则是解决专业领域问答的另一种思路,在用户原始问题之后加上与之相关的私域数据一起提问,由通用LLM进行分析和总结。通过检索增强的方式为LLM提供更加精准的信息,从而提升最终回答效果,如下图所示:
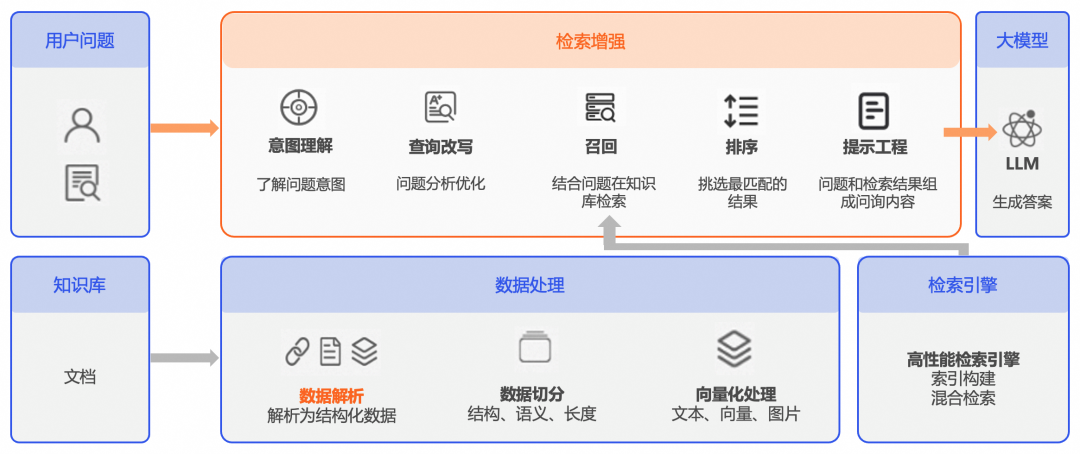
知识数据库是RAG系统的核心组件,需要离线将各类私域文档转换成计算机可检索的数据。实际场景中,大部分专业文档都是以pdf、doc等非结构化数据进行存储,它们有标题、段落、表格、图片等元素,易于人类阅读,却不适合计算机进行检索和处理。文档解析是将这些非结构化文档转换为半结构化的文档(如markdown、html),由系统后续进行切片、向量化处理,最终形成可检索的结构化数据。因此,文档解析是RAG系统的第一步,所谓better input better output,高质量的解析结果自然会提升RAG系统整体的效果。

Word与Pdf对比

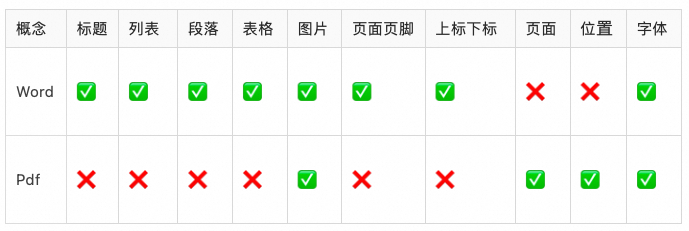
Pdf和Word(MS Office 2007之前为doc,之后为docx)是两种最常见的文档格式,但是二者有本质区别:

  • Word倾向于编辑。 Docx格式遵循Office Open XML标准[1],底层通过xml保存数据,有标题、段落、表格等概念,但是不含页面和位置的概念,文档各个元素最终展现的位置由实际的渲染引擎决定(同一份文档不同软件打开后显示结果可能不同)。解析docx文件只需要按照标准读取底层的xml文件即可。doc格式在2008年才对外开放(此时已被docx替代),能够解析的开源工具很少,通常是转换为docx文件后进行解析。

  • Pdf倾向于阅读和打印。 文档存储了一系列绘制字符、线条等基本元素的指令,指示了阅读器或打印机在屏幕或纸张上显示符号的位置和方式。相比word,pdf有页面和位置的概念,在不同终端的展示效果一致。因为不需要编辑,pdf中没有标题、段落、表格等概念,例如标题只是大号加粗的文字,表格只是对齐排列的线条和文字。解析pdf文件除了需要提取出文字外,还需要进行额外的版面恢复、表格识别等操作。

以下是docx和pdf文件结构的示例:

<w:document>`   `<w:body>`       `<!-- 段落 -->`       `<w:p w:rsidR="005F670F" w:rsidRDefault="005F79F5">`           `<w:r>`             `<!-- 文本属性 -->`             `<w:rPr>`                `<w:rFonts w:ascii="Arial" w:hAnsi="Arial" w:cs="Arial"/>`                `<w:color w:val="000000"/>`              `</w:rPr>`              `<w:t>Hello world!</w:t>`            `</w:r>`       `</w:p>`       `<!-- 页面属性 -->`       `<w:sectPr w:rsidR="005F670F">`           `<w:pgSz w:w="12240" w:h="15840"/>`           `<w:pgMar w:top="1440" w:right="1440" w:bottom="1440" w:left="1440" w:header="720" w:footer="720"`                    `w:gutter="0"/>`           `<w:cols w:space="720"/>`           `<w:docGrid w:linePitch="360"/>`       `</w:sectPr>`   `</w:body>``</w:document>

4 0 obj                 % 页面内容流``<< >>``stream                  % 流的开始``1. 0. 0. 1. 50. 700. cm % 位置在(50,700)``BT                      % 开始文本块` `/F0 36. Tf             % 在36pt选择/F0字体` `(Hello, World!) Tj     % 放置文本字符串``ET                      % 结束文本块``endstream               % 流结束``endobj

总结:
Word解析

docx格式

一个DOCX文件实际上是一个包含多个文件和文件夹的压缩包,可以用解压缩工具进行解压。最小结构如下,示例为:

.``├── [Content_Types].xml``├── _rels``│   └── .rels``└── word`    `├── document.xml`    `└── _rels`        `└── document.xml.rels

其中word/document.xml是DOCX文档的主要内容。参考上面的示例,以下是一些关键标签:

  1. <w:document>:根元素,包含整个文档内容。

  2. <w:body>:文档主体部分,包含所有段落、表格和其他内容。

  3. <w:p> (Paragraph):段落元素。

  4. <w:r> (Run):包含一段连续的文本,带有相同的格式。

  5. <w:t> (Text):具体的文本内容。

  6. <w:sectPr> (Section Properties):节属性,定义页面设置如页边距、页码、页眉页脚等。

doc格式

doc格式本身是一个OLE(Object Linking and Embedding)复合文档,文档将数据分成很多流(Steams),存储在不同的 Storages 里,详见MS-DOC文件格式规范[2]。其中WordDocument二进制流是文档的主要内容,必须存在。据目前所知,python环境下没有任何库能够直接读取doc文件中的内容。python olefile虽然可以打开doc文件,但也仅限于打开,无法理解(decode)WordDocument等流。因此python环境下一般通过libreoffice将doc文件转换为docx文件进行解析。同时为了避免文件加密导致转换失败,可以借助olefile及文件格式规范进行提前判断。

Pdf解析

开源工具

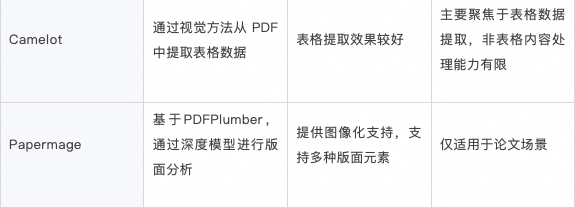
目前python开源的pdf解析工具很多,总结如下:
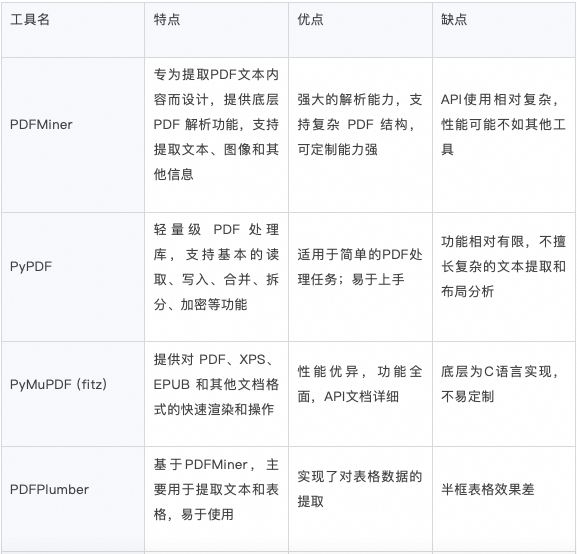
其中Papermage对PDFPlumber进行了封装,并基于多个模型进行版面分析,功能最全,能识别标题、作者、摘要等元素,但仅限于论文场景。类似的还有ragflow-deepdoc[3](参考:深度解读RAGFlow的深度文档理解DeepDoc[4])。下面详细介绍下Papermage。

PaperMage介绍

第一步——纯文本提取

基于PDFPlumber将pdf中的文字部分提取出来,得到words集合,并基于words位置关系检测文本行(lines)。

第二步——视觉标注

将pdf按页光栅化成位图,通过目标检测技术识别位图中的元素,得到blocks,每个block包括了边界框(bounding box,bbox)和标签(如图片、表格等)信息。光栅化操作使用了pdf2image库(底层是poppler),目标检测模型用的是efficientdet系列模型:layoutparser/efficientdet · Hugging Face[5]。可视化结果如下:
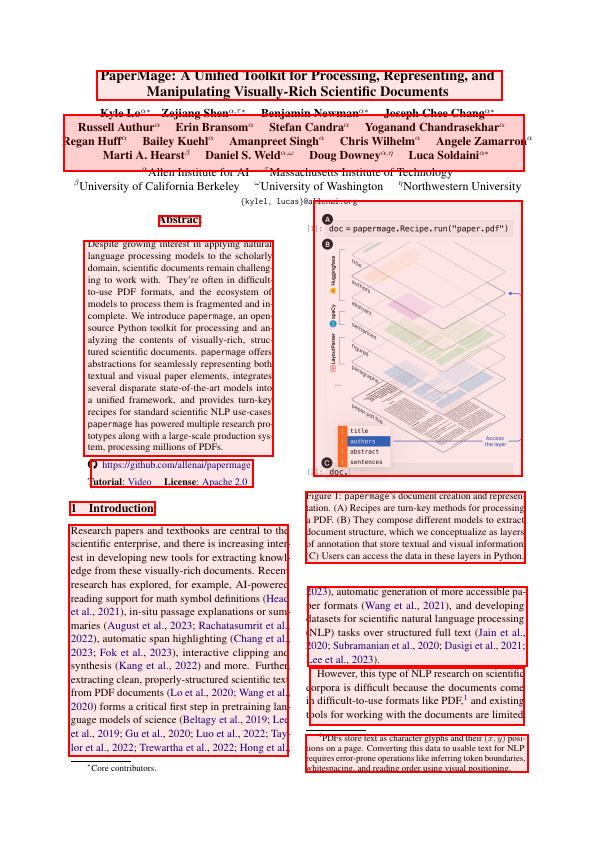
可以发现,bbox是一个大致区域,主要目的是通过位置关系将words划分到不同label的blocks中,即第三步中的block_ids和labels。

第三步——字符级标注

字符标注模型使用了I-VILA系列模型(allenai/ivila-block-layoutlm-finetuned-s2vl-v2[6]),将前两步的结果作为输入,输入格式入下:

{`  `"words": ["word1", "word2", ...],`  `"block_ids": [0, 0, 0, 1 ...],`  `"line_ids": [0, 1, 1, 2 ...],`  `"labels": [0, 0, 0, 1 ...],``}

预测出的标签有:

{`  `"0": "Title",`  `"1": "Author",`  `"2": "Abstract",`  `"3": "Keywords",`  `"4": "Section",`  `"5": "Paragraph",`  `"6": "List",`  `"7": "Bibliography",`  `"8": "Equation",`  `"9": "Algorithm",`  `"10": "Figure",`  `"11": "Table",`  `"12": "Caption",`  `"13": "Header",`  `"14": "Footer",`  `"15": "Footnote"``}

模型对于每个word都会预测出一个标签,相同标签的word聚合成一个实体(如titles、authors等),而实体的外接框为实体中所有word的外接框。

可视化结果如下(不同颜色表示不同实体,如红色表示标题,橙色表示作者,绿色表示段落,黑色表示脚注等):
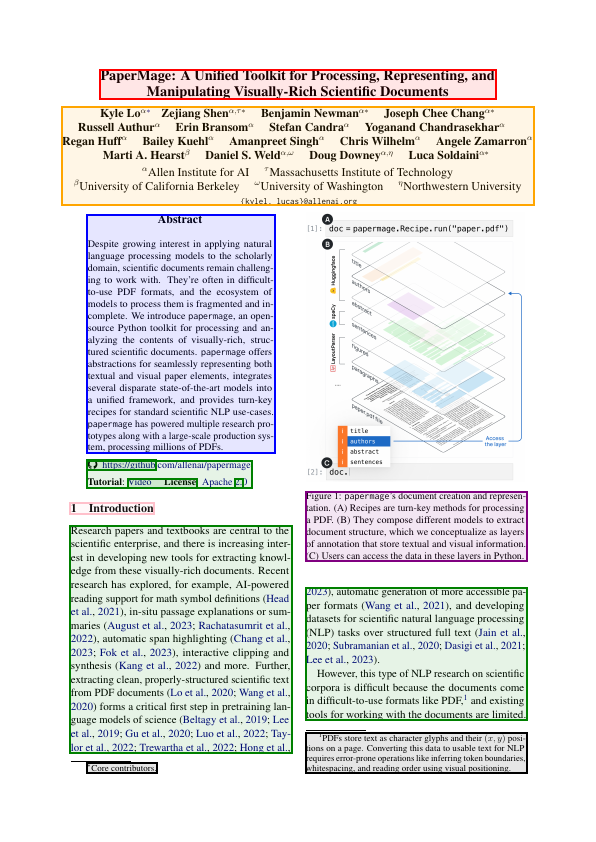
可以发现如果某个区域未提取到任何word,则该区域就不会被标注,因此上图中图片未识别到(目标检测模型虽然检测到,但标签识别错误)。

总结:

目前开源工具可以分为两类。

(1)基于规则的方式,优势:适用性广泛、速度快。劣势:效果一般,识别的版面元素有限,且识别效果较差;

(2)基于模型的方式,优势:能够识别更多更上层的版面元素,有利于后续切片。劣势:速度慢,依赖GPU资源,适用的场景有限,识别过程黑盒(比如难以纠正上图中图片未识别的错误)。

关键问题

版面元素恢复

前面提到,pdf相比word缺少了很多版面元素的概念,如果仅提取文本则会丢失很多信息(如语义段落信息,文字大小,位置信息等),不利于后续的文档切片。版面恢复主要包括识别标题、段落、上下标、页眉页脚等。

表格结构识别

表格分为两种,一种是全框表格,另一种是半框表格(如论文中常见的三线表)。准确识别表格的前提是准确定位到表格区域,然后识别出表格结构,最后提取出每个单元格对应的文本。

阅读顺序还原

通过版式恢复后,能够输出版面元素的bounding box,如何准确的还原出符合人类阅读顺序的文档内容也是尤为重要。常见技术路径有:基于规则的方法(xy-cut等)、基于深度学习的方法(Layoutreader[7]等)

阿里云搜索文档内容解析

整体架构
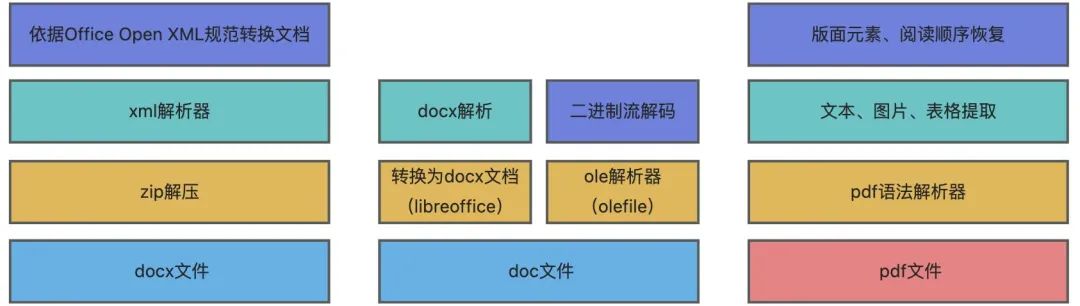
图中左侧和中间为doc/docx文件解析,右侧为pdf文件解析。对于pdf解析,我们采用了基于规则的方式,相比基于模型的方式,主要有以下考虑:

  1. 我们定位为通用场景,文档版面丰富多样,页数可能达到千页,模型性能泛化性达不到要求;

  2. GPU资源瓶颈,会限制服务最大吞吐量,而基于规则的方式只依赖CPU资源,可以无限扩缩;

  3. 模型效果黑盒化,badcase难以纠正。

所有格式最终输出为markdown格式,支持的版面元素:

  • 多级标题

  • 自然段划分

  • 图片(标量、矢量)

  • 表格(全框、半框)

  • 上标、下标(支持嵌套)

  • 页眉、页脚

pdf格式另外还支持:

  • 阅读顺序还原

  • 图片OCR(支持影印版)

  • PPT类型优化

效果示例

原文:PaperMage.pdf[8]

版面元素恢复
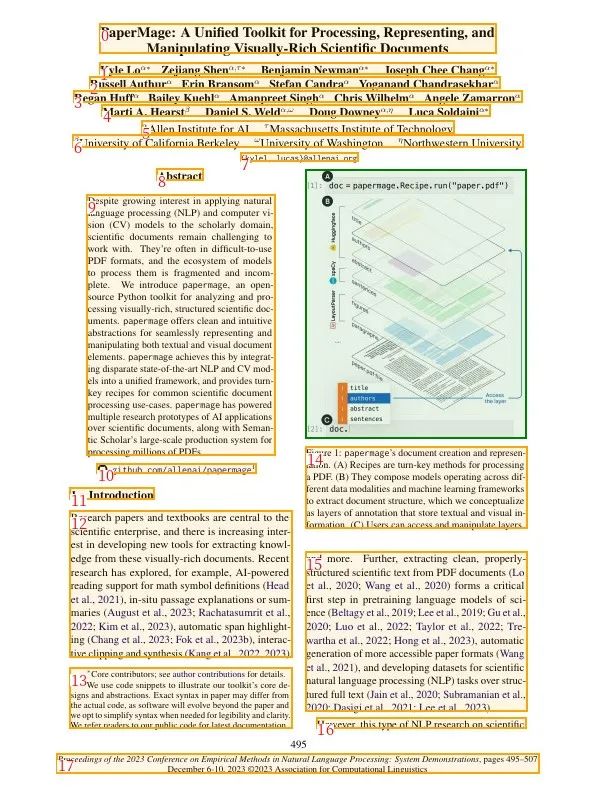
段落划分及阅读顺序,页脚识别
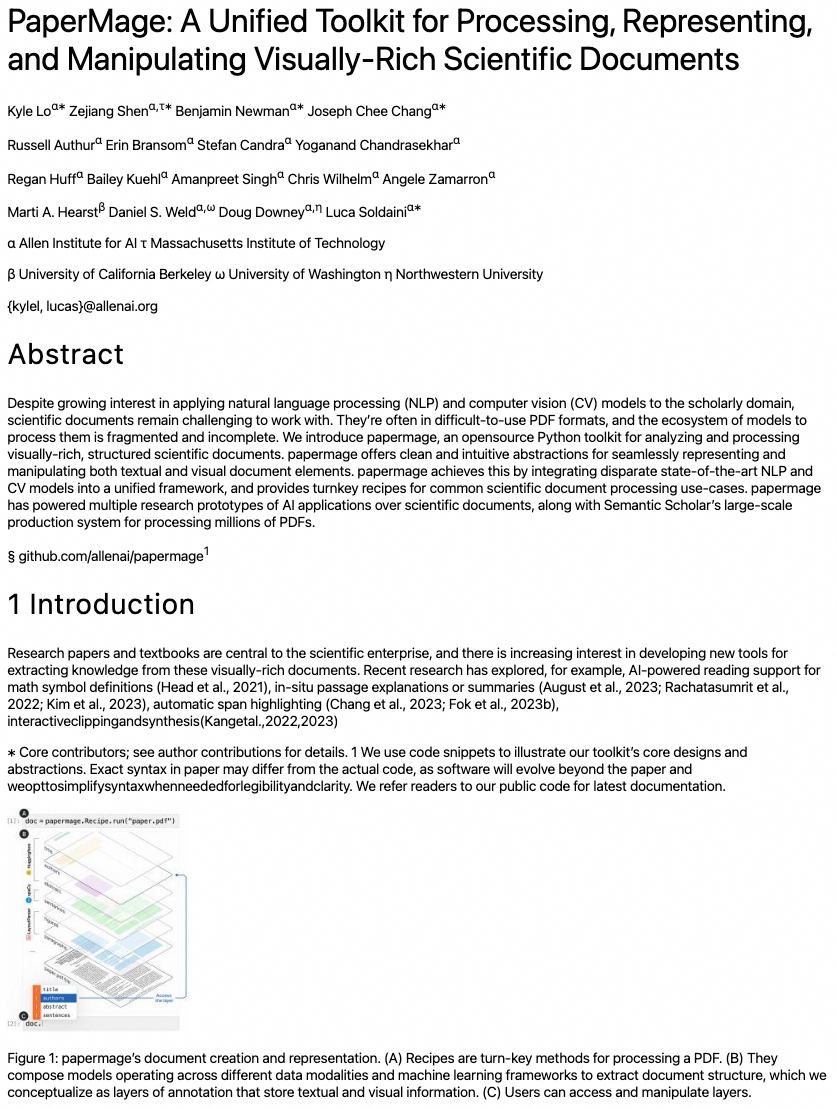
标题、段落、上下标、图片等元素识别

表格结构识别
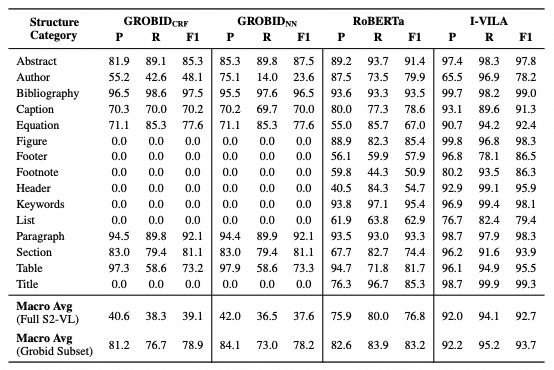
原文
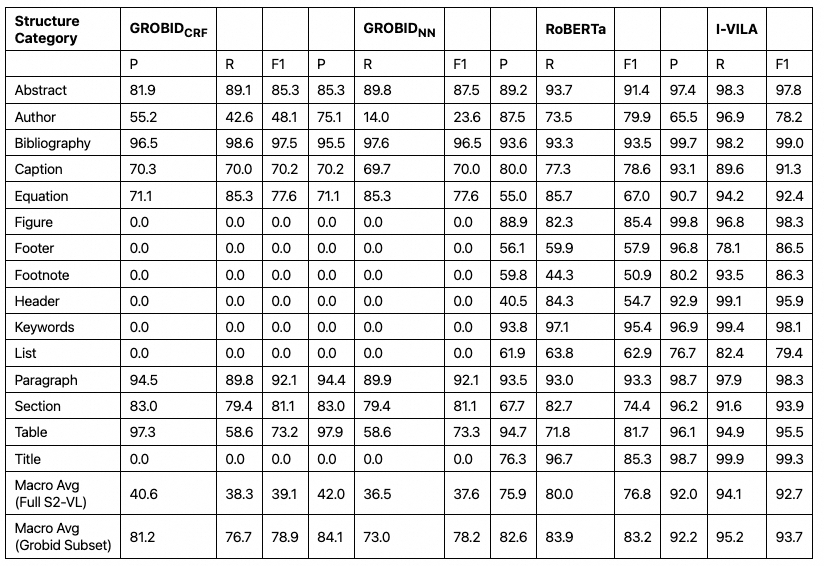
markdown

速度及准确率

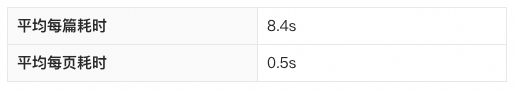
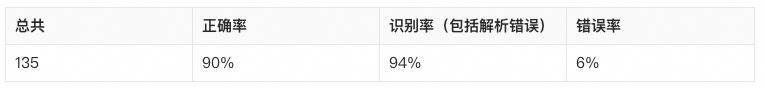
测试集:53篇论文

解析速度:
其中表格识别准确率(人工评测):
服务体验

RAG文档解析能力已在阿里云搜索开发工作台发布,搜索开发工作台围绕智能搜索及RAG场景,提供优质的组件化服务以及灵活的调用机制,内置文档解析、文档切片、文本向量、召回、排序及大模型等服务,可实现一站式灵活的AI搜索业务开发。

目前新用户可免费开通搜索开发工作台,获赠100次服务免费调用额度。

免费开通:https://common-buy.aliyun.com/?spm=5176.14058969.J_8356059010.3.548254f8Gi92L1&commodityCode=opensearch_platform_public_cn

文档解析API:https://help.aliyun.com/zh/open-search/search-platform/developer-reference/api-details

查看及体验搜索开发工作台更多服务:https://opensearch.console.aliyun.com/cn-shanghai/rag/server-market

程序员为什么要学大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

事实上,抢你饭碗的不是AI,而是会利用AI的人。

继科大讯飞、阿里、华为等巨头公司发布AI产品后,很多中小企业也陆续进场!超高年薪,挖掘AI大模型人才! 如今大厂老板们,也更倾向于会AI的人,普通程序员,还有应对的机会吗?

与其焦虑……

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高。

针对所有自学遇到困难的同学们,我帮大家系统梳理大模型学习脉络,将这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

一、LLM大模型经典书籍

AI大模型已经成为了当今科技领域的一大热点,那以下这些大模型书籍就是非常不错的学习资源。

在这里插入图片描述

二、640套LLM大模型报告合集

这套包含640份报告的合集,涵盖了大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。(几乎涵盖所有行业)

在这里插入图片描述

三、LLM大模型系列视频教程

在这里插入图片描述

四、LLM大模型开源教程(LLaLA/Meta/chatglm/chatgpt)

在这里插入图片描述

LLM大模型学习路线 ↓

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。

  • 内容:

    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
    • L1.4.1 知识大模型
    • L1.4.2 生产大模型
    • L1.4.3 模型工程方法论
    • L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。

  • 内容:

    • L2.1 API接口
    • L2.1.1 OpenAI API接口
    • L2.1.2 Python接口接入
    • L2.1.3 BOT工具类框架
    • L2.1.4 代码示例
    • L2.2 Prompt框架
    • L2.3 流水线工程
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。

  • 内容:

    • L3.1 Agent模型框架
    • L3.2 MetaGPT
    • L3.3 ChatGLM
    • L3.4 LLAMA
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。

  • 内容:

    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

这份 LLM大模型资料 包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码领取🆓↓↓↓

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

RagFlow 文档解析 RAGFlow 的设计哲学是“高质量输入,高质量输出”,它通过提供可解释性和可控性的生成结果,让用户能够信任并依赖于系统提供的答案。 阅读详情

相关推荐

RAG优化秘籍:非结构化文档解析全攻略大汇总

RAG技术的适用性极为广泛,包括问答系统、文档生成、智能助手、信息检索和知识图谱填充等自然语言处理任务,显著提升了大型语言模型在处理知识密集型任务时的性能。通过这些方法,可以高效地将不同格式的文档内容解析为结构化数据,进而在RAG技术中发挥其作用,提升信息检索和文本生成的准确性和效率。如果需要OCR技术来解析图像或扫描的PDF文档,选择高效的OCR引擎,如Tesseract,并对其进行参数调优。通过上述方法和策略,可以有效地优化PDF的解析过程,并高效地处理解析后的数据,为各种应用场景提供支持。

春华秋实 1032

RAG效果优化:高质量文档解析详解

本文介绍了如何通过高质量的文档解析提升RAG系统整体的效果。

科技很有意思 2838

【TextIn大模型加速器 + 火山引擎】我发现了文档解析神器!-- 用专业解析提升复杂文档问答效果

摘要: 本文探讨了如何通过TextIn文档解析工具结合Coze平台构建高效知识库应用。实验对比显示,TextIn在解析复杂格式文档(含表格、图片、多栏排版等)时表现优异,能显著提升Coze知识库的问答效果。传统解析方案存在格式兼容性差、复杂元素丢失等问题,而TextIn通过结构化输出和精准解析,使下游任务准确率提升35%-70%。研究证明,优化文档预处理质量是突破AI应用效果瓶颈的关键路径。

ronlym的博客 1万+

【文档智能 & RAG】RAG新基建-RAG性能增强关键技术点及通用文档解析工具-TextIn

在私有领域知识问答和企业知识管理领域,结合检索增强型生成模型(Retrieval-Augmented Generation, RAG)大模型(Large Language Model, LLM)已成为一种趋势。然而,在RAG系统的文档预处理阶段和检索阶段,经常碰到三个主要问题。企业内部常常积累了大量包含PDF格式的文档,这些文档的解析精度不足,严重制约了基于专业知识的问答系统的性能。因此,提高这些PDF文件的解析质量,对于构建高效的RAG系统至关重要。构建起一个完备的智能文档解析服务后,需要一个。

余俊晖,NLP炼丹师,目前专注自然语言处理领域研究。曾获得国内外自然语言处理算法竞赛TOP奖项近二十项。 4155

告别云端依赖:手把手教你在Windows 10/11上离线部署WhisperDesktop(含模型下载避坑指南)

本文详细介绍了如何在Windows 10/11上离线部署WhisperDesktop,包括硬件要求、模型下载、环境配置和实战应用。通过本地部署,用户可以实现高效的语音转文字功能,无需依赖云端服务,特别适合注重数据隐私和需要离线工作的场景。

weixin_33736048的博客 322

【基金量化研究系列】基金绩效归因模型——Brinson多期归因模型之python实现

文章目录1. 引言2. Brinson多期归因模型的Python实现2.1 基准数据读取模块2.2 持仓数据读取模块2.3 持仓收益与基准计算模块2.4 Brinson多期归因模型核心算法Brinson_Multiple2.5 主函数模块3. 归因结果写在最后 1. 引言 在上文中,我们已经介绍了Brinson归因模型的基本思想。那么,就让我们动起手来,实现这一方法吧! 在Brinson多期归因模型实现的过程中,本文使用模块化方法,将整个实现过程划分为如下五个功能板块: Module 1: 基准数据读取模

Mikey_Sun的博客 2万+

【大模型】RAG效果优化:高质量文档解析详解

基于PDFPlumber将pdf中的文字部分提取出来,得到words集合,并基于words位置关系检测文本行(lines)。

2401_85325726的博客 1766

Nacos 2.3.2与PostgreSQL的Docker化部署实战

本文详细介绍了Nacos 2.3.2与PostgreSQL的Docker化部署实战,包括环境准备、数据库配置、镜像获取与导入、容器部署及常见问题排查。通过Docker容器化技术,结合PostgreSQL的稳定性和扩展性,为微服务架构提供高效的服务发现和配置管理解决方案。

k5l6m的博客 283

RAG效果优化:高质量文档解析详解 | 大模型技术

基于PDFPlumber将pdf中的文字部分提取出来,得到words集合,并基于words位置关系检测文本行(lines)。

zhishi0000的博客 1852

海思Hi3516DV300实战:从yolov5模型训练到Sort跟踪算法的完整部署流程

本文详细介绍了在海思Hi3516DV300芯片上部署YOLOv5目标检测与Sort多目标跟踪算法的完整流程。内容涵盖从特定场景数据训练YOLOv5模型、模型格式转换(PyTorch到ONNX再到Caffe),到利用海思NNIE引擎生成WK模型并进行端侧集成与优化的全链路实战经验,旨在解决嵌入式设备上实时人流量统计等实际应用挑战。

weixin_29034963的博客 338

Ubuntu开机卡在BusyBox?3种方法快速修复initramfs错误(附详细命令)

本文详细介绍了Ubuntu开机卡在BusyBox并出现initramfs错误的3种修复方法,包括使用fsck检查文件系统、调整BIOS/UEFI存储设置以及修改GRUB内核参数。针对常见的文件系统错误和根设备无法找到问题,提供了具体的命令行操作步骤和实用技巧,帮助用户快速恢复系统启动。

milk8的博客 785

大模型 | RAG效果优化:高质量文档解析详解(上)

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

m0_56255097的博客 1598

【Unity3D插件】XCharts插件完全教程《全网最全》-专栏文章目录

最近在做图表类需求功能的时候,发现了一款强大的Unity3D插件,也就是XCharts图表插件,功能强大,支持多种图表。官方介绍:一款基于UGUI的功能强大、简单易用的数据可视化图表插件。支持折线图、饼状图、饼图、雷达图、散点图、热力图、环形图、K线图、极坐标、平行坐标等十多种内置图表,以及3D饼图、3D金字塔、漏斗图、仪表盘、水位图、象形柱图、甘特图、矩形树图等拓展图表。内置丰富示例和模板,参数可视化配置,效果实时预览,纯代码绘制。支持折线图、柱状图、饼图、雷达图、散点图、热力图等常见图表。

优快云博客专家,Unity3D高级软件工程师,《Unity 3D从入门到实战》作者。 3197

大模型应用潜力:高质量文档解析技术与RAG系统优化

文档解析是一款大模型友好的解析工具,能够精准还原pdf、word、excel、ppt、图片等十余种格式的非结构化文件,将其快速转换为Markdown或JSON格式返回,同时包含精确的页面元素和坐标信息。支持识别文本、图像、表格、公式、手写体、表单字段、页眉页脚等各种元素,并支持印章、二维码、条形码等子类型,为LLM推理、训练输入高质量数据,帮助完成数据清洗和文档问答任务,适用于各类AI应用程序,如知识库、RAG、Agent或其他自定义工作流程。

老皮的博客 1063

QGIS之七建筑面由DSM和DEM获取高度并可视化

QGIS建筑面由DSM和DEM获取高度并可视化

yilvyangguang520的博客 3511

低功耗设计:rush current

在power gating的设计中引入了一个rush current的概念,它的产生原因是switch cell上电过程相当于电容充电过程,会产生一个短期的大电流,称之为rush current。 1.rush current的危害 1)造成巨大的ir drop 2)导致功能错误 3)一些极端例子中,rush current会引发VDD短期崩溃,造成存储在retention register与mem中的数据失效 4)大电流会还对周围always on模块造成干扰,产生大的压降 2.控制rus

m0_61544122的博客 3071

大模型 | RAG效果优化:高质量文档解析详解(下)

目前开源工具可以分为两类。(1)基于规则的方式,优势:适用性广泛、速度快。劣势:效果一般,识别的版面元素有限,且识别效果较差;(2)基于模型的方式,优势:能够识别更多更上层的版面元素,有利于后续切片。劣势:速度慢,依赖GPU资源,适用的场景有限,识别过程黑盒(比如难以纠正上图中图片未识别的错误)。AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。

m0_56255097的博客 1501

pscad IEEE标准系统搭建说明

pscad IEEE标准系统搭建说明,包含典型的IEEE 9节点、14节点、30节点、39节点和118节点系统。内含标准测试系统的原始数据和潮流结果。

打造自己的RAG解析大模型:金融、财务、保险、证券的AI助理知识库PDF文档解析,只需看这一篇

金融、财务、保险和证券领域的PDF文档解析,是构建AI助理知识库的重要技术环节。这些文档通常包含事件总结、财务报表、年度销售等核心表格数据。通过版面分析、表格识别和文本提取,将文档内容结构化并存储到向量数据库中,为RAG系统提供高质量数据块支持。这些解析数据的使用场景包括:智能投顾系统提供实时数据支持、财务报表的自动化审计、保险理赔的智能核算以及证券分析中的自动数据提取,显著提升工作效率与决策精准度。这种解析能力能够帮助企业快速处理大规模非结构化文档,降低人工操作成本并优化核心业务流程。

m0_59164520的博客 1348

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

提升RAG系统的回答质量:高质量企业文档解析

LLM(大型语言模型)在生成自然语言文本方面展现出强大的能力,但它们的训练数据通常来自于公开的、广泛的数据源,这意味着它们在面对特定企业的私有数据时,可能无法准确地生成相关的答案或信息。一种可行的思路是将这些专业数据用于微调大型语言模型(LLM),但这通常对技术和成本的要求都非常高。相比之下,RAG系统提供了一个更加经济和高效的解决方案。它通过在用户的原始问题后附加相关的私域数据,将其与通用LLM结合进行分析和总结。企业的私有数据通常以文档形式存储,包括技术手册、政策文件、客户档案、研究报告等。

m0_59164304的博客 1100

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

从原理开始学大模型RAG,如何通过优化文档处理让RAG发挥最大潜力

如果你真的想学习大模型,请不要去网上找那些零零碎碎的教程,真的很难学懂!你可以根据我这个学习路线和系统资料,制定一套学习计划,只要你肯花时间沉下心去学习,它们一定能帮到你!点击领取:2025最新最全AI大模型资料包:学习路线+书籍+视频+实战+案例…

dmx123789的博客 1000

RAG 技术如何让大模型更好地处理私有文档?

而随着大模型在科研辅助、金融建模、内部知识库搭建等私有文档处理场景的需求激增,RAG(检索增强生成)技术作为解决大模型私有数据访问、降低幻觉风险的关键方案,其应用效果的优化成为行业关注焦点 —— 数据质量正是决定 RAG 系统能否适配新一代大模型能力、高效处理私有文档的核心前提。支持 PDF、Word、Excel、PPT、图片、手写笔记等十余种非结构化文件格式,同时适配带水印、弯曲图像、扫描件、截屏等特殊载体,覆盖企业科研文档、合同文件、生产标准、售后资料等各类私有文档类型。

TextIn智能文档云平台的官方博客 701

提升RAG系统的回答质量:高质量文档解析终极干货

t【最新】原始高精度模型,支持中英文、多语种文本检测c【最新】高精度模型,支持中英文、数字识别基于SLANet的中文表格识别模型CDLA数据集训练的中文版面分析模型,可以划分为表格、图片、图片标题、表格、表格标题、页眉、页脚、引用、公式10类区域。

xx_nm98的博客 2043

【LLM大模型】最优化大模型效果之 RAG(三):检索的优化策略

在最简单的 RAG 系统中,存在这样一个工作链条:当用户进行提问时,RAG 系统首先会根据问题从预先构建好的数据库检索相关的文档,并返回给大模型进行生成。在这个过程中,我们一共做了三件事儿,分别是索引、检索和生成。为了获得更好的效果,需要对这三个环节进行针对性的优化,从而提高 RAG 系统的性能。在上一篇文章中,我们已经针对索引环节的优化进行了讨论,接下来的内容中,我们将重点探讨 RAG 系统里检索的优化方法和策略。检索是 RAG 中的关键环节,目的在于从数据库中匹配与用户原始问题最相关的内容。

2401_82469710的博客 2314
上一篇: LLM大模型畅销的2本书!BERT基础教程+Transformer自然语言处理实战 附书籍PDF
下一篇: 大模型理论基础(so-large-lm)+《开源大模型食用指南》助你速通大模型!(文档分享)
Llama-Turbo
博客等级 码龄4年 9901粉丝 2022原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值