LLM学习(5)——系统评估与优化

【LangChain】Retrieval QA 您可以传入自定义prompt来进行问答。这些提示与您可以传递到基本问答链的提示相同。{context}Answer in Italian:""" PROMPT = PromptTemplate(template = prompt_template , input_variables = [ "context" , "question" ]) # 自定义 chain prompt chain_type_kwargs = { 阅读详情

5.1 如何评估 LLM 应用

5.1.1 验证评估的一般思路

通过不断寻找Bad Case并进行针对性优化,将这些案例逐步加入验证集,形成一个具有一定样本数量的验证集。针对这种验证集,逐个进行评估变得不切实际,需要一种自动评估方法来对整体性能进行评估。验证迭代是构建以LLM为核心的应用程序的重要步骤,通过不断寻找Bad Case、调整Prompt或优化检索性能,推动应用程序达到目标性能和准确性。接下来,将介绍大模型开发评估的几种方法,并简要介绍从少数Bad Case针对性优化到整体自动评估的一般思路。

5.1.2大模型评估方法

人工评估的一般思路

准则一 量化评估
为保证很好地比较不同版本的系统性能,量化评估指标是非常必要的。我们应该对每一个验证案例的回答都给出打分,最后计算所有验证案例的平均分得到本版本系统的得分。量化的量纲可以是05,也可以是0100,可以根据个人风格和业务实际情况而定。
量化后的评估指标应当有一定的评估规范,例如在满足条件 A 的情况下可以打分为 y 分,以保证不同评估员之间评估的相对一致。
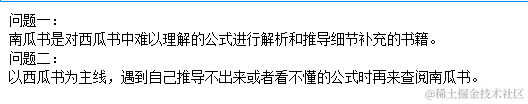
以下是对于问题

  1. 南瓜书和西瓜书有什么关系?
  2. 应该如何使用南瓜书?

两个模板的结果

以下是相应的代码[注:相对于前文这里我更改了嵌入的方式因为Gemini的嵌入实在太差了,还有pdf的导入方式,我用PyMuPDFLoader替代了PyPDFLoader因为PyPDFLoader输出会出现乱码]

Copy
from langchain.prompts import PromptTemplate
from langchain.chains import RetrievalQA


template_v1 = """使用以下上下文来回答最后的问题。如果你不知道答案,就说你不知道,不要试图编造答
案。最多使用三句话。尽量使答案简明扼要。总是在回答的最后说“谢谢你的提问!”。
{context}
问题: {question}
"""

QA_CHAIN_PROMPT = PromptTemplate(input_variables=["context","question"],
                                 template=template_v1)


qa_chain = RetrievalQA.from_chain_type(llm,
                                       retriever=vectordb.as_retriever(),
                                       return_source_documents=True,
                                       chain_type_kwargs={"prompt":QA_CHAIN_PROMPT})

print("问题一:")
question = "南瓜书和西瓜书有什么关系?"
result = qa_chain({"query": question})
print(result["result"])

print("问题二:")
question = "应该如何使用南瓜书?"
result = qa_chain({"query": question})
print(result["result"])
Copy
template_v2 = """使用以下上下文来回答最后的问题。如果你不知道答案,就说你不知道,不要试图编造答
案。你应该使答案尽可能详细具体,但不要偏题。如果答案比较长,请酌情进行分段,以提高答案的阅读体验。
{context}
问题: {question}
有用的回答:"""

QA_CHAIN_PROMPT = PromptTemplate(input_variables=["context","question"],
                                 template=template_v2)

qa_chain = RetrievalQA.from_chain_type(llm,
                                       retriever=vectordb.as_retriever(),
                                       return_source_documents=True,
                                       chain_type_kwargs={"prompt":QA_CHAIN_PROMPT})

print("问题一:")
question = "南瓜书和西瓜书有什么关系?"
result = qa_chain({"query": question})
print(result["result"])

print("问题二:")
question = "应该如何使用南瓜书?"
result = qa_chain({"query": question})
print(result["result"])

我们可以看出来,对于问题1模板A有稍微好一些的结果,对于问题二两者结果一致,所以这种评估方式其实并不推荐,首先难以确定哪个结果更好,其次需要两个问题的答案都更好非常困难。

多维评估#

对于大模型的评估,可以从多个维度出发,包括知识查找正确性、回答一致性、回答幻觉比例、回答正确性、逻辑性、通顺性和智能性等方面进行评估。每个维度都可以设计相应的评估指标,并在0~1之间进行打分,以综合评估系统的性能表现。同时,评估指标应当结合业务实际,量化评估和多维评估相结合,全面评估系统的性能表现。

Copy
print("问题:")
question = "应该如何使用南瓜书?"
print(question)
print("模型回答:")
result = qa_chain({"query": question})
print(result["result"])
print(result["source_documents"])


对答案进行多维打分

简单自动评估#

构造客观题
构造如下客观题

Copy
prompt_template = '''
请你做如下选择题:
题目:南瓜书的作者是谁?
选项:A 周志明 B 谢文睿 C 秦州 D 贾彬彬
你可以参考的知识片段:
~~
{}
~~
请仅返回选择的选项
如果你无法做出选择,请返回空
'''

我们规定如下打分策略:全选1分,漏选0.5分,错选不选不得分(错选也可以设为扣1分)这样我们就可以实现快速的评估

计算相似度#

构造标准答案并计算回答与标准答案相似度

使用大模型进行评估#

构造 Prompt Engineering 让大模型充当一个评估者的角色,从而替代人工评估的评估员;同时大模型可以给出类似于人工评估的结果,因此可以采取人工评估中的多维度量化评估的方式,实现快速全面的评估。

Copy
# 使用第二章讲过的 OpenAI 原生接口

from openai import OpenAI

client = OpenAI(
    # This is the default and can be omitted
    api_key=os.environ.get("OPENAI_API_KEY"),
)


def gen_gpt_messages(prompt):
    '''
    构造 GPT 模型请求参数 messages
    
    请求参数:
        prompt: 对应的用户提示词
    '''
    messages = [{"role": "user", "content": prompt}]
    return messages


def get_completion(prompt, model="gpt-3.5-turbo", temperature = 0):
    '''
    获取 GPT 模型调用结果

    请求参数:
        prompt: 对应的提示词
        model: 调用的模型,默认为 gpt-3.5-turbo,也可以按需选择 gpt-4 等其他模型
        temperature: 模型输出的温度系数,控制输出的随机程度,取值范围是 0~2。温度系数越低,输出内容越一致。
    '''
    response = client.chat.completions.create(
        model=model,
        messages=gen_gpt_messages(prompt),
        temperature=temperature,
    )
    if len(response.choices) > 0:
        return response.choices[0].message.content
    return "generate answer error"

question = "应该如何使用南瓜书?"
result = qa_chain({"query": question})
answer = result["result"]
knowledge = result["source_documents"]

response = get_completion(prompt.format(question, answer, knowledge))
response

BULE 打分#

n-gram:指一个语句里面连续的n个单词组成的片段
精确度:指Candidate(生成模型的预测文本)语句里面的n-gram在所有Reference(标准文本)语句里面出现的概率
modified n-gram recision:Modified n−gram precision=Numberoftotalgeneratedn−gramsNumberofmatchingn−grams

  • Number of matching n-grams表示生成文本中与参考文本匹配的n-gram序列数量;
  • Number of total generated n-grams表示生成文本中总的n-gram序列数量。

BP:
当待评价译文同任意一个参考译文长度相等或超过参考译文长度时,BP值为1,当待评价译文的长度较短时加一个权重
BP={1ifc>re1−r/cifc≤r
然后我们就可以计算分数
Bleu=BP⋅exp⁡(∑n=1Nwnlog⁡pn)

如何系统的去学习AI大模型LLM ?

作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。

但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的 AI大模型资料 包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

所有资料 ⚡️ ,朋友们如果有需要全套 《LLM大模型入门+进阶学习资源包》,扫码获取~

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

在这里插入图片描述

四、AI大模型商业化落地方案

img

阶段1:AI大模型时代的基础理解

  • 目标:了解AI大模型的基本概念、发展历程和核心原理。
  • 内容:
    • L1.1 人工智能简述与大模型起源
    • L1.2 大模型与通用人工智能
    • L1.3 GPT模型的发展历程
    • L1.4 模型工程
      - L1.4.1 知识大模型
      - L1.4.2 生产大模型
      - L1.4.3 模型工程方法论
      - L1.4.4 模型工程实践
    • L1.5 GPT应用案例

阶段2:AI大模型API应用开发工程

  • 目标:掌握AI大模型API的使用和开发,以及相关的编程技能。
  • 内容:
    • L2.1 API接口
      - L2.1.1 OpenAI API接口
      - L2.1.2 Python接口接入
      - L2.1.3 BOT工具类框架
      - L2.1.4 代码示例
    • L2.2 Prompt框架
      - L2.2.1 什么是Prompt
      - L2.2.2 Prompt框架应用现状
      - L2.2.3 基于GPTAS的Prompt框架
      - L2.2.4 Prompt框架与Thought
      - L2.2.5 Prompt框架与提示词
    • L2.3 流水线工程
      - L2.3.1 流水线工程的概念
      - L2.3.2 流水线工程的优点
      - L2.3.3 流水线工程的应用
    • L2.4 总结与展望

阶段3:AI大模型应用架构实践

  • 目标:深入理解AI大模型的应用架构,并能够进行私有化部署。
  • 内容:
    • L3.1 Agent模型框架
      - L3.1.1 Agent模型框架的设计理念
      - L3.1.2 Agent模型框架的核心组件
      - L3.1.3 Agent模型框架的实现细节
    • L3.2 MetaGPT
      - L3.2.1 MetaGPT的基本概念
      - L3.2.2 MetaGPT的工作原理
      - L3.2.3 MetaGPT的应用场景
    • L3.3 ChatGLM
      - L3.3.1 ChatGLM的特点
      - L3.3.2 ChatGLM的开发环境
      - L3.3.3 ChatGLM的使用示例
    • L3.4 LLAMA
      - L3.4.1 LLAMA的特点
      - L3.4.2 LLAMA的开发环境
      - L3.4.3 LLAMA的使用示例
    • L3.5 其他大模型介绍

阶段4:AI大模型私有化部署

  • 目标:掌握多种AI大模型的私有化部署,包括多模态和特定领域模型。
  • 内容:
    • L4.1 模型私有化部署概述
    • L4.2 模型私有化部署的关键技术
    • L4.3 模型私有化部署的实施步骤
    • L4.4 模型私有化部署的应用场景

学习计划:

  • 阶段1:1-2个月,建立AI大模型的基础知识体系。
  • 阶段2:2-3个月,专注于API应用开发能力的提升。
  • 阶段3:3-4个月,深入实践AI大模型的应用架构和私有化部署。
  • 阶段4:4-5个月,专注于高级模型的应用和部署。
这份完整版的所有 ⚡️ 大模型 LLM 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

全套 《LLM大模型入门+进阶学习资源包》↓↓↓ 获取~

👉优快云大礼包🎁:全网最全《LLM大模型入门+进阶学习资源包》免费分享(安全链接,放心点击)👈

​

基于FLANT5的LLM指令跟随能力评估 1.1 问题的提出 在人工智能领域,特别是自然语言处理(NLP)领域,LLM(大型语言模型)已经成为了一种强大且广泛使用的工具。这些模型,如GPT-3、BERT、T5等,通过学习海量文本数据,能够生成连贯且具有逻辑性的文本,为各种应用场景提供支持,如文本生成、问答系统、翻译等。 然而,随着LLM在更复杂任务中的使用,如指令跟随,其能 阅读详情

相关推荐

自我改进型AI Agent:LLM的自我评估与优化

第1章:自我改进型AI Agent概述 1.1 自我改进型AI Agent的定义与重要性 自我改进型AI Agent,简称Self-Improving AI Agent,是一种具有自我学习和优化能力的人工智能实体。与

AI天才研究院 1081

LLM:badcase分析

bad case分析是了解业务、了解场景的重要途径,知道当前研究、实践中容易出现的问题,往通俗的说,吸收经验的重要途径。分析badcase必须要先了解目前模型的效果,也就是baseline,知道该往哪个方向努力。

qq_43814415的博客 1998

LLM作为推荐系统的评估与局限性研究

引言 近年来,随着人工智能技术的快速发展,大规模语言模型(LLM,Large Language Model)逐渐成为研究与应用的热点。LLM作为一种具有强大生成和推理能力的模型,已经在自然语言处理、文本生成、问答系统等领域取得了显著的成果。与此同时,推荐系统作为信息过滤和个性化推荐的重要手段,也在电子商务、社交媒体、视频平台等领域发挥着重要作用。

AI天才研究院 1047

目前超火的LLM,也能在您的私有数据上部署问答系统

介绍本文将探讨如何利用语言模型和文本分块构建一个问答系统。我们将使用PyPDF2、langchain、Hugging Face和FAISS等工具从PDF中提取文本,将其处理成可管理的块,创建嵌入并利用这些嵌入进行高效的基于检索的问答。什么是LLM?LLM代表“语言模型”,它是一类用于自然语言处理(NLP)任务的人工智能模型。语言模型被设计用于理解和生成人类语言文本。它们具有预测句子中下一个词、完成...

Warmer_Sweeter 1715

【iceberg数据一致性】iceberg如何保证高并发数据一致性

那么在高并发的时候,同时操作某张表时是如何运作的呢?其实这里iceberg引用了乐观锁的方法。其实在写入数据的时候是有一个验证的操作的,即在准备写入时会检查原文件和带写入文件的差异,如果存在本次写入数据以外的数据,则代表有其他操作已经更新了原文件,那么本次写入会取消,并重试写入的步骤,知道验证完成,写入完成,如此就保证了数据的一致性,并且也解决了HMS锁的问题。在使用iceberg写数据时,一直弄不清楚为什么iceberg写入快,并且能够保证数据的一致性。今天决定搞清楚这个问题,经过查询和理解,写下来。

你的博客 1046

Open3D 曲率下采样

曲率下采样是一种基于几何特征的点云处理技术,通过计算每个点的曲率来判断其所在位置的局部表面特征,从而进行选择性保留。曲率的计算通常基于点的法向量和其邻域点的分布。

纵马踏花向自由 845

langchain pdf链检索,提问式表单(实体命名识别)

通过用户输入的内容,识别需要填写的字段,有点实体命名识别的感觉,当需要从程序中识别特定实体时可以参考。stuff 链,重排链,RetrievalQA 链。

木下瞳的博客 1042

大厂硬件笔试机试题ASIC设计方向-卷3

本文提供了30道硬件工程师机试题目,涵盖数字逻辑、模拟电路、CMOS和信号处理等核心领域。选择题和判断题均配有详细解析,重点考察Verilog编程、CMOS特性、触发器设计、采样定理等知识点。题目难度适中但覆盖面广,如Verilog中阻塞/非阻塞赋值的区别、CMOS静态功耗来源、Nyquist采样定理、通用逻辑门判断等。备考建议强调掌握逻辑门设计、Verilog时序电路编写和CMOS特性理解。这些题目反映了华为等大厂硬件机试的典型考查内容,通过系统复习可有效提升机试成绩,为后续面试奠定基础。

启芯硬件的博客 546

LLM 大模型企业应用实战(-“消灭”LLM幻觉的利器

大模型在一定程度上去改变了我们生活生工作的思考的方式,然后也越来越多的个人还有企业在思考如何将大模型去应用到更加实际的呃生产生活中去,希望大语言模型能够呃有一些更多企业级别生产落地的实践,然后去帮助我们解决一些业务上的问题。

2401_82469710的博客 942

YOLOv12环境配置,手把手教你使用YOLOv12训练自己的数据集和推理(附YOLOv12网络结构图),全文最详细教程

YOLO 系统尊嘟太卷了吧,YOLOv11 还没完明白,YOLOv12 就重磅来袭,YOLOv12 是由纽约州立大学联合中科院在 2025年2月19 日发布,从 YOLOv12 论文题目我们大概就知道做了那些更新 ,下图是YOLOv12 在 COCO 数据集上的性能表现引入区域注意力机制(area-attention):通过引入十字形窗口自我注意机制,沿水平和垂直条纹计算注意力机制,纵横交错的注意机制。如下图所示,区域注意力采用最多简单的等分方法,将特征地图垂直或水平划分为 L 个区域。

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 6万+

【WorkBuddy专栏27】WorkBuddy 和 CodeBuddy 到底什么关系——一篇文章终结所有混淆

WorkBuddy 和 CodeBuddy 到底什么关系——一篇文章终结所有混淆

AI人人懂 2811

llm-universe学习小记录5--系统评估与优化

介绍了如何评估LLM应用、评估并优化生成部分、评估并优化检索部分

Adela0546的博客 1403

【Unity3D框架】GameFramework框架完全教程《全网最全》-专栏文章目录

最近准备学习框架,了解到GameFramework框架是国产Unity3D框架,准备学习一下,但是奈何全网关于这个框架的教程实在太少。为了让自己学习方便一些,也为了让后来者乘凉。将框架以自己的理解整理目录,并且补全教程。觉得教程有帮助别忘了一键三连哦。

优快云博客专家,Unity3D高级软件工程师,《Unity 3D从入门到实战》作者。 2万+

别再找了,这个免费的LLM课程就是你的终极学习路线图

在GitHub上发现一个近乎完美的免费大语言模型课程,包含科学家和工程师双路径的详细学习路线,附带实战Notebook、论文资源和初学者所需的一切。

瓦罗兰特顶级C位的博客 430

Allegro174版本如何关闭模块复用后铜皮自动从动态变成静态操作指导

在用Allegro进行PCB设计的时候,模块复用是使用的十分频繁的操作,当Allegro升级到了174 S034版本的时候,当使用模块复用的功能的时候,模块内的铜皮会自动动静转换,大部分情况是不需要的。版本如何关闭模块复用后铜皮自动从动态变成静态操作指导。如何关闭这个功能,具体操作如下。

weixin_54787054的博客 1262

C# 接口和抽象类

文章目录1. 什么是接口和抽象类2. 接口与单元测试3. 依赖&耦合4. 依赖翻转5. 单元测试 1. 什么是接口和抽象类 接口和抽象类都是“软件工程产物” 具体类->抽象类->接口:越来越抽象,内部实现的东西越来越少 抽象类是未完全实现逻辑的类(可以有字段和非public成员,它们代表了“具体逻辑”) 抽象类为复用而生:专门作为基类来使用,也具有解耦功能 封装确定的,开放不确定的,推迟到合适的子类中去实现 接口是完全未实现逻辑的“类”(“纯虚类”;只有函数成员;成员全部publi

汽车电子软件领域知识分享 1016

LLM智能体长周期任务优化:Hindsight Credit Assignment原理与GRPO集成实践

在强化学习与大型语言模型智能体领域,信用分配是解决长周期、稀疏奖励任务的核心挑战。其核心原理在于将最终结果的责任精准回溯到序列决策中的具体步骤,从而提供细粒度的学习信号。这一技术价值在于显著提升智能体的学习效率与决策可解释性,尤其在需要多步工具调用与复杂规划的AI助理、自动化工作流等场景中至关重要。当前,通过将事后信用分配思想与GRPO等策略优化算法结合,已成为提升模型长期性能的主流方向。本文以Qwen2.5-7B-Instruct为基座模型,深入探讨了HCA的实现框架、与GRPO的集成方法,以及基于规则与

weixin_29061041的博客 350

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

AISMM评估体系深度拆解:5大维度、12项指标、37个自动化断点,你漏掉了哪一环?

深度拆解AISMM自动化程度评估:SITS 2026 AI流程自动化水平,覆盖金融、制造、政务等场景,依托5大维度、12项指标与37个自动化断点精准诊断AI落地瓶颈。方法论可量化、可对标、可优化,助力企业识别自动化盲区。值得收藏

AlgoInk的博客 145

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

数学建模模型总结

这是本人在两年内准备参加数学建模竞赛搜集到的模型资料,已经经过了本人的筛选和整理,希望能够对准备参加数学建模竞赛的学弟学妹们提供一些帮助!

【LLM】系统的评估与优化

本节学习了大模型的常见评估方法:人工评估、简单自动评估、大模型评估和混合评估,其中人工评估耗费人力成本高,且需要确定量化评估指标、从多个维度进行评估。简单自动评估通过构建客观题让LLM进行回答,并且用代码方式实现打分策略,因此实现完全自动化,从而实现了高效的验证。对于无法构建客观题的问题,可以通过计算答案相似度方法进行评分,具体实现原理:对生成问题采用人工构造标准答案并计算回答与标准答案相似度的方法来实现自动评估。

weixin_42914989的博客 1730

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

LLM应用系统评估与优化

现在,我们已经构建了一个简单的、一般化的大模型应用。回顾整个开发流程,我们可以发现,以调用、发挥大模型为核心的大模型开发相较传统的 AI 开发更注重验证迭代。由于你可以快速构建出基于 LLM 的应用程序,在几分钟内定义一个 Prompt,并在几小时内得到反馈结果,那么停下来收集一千个测试样本就会显得极为繁琐。因为现在,你可以在没有任何训练样本的情况下得到结果。因此,在使用LLM构建应用程序时,你可能会经历以下流程:首先,你会在一到三个样本的小样本中调整 Prompt ,尝试使其在这些样本上起效。

阿拉斯加大闸蟹的博客 4319

LLM评估在RAG系统中的局限与优化

基于LLM的评估方法在RAG系统的生产环境中存在显著局限性,主要体现在一致性、可重复性、细粒度分析和跨领域泛化等方面。LLM评估结果易受温度设置、提示词设计等因素影响,导致不可预测性,且难以深入分析系统组件的具体表现。此外,LLM评估在不同领域的泛化能力有限,资源消耗高,难以实现实时监控和大规模查询评估。符号化指标在一致性、可重复性和细粒度分析方面具有优势,能够提供对系统组件的详细洞察,弥补了LLM评估的不足。结合符号化指标和LLM评估的混合方法能够为RAG系统提供更全面、可靠的评估框架,帮助初创企业实现快

XianxinMao的博客 907

玩转 LangChain:深度评估问答系统的三种高效方法(示例生成、手动评估与LLM辅助评估)

在近年来,LangChain作为一款强大的开源框架,逐渐成为构建基于大型语言模型(LLM)应用的首选工具。它不仅提供了简洁且灵活的API来进行模型的交互,还包括了众多功能模块,支持高效构建多种应用,如智能问答系统、自动化工作流等。LangChain的模块化设计使得开发者能够根据自己的需求灵活组合不同的功能,从而快速实现复杂的业务场景。LangChain 的核心模块Model(模型)提供与大语言模型交互的接口,例如 OpenAI、阿里云等的 LLM。开发者可以轻松配置 API 调用和模型参数。

吴师兄大模型的博客 4574

LLM评估在RAG系统中的局限与优化_用llm评估rag

基于LLM的评估方法虽然在自然语言理解和主观质量评估方面具有优势,但其在一致性、可重复性、细粒度分析和跨领域泛化等方面的局限性使得它无法单独满足RAG系统在生产环境中的评估需求。特别是在性能跟踪、组件分析和资源优化方面,LLM评估方法的表现尤为不足。因此,结合符号化指标(symbolic metrics)和LLM评估方法的综合评估框架,可能是未来RAG系统评估的发展方向。这种综合方法能够弥补LLM评估方法的不足,提供更全面、可靠的系统评估和优化方案。

jennycisp的博客 661

FlowiseAI评估系统:LLM性能监控与优化

在现代AI应用开发中,如何科学评估和优化大型语言模型(LLM)的性能已成为开发者面临的核心挑战。FlowiseAI作为领先的拖放式LLM流程构建平台,提供了强大的评估系统,帮助开发者全面监控、分析和优化AI应用性能。 本文将深入解析FlowiseAI评估系统的核心架构、功能特性以及最佳实践,为您提供一套完整的LLM性能监控与优化解决方案。 ## 评估系统架构 FlowiseAI评估系统采用模...

gitblog_00406的博客 773

大语言模型LLM小白初学笔记Chapter4:部署知识库助手、Chapter5:系统评估与优化

官方文档一个用于快速创建数据应用程序的开源 Python 库。它的设计目标是让数据科学家能够轻松地将数据分析和机器学习模型转化为具有交互性的 Web 应用程序,而无需深入了解 Web 开发。和常规 Web 框架,如 Flask/Django 的不同之处在于,它不需要你去编写任何客户端代码(HTML/CSS/JS),只需要编写普通的 Python 模块,就可以在很短的时间内创建美观并具备高度交互性的界面,从而快速生成数据分析或者机器学习的结果;

weixin_55230265的博客 1792
上一篇: LLM学习(4)——构建 RAG 应用
下一篇: LLM学习(6)—— LLM 应用
Llama-Turbo
博客等级 码龄4年 9902粉丝 2026原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值