Python爬虫:抓取多级页面数据

『scrapy爬虫』03. 爬取多个页面(详细注释步骤) 阅读详情
AI摘要

本文介绍了一种针对多级页面的数据抓取方法,并通过电影天堂网站为例详细讲解了爬虫程序的设计与实现过程。

前面讲解的爬虫案例都是单级页面数据抓取,但有些时候,只抓取一个单级页面是无法完成数据提取的。本节讲解如何使用爬虫抓取多级页面的数据。

在爬虫的过程中,多级页面抓取是经常遇见的。下面以抓取二级页面为例,对每级页面的作用进行说明:

  • 一级页面提供了获取二级页面的访问链接。
  • 二级页面作为详情页用来提取所需数据。

一级页面以<a>标签的形式链接到二级页面,只有在二级页面才可以提取到所需数据。

多级页面分析

下面以电影天堂2020 新片精品为案例进行讲解,将每部影片的名称,以及下载链接抓取下来。首先点击“更多”进入一级页面,如下图所示:

图1:Python爬虫多级页面抓取

1) 寻找url规律

通过简单分析可以得知一级与二级页面均为静态页面,接下来分析 url 规律,通过点击第 1 页,第 2 页 …,其规律如下:

**

第1页 :https://www.dytt8.net/html/gndy/dyzz/list_23_1.html
第2页 :https://www.dytt8.net/html/gndy/dyzz/list_23_2.html
第n页 :https://www.dytt8.net/html/gndy/dyzz/list_23_n.html
2) 确定正则表达式

通过元素审查可知一级页面的元素结构如下:
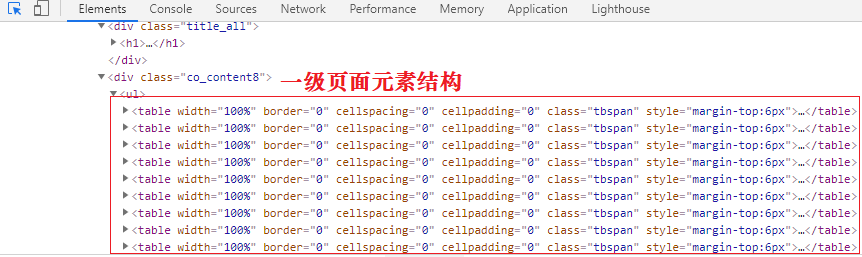

图2:页面元素分析

其正则表达式如下:

**

 <table width="100%".*?<td width="5%".*?<a href="(.*?)".*?ulink">.*?</table>

点击二级页面进入详情页,通过开发者工具分析想要数据的网页元素,即电影名称,和下载链接,其正则表达式如下:

**

<div class="title_all"><h1><font color=#07519a>(.*?)</font></h1></div>.*?<div><a href="(.*?)">.*?</a>

爬虫增量抓取

爬虫是一种效率很低的程序,非常消耗计算机资源。对于聚焦爬虫程序而言,需要每天对特定的网站进行数据抓取,如果每次都去抓取之前已经抓取过的数据,就会白白消耗了时间和资源。而增量爬虫是指通过监测网站更新的情况,只抓取最新数据的一种方式,这样就大大降低了资源的消耗。

对于本节案例来说,电影天堂网站每天都会更新内容,因此编写一个增量抓取的爬虫程序是非常合适的。

那么要如何判断爬虫程序是否已抓取过二级页面的 url 呢?其实,当您第一次运行爬虫程序时,爬虫会将所有的 url 抓取下来,然后将这些 url 放入数据库中。为了提高数据库的查询效率,您可以为每一个 url 生成专属的“指纹”。当网站更新后,第二次运行爬虫程序时,程序只会对数据库中不存在的指纹进行抓取。

程序代码实现

1) 建库建表

将抓取的数据的存放至 MySQL 数据库,需要先进行建库建表操作。注意,这里需要将 url 指纹单独存放在一张表中,如下所示:

  1. create database movieskydb charset utf8;
  2. use movieskydb;
  3. create table request_finger(
  4. finger char(60)
  5. )charset=utf8;
  6. create table movieinfo(
  7. moviename varchar(300),
  8. downloadaddr varchar(600)
  9. )charset=utf8;
2) url指纹生成

您可以使用 Python 内置模块 md5 来生成加密“指纹”,如下所示。

  1. #导入模块
  2. from hashlib import md5
  3. #待加密的url
  4. url=“https://www.dytt8.net/html/gndy/dyzz/20210226/61131.html”
  5. 生成MD5对象

  6. secret = md5()
  7. 加密url

  8. secret.update(url.encode())
  9. 提取十六进制的加密串

  10. finger = secret.hexdigest()
  11. print(finger)

输出结果:

**

2d5e46ee52756e8ae59c9ba42230b883
3) 程序完整代码
  1. -- coding: utf-8 --

  2. from urllib import request
  3. import re
  4. import time
  5. import random
  6. import pymysql
  7. from hashlib import md5
  8. from ua_info import ua_list
  9. import sys
  10. class MovieSkySpider(object):
  11. def init(self):
  12. self.url = ‘https://www.dytt8.net/html/gndy/dyzz/list_23_{}.html’
  13. self.db = pymysql.connect(
  14. ‘localhost’,‘root’,‘123456’,‘movieskydb’,
  15. charset=‘utf8’
  16. )
  17. self.cursor = self.db.cursor()
  18. 1.请求函数

  19. def get_html(self, url):
  20. headers = {‘User-Agent’: random.choice(ua_list)}
  21. req = request.Request(url=url, headers=headers)
  22. res = request.urlopen(req)
  23. 本网站使用gb2312的编码格式

  24. html = res.read().decode(‘gb2312’, ‘ignore’)
  25. return html
  26. 2.正则解析函数

  27. def re_func(self,re_bds,html):
  28. pattern = re.compile(re_bds,re.S)
  29. r_list = pattern.findall(html)
  30. return r_list
  31. 3.提取数据函数

  32. def parse_html(self,one_url):
  33. 调用请求函数,获取一级页面

  34. one_html = self.get_html(one_url)
  35. re_bds = ‘<table width=“100%”.?<td width=“5%”.?<a href=“(.?)".?ulink”>.*?’
  36. 获取二级页面链接

  37. link_list: [‘/html//html/gndy/dyzz/20210226/61131.html’,‘/html/xxx’,‘’,‘’]

  38. link_list = self.re_func(re_bds,one_html)
  39. for link in link_list:
  40. 判断是否需要爬取此链接

  41. 1.获取指纹

  42. 拼接二级页面url

  43. two_url = ‘https://www.dytt8.net’ + link
  44. s = md5()
  45. #加密url,需要是字节串
  46. s.update(two_url.encode())
  47. 生成指纹,获取十六进制加密字符串,

  48. finger = s.hexdigest()
  49. 2.通过函数判断指纹在数据库中是否存在

  50. if self.is_hold_on(finger):
  51. 抓取二级页面数据

  52. self.save_html(two_url)
  53. time.sleep(random.randint(1,2))
  54. 抓取后,把想用的url专属指纹存入数据库

  55. ins = ‘insert into request_finger values (%s)’
  56. self.cursor.execute(ins,[finger])
  57. self.db.commit()
  58. else:
  59. sys.exit(‘更新完成’)
  60. 4.判断链接是否已经抓取过

  61. def is_hold_on(self,finger):
  62. 查询数据库

  63. sql=‘select finger from request_finger where finger=%s’
  64. execute()函数返回值为受影响的行数(即0或者非0)

  65. r = self.cursor.execute(sql,[finger])
  66. 如果为0表示没有抓取过

  67. if not r:
  68. return True
  69. 5.解析二级页面,获取数据(名称与下载链接)

  70. def save_html(self,two_url):
  71. two_html = self.get_html(two_url)
  72. re_bds = '

    (.*?)

    \
  73. .*?

若要查询数据库存储数据,执行以下命令即可:

  1. mysql> select * from movieinfo\G

输出如下,如下图所示:
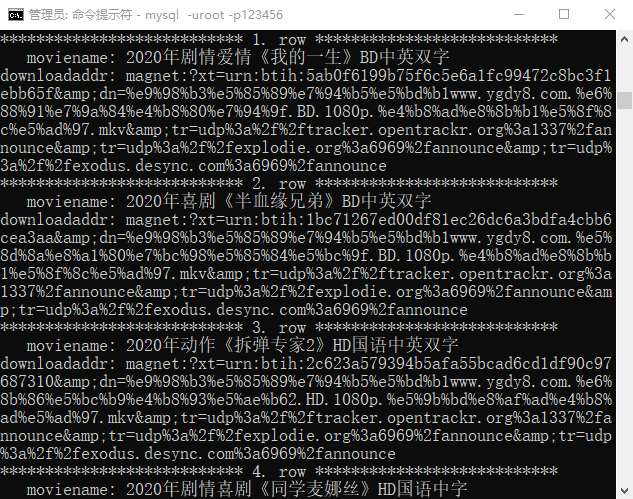

图3:MySQL数据库存储数据

在二级页面提取数据时要注意该页面的类型。该网站在二级页面使用了两种类型的网页结构,另外一种页面结构的正则表达式如下所示:

**

<div class="title_all"><h1><font color=#07519a>(.*?)</font></h1></div>.*?<td style="WORD-WRAP.*?>.*?>(.*?)</a> 

若要抓取此类页面的数据,需要更换二级页面正则表达式。

这里给大家分享一份Python全套学习资料,包括学习路线、软件、源码、视频、面试题等等,都是我自己学习时整理的,希望可以对正在学习或者想要学习Python的朋友有帮助!

优快云大礼包:全网最全《全套Python学习资料》免费分享🎁

😝有需要的小伙伴,可以点击下方链接免费领取或者V扫描下方二维码免费领取🆓

👉优快云大礼包🎁:全网最全《Python学习资料》免费分享(安全链接,放心点击)👈

​style=“margin: auto” />

1️⃣零基础入门

① 学习路线

对于从来没有接触过Python的同学,我们帮你准备了详细的学习成长路线图。可以说是最科学最系统的学习路线,你可以按照上面的知识点去找对应的学习资源,保证自己学得较为全面。
在这里插入图片描述

② 路线对应学习视频

还有很多适合0基础入门的学习视频,有了这些视频,轻轻松松上手Python~在这里插入图片描述

③练习题

每节视频课后,都有对应的练习题哦,可以检验学习成果哈哈!
在这里插入图片描述
因篇幅有限,仅展示部分资料

2️⃣国内外Python书籍、文档

① 文档和书籍资料

在这里插入图片描述

3️⃣Python工具包+项目源码合集

①Python工具包

学习Python常用的开发软件都在这里了!每个都有详细的安装教程,保证你可以安装成功哦!
在这里插入图片描述

②Python实战案例

光学理论是没用的,要学会跟着一起敲代码,动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。100+实战案例源码等你来拿!
在这里插入图片描述

③Python小游戏源码

如果觉得上面的实战案例有点枯燥,可以试试自己用Python编写小游戏,让你的学习过程中增添一点趣味!
在这里插入图片描述

4️⃣Python面试题

我们学会了Python之后,有了技能就可以出去找工作啦!下面这些面试题是都来自阿里、腾讯、字节等一线互联网大厂,并且有阿里大佬给出了权威的解答,刷完这一套面试资料相信大家都能找到满意的工作。
在这里插入图片描述
在这里插入图片描述

5️⃣Python兼职渠道

而且学会Python以后,还可以在各大兼职平台接单赚钱,各种兼职渠道+兼职注意事项+如何和客户沟通,我都整理成文档了。
在这里插入图片描述
在这里插入图片描述
上述所有资料 ⚡️ ,朋友们如果有需要 📦《全套Python学习资料》的,可以扫描下方二维码免费领取 🆓
😝有需要的小伙伴,可以点击下方链接免费领取或者V扫描下方二维码免费领取🆓

👉优快云大礼包🎁:全网最全《Python学习资料》免费分享(安全链接,放心点击)👈

​

2024年Python最全Python 爬虫爬取多页数据 模拟请求,获得数据分析数据,获得结果以下为实施步骤:1.获取请求信息,如下图所示,控制台选择Network->XHR,此时,点击页面跳转按钮,控制台会出现发出的请求,然后选择发出请求的文件(第三步),然后选择Headers,下方显示的就是请求头文件信息。2,使用Python 模拟请求,在Headers下找到 Request Headers 部分,这是请求的头数据。然后找到Form Data复制以上内容,形成如下代码。 阅读详情

相关推荐

爬虫获取多级页面数据丨Python基础实战系列(4)

有些时候,只抓取一个单级页面是无法完成数据提取的。本节讲解如何使用爬虫抓取多级页面的数据,涉及到正则表达式。【阿星建议】在学Python爬虫?建议你戳进来学习一下~

阿星的Python技术分享博客 3648

Python爬虫——爬取网站多页数据

1.利用“固定网址”+“下页”方法 同样使用豆瓣电影的网页来进行分析,https://movie.douban.com 豆瓣电影网站 #获取下一页地址 #获取下一页地址 try: next_url = list.xpath('//span[@class="next"]/a/@href')[0] #@href是获取href的地址 if next_u...

lucky_shi的博客 3万+

Python网络爬虫入门教程:从抓取数据到应用实现

本文将通过一个简单的例子,带你了解Python网络爬虫的基本原理与应用。不过,在使用爬虫时,务必注意遵守网站的法律法规,合理设置抓取频率,避免对网站造成负担。:网络爬虫通过模拟浏览器向网站发送请求,获取网页内容,然后提取其中需要的数据。Python网络爬虫是一项强大而灵活的技术,通过它可以帮助我们自动化地从互联网上提取有价值的数据。:网页内容通常是HTML格式,通过分析网页的HTML结构,可以定位到需要的数据。为了让你对爬虫的应用有更深入的理解,我们来做一个小项目——抓取小说网站中的章节标题和内容。

2403_90036899的博客 3151

Python爬虫实战:二级页面数据抓取与反爬策略详解

网络爬虫作为数据采集的核心技术,其核心原理是通过模拟浏览器行为向目标网站发送HTTP请求并解析返回的HTML文档。在工程实践中,面对包含大量二级页面的网站时,如何高效调度请求、稳定解析数据成为关键挑战。通过Requests库发送网络请求,结合BeautifulSoup进行HTML解析,可以构建结构化的数据提取流程。这种技术方案在电影信息聚合、电商商品详情抓取、新闻内容采集等场景中具有广泛应用价值。针对4567电影网这类资源站,本文重点探讨了二级页面抓取中遇到的典型问题,如URL规律分析、请求头伪装、频率控制

weixin_34268753的博客 326

什么是网络爬虫

又称为网页蜘蛛,网络机器人,在FOAF社区中间,更经常的称为网页追逐者,是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。网络爬虫可以根据指定的规则,从互联网上下载网页、图片、视频等内容,并抽取其中的有用信息进行处理。网络爬虫的工作流程包括获取网页源代码、解析网页内容、存储数据等步骤。根据其目的和工作方式的不同,网络爬虫可以分为多种类型。常见的网络爬虫包括通用爬虫、聚焦爬虫、增量式爬虫等。

2301_79903190的博客 2489

Python-网络爬虫

网络爬虫(Web Spider)又称网络蜘蛛或网络机器人,是一段用来实现自动采集网站数据的程序。网络爬虫不仅能够为搜索引擎采集网络信息,而且还可以作为定向信息采集器,定向采集某些网站中的特定信息。对于定向信息的爬取,网络爬虫主要采取数据抓取、数据解析、数据入库的操作流程。(1)数据抓取:发送构造的HTTP请求,获得包含所需数据的HTTP响应;(2)数据解析:对HTTP响应的原始数据进行分析、清洗,以提取出所需要的数据;(3)数据入库:将数据进一步保存到数据库(或文本文件)中,用于构建知识库。

qq_42759120的博客 1767

python爬虫获取网页数据,python爬取本地网页数据

这篇文章主要介绍了利用python爬取简单网页数据步骤,具有一定借鉴价值,需要的朋友可以参考下。希望大家阅读完这篇文章后大有收获,下面让小编带着大家一起了解一下。前面讲解的爬虫案例都是单级页面数据抓取,但有些时候,只抓取一个单级页面是无法完成数据提取的。本节讲解如何使用爬虫抓取多级页面的数据。在爬虫的过程中,多级页面抓取是经常遇见的。一级页面以标签的形式链接到二级页面,只有在二级页面才可以提取到所需数据。

2301_81837718的博客 494

五分钟学会Python网络爬虫

但不管怎样,爬虫技术是无罪的,还是值得我们开发人员去学习了解一下的。在学习之前,我们还是要先了解一下相关概念。 什么是爬虫 网络爬虫:又被称为网页蜘蛛,网络机器人,是一种按照一定的规则,自动的抓取万维网信息的程序或者脚本。 大数据时代,要进行数据分析,首先要有数据源,可数据源从哪里来,花钱买,没预算,只能从其它网站就行抓取。 细分下来,业内分为两类:爬虫和反爬虫。 反爬虫:顾名思义,就是防止你来我网站或APP上做爬虫的。 爬虫工程师和反爬虫工程师是一对相爱相杀的小伙伴,经常因为对方要加班写代码,

python588的博客 2366

【论文投稿】Python 网络爬虫:探秘网页数据抓取的奇妙世界

在当今数字化信息呈爆炸式增长的时代,网络爬虫宛如一把神奇的钥匙,开启了通往海量数据宝藏的大门。无论是商业领域的市场情报搜集、科研工作中的资料聚合,还是个人兴趣驱动下的信息整合,网络爬虫都展现出了无与伦比的价值。今天,就让我们一同走进 Python 网络爬虫的精彩世界,探索其中的奥秘。Python 网络爬虫为我们打开了一扇通往无限数据世界的大门,在商业、科研、生活等各个领域释放出巨大能量。通过掌握requestsScrapy等核心工具和框架,我们能够披荆斩棘,克服重重挑战,从网页的海洋中挖掘出珍贵的数据宝藏。

来自想要赚大钱的小周同学 9504

Python网络爬虫:歌曲数据抓取实践

项目完成后,应该进行总结,分析哪些地方做得好,哪些需要改进,为以后的项目提供经验教训。

weixin_42504649的博客 2228

接口操作MySQL跟MongoDB事务回滚问题

通常使用的事务注解:@Transactional 是不会对MongoDB生效的,但是在一些生产接口中无法避免同时使用MySQL跟MongoDB的操作。

weixin_45932023的博客 1579

Python 网络爬虫:高效数据抓取指南

随着互联网数据量的爆炸式增长,网络爬虫成为提取有价值信息的重要工具。Python 凭借其强大的库支持和简单的语法,被广泛应用于网络爬虫开发领域。本文将从网络爬虫的基础知识、关键技术、常用工具以及实战案例等方面,全面介绍如何利用 Python 构建高效的网络爬虫。然而,在使用网络爬虫时,我们需要始终关注法律与道德问题,避免过度爬取或抓取敏感数据。网络爬虫(Web Crawler)是一种自动化脚本程序,它模拟用户浏览器的行为,从网页中抓取所需数据。通过浏览器的开发者工具,确定商品名称和价格的 HTML 标签。

qq_20245171的博客 2258

Windows 11下manage-bde命令实战:BitLocker锁了别慌,手把手教你用命令行找回数据

本文详细介绍了在Windows 11系统下使用manage-bde命令解锁BitLocker加密驱动器的实战方法。通过命令行诊断、恢复密钥获取、解锁流程演示及高级故障排除,帮助用户在系统锁定后快速找回数据,特别适合IT技术人员和遇到紧急情况的用户。

weixin_30902251的博客 334

网络爬虫的基本原理及抓取静态网页详解

网络爬虫(又称为网页蜘蛛,网络机器人)是一种按照一定的规则,自动地抓取万维网信息的程序或者脚本。网络爬虫可以从一个或若干初始网页的URL开始,通过抓取网页上的链接地址,自动地访问网页、提取数据,实现对整个网站内容的爬取。网络爬虫主要用于搜索引擎、数据挖掘、信息提取、网页抓取等应用,是网络数据采集的重要工具。网络爬虫的技术实现涉及到多个领域的知识,包括计算机网络、数据挖掘、自然语言处理等。网络爬虫的分类有多种,根据其爬取范围可以分为通用爬虫和聚焦爬虫。

2303_76177437的博客 3383

XVF3800麦克风阵列实战:从选型到快速原型搭建

本文详细介绍了XVF3800麦克风阵列的选型与快速原型搭建实战经验。从开箱即用的特性到波束成形、回声消除等核心功能拆解,再到硬件设计避坑指南和固件开发技巧,帮助开发者高效实现智能语音设备的开发。特别适合智能音箱、会议终端等需要远场拾音和声源定位的应用场景。

weixin_29161719的博客 275

GEE:连续变化检测 CCDC 提取断点信息(干扰时间、干扰幅度、干扰次数)

本文将介绍在 Google Earth Engine (GEE) 平台上连续变化检测与分类(Continuous Change Detection and Classification, CCDC)提取扰动时间、干扰幅度、干扰次数信息,并下载到本地的代码。

养乐多的博客 1946

Python网络爬虫数据抓取思路,静态与动态页面爬取思路,爬虫框架等

目录 一、静态文件抓取(响应文件中存在的数据) 二、动态文件抓取(响应文件中不存在的数据) 三、多线程数据抓取 四、存文件:多线程争抢共同文件时的操作 五、Python爬虫解析模块思路 一、静态文件抓取(响应文件中存在的数据) 大部分的数据都是直接写在静态文件上的,静态文件这里通常指的一定时间内不会变化的,不需要与后台进行交互的网页。 1.首先确认抓取的数据是否存在于响应文件...

ck784101777的博客 4795

《PLECS仿真与实战:从建模到高端应用》-专栏文件目录

《PLECS仿真与实战:从建模到高端应用》是一本系统介绍PLECS电力电子仿真软件的实用指南。全书共10章,首先介绍软件安装与基础操作,包括RC电路仿真等入门内容;随后深入讲解各类电力电子电路的建模与仿真,涵盖整流、交交变换、直流变换、逆变等电路;最后探讨PWM控制建模和直流调速系统等高端应用。书中配有丰富的示例程序和波形分析方法,附录还包含电力电子器件、代码生成等实用资料。该书适合电力电子领域工程师和学生系统学习电路仿真技术。

547
上一篇: Python实战 爬虫抓取猫眼电影排行榜
下一篇: Requests库常用方法及参数介绍
Llama-Turbo
博客等级 码龄4年 9902粉丝 2026原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值