redis再战之布隆过滤器《五》

Redis-布隆过滤器(Bloom Filter)详解 什么是布隆过滤器 布隆过滤器(Bloom Filter)是 1970 年由布隆提出的,是一种非常节省空间的概率数据结构,运行速度快,占用内存小,但是有一定的误判率且无法删除元素。它实际上是一个很长的二进制向量和一系列随机映射函数组成,主要用于判断一个元素是否在一个集合中。 通常我们都会遇到判断一个元素是否在某个集合中的业务场景,这个时候我们可能都是采用 HashMap的Put方法或者其他集合将数据保存起来,然后进行比较确定,但是如果元素很多的情况下,采用这种方式就会非常浪费空间,最终达到瓶颈,检索速度也会越 阅读详情

布隆过滤器(bloom)

安装

首先需要redis安装布隆过滤器的扩展库:

  1. 进入布隆过滤器在github的仓库,下载zip包上传到linux或者点击鼠标右键获得下载地址,然后在linux上使用wget命令直接下载。
  2. 下载完之后获得一个zip的压缩包,需要下载解压工具 yum install unzip。
  3. 下载完unzip之后执行unzip RedisBloom-master.zip解压zip压缩包,得到RedisBloom-master目录。
  4. cd 到 RedisBloom-master目录,执行make执行(执行之前确认当前linux里有安装过gcc编译器)。
  5. make之后目录里会出现redisbloom.so文件,一般情况下我们会把这个文件cp到redis可执行文件的目录里面去。执行命令cp redisbloom.so /opt/zxj/redis5/。
  6. 查看当前启动的redis进程ps -fe | grep redis,关闭当前已经启动的redis进程service redis_6379 stop,如果没有此条可以忽略。
  7. 重新启动redis的时候从新挂载扩展库,可以通过修改配置文件启动挂载,也可以手工挂载扩展库启动redis进程redis-server /etc/redis/6379.conf --loadmodule /opt/~/redis5/redisbloom.so。
  8. 进入redis-cli客户端,输入bf.,按Tab键,能出现BF.ADD,BF.MEXISTS,BF.INSERT等命令就说明挂载成功。
    在这里插入图片描述

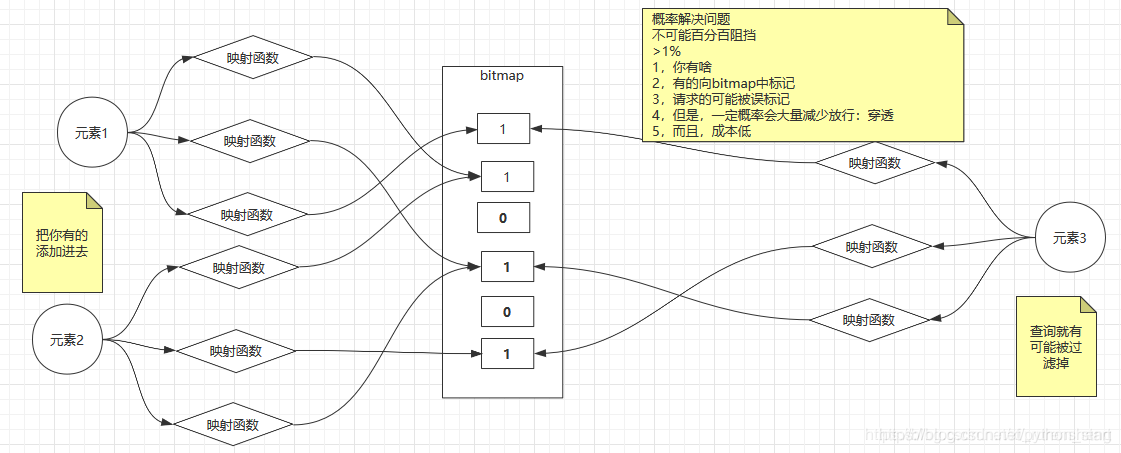
布隆过滤器如何用小的空间解决大量数据的匹配呢?
redis是二进制安全,因此string类型可以操作bitmap位图。
每个商品都代表一个元素,假设这个商品为元素1,元素1会经历N个不同的映射函数,每个映射函数把元素1转换成一个对应的数字,以数字为索引标记bitmap对应位为1。

redis穿透问题
在浏览器访问网站的时候,在请求一条数据的时候,往往会先访问redis中书否存在这个数据,如果存在就直接返回,如果不存在会从数据库查询这个数据是否存在,存在这个数据会返回给浏览器并且存入Redis。下次再有请求这个数据的时候,会直接从redis中查询快速返回,这样既能快速响应浏览器,又可以减轻数据库的压力。
但是如果有很多请求的数据redis中没有,数据库里也没有,甚至有人恶意 高并发请求不存在的数据,每次都使请求命中数据库,每次都和数据库建立socket,可能会造成网站的卡顿,严重的可能让数据库挂掉。

解决穿透
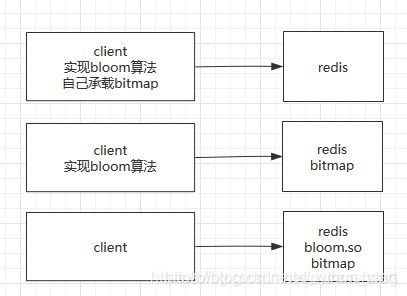
在这里插入图片描述

bf.add 添加元素
bf.exists 查询元素是否存在
bf.madd 一次添加多个元素
bf.mexists 一次查询多个元素是否存在

在 redis 中有两个值决定布隆过滤器的准确率:

  • error_rate:允许布隆过滤器的错误率,这个值越低过滤器的位数组的大小越大,占用空间也就越大。
  • initial_size:布隆过滤器可以储存的元素个数,当实际存储的元素个数超过这个值之后,过滤器的准确率会下降。

redis 中有一个命令可以来设置这两个值:
bf.reserve test 0.01 100
第一个值是过滤器的名字。
第二个值为 error_rate 的值。
第三个值为 initial_size 的值。

redis-server --loadmodule /opt/yupsoftware/redis-5.0.5/redisbloom.so
bf.add hololive minatoaqua
bf.exists hololive minatoaqua
bf.exists hololive kaguramea
bf.madd hololive shirakamifubuki kaguramea nakiriayame ozorasubaru
bf.mexists hololive shirakamifubuki kaguramea nakiriayame ozorasubaru cierrarunis
bf.reserve test 0.001 10000

注意:
必须在add之前使用bf.reserve指令显式创建,如果对应的 key 已经存在,bf.reserve会报错。同时设置的错误率越低,需要的空间越大。如果不使用 bf.reserve,默认的error_rate是 0.01,默认的initial_size是 100。

应用场景

主要是解决大规模数据下不需要精确过滤的场景,如检查垃圾邮件地址,爬虫URL地址去重,解决缓存穿透问题等。

布谷鸟过滤器

实现了布隆过滤器的删除功能

击穿

那么击穿是怎么回事呢?

就是在redis中某个数据刚刚过期淘汰的瞬间,用大量的用户一起访问这个数据,产生高并发。这个时候redis返回的是null,相当于在redis缓存上打了一个窟窿,这些请求就都会去访问数据库,这就是缓存击穿。

解决思路:

思考: 瞬间有大量的并发请求命中数据库,命中的原因是redis中没有key,那么怎么阻止请求并发到达数据库?

  • 首先redis是单进程单实例的,并发请求到达redis的时候会串行化,那么肯定会有第一个请求先到达redis而没有找到缓存数据。
  • 第一个请求没有拿到数据回到service后,调用redis的 setnx 命令在redis中创建key。setnx 命令只能创建key,如果key不存在,则能创建成功;如果key已经存在,则返回null(分布式锁)。
  • 获得锁的请求去访问mysql数据库返回从新把数据缓存进redis,没有获得锁的请求死循环尝试在redis中获取数据,中途可以sleep一定的时间(sleep不能太久,服务链会超时),sleep结束后重复在redis中获取缓存数据,尝试获得锁的过程,直到获得数据跳出循环。

有bug ?

  • 可能会产生死锁的问题! 如果去访问数据库的请求挂了,setnx得不到释放,后续请求也无法获取到锁,那些请求就会一直循环sleep。

怎么解决呢?

可以设置setnx的过期时间。

锁设置了过期时间,依然会有bug?

  • 第一个去请求数据库的请求可能没有挂,只是因为在mysql这里出现了拥塞,导致锁过期超时。
  • 这样就会引起连锁反应,第二个请求拿到了锁,同样到达mysql发生拥塞,就会可能导致访问数据库的请求越堆越多。甚至第一个请求从mysql拿到数据后返回给redis,后续请求从redis拿到数据返回,但是之前拿到锁的请求可能还在mysql排队,或者引起一些用户访问丢失。

解决:
可以利用多线程,一个线程去mysql取数据,另外一个线程监控数据是否取回来,并且及时更新锁的过期时间。

缓存雪崩

  • 击穿是某个缓存数据 过期淘汰,并且非常巧的对这个数据有高并发访问,
  • 而雪崩是大量的缓存数据 同时 过期淘汰,比如:某些业务要求缓存数据 凌晨0点数据过期,需要从新加载新的数据到缓存,间接造成大量的访问命中数据库

如何解决?

  • 普通场合:普通场合:普通场合:
    随机过期时间。但是随机过期时间不适合要求凌晨0数据过期的场合。
  • 缓存12点必须过期:
  1. 强依赖缓存击穿方案。并发时,第一个请求获得锁请求数据库,后续数据获得锁失败 -> 休眠 -> 再次尝试获得数据 -> 获取失败循环 -> 获取成功跳出循环。
  2. 使用0点延迟方案。就是在0点的时候,前置服务里面加一个随机sleep(几十毫秒),保证了请求到达redis时间的差异。
  3. 强依赖缓存击穿方案 和 0点延迟方案一起使用)

redis分布式锁

实现: setnx
弊端:过期时间。

缺点

  • 时间到了,活还没做完,别人又去干了。
  • 过期时间没到, 自己挂了。

解决弊端: 多线程,延长过期。

Redis系列--布隆过滤器(Bloom Filter) 无论使用谷歌版本的布隆过滤器还是自己编写的,都会存在两个问题,1、因为不同元素经过hash函数计算后可能会出现相同的hash值(hash碰撞),就会出现一个误判率的问题2、因为有hash碰撞,导致同一个位置可能存放不同的数据,这对于删除操作是很不友好的。对于这些情况可查看另一种布隆过滤器,布谷鸟过滤器。 阅读详情

相关推荐

基于Redis的分布式布隆过滤器

布隆算法是一个以牺牲一定的准确率来换取低内存消耗的过滤算法,可以实现大量数据的过滤、去重等操作。 本博客不讨论布隆算法的具体原理,如果想了解的可以查看这篇博客:布隆过滤器(Bloom Filter)详解 为了实现分布式过滤器,在这里使用了Redis,利用Redis的BitMap实现布隆过滤器的底层映射。 布隆过滤器的一个关键点就是如何根据预计插入量和可接受的错误率推导出合适的BIt数组长度和...

buren的博客 1万+

布隆过滤器和布谷鸟过滤器

布隆过滤器、布谷鸟过滤器

老师好我叫付十一的博客 2838

基于Redis的布隆过滤器的实现

项目简介包含一个基于Redis的布隆过滤器的实现,以及应用到Scrapy中的Demo。地址:BloomFilterRedis布隆过滤器网上有很多介绍,推荐《数学之美》,介绍的很详尽,此处不再赘述。哈希函数布隆过滤器中需要n个哈希函数,我使用的是Arash Partow提供的常见哈希函数。建立在Redis上的布隆过滤器Redis中有一个数据结构叫做Bitmap(下方有官网详解),它提供一个最大长度为5

孔天逸'Blog 3万+

python-布隆过滤器

在学习redis过程中提到一个缓存穿透的问题, 书中参考的解决方案之一是使用布隆过滤器, 那么就有必要来了解一下什么是布隆过滤器。在参考了许多博客之后, 写个总结记录一下。

m0_59485658的博客 1534

redis 布隆过滤器 BloomFilter

文章目录1、什么是布隆过滤器?1.1工作原理1.2布隆过滤器的优点1.3缺点2、布隆过滤器的使用场景3、布隆过滤器的原理3.1布隆过滤器的数据结构3.2初始化阶3.3插入元素过程3.4查询元素是否存在3.5元素删除3.6扩容4、SpringBoot整合布隆过滤器4.1技术选型4.2依赖4.3配置布隆过滤器相关参数4.4布隆过滤器工具类4.5业务操作。

m0_37843156的博客 2545

布谷鸟搜索(Cuckoo Search)优化算法(XinShe Yang)

XinShe Yang教授提出的Cuckoo Search优化算法Matlab原代码,可用于全局优化,并附有算法原理的文章及测试函数,供大家参考学习。

高级数据结构与算法 | 布谷鸟过滤器(Cuckoo Filter):原理、实现、LSM Tree 优化

布谷鸟过滤器(Cuckoo Filter)是一种节省内存空间的概率数据结构,基于布谷鸟哈希算法实现的过滤器,和布隆过滤器一样,用于检测指定元素是否存在于某个集合中

凌桓丶的博客 7109

布谷鸟算法

布谷鸟算法python代码,基于xinshe Yang的matlab m文件改编

【从零开始学习Redis | 第五篇】基于布隆过滤器解决Redis的穿透问题

在如今的开发中,使用缓存中间件Redis已经成为一项很广泛的技术,Redis的高性能大大优化了我们的服务器性能,缓解了在高并发的情况下服务器的压力。它基于缓存的形式,在内存中保存数据,减少对磁盘的IO操作。而我们今天就把焦点聚焦于Redis的击穿问题。

fckbb的博客 4248

Python+Redis实现布隆过滤器

布隆过滤器(Bloom Filter)是1970年由布隆提出的。它实际上是一个很长的二进制向量和一系列随机映射函数。这篇文章主要介绍了Python+Redis实现布隆过滤器,需要的朋友可以参考下

动态布谷鸟过滤器

动态布谷鸟过滤器

重学SpringBoot3-集成Redis(五)之布隆过滤器

布隆过滤器是一种空间效率高的概率性数据结构,用于快速判断某个元素是否在集合中。内存占用小:相比传统的集合结构,布隆过滤器的内存使用更少。可能存在误判:布隆过滤器只能确定某个元素“可能存在”或“绝对不存在”。但存在误判的概率可以通过调整参数降低。不支持删除:布隆过滤器不支持删除已添加的元素,删除某个元素会导致误判率增加。通过结合Redis和Redisson,我们可以非常方便地实现布隆过滤器,来防止缓存穿透问题。在高并发场景下,布隆过滤器是一种有效的工具,可以降低数据库的压力,提升系统性能。

CoderJia的学习之路 2481

2025最新OSM中国矢量数据保姆级下载指南(附百度网盘链接)

本文提供2025年OSM中国矢量数据的保姆级下载与使用指南。详细介绍了通过Geofabrik镜像站、QGIS插件及第三方平台获取数据的多种途径,重点解析了Shapefile格式数据的结构、WGS84坐标系特性,并指导进行格式转换与基础GIS应用,帮助用户高效合规地获取并利用这份开放地理数据资源。

weixin_29228781的博客 873

玩转Redis-Redis中布隆过滤器的使用及原理

《玩转Redis》系列文章主要讲述Redis的基础及中高级应用。本文是《玩转Redis》系列第【11】篇,本文关键字:玩转Redis、Bloom filter、布隆过滤器、无偏hash函数; - 布隆过滤器的底层原理 - 布隆过滤器的底层结构 - 最佳hash函数数量与错误率的关系 - 所需存储空间与错误率及容量关系 - 布隆过滤器如何扩容 - 布隆过滤器有哪些应用场景 - 布隆过滤器的优缺点 - 延伸拓展

zxiaofan.com 9238

【HCIP-AI 进阶之路(一)】零成本白嫖算力,7天速通华为人工智能资深开发者认证

《HCIP-AIEIDeveloper认证备考指南》摘要:本文深度解析华为HCIP-AI(H13-331)认证考试要点,涵盖考试大纲、评分标准及备考策略。重点剖析昇腾AI全栈架构,包括达芬奇架构核心计算单元(Cube/Vector/Scalar Unit)和四大层级关系(芯片-CANN-框架-应用)。针对无硬件资源的开发者,提供MindSpore CPU版、ModelArts免费算力和沙箱实验室三种零成本实践方案。文章强调该认证对国企/华为生态企业求职者的价值,并指出多选题是主要失分点。下篇将聚焦计算机视觉

2301_82049134的博客 1181

Silvaco TCAD仿真例库——肖特基二极管反向击穿特性(案例)

本文详细解析了使用Silvaco TCAD仿真例库进行肖特基二极管反向击穿特性分析的完整案例。通过构建包含浮空P型保护环的平面结构,重点阐述了针对雪崩击穿仿真的关键步骤,包括高精度网格划分、碰撞电离模型(impact selb)的启用以及反向电压的精细扫描策略。文章深入探讨了漂移区掺杂浓度、保护环设计等参数对击穿电压的影响,并提供了实用的调试心得,旨在帮助工程师精准预测和优化功率肖特基二极管的反向耐压能力。

fire9的博客 724

【Redis】布隆过滤器

布隆过滤器的简介、Redis的布隆过滤器的实现

人类所有真实的快乐,一定是恒久的努力 4286

LabVIEW调用.so文件的方法

LabVIEW调用.so文件的方法

m0_37878912的博客 3022

Redis 之布隆过滤器

1、布隆过滤器使用场景   比如有如下几个需求:   ①、原本有10亿个号码,现在又来了10万个号码,要快速准确判断这10万个号码是否在10亿个号码库中?   解决办法一:将10亿个号码存入数据库中,进行数据库查询,准确性有了,但是速度会比较慢。   解决办法二:将10亿号码放入内存中,比如Redis缓存中,这里我们算一下占用内存大小:10亿*8字节=8GB,通过内存查询,准确性和速度都有了,但是大约8gb的内存空间,挺浪费内存空间的。   ②、接触过爬虫的,应该有这么一个需求,需要爬虫的网站千千

伟大是熬出来的 1万+

基于 ESP32 的智能环境监测与远程报警系统

本系统基于 ESP32 实现了环境数据的采集、远程传输、报警通知功能,硬件成本低、接线简单、代码可直接运行。用户可根据实际需求调整传感器类型(如替换为 PM2.5 传感器、土壤湿度传感器)和功能扩展,适合嵌入式 IoT 入门学习和实际场景应用。通过多轮迭代(如优化低功耗、增加 APP 控制),可进一步提升系统的实用性和稳定性。

weixin_42300449的博客 1023

Serial RapidIO Gen2 IP 说明(一)

概述 高速IO(RapidIO)互联架构,用来兼容当前最流行的集成通信处理器、主处理器、联网的数字信号处理器,是一种高性能、分组交换(报文交换)的互联技术。它解决了高性能嵌入式产业稳定性、高带宽以及系统内部更快的总线速率的需求。 高速IO(RapidIO)标准由三层定义:逻辑层、传输层、物理层。逻辑层定义了所有的协议内容和报文格式。这些是终端发起和完成一次传输所必需的信息。传输层提供了报文从一个端点传输到另外一个端点必要的路线信息。物理层则描述了设备级的端口声明,如报...

记录所学,分享知识,结识挚友 1497

Redis布隆过滤器详解

布隆过滤器(Bloom Filter)是 Redis 4.0 版本提供的新功能,它被作为插件加载到 Redis 服务器中,给 Redis 提供强大的去重功能。相比于 Set 集合的去重功能而言,布隆过滤器在空间上能节省 90% 以上,但是它的不足之处是去重率大约在 99% 左右,也就是说有 1% 左右的误判率,这种误差是由布隆过滤器的自身结构决定的。俗话说“鱼与熊掌不可兼得”,如果想要节省空间,就需要牺牲 1% 的误判率,而且这种误判率,在处理海量数据时,几乎可以忽略。

怪咖@的博客 8776

GB28181 —— 3、C++编写GB28181设备端,完成注册、注销、保活心跳、响应查询目录等功能(附源码)

GB28181 —— Win10下编写GB28181设备端,完成注册、注销、保活心跳、响应查询目录等功能(附源码)

1307

Redis——布隆过滤器

第一次听到布隆是从英雄联盟中,本篇讲的是布隆过滤器,是Redis避免缓存穿透的防御利器; 简单来说就是:当我们通过布隆过滤器判断一个元素在不在集合中时;如果布隆过滤器返回的是在集合中,那么集合中可能没有这个元素;如果布隆过滤器返回的不存在于集合中,那么集合中是一定不存在这个元素的;常见的使用场景就是作为避免缓存穿透的利器;

娜娜米的博客 2580

【LOGO动态替换】记录一次关于LOGO动态替换引发的uboot代码分析及其实现

文章目录1.前言2.实现2.1 新增logo分区2.2 制作logo分区镜像2.2.1 查看logo.bmp和logo_kernel.bmp的文件大小。2.2.2 按规则将bmp写入logo.img3.分析3.1 uboot的启动分析3.2 uboot bmp load 显示部分3.2.1 rockchip_show_logo3.2.2 load_bmp_logo3.2.3 load_bmp_logo3.3 uboot bmp read部分3.3.1 read_logo_bmps3.3.1 read_bmp

wang 恒 的博客 1211

WINCC7.3破解文件

WINCC7.3硬件够破解文件,有需要的下载!WINCC7.3硬件够破解文件,有需要的下载!

redis布隆过滤器的使用

1.使用场景:推荐系统给用户推荐新闻,避免重复推送。 需要考虑问题:从用户观看历史中筛选出没有看过的新闻进行推送,就需要数据库中频繁的使用exists进行查询,但是当用户量很大时,数据库很难顶住压力。 解决方法: 1.1.使用缓存?但是日子长了,会浪费很大空间,不是长久之计,不是很好的解决办法。 1.2.这时布隆过滤器就可以很好的解决这个需求了,可以节约90%以上的空间,缺点就是稍微有那么...

杨文炯的博客 2万+

复分析 阿尔福斯(Ahlfors) 第三版答案 英文

答案分为十章,有部分习题没有答案,全英文复分析阿尔福斯(Ahlfors) 第三版答案

上一篇: redis再战之进阶消息订阅,事务,缓存《四》
下一篇: Redis再战之持久化 rdb 和 aof《六》
漂吧
博客等级 码龄8年 15粉丝 38原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值

