11-2027毕设-基于yolov8的果蔬检测识别系统(含UI界面、训练好的模型、Python代码、数据集)

C#创建COM组件,QT调用COM组件简单测试(VS2008+QT4.6.4) 一. C#创建组件: 1. VS2008新建一个项目,选择Visual C#, Class library 修改Properties下面的AssemblyInfo.cs文件,ComVisible属性设置为True,即:[assembly: ComVisible(true)] 2. 右击项目,选择“属性”, 选择“生成”选项卡,把“为COM互操作注册”勾选上 选择“签名”选项卡,把“ 阅读详情

11-基于深度学习的果蔬检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)

在这里插入图片描述

摘要:果蔬检测识别系统在相关领域中起着至关重要的作用,不仅能有效提升检测效率,还为自动化识别提供了可靠的数据支撑。本文介绍了一款基于YOLOv8、YOLOv5等深度学习框架的目标检测模型,该模型使用了大量图片进行训练,能够准确识别多种目标。系统可在不同场景下进行检测,包括多目标场景、复杂背景、光线变化等。
    此外,我们开发了一款带有UI界面的检测系统,支持实时检测不同种类的目标,并通过图形界面直观展示检测结果。系统基于Python与PyQt5开发,能够处理图片、视频及摄像头输入,检测结果可以保存以供后续分析。本文还提供了完整的Python代码及详细的使用指南,供有兴趣的读者参考,完整代码资源请见文章末尾。

项目介绍

项目中所用到的算法模型和数据集等信息如下:

算法模型:

  • yolo26、yolo26 + SE注意力机制
  • yolo11、yolo11 + SE注意力机制
  • yolo12、yolo12 + SE注意力机制
  • yolov8、yolov8 + SE注意力机制
  • yolov5、yolov5 + SE注意力机制
  • 算法还在持续更新中。。。。不同算法的界面是不一样的,不用担心重复问题。

    目前有上面这些不同的算法模型、每个算法有两个训练好的模型。模型十分重要,因为有些同学的电脑没有 GPU,无法自行训练。

数据集:
    网上下载的数据集,格式都已转好,可直接使用。

界面:
    PyQt5

以上是本篇博客的简单说明,添加注意力机制可作为模型的创新点 。

在这里插入图片描述


前言

    果蔬检测识别系统在相关领域中发挥着至关重要的作用。在实际应用中,快速且精准地识别不同种类的目标,能够有效提高工作效率,减少人力成本,尤其是在自动化监测系统中,准确识别目标是各项应用的基础。同时,检测系统还为相关人员提供了重要的实时数据反馈,帮助他们及时掌握运行状态的变化情况,推动相关工作的科学化和高效化。

    目标检测技术已在多个领域得到了广泛应用,如工业检测、智能监控、科学研究、自动识别等场景中,都依赖于高效准确的检测技术。通过自动化的识别系统,相关机构可以在实际应用过程中实时识别目标的种类和数量,并根据识别到的数据做出相应的决策,从而提高工作效率。

    在现代管理环境中,检测系统还可以与其他智能化管理系统结合使用,如环境监测、智能调度和预警系统,形成一个完整的智能管理体系,帮助相关人员更高效地掌握动态。在特殊环境或复杂的场景中,系统能够快速识别不同类型的目标,为相关人员提供更为精准的数据。

    本文通过收集与检测相关的数据和图像,利用YOLOv8、YOLOv5等目标检测技术,结合Python与PyQt5,开发出了一款界面简洁的检测系统。该系统支持图片、视频及摄像头检测,并能够保存识别结果,为用户提供直观便捷的检测体验。

功能展示:

部分核心功能如下:

  • 功能1: 支持单张图片识别
  • 功能2: 支持遍历文件夹识别
  • 功能3: 支持识别视频文件
  • 功能4: 支持摄像头识别
  • 功能5: 支持结果文件导出(xls格式)
  • 功能6: 支持切换检测到的目标查看

更多的其他功能可以通过下方视频演示查看。视频中详细讲解了环境安装、模型训练、模型评估、项目结构说明以及常见问题答疑,跟着视频操作即可顺利完成部署。

11-基于YOLO12的果蔬检测识别系统项目实战!-全网最全资料(附赠任务书、开题报告模板课程)人工智能/深度学习/计算机视觉/神经网络

11-基于深度学习的果蔬检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)

11-基于深度学习的果蔬检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)

11-基于深度学习的果蔬识别系统(yolov5)


🌟 一、数据集介绍

本项目使用的数据集已按照 YOLO 标准格式整理完毕,包含 train、val、test 三个子目录,标注文件为 YOLO 标准的 .txt 格式,每行包含 class x_center y_center width height,可以直接用于训练和评估,无需额外转换步骤。数据集的类别信息在 traindata.yaml 中定义。
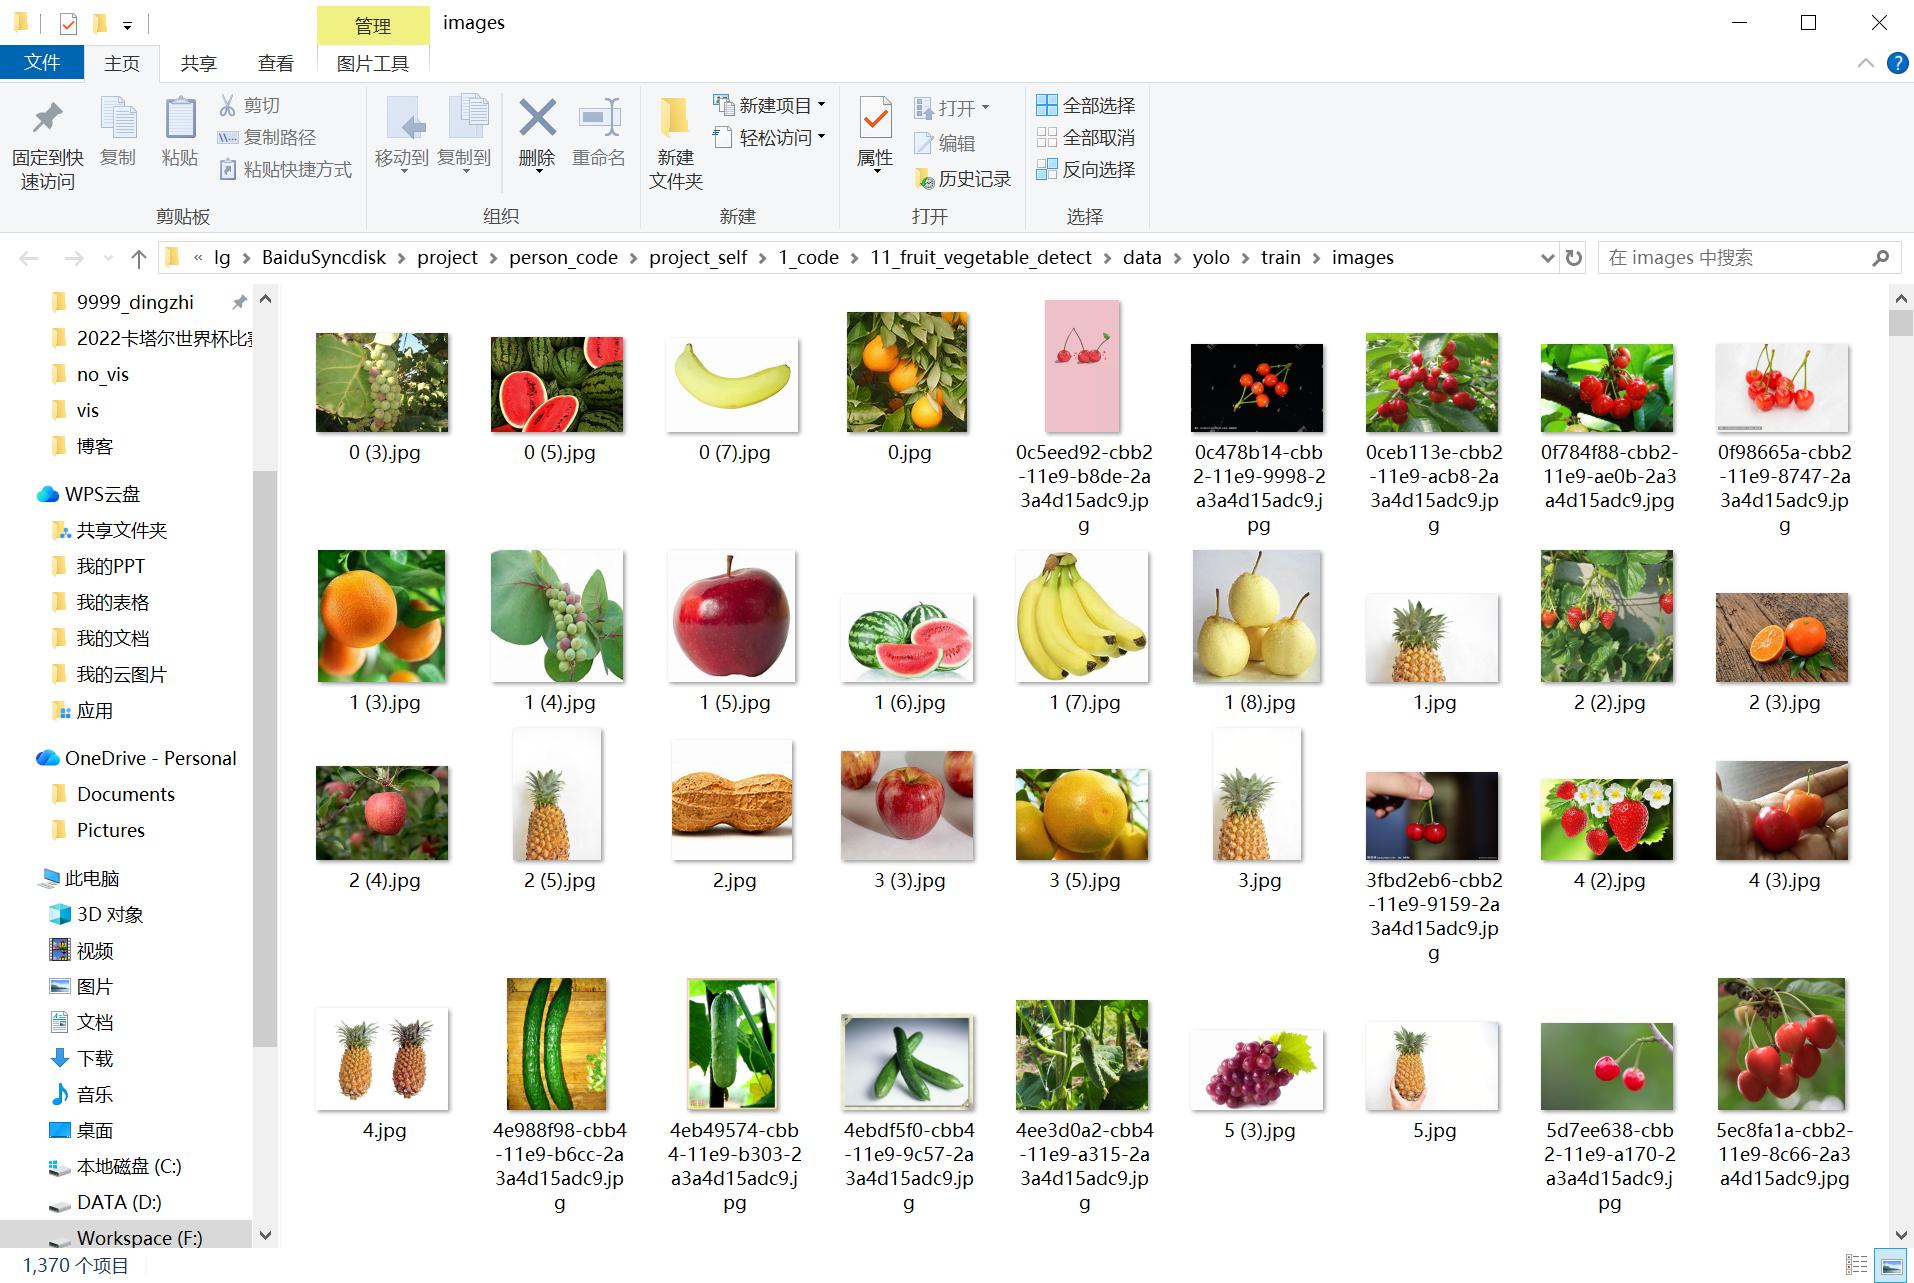
数据集展示截图.jpg


🌟 二、深度学习算法介绍

  本系统集成了多个不同的算法版本和界面版本,以下是对这些版本的概述:

  算法版本方面,系统提供了多种深度学习算法和传统图像处理技术,用户可以选择最合适的算法进行任务处理。此外,各算法版本经过严格的测试和优化,以提供更高的准确率和效率。

  在界面版本方面,系统设计了多种用户界面风格,可以选择简约、直观的界面,快速上手进行操作;也可以选择功能丰富的专业界面,满足复杂任务的需求。界面设计注重用户体验,确保用户在操作过程中能够方便地访问各种功能。

  此外,系统还支持实时更新和扩展,可以根随时添加新的算法模块或界面选项。这种灵活性不仅提高了系统的适用性,也为未来的技术发展预留了空间。

  总之,本系统通过多个算法和界面版本的组合,提供了丰富的选择和强大的功能。

下面是对包含到的算法的大概介绍:

1. yolov8相关介绍

  YOLOv8 是当前深度学习领域内的一个SOTA(State-Of-The-Art)模型,凭借其前代版本的技术积累,再次引领了目标检测算法的发展方向。与其前辈不同,YOLOv8在模型结构和计算方式上都做了创新性调整,旨在实现更高效的计算和更灵活的应用场景适应能力。全新的骨干网络设计,结合Anchor-Free 检测头,让模型在面对不同输入尺寸、不同目标尺度时的表现更加出色,极大提升了性能和准确性。

  此外,YOLOv8 的另一个重要进步在于它采用了全新的损失函数,使得训练过程更加稳定和高效。无论是在传统的CPU平台上运行,还是在更强大的GPU平台上进行加速,YOLOv8 都能够适应不同硬件资源的场景,确保在各种场合下保持高效的推理速度和精确的检测能力。

  不过,值得注意的是,ultralytics 这一开发团队并没有直接将其开源库命名为 YOLOv8,而是采用了ultralytics的品牌名来命名整个项目。这并非单纯的命名策略,而是反映了其定位的重大变化。ultralytics 将这个库不仅视为一个算法框架,而非仅仅一个 YOLO 版本的延续。其设计目标之一是打造一个能够适应不同任务的算法平台,无论是目标检测、分类、分割,还是姿态估计,都能够在这个框架中被高效地支持。

  这也意味着,未来的ultralytics 开源库将不仅限于 YOLO 系列,它的可扩展性为用户提供了更大的可能性。无论是使用非 YOLO 系列模型,还是面对不同应用领域的特定需求,ultralytics都提供了灵活且高效的解决方案。

总的来说,ultralytics 开源库 的优势可以归纳为以下几个要点:

  • 融合当前最前沿的深度学习技术,让用户可以轻松实现复杂的计算任务。

  • 具有极高的扩展性,未来将不仅支持 YOLO 系列,还会支持更多非 YOLO 的算法,适用于广泛的任务场景。

如此一来,ultralytics 不仅能够帮助开发者在算法研究和工程应用上取得突破,更能推动未来智能视觉领域的进一步发展。

在这里插入图片描述

网络结构如下:
在这里插入图片描述

2. yolov5相关介绍

  YOLOV5有YOLOv5n,YOLOv5s,YOLOv5m,YOLOV5l、YOLO5x五个版本。这个模型的结构基本一样,不同的是deth_multiole模型深度和width_multiole模型宽度这两个参数。就和我们买衣服的尺码大小排序一样,YOLOV5n网络是YOLOV5系列中深度最小,特征图的宽度最小的网络。其他的三种都是在此基础上不断加深,不断加宽。不过最常用的一般都是yolov5s模型。
在这里插入图片描述

  本系统采用了基于深度学习的目标检测算法YOLOv5,该算法是YOLO系列算法的较新版本,相比于YOLOv3和YOLOv4,YOLOv5在检测精度和速度上都有很大的提升。YOLOv5算法的核心思想是将目标检测问题转化为一个回归问题。此外,YOLOv5还引入了一种称为SPP(Spatial Pyramid Pooling)的特征提取方法,这种方法可以在不增加计算量的情况下,有效地提取多尺度特征,提高检测性能。

  在YOLOv5中,首先将输入图像通过骨干网络进行特征提取,得到一系列特征图。然后,通过对这些特征图进行处理,将其转化为一组检测框和相应的类别概率分数,即每个检测框所属的物体类别以及该物体的置信度。YOLOv5中的特征提取网络使用CSPNet(Cross Stage Partial Network)结构,它将输入特征图分为两部分,一部分通过一系列卷积层进行处理,另一部分直接进行下采样,最后将这两部分特征图进行融合。这种设计使得网络具有更强的非线性表达能力,可以更好地处理目标检测任务中的复杂背景和多样化物体。

在这里插入图片描述

  在YOLOv5中,每个检测框通过其左上角坐标(x, y)、宽度(w)、高度(h)以及置信度(confidence)来表示。此外,YOLOv5对于每个检测框还会预测C个类别的概率得分,每个类别的概率得分总和为1。这意味着每个检测框最终可以被表示为一个维度为(C+5)的向量,包括类别概率、位置和置信度信息。

  在训练过程中,YOLOv5使用了交叉熵损失函数来优化模型,该损失函数由定位损失、置信度损失和分类损失三个部分组成。YOLOv5还采用了Focal Loss和IoU Loss等优化方法,以缓解正负样本不平衡及目标尺寸变化等问题。这些优化不仅提高了模型的准确性,还改善了在不同尺寸目标下的表现。

  从网络结构来看,YOLOv5分为四个主要部分:Input(输入)、Backbone(骨干网络)、Neck(颈部结构)和Prediction(预测)。其中,Input部分负责将数据引入网络,采用了Mosaic数据增强技术,能够通过随机裁剪和拼接输入图片,进一步提升网络的泛化能力。

  Backbone部分是YOLOv5提取图像特征的关键模块,其特征提取能力直接影响了整个模型的性能表现。相比前代YOLOv4,YOLOv5在Backbone中引入了Focus结构。Focus结构通过切片操作将图片的宽度(W)和高度(H)信息转移到通道空间中,从而实现了2倍的下采样操作,同时保证了不丢失关键信息。

3. yolo11相关介绍

   YOLO11采用改进的骨干和颈部架构,增强了特征提取能力,提高了物体检测的精确度和复杂任务的表现。YOLO11引入精炼的架构设计和优化的训练流程,实现更快的处理速度,同时保持精度和性能之间的最佳平衡。通过模型设计的进步,YOLO11m在COCO数据集上实现了更高的均值平均精度(mAP),同时使用比YOLOv8m少22%的参数,使其在不妥协准确性的情况下更加计算高效。YOLO11可以无缝部署在各种环境中,包括边缘设备、云平台以及支持NVIDIA GPU的系统,确保最大灵活性。无论是物体检测、实例分割、图像分类、姿态估计,还是定向物体检测(OBB),YOLO11都旨在应对多样的计算机视觉挑战。
在这里插入图片描述

1. Ultralytics YOLO11相比于之前版本的主要改进有哪些?

Ultralytics YOLO11在其前身基础上引入了几项重要进步。主要改进包括:

增强的特征提取: YOLO11采用改进的骨干和颈部架构,增强了特征提取能力,提高了物体检测的精确度。
优化的效率和速度: 精炼的架构设计和优化的训练流程实现了更快的处理速度,同时保持了准确性和性能之间的平衡。
更高的准确性与更少的参数: YOLO11m在COCO数据集上实现了更高的均值平均精度(mAP),同时使用比YOLOv8m少22%的参数,使其在不妥协准确性的情况下更加计算高效。
环境适应性强: YOLO11可以在多种环境中部署,包括边缘设备、云平台以及支持NVIDIA GPU的系统。
支持广泛的任务: YOLO11支持多种计算机视觉任务,如物体检测、实例分割、图像分类、姿态估计和定向物体检测(OBB)。
  我们先来看一下其网络结构有什么变化,可以看出,相比较于YOLOv8模型,其将CF2模块改成C3K2,同时在SPPF模块后面添加了一个C2PSA模块,且将YOLOv10的head思想引入到YOLO11的head中,使用深度可分离的方法,减少冗余计算,提高效率。

在这里插入图片描述

2. C3K2的网络结构

   从下面图中我们可以看到,C3K2模块其实就是C2F模块转变出来的,它代码中有一个设置,就是当c3k这个参数为FALSE的时候,C3K2模块就是C2F模块,也就是说它的Bottleneck是普通的Bottleneck;反之当它为true的时候,将Bottleneck模块替换成C3模块。
在这里插入图片描述

3. C2PSA的网络结构

   C2PSA是对 C2f 模块的扩展,它结合了PSA(Pointwise Spatial Attention)块,用于增强特征提取和注意力机制。通过在标准 C2f 模块中引入 PSA 块,C2PSA实现了更强大的注意力机制,从而提高了模型对重要特征的捕捉能力。
在这里插入图片描述

4. PyQt5介绍

  PyQt5 是 Python 语言的一个图形用户界面(GUI)开发框架,基于 Qt库 开发而成。Qt 是一个广泛使用的跨平台 C++ 图形库,支持开发适用于 Windows、macOS、Linux 等多个操作系统的应用程序。PyQt5 提供了对 Qt 类库的完整封装,使开发者可以使用 Python 语言构建功能强大、界面美观的桌面应用。

  PyQt5 包含了丰富的组件,如窗口、按钮、文本框、表格等,可以通过拖拽和代码的方式快速布局,极大地简化了 GUI 开发流程。同时,它还支持 事件处理 和 信号与槽机制,使得用户与界面之间的交互更加灵活。

  通过 PyQt5,开发者能够轻松实现跨平台桌面应用,同时结合 Python 的易用性和 Qt 的强大功能,既适合初学者学习 GUI 编程,也适合资深开发者进行复杂项目的开发。


🌟 四、模型训练步骤

项目工程中提供详细的模型训练步骤,如果有需要的话,可以在自己的电脑上训练模型。

  1. 使用pycharm打开代码,找到train.py打开,示例截图如下:
    在这里插入图片描述

  2. 修改 model_yaml 的值,以符合实际情况。如果你打算训练 YOLOv8s 模型,请将其修改为 model_yaml = yaml_yolov8s。如果你想训练添加 SE注意力机制 的模型,请将其修改为 model_yaml = yaml_yolov8_SE。

  3. 修改 data_path 的数据集路径。这里默认指定的是 traindata.yaml 文件。如果你使用的是我提供的数据,可以不用修改。

  4. 修改 model.train() 中的参数,根据自己的需求和电脑硬件的情况进行调整。

    # 文档中对参数有详细的说明
    model.train(data=data_path,             # 数据集
                imgsz=640,                  # 训练图片大小
                epochs=200,                 # 训练的轮次
                batch=2,                    # 训练batch
                workers=0,                  # 加载数据线程数
                device='0',                 # 使用显卡
                optimizer='SGD',            # 优化器
                project='runs/train',       # 模型保存路径
                name=name,                  # 模型保存命名
                )
    
  5. 修改traindata.yaml文件, 打开 traindata.yaml 文件,如下所示:
    在这里插入图片描述
    在这里,只需修改 path 的值,其他的都不用改动(仔细看上面的黄色字体),我提供的数据集默认都是到 yolo 文件夹,设置到 yolo 这一级即可,修改完后,返回 train.py 中,执行train.py。

  6. 打开 train.py ,右键执行。
    在这里插入图片描述

  7. 出现如下类似的界面代表开始训练了
    在这里插入图片描述

  8. 训练完后的模型保存在runs/train文件夹下
    在这里插入图片描述


🌟 五、模型评估步骤

  1. 打开val.py文件,如下图所示:
    在这里插入图片描述

  2. 修改 model_pt 的值,是自己想要评估的模型路径

  3. 修改 data_path ,根据自己的实际情况修改,具体如何修改,查看上方模型训练中的修改步骤

  4. 修改 model.val()中的参数,按照自己的需求和电脑硬件的情况更改

    model.val(data=data_path,           # 数据集路径
              imgsz=300,                # 图片大小,要和训练时一样
              batch=4,                  # batch
              workers=0,                # 加载数据线程数
              conf=0.001,               # 设置检测的最小置信度阈值。置信度低于此阈值的检测将被丢弃。
              iou=0.6,                  # 设置非最大抑制 (NMS) 的交叉重叠 (IoU) 阈值。有助于减少重复检测。
              device='0',               # 使用显卡
              project='runs/val',       # 保存路径
              name='exp',               # 保存命名
              )
    
  5. 修改完后,即可执行程序,出现如下截图,代表成功(下图是示例,具体以自己的实际项目为准。)
    在这里插入图片描述

  6. 评估后的文件全部保存在在 runs/val/exp... 文件夹下
    在这里插入图片描述


🌟 六、训练结果

我们每次训练后,会在 run/train 文件夹下出现一系列的文件,如下图所示:
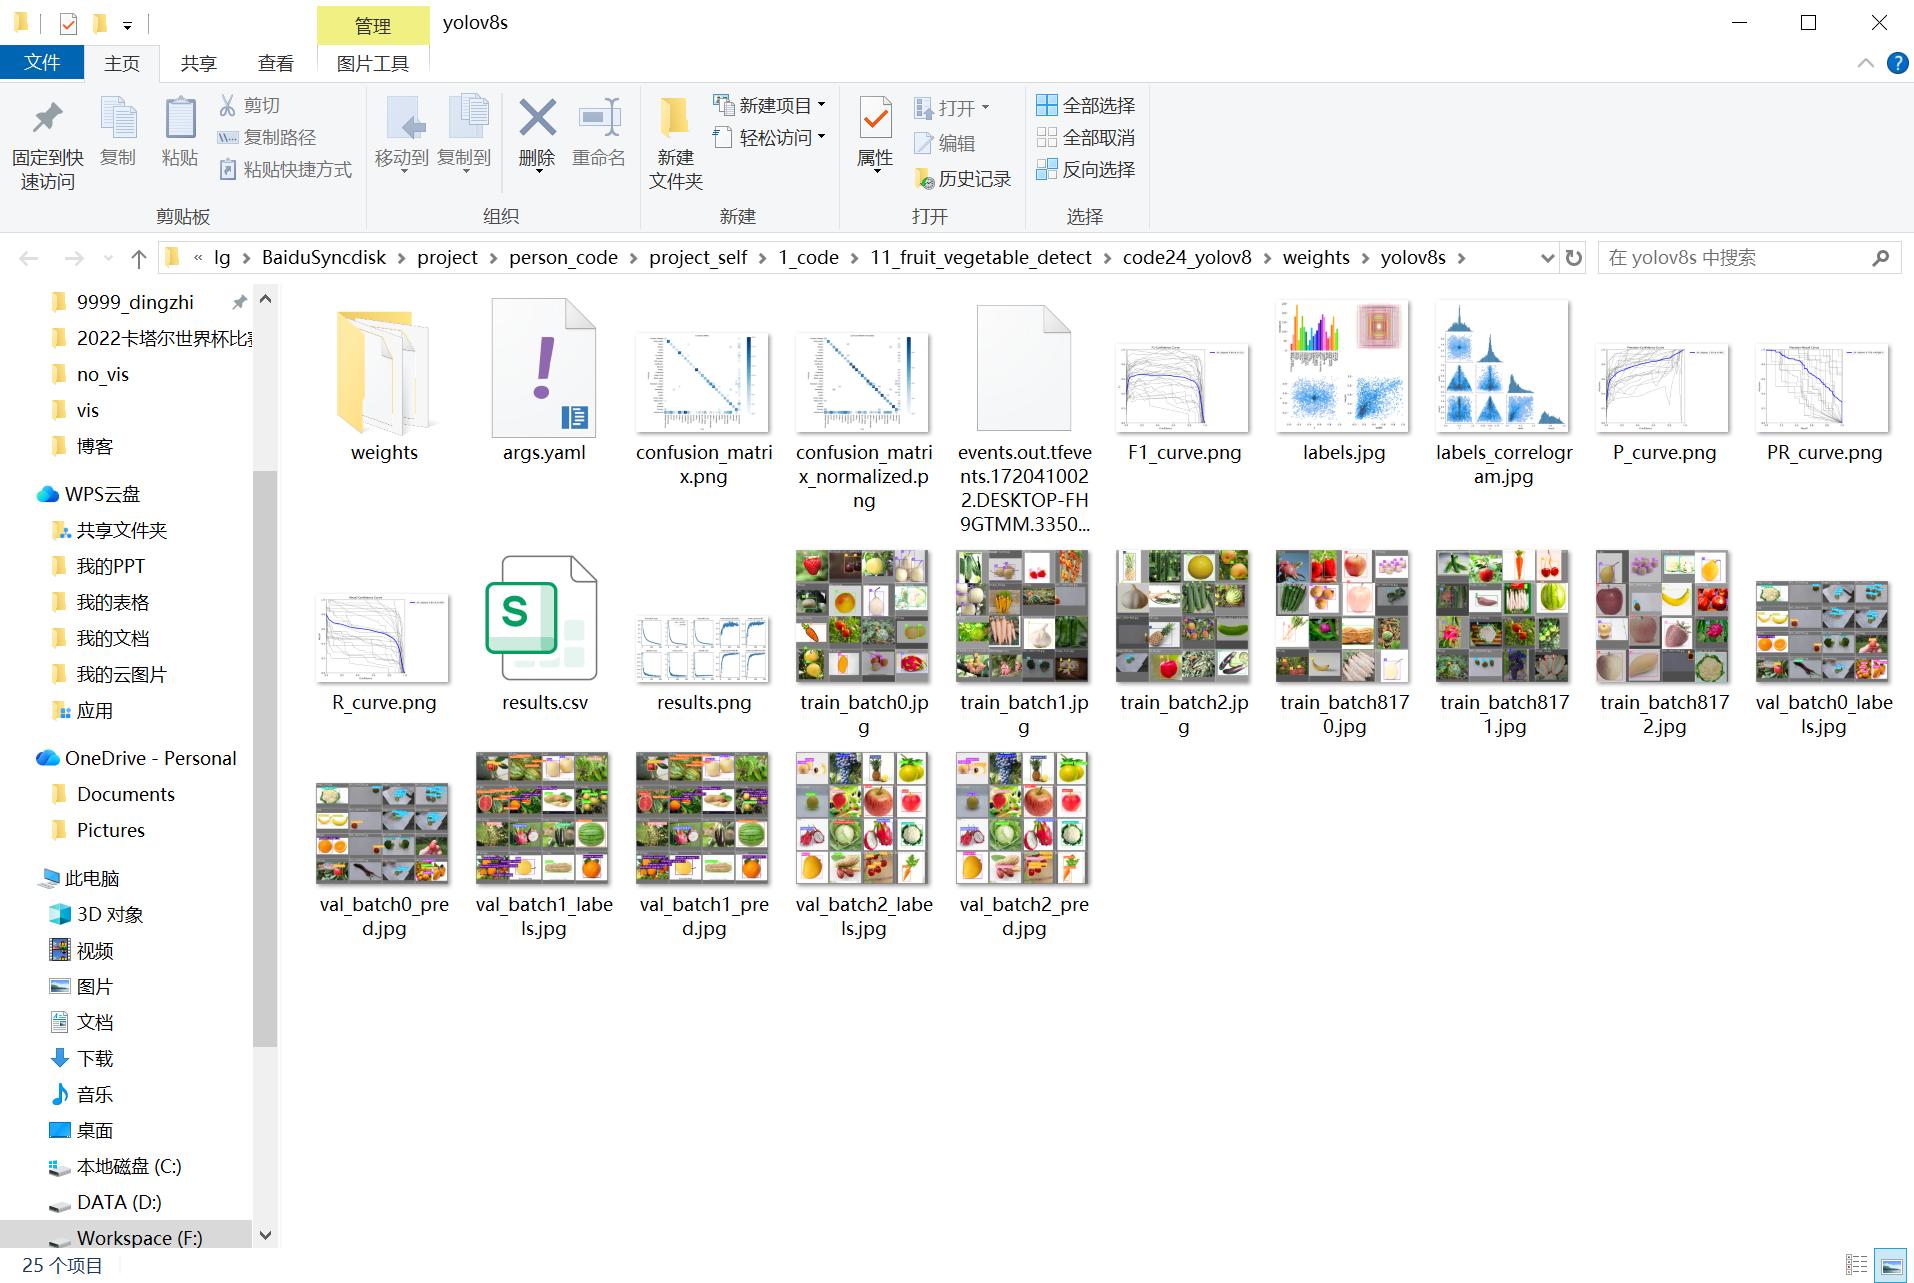
训练结果截图.jpg

   如果大家对于上面生成的这些内容(confusion_matrix.png、results.png等)不清楚是什么意思,可以参考一下我写的文档,查看这些指标的具体含义,示例截图如下:

在这里插入图片描述


结束语 🌟 🌟🌟🌟

   下面图片是对每个文件夹作用的介绍:

在这里插入图片描述

其实用yolo算法做系统非常的简单,但是博客文字有限,如果有介绍不明白的地方,也可以看一下下面的视频,也许会更容易理解。视频中介绍了如何进行训练、预测,简单修改界面等。

演示与介绍视频: 11-基于YOLO12的果蔬检测识别系统项目实战!-全网最全资料(附赠任务书、开题报告模板课程)人工智能/深度学习/计算机视觉/神经网络

演示与介绍视频: 11-基于深度学习的果蔬检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)

演示与介绍视频: 11-基于深度学习的果蔬检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模板课程)

演示与介绍视频: 11-基于深度学习的果蔬识别系统(yolov5)

由于博主的能力有限,文中提到的方法虽经过实验验证,但难免存在一些不足之处。为不断提升内容的质量与准确性,欢迎您指出任何错误和疏漏。这不仅将帮助我在下次更新时更加完善和严谨,也能让其他读者受益。您的反馈对我至关重要,能够推动我进一步完善相关内容。

此外,如果您有更优秀的实现方案或独到的见解,也非常欢迎分享。这将为大家提供更多思路与选择,促进我们共同的成长与进步。期待您的宝贵建议与经验交流,非常感谢您的支持!

参考文献:

  1. Redmon, J., & Farhadi, A. (2018). YOLOv3: An Incremental Improvement. arXiv preprint arXiv:1804.02767.

    该文献介绍了YOLO(You Only Look Once)系列模型的第三版,是一种广泛用于实时目标检测的深度学习模型,为目标检测提供了技术支持。

  2. Bochkovskiy, A., Wang, C. Y., & Liao, H. Y. M. (2020). YOLOv4: Optimal Speed and Accuracy of Object Detection. arXiv preprint arXiv:2004.10934.

    该文献介绍了YOLOv4模型,在目标检测的精度和速度方面进行了优化。

  3. Jocher, G., et al. (2023). Ultralytics YOLOv8. https://github.com/ultralytics/ultralytics.

    该文献介绍了YOLOv8模型,是当前目标检测领域的SOTA模型之一,支持检测、分割、分类等多种任务。
    ang, C. Y., & Liao, H. Y. M. (2020). YOLOv4: Optimal Speed and Accuracy of Object Detection. arXiv preprint arXiv:2004.10934.

    该文献介绍了YOLOv4模型,在目标检测的精度和速度方面进行了优化。

贝加莱Automation Studio 4.10安装保姆级教程:从官网下载到解决.Net 3.5报错 本文提供贝加莱Automation Studio 4.10的详细安装教程,涵盖从官网下载到解决.Net 3.5报错的全过程。特别针对工业自动化开发环境中常见的.Net Framework 3.5安装问题,提供多种经过验证的解决方案,包括控制面板安装、DISM命令离线安装和手动下载安装包等方法,帮助工程师顺利完成PLC开发环境的搭建。 阅读详情

相关推荐

一文了解ECU软件刷写的2种方法:Bootloader刷写和调试器刷写

分为刷写前、刷写中和刷写后三个阶段,如下示意:下面我们来详细了解一下Bootloader收到外部请求后开始刷写的三个阶段1)刷写前进行刷写的准备,一是确保刷写阶段总线通信的稳定性,二是避免刷写阶段出现非预期的故障,三是读取车辆数据供刷写前的一些检查等,如下所示:首先进行会话控制,通过功能寻址方式进入扩展会话模式,为后面的信息访问及其他指令做准备;然后检查刷写的前提条件,通过物理寻址方式发送历程控制请求。比如车确实处于静止状态,供电电压稳定等条件下才允许刷写;

menghuyouyou的博客 5784

基于yolov8的钢铁缺陷检测系统-2027毕业版(UI界面+Python项目源码+模型+标注好的数据集)

已经分好 train、val、test文件夹,也提供转好的yolo格式的标注文件,可以直接使用。本系统集成了多个不同的算法版本和界面版本,以下是对这些版本的概述:算法版本方面,系统提供了多种深度学习算法和传统图像处理技术,用户可以选择最合适的算法进行任务处理。此外,各算法版本经过严格的测试和优化,以提供更高的准确率和效率。在界面版本方面,系统设计了多种用户界面风格,可以选择简约、直观的界面,快速上手进行操作;也可以选择功能丰富的专业界面,满足复杂任务的需求。

Python_csdn_csdn的博客 181

Claude Code 使用 OpenAI Codex(GPT-5.3-Codex)完整配置教程

通过 LiteLLM 可以让 Claude Code 调用任何模型,包括:OpenAIDeepSeekGemini本地模型↓↓优点:不依赖 Anthropic API可自由切换模型支持统一 AI Gateway这种“LLM Gateway 架构”正在成为 AI 开发工具的主流实践。

Jacobe_zhao的博客 1万+

基于PP-PicoDet的钢铁缺陷检测

实现轻量化模型检测钢铁缺陷

m0_63642362的博客 1301

基于STM32和K210的自动驾驶小车设计

自动驾驶技术正在迅速发展,成为了汽车行业和智能交通领域的热点之一。随着科技的发展,STM32和K210这两款芯片为自动驾驶小车提供了优秀的硬件支持。本文我们将学习如何使用STM32和K210打造一个简单的自动驾驶小车。提示:以下是本篇文章正文内容,下面案例可供参考通过这篇文章,掌握了如何使用STM32和K210构建一个简单的自动驾驶小车。通过了解基本的电路设计,并编写了STM32和K210的代码。通过这个例子,可以更好地理解如何在嵌入式系统中使用STM32和K210,以及如何实现自动驾驶小车的简单功能。

Kyle_Chan_zMH的博客 2219

OpenCV实战:如何用Debevec算法搞定相机响应函数(附完整代码)

本文详细介绍了如何使用OpenCV实现Debevec算法计算相机响应函数(CRF),并应用于HDR图像合成。通过完整的代码示例和工程实践问题解决方案,帮助开发者掌握从原理到实现的关键步骤,提升高动态范围成像和计算机视觉任务的处理能力。

weixin_29061041的博客 229

基于YOLOV8的骑行智能守护实时检测系统【训练和系统文档及源码+Pyside6+数据集+包运行】

骑行智能守护实时检测系统通过先进的图像处理和人工智能技术,实时检测电动车和车上人员头盔佩戴情况,促进安全出行,减少交通事故风险。本文基于YOLOv8算法框架,通过5448张真实道路场景的训练图片(其中4358张训练集,1090张验证集),训练出一个可用于检测电动车及车上人员头盔情况的有效模型。此外,为更好地展示算法效果,基于此模型开发了一款带GUI界面的基于YOLOv8的骑行智能守护实时检测系统,可用于实时检测电动车及车上人员头盔情况,以及时告警。系统背景和标题修改模型权重导入和初始化。

源的博客 2039

ResNet改进(51):基于轴向注意力机制的改进ResNet模型

本文介绍了一种结合轴向注意力机制的改进ResNet模型。 通过在传统CNN中引入轴向注意力,我们能够在保持计算效率的同时,增强模型对图像全局上下文的理解能力。这种混合架构结合了CNN的局部特征提取优势和注意力机制的全局建模能力,在图像识别任务中表现出色。 轴向注意力机制的应用不仅限于ResNet,也可以灵活地集成到其他CNN架构中。 未来可以探索更多注意力变体,或将其应用于特定领域任务,如医学图像分析、自动驾驶等需要精确空间理解的场景。 希望本文能帮助你理解如何将注意力机制与传统CNN结合,为你的计

2401_82355416的博客 359

【完整源码+数据集+部署教程】Github图像验证识别系统源码&数据集分享 [yolov8-seg-C2f-Faster-EMA&yolov8-seg-SPPF-LSKA等50+全套改进创新点发刊_

【完整源码+数据集+部署教程】Github图像验证识别系统源码&数据集分享 [yolov8-seg-C2f-Faster-EMA&yolov8-seg-SPPF-LSKA等50+全套改进创新点发刊_

weixin_43860634的博客 1430

【PointNet++】制作点云数据集使用CloudCompare进行标注

使用PointNet++复现成功后,需要训练自己的数据集。于是使用cloudcompare参照ShapeNet的数据集格式去制作,最终保存的txt文件格式为“xyz+rgb+label”,一共7列。 自己按此制作好的数据集已成功训练及推测,于是记录下来让好兄弟好姐妹们少踩坑多吃肉。

纵马踏花向自由 5714

AOSP 8.0.0编译中的ANDROID_DATA缺失问题解决方案

在AOSP编译过程中,环境变量和路径设置的正确性至关重要。遇到相关的错误时,检查并修正环境配置通常是解决问题的关键。希望本文提供的分析和解决方案能帮助你顺利编译AOSP。

m0_74337424的博客 398

基于深度学习的钢铁缺陷检测系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版

摘要 本项目基于YOLO系列算法(YOLOv5/YOLOv8/YOLOv12)开发了一套高效的目标检测系统,支持图像、视频及摄像头实时检测,具备工业质检、智能安防等应用价值。系统采用PyQt5构建交互界面,提供完整的端到端解决方案,包括数据预处理、模型训练与评估、结果导出等功能。通过算法对比与优化,验证了不同YOLO版本在实际场景中的性能差异。项目包含详细的环境配置指南、数据集及训练参数说明,适合学习与二次开发,可应用于缺陷检测、自动驾驶、医疗影像等领域。 关键词:YOLO、目标检测、PyQt5、工业质检、

you 是 mine 267

Vue3 - 详解播放m3u8视频流+HLS拉流推流完整方案,vue3如何播放m3u8格式文件实时视频播放教程(流媒体播放、直播视频流、实时摄像头监控视频流对接、后端服务器切片分片传输视频流边下边播)

vue3组件播放m3u8格式视频,实现hls流媒体监控摄像头实时播放,vue3播放m3u8视频流格式,实时直播画面视频流播放,摄像头监控画面推流,hls.js,Vue Video.js播放m3u8视频流格式,实现hls流媒体监控摄像头实时播放,vue中使用video.js播放m3u8格式的视频,m3u8格式视频,通过HLS协议播放m3u8格式视频,黑屏不显示怎么办,视频非常卡加载缓慢,拉流报错,推流报错,播放失败,播放监控m3u8视频流格式,苹果ios播放,vue3中使用video标签播放MP4,西瓜视频插

🏆 前端领域优质创作者 5940

11-2027毕设-基于yolo11的果蔬检测识别系统(含UI界面、训练好的模型、Python代码、数据集)

项目中所用到的算法模型和数据集等信息如下:算法模型:yolo26yolo26 + SE注意力机制yolo11yolo11 + SE注意力机制yolo12yolo12 + SE注意力机制yolov8yolov8 + SE注意力机制yolov5yolov5 + SE注意力机制算法还在持续更新中。。。。不同算法的界面是不一样的,不用担心重复问题。目前有上面这些不同的算法模型、每个算法有两个训练好的模型。模型十分重要,因为有些同学的电脑没有 GPU,无法自行训练。

pythonAI_的博客 427

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

jre9下载 jdk9

(Java SE Runtime Environment 9.0) 9.0u175 官方最新版 【x86|x64】

基于深度学习的果蔬检测识别系统(yolo26、yolo12、yolo11、yolov8、yolov5+UI界面+Python项目源码+模型+标注好的数据集)2027毕业版

本项目基于PyQt5构建了简洁易用的图形用户界面,支持用户选择本地图片或视频进行目标检测。系统界面美观,交互流畅,具备良好的用户体验。项目附带完整的 Python 源码和详细的使用说明,适合学生进行学习或有一定 Python 基础的开发者,参考与二次开发。您可以在文末获取完整的代码资源文件。✨ 项目亮点🔧包括pyqt5界面、后台检测逻辑、模型加载等模块🧠源代码,支持个人添加改进、模型修改等🚀结构清晰,逻辑完整,便于演示使用数据集一部分个人标注,一部分来源网络,已统一标注格式并完成预处理,

you 是 mine 519

YOLOv8钢材焊接缺陷识别检测系统(项目源码+YOLO数据集+模型权重+UI界面+python+深度学习+环境配置)

针对钢材焊接过程中常见缺陷检测效率低、人工检测主观性强等问题,本文基于YOLOv8目标检测算法构建了一套钢材焊接缺陷自动检测系统。系统涵盖六类焊接缺陷:不良焊接(Bad Welding)、裂纹(Crack)、余高过大(Excess Reinforcement)、良好焊接(Good Welding)、气孔(Porosity)及飞溅(Spatters)。实验采用3,037张训练图像、422张验证图像及205张测试图像,训练100个周期。

斌擎科技 740

03-【2027毕设】YOLOv8钢铁缺陷检测系统 - Python完整源码+PyQt5界面+训练模型+数据集

本系统围绕实用场景设计,涵盖以下核心功能模块:完整的功能演示和环境配置讲解,请参考下方视频资源。视频内容覆盖了安装部署、模型训练、结果评估及常见问题解答。03-基于YOLO12的钢铁缺陷检测识别系统项目实战!-全网最全资料(附赠任务书、开题报告模板课程)人工智能/深度学习/计算机视觉/神经网络03-模型预测教程03-基于深度学习的钢铁缺陷检测识别系统-yolo11-彩色版界面(附赠任务书、开题报告模板课程)03-基于深度学习钢铁缺陷检测识别系统-yolov8/yolov5-经典版界面(附赠任务书、开题报告模

Python_csdn_csdn的博客 423

基于YOLOv8的钢材表面缺陷检测系统(全套源码+数据集)

本项目是一个面向钢材表面缺陷检测场景的深度学习应用系统,围绕 YOLOv8 完成了从数据集组织、模型训练、结果评估,到桌面端检测系统开发与功能集成的完整流程。项目以 NEU-DET 钢材表面缺陷数据集为基础,训练得到钢材缺陷检测模型,并基于 PyQt6 开发了可视化检测系统,支持图片识别、视频识别、摄像头实时识别、检测历史管理、模型参数管理和训练指标展示等功能。

Michael_Jay的博客 316

YOLOv5至YOLOv12升级:钢材表面缺陷检测系统的设计与实现(完整代码+界面+数据集项目)

本文面向钢材表面缺陷检测,基于 YOLOv5–YOLOv12 搭建可落地系统,提供代码、PySide6 界面与数据集;统一配置对比各版本精度与速度,界面支持多源输入、阈值调参、结果统计导出,并用 SQLite 做账号与结果管理。

思绪无限的博客 982

深度学习目标检测-钢材缺陷检测系统上位机ui和web界面

钢材缺陷检测-基于yolov5算法和qt界面

weixin_39735688的博客 6836

【原创毕设项目】基于深度学习的杂草图像分类系统设计与实现

本文设计并实现了一套基于深度学习的杂草图像分类系统,采用ResNet50迁移学习,融合负样本拒识机制,支持图片、视频与摄像头实时识别,具备9类输出(8类杂草+背景),结合Django+Vue架构与ECharts可视化看板,实现识别记录管理与六图统计分析。系统有效提升田间杂草识别效率与准确性,为智能农业提供可落地的技术方案。

qq_1445749146的博客 216

使用yoloV8实现自动化脚本

移动端自动化脚本里的“找图”一直是个让人头疼的环节。OpenCV模板匹配要求目标和素材几乎像素级一致,界面稍微缩放、换个主题、加个滤镜,匹配率就断崖式下跌。找色方案更脆弱,系统亮度一变,整段逻辑就废了。无障碍控件看起来是最优解,但短视频和游戏类应用普遍对控件树做了限制,经常拿不到有效节点。冰狐平台把YOLOv8的推理能力直接封装进了JavaScript运行环境,在安卓本地完成目标检测,不走云端,模型文件和截图都不会离开手机。

jcgu的专栏 286

C#使用opencv和Yolo模型识别车牌号

本文基于OpenCVSharp与OnnxRuntime,结合YoloV8n-pose_plate模型(检测车牌位置)和OCR模型(识别车牌文字),实现高效车牌识别。通过预处理、目标检测、NMS筛选及文字识别流程,最终输出车牌框位置与识别文本。代码封装良好,支持自定义路径与置信度阈值,具备实际应用价值。

lweiyue的专栏 173

YOLO26最新创新改进:融合 WST:小波无损下采样主干,下采样是主干里唯一一次不可逆的信息丢弃,用小波把丢掉的高频收回来!

YOLO26融合小波无损下采样(WST)主干,针对原始结构中下采样导致的高频信息不可逆丢失问题,提出在保持原有拓扑不变的前提下,以正交小波变换替代传统卷积下采样。该方法实现无损特征分解与高频子带重构,有效保留边缘、纹理等关键细节,解决弱目标检测中因下采样失真带来的性能瓶颈。实验表明,该改进显著提升小目标与低对比度目标检测精度,且机制清晰、可解释性强,为轻量级检测器优化提供新范式。

B站 Ai学术叫叫兽的文案地 611

高空作业栏杆检测数据集VOC+YOLO格式230张3类别

标注类别名称(注意yolo格式类别顺序不和这个对应,而以labels文件夹classes.txt为准):["langan","nverqiang","wu"]数据集格式:Pascal VOC格式+YOLO格式(不包含分割路径的txt文件,仅仅包含jpg图片以及对应的VOC格式xml文件和yolo格式txt文件)nverqiang女儿墙(屋顶边缘的矮墙) 框数=118,占有图片数=95。图片数量(jpg文件个数):230。标注数量(xml文件个数):230。标注数量(txt文件个数):230。

FL1623863129的博客 201

YOLO + SAM 3 混合自动标注:把数据集生产成本打下来的工程实践

YOLO + SAM 3 的混合方案之所以有效,不是因为它用了两个更强的模型,而是因为它把任务拆成了「召回—精修—仲裁」三段,每一段都交给了最擅长的那一方:YOLO 管快与类别,SAM 3 管准与开放概念,人管边界与例外,工程管闭环与可追溯。这篇文章讲一套已经跑在生产环境里的混合方案:让 YOLO 负责「快」和「认得类别」,让 SAM 3 负责「准」和「开放概念」,人工只负责最后一公里的仲裁与验收。给定「黄色安全帽」这样的名词短语,它返回所有符合该概念的实例掩膜与框,并给出存在性评分。

SaturnCloud的博客 758

基于 YOLOv8 的森林火灾检测系统(Web 版)

本项目面向林区早期火情识别场景,使用YOLOv8完成火焰(Fire)与烟雾(Smoke)两类目标的检测模型训练,并以FastAPI构建 Web 检测平台,把模型能力封装为可直接登录使用的系统。平台除常规的图片、批量、视频、摄像头检测外,还提供同图多权重对比、数据集浏览与标注核对、模型热切换,以及把训练搬到网页上的能力:可在浏览器配置超参数发起真实训练,训练中在线调整学习率、查看进度与动态曲线,训练完成后下载产物或直接应用到检测。

Michael_Jay的博客 63
上一篇: 11-2027毕设-基于yolo11的果蔬检测识别系统(含UI界面、训练好的模型、Python代码、数据集)
下一篇: 12-2027毕设-基于yolo11的人脸表情检测识别系统(含UI界面、训练好的模型、Python代码、数据集)
悟空毕设
博客等级 码龄122天 4粉丝 22原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值