表情包:有本事来爬我啊,俺有上千条 python:来啦~

python爬虫教程:《利用Python爬取表情包》 python爬虫教程:《利用Python爬取表情包》,微信没有表情包?不用愁!老师带领你使用多线程爬虫一键爬取20w的表情包~ 项目源码: ''' 在学习过程中有什么不懂得可以加我的 python学习交流扣扣qun,934109170 群里有不错的学习教程、开发工具与电子书籍。 与你分享python企业当下人才需求及怎么从零基础学习好python,和学习什么内容。 ''' from pyq... 阅读详情

前言

在如今这个人人配一台手机得时代,很多人聊天都是通过网上,但是,怎么样快速缓解尴尬进入快乐而愉快得聊天呢~
src=http___pic.fxxz.com_up_2020-5_15891660163881132.gif&refer=http___pic.fxxz.gif

刚认识的朋友丢几个表情包出去分分钟拉进关系,女朋友生闷气了整两个表情包开心一下,也可以化解尴尬,没时间打字整两张表情包,礼貌而不失尴尬。不知道回啥时,那更是丢张表情包分分钟钟解决
现在年轻人聊天,不带点表情包都不好意思说自己是年轻人, 表情包已然成为人与人聊天中不可缺少的部分。
准备工作

准备工作很重要,先知道我们要干啥,用什么来做,怎么做,再去一步步实时,稳扎稳打。

开发环境配置

  • Python 3.6
  • Pycharm

如果有没安装得小伙伴可以左侧主页领取👈👈👈或者私信我领取安装教程~♥♥♥♥♥

模块安装配置

  • requests
  • parsel
  • re
第三方模块,我们需要安装:
  1. win + R 输入cmd 输入安装命令 pip install 模块名 如果出现爆红 可能是因为 网络连接超时 切换国内镜像源

  2. 在pycharm中点击Terminal(终端) 输入安装命令

如何配置pycharm里面的python解释器?
  1. 选择file(文件) >>> setting(设置) >>> Project(项目) >>> python interpreter(python解释器)

  2. 点击齿轮, 选择add

  3. 添加python安装路径

pycharm如何安装插件?
  1. 选择file(文件) >>> setting(设置) >>> Plugins(插件)
  2. 点击 Marketplace 输入想要安装的插件名字 比如:翻译插件 输入 translation / 汉化插件 输入 Chinese
  3. 选择相应的插件点击 install(安装) 即可
  4. 安装成功之后 是会弹出 重启pycharm的选项 点击确定, 重启即可生效

代码

目标:fabiaoqing
地址前面后面大家自己补全一下,包括后面代码里的,这应该没有不会的吧。

导入模块

import requests 
import parsel 
import re
import time

请求网址

url = f'fabiaoqing/biaoqing/lists/page/{page}.html'

请求头

headers = {
       'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/84.0.4147.105 Safari/537.36'
    }

返回网页源代码

response = requests.get(url=url, headers=headers)

获取数据

# 第一次提取 提取所有的div标签内容
divs = selector.css('#container div.tagbqppdiv') # css 根据标签提取内容

# 通过标签内容提取他的图片url地址
img_url = div.css('img::attr(data-original)').get()

# 提取标题
title = div.css('img::attr(title)').get()

# 获取图片的后缀名
name = img_url.split('.')[-1]

保存数据

new_title = change_title(title)

对表情包图片发送请求 获取它二进制数据

img_content = requests.get(url=img_url, headers=headers).content

保存数据

def save(title, img_url, name):

    img_content = get_response(img_url).content
    try:
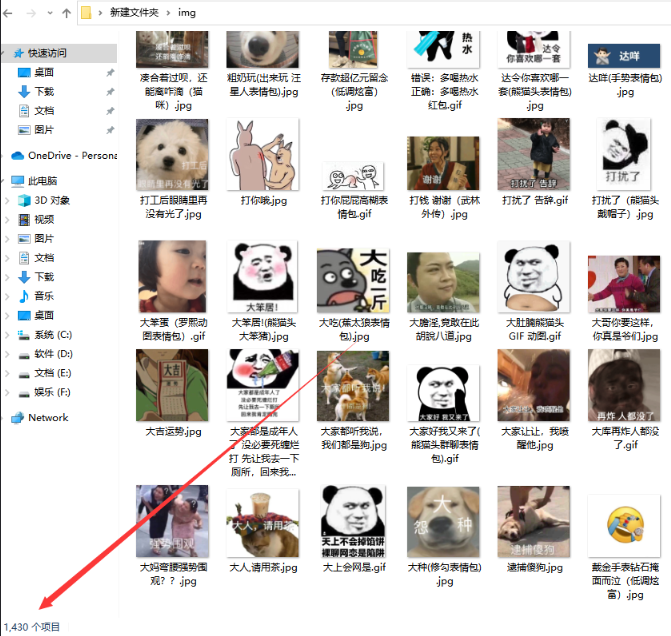
        with open('img\\' + title + '.' + name, mode='wb') as f:
            # 写入图片二进制数据
            f.write(img_content)
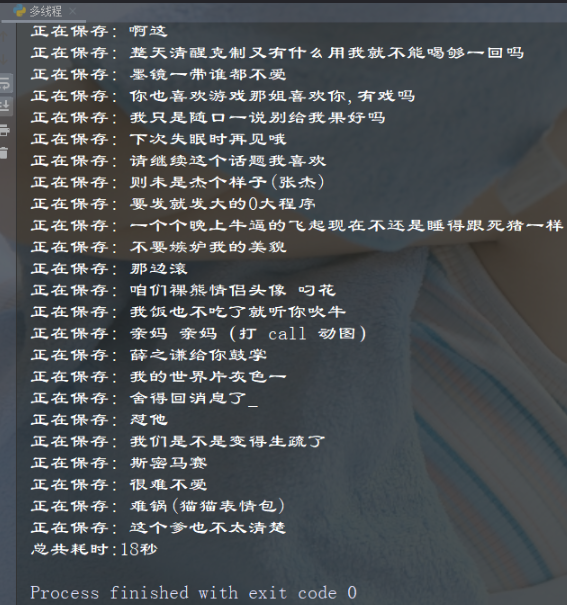
            print('正在保存:', title)
    except:
        pass
        
# 替换标题中的特殊字符
# 因为文件命名不明还有特殊字符,所以我们需要通过正则表达式替换掉特殊字符。
def change_title(title):
    mode = re.compile(r'[\\\/\:\*\?\"\<\>\|]')
    new_title = re.sub(mode, "_", title)
    return new_title

记录时间

time_2 = time.time()

use_time = int(time_2) - int(time_1)
print(f'总共耗时:{use_time}秒')
多线程

import requests  
import parsel 
import re
import time
import concurrent.futures 


def change_title(title):

    mode = re.compile(r'[\\\/\:\*\?\"\<\>\|]')
    new_title = re.sub(mode, "_", title)
    return new_title


def get_response(html_url):

    headers = {
        'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/84.0.4147.105 Safari/537.36'
    }
    repsonse = requests.get(url=html_url, headers=headers)
    return repsonse


def save(title, img_url, name):

    img_content = get_response(img_url).content
    try:
        with open('img\\' + title + '.' + name, mode='wb') as f:
          
            f.write(img_content)
            print('正在保存:', title)
    except:
        pass


def main(html_url):

    html_data = get_response(html_url).text
    selector = parsel.Selector(html_data) 
    divs = selector.css('#container div.tagbqppdiv') 
    for div in divs:

        img_url = div.css('img::attr(data-original)').get()
 
        title = div.css('img::attr(title)').get()

        name = img_url.split('.')[-1]
 
        new_title = change_title(title)
        save(new_title, img_url, name)


if __name__ == '__main__':
    time_1 = time.time()
    exe = concurrent.futures.ThreadPoolExecutor(max_workers=10)
    for page in range(1, 201):
        url = f'fabiaoqing/biaoqing/lists/page/{page}.html'
        exe.submit(main, url)
    exe.shutdown()
    time_2 = time.time()
    use_time = int(time_2) - int(time_1)
    print(f'总共耗时:{use_time}秒')
大家看完觉得有用的话,点个赞收藏一下呗 ♥♥♥♥♥♥

Python爬虫爬取表情包 听说你在网上斗图斗输了?听说你连弔图也不知道去哪找? 没事啦,你看到这篇文章就证明你找到救星啦!在本篇文章里我会带着大家一起来爬取一下表情包网,从此让你的图库再也不缺弔图,妈妈再也不担心我斗图找不到图啦!那废话不多说 直接上解析。 首先我们要知道如果我们要爬取一个网站,我们要先分析这个网站,了解你的需求是什么, ... 阅读详情

相关推荐

用Python爬取了上W表情包。快拿去欢乐斗图吧~

导语 “表情包”是一种利用图片来表示感情的一种方式。表情包是在社交软件活跃之后,形成的一种流行文化,表情包流行于互联网上面,基本人人都会发表情。 曾经你是否也有过找不到表情包去应对别人的时候。别担心~???? 今天小编将分享如何用Python爬取批量表情包,想用什么表情包搜一下就有了! 小编爬取的表情包图: 想要大量丰富又(沙雕)bushi有趣的表情包的铁汁萌可要看看学习这篇哦!! 想领取更多完整源码更Python学习资料可点击这行字体 面向对象 python从设计开始就是一

L010409的博客 674

python程序员搞笑段子_程序员才能看得懂的段子,内含表情包,吃饭的时候别点!...

原标题:程序员才能看得懂的段子,内含表情包,吃饭的时候别点!很多网友都认为程序员必定是非常古板,整天只会敲键盘的码农。其实这种看法是非常片面的。真正优秀的程序员,不仅精通程序的编写,还是某些领域的专家。许多“码农”也会发生很多让人啼笑皆非的趣事,这些故事你的身边有发生过吗? 1、公司两位程序员同事聊天,甲抱怨说:“每天敲代码太辛苦了,我想换行”乙说:“敲回车啊”2、公司的前端工程师单身久了,就去了...

weixin_39716044的博客 620

【python】你的表情包缺不缺?我猜你缺了~来批量获取一波吧~

嗨喽~大家好呀,这里是魔王呐 ❤ ~!在我们的生活中,总少不了表情包来调剂少了表情包就会少了很多趣味今天就来教大家如何批量下载我们的表情包。

python56123的博客 1406

python谐音梗_有没有类似“duck不必”的谐音梗?

8月份看到此问题,灵感突然爆发。然后文章写写停停停停停……快11月才写出来……谐音梗干嘛要找人问,自己创造不快乐吗~我潜心研究,发明了谐音梗生成器。 文章版见:M小白:谐 音 梗 生 成 器​zhuanlan.zhihu.com谐音梗,即通过谐音来制造笑点,比如book思议,Tony带水,贪生pass等等。谐音梗相较于其他段子来说比较容易创作,不用花费太多心思就能创作出令人愉悦的段子。当然,在李诞...

weixin_39900676的博客 1027

python批量采集欢乐之源——表情包数据~

嗨喽,大家好呀~这里是爱看美女的茜茜呐无论在什么时候,表情包都是一大神奇~它促进人与人之间的距离~使人和睦关爱的相处😀。

m0_72282564的博客 637

【Python实战】海量表情包炫酷来袭,快来pick斗图新姿势吧~(超好玩儿)

身处表情包时代,谁的手机里能没点藏货?正所谓,没有表情包的聊天是没有灵魂的想要成为斗图界的天花板,会点儿代码技术必不可少。想要多少自己取就是了。好啦文章结束,大家记得点点关注哦~

xy258009的博客 1252

PHP最好的语言的梗的笑话

最早看到这个是由于下面这个笑话: 某女:你能让这个论坛的人都吵起来,我今晚就跟你走。 某软件工程师:PHP是最好的语言! 某论坛真的就炸锅了,各种吵架…… 某女:服了你了,我们走吧,你想干啥都行。 某软件工程师:今天不行,我一定要说服他们,PHP必须是最好的语言…… 其实把PHP换成Python\Ruby\Java…能起到一样的效果。终究这只是一个笑话而已。每个人心中都有自己的女神,每个人都会本能...

sunsiny 1958

Zemax实战:20×超高清变焦镜头设计全流程解析(从架构到制造)

本文详细解析了使用Zemax软件设计一款20倍变焦比、恒定F2.8光圈8K超高清镜头的全流程。从应对恒定光圈、宽光谱与8K解析力三大挑战的初始架构规划,到构建多重组态模型、分七阶段进行像差优化与公差分析,最终跨越制造鸿沟,为广播级影视与高精度工业检测应用提供了实战指南。

sun99的博客 552

python中 什么意思_Python里面的这几个梗,你能回答出来吗

原标题:Python里面的这几个梗,你能回答出来吗初学者学习Python的时候,会有一些梗非常不适应,这些是Python特有的地方,今天我罗列出一些,希望对初学者有帮助!1.Python中多重循环如何退出比如我们在进行嵌套循环的时候,需要立刻退出,用break是不行的:deffun():fori inrange(3):fori inrange(10,13):print("inner:",i)ifi...

weixin_39693101的博客 399

Linux下开机异常(fsck exited with status code 4)

Linux下开机异常事情是这样的,本来我呢跑着程序听着歌,结果忽然就死机了,我只能强制关机,再次打开系统的时候,就提示这样fsck from util-linux 2.26.2 /dev/sda10 contains a file system with errors, check forced. /dev/sda10: Inodes that were part of a corrupted pr

芳草碧连天 2万+

SBM与超效率SBM模型实战:从原始面板数据到MATLAB高效实现

本文详细介绍了SBM模型与超效率SBM模型的核心原理,并提供了从原始面板数据预处理到MATLAB高效实现的完整实战指南。通过具体代码解析,帮助研究者掌握如何利用MATLAB进行数据标准化、模型构建、效率求解及结果可视化,从而精准评估决策单元的相对效率,尤其适用于在高效单元中进一步精细排名的场景。

weixin_29100399的博客 481

python恶搞表情包-关于python表情包

广告关闭2017年12月,云+社区对外发布,从最开始的技术博客到现在拥有多个社区产品。未来,我们一起乘风破浪,创造无限可能。来源:python开发id:pythonpush作为一个数据分析师,应该信奉一句话----一图胜千言。 不过这里要说的并不是数据可视化,而是一款全民向的产品形态----表情包! 表情包不仅仅是一种符号,更是一种文化; 是促进社交乃至社会发展的动力之一,就像懒。 我们坚持认为,...

weixin_37988176的博客 4990

【时空数据分析#06】实战:基于Python与ArcGIS的NDVI长期趋势制图与分级

本文详细介绍了基于Python与ArcGIS进行NDVI长期趋势制图与分级分析的完整工作流。通过整合MODIS卫星数据,利用ArcGIS进行空间处理与栅格转换,结合Python进行时序统计与趋势计算,最终生成直观的植被变化趋势分级图,为生态评估与环境监测提供可靠的空间分析工具。

lilh34434的博客 478

Python爬虫入门推荐案例:学会爬虫_表情包手到擒来~

前言 哈喽,哈喽,各位小伙伴们早上好,我来更新了! 超感谢大家的喜欢与支持???? 这一期文章内容呢:之前有一个小可爱私信我,想要小表情包!(因为基础学完了.) 因为我一直在更新最基础的知识点_很多同学可能跟着我已经学完了<Python从入门到实战的基础 系列内容>刚好,基础的知识上一期讲到了第三方模块的安装与使用,新手的练习题库也出了几大箩 筐了!还是按照我的一个更文的进度,今天讲一个最最简单的小爬虫,只有几行代码的哈! 希望大家喜欢别忘了文末点击“三连”或者“关注下

xy258009的博客 2272

四旋翼无人机数学模型推导

本周开始进行四旋翼无人机的学习工作,首先来进行四旋翼无人机的数学模型推导工作。。 四旋翼动力学数学模型 坐标变换 介绍四旋翼数学模型之前,首先引入坐标变换的概念,定义两个坐标系惯性坐标系{E},以及机体坐标系{B},惯性坐标系就相当于在地面建立的、静止不动的坐标系,也是我们操纵无人机所在的空间,而机体坐标系是建立于四旋翼机体之上,随着四旋翼姿态变换而变化,所以建立一种地面上的惯性坐标系与四旋翼机体坐标系之间的转换关系,就有这个必要。 对于惯性坐标系{E},以及机体坐标系{B},它们之间的转换关系

BiuBiuSun的博客 1万+

Python 爬虫实战:爬取哔哩哔哩知识区,抓取高赞课程信息

哔哩哔哩(Bilibili)是一个广受欢迎的综合性视频社区,其中的知识区汇聚了大量优质的教育、科普、技术等课程内容。本文将指导读者如何使用 Python 爬虫技术从哔哩哔哩知识区抓取高赞课程信息,并进行数据分析。本文深入探究了利用 Python 爬虫技术从哔哩哔哩知识区抓取高赞课程信息的全流程。从前期的环境搭建、模拟登录,到核心的课程数据抓取、存储,再到后续的数据分析与可视化,都详细展开讲解并提供代码支持。通过此方法所获取的数据,能够助力创作者优化内容、用户发现优质课程、平台洞察用户需求。

u014481728的博客 1137

python恶搞表情包-python绘制表情包

广告关闭2017年12月,云+社区对外发布,从最开始的技术博客到现在拥有多个社区产品。未来,我们一起乘风破浪,创造无限可能。python爱好者社区 , 作者 盛光晓表情包是当代社交生态中的战略性武器,既托起了友情的小船,又浮起了爱情的巨轮,还载起了亲情的航空母舰。 在一个又一个宁静又不乏躁动的夜晚,此起彼伏的“老铁666”、“顶你上去”掀起了一阵又一阵的波澜。 当你和别人斗图斗得天昏地暗、地动山摇...

weixin_37988176的博客 1913

手把手教你学simulink(31.17)--双向DCDC电源场景示例:基于simulink 的双向DCDC应用:车载充电器的pi控制

通过引入PI控制器,系统可以更精确地控制电压和电流,确保充电和放电过程的稳定性和高效性。

MHD0815的博客 206

斗图?教你用Python制作表情包

作者 | Ahab来源 | Ahab杂货铺 (ID:AhabBin)“表情包”是现在非常流行的交流方式,通过一张图片就能把文字不能表达或不便于表达的情感给表示出来,表情...

AI科技大本营 5357

使用pytorch-superpoint与pytorch-superglue项目实现训练自己的数据集

superpoint与superglue的组合可以实现基于深度学习的图像配准,官方发布的superpoint与superglue模型均基于coco数据训练,与业务中的实际数据或许存在差距,为此实现基于开源的pytorch-superpoint与pytorch-superglue项目实现训练自己的数据集。然而,在训练pytorch-superpoint有诸多细节需要优化,特此整理成技术文档。本文档描述了实验pytorch-superpoint与pytorch-superglue项目训练自己的图像配准模型。

a486259的博客 9506

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

python多线程爬表情包,斗图斗够瘾~

前言 嗨喽!大家好,这里是魔王。 什么?群里又在斗图 (+_+)? 别动让我来(>人<;) 教你一招爬取海量表情包图片, 从此告别图慌 !!! 课 题:python爬取海量表情包 课程亮点: 系统分析目标网页 html标签数据解析方法 海量图片数据一键保存 环境介绍: python 3.8 pycharm 模块使用: requests >>> pip install requests parsel >>> pip install parsel time

python56123的博客 1027

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

【python】半佛老师的表情包是怎么爬的?

背景 听半佛老师说他的表情包是爬的,有点好奇是怎么爬的?由此有了这篇文章。 我调研了几个表情包的网站,最后以斗图网为例https://www.doutula.com/photo/list/爬取网站上的表情图片。 为了简单,用python +Scrapy去做。 环境 Python3 +Scrapy(1.6.0)+ urllib +BeautifulSoup 如果没有Scrapy包,pip3 install Scrapy即可。 参考:https://docs.scrapy.org/en/lat..

opi 3415

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

python制作动态表情包,用 Python 开发一个【GIF表情包制作神器】

用 Python 开发一个【GIF表情包制作神器】小帅b 学习python的正确姿势之前小帅b写过这样一篇教程用python成为了微信斗图届的高手然后,好多人表示:虽然存了很多表情包但似乎还不是很过瘾因为它不可以自己来定制我们可不可以根据一些表情素材然后自己制作专属表情包呢像这样本来小帅b想自己实现一个表情包制作器后来发现已经有人在 GitHub 分享了主要功能就是可以在原有的素材里面自定义自己...

weixin_35830006的博客 1352

女同桌找我要表情包,还好我会Python,分分钟给她下载几十个G...

emmm~ 起因呢,这昨晚女同桌跟我说电脑有点卡,喊我去宿舍给她装个新系统,装系统就装系统吧,结果又说新系统表情包都没保存~ 我当时就有点生气,真当我是万能的呢? 于是我直接就用Python给她爬了几十个G,完事扭头就走,任她怎么喊我也没用!

人生苦短, 还不用Python? 3万+

scrapy 爬取二十万张热门表情包

目标:爬取 发表情 所有热门表情包,一页 45 张, 3961 页,将近 20 万个表情包。 以页为文件夹存在硬盘上(3 个多小时爬到了 2000 多页,还在爬…) 每一页45张表情包 想想是不是有点小激动,从此斗遍天下再也不用担心图穷了23333333~ 创建爬虫的步骤细节就不多讲了,想看步骤细节的同学可以移步我的另一篇博客 Python3 scrapy爬取智联招聘存MongoDB 下面直...

Mr_Lewis的博客 798
上一篇: python:想要什么资源,直接上去莽就完事了~
下一篇: 一篇文章带你多方面采集完一个应用评论、视频并自动点赞、评论~
魔王不会哭
博客等级 码龄5年 6003粉丝 394原创
评论 8
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值