


新人入门机器学习,最害怕的是各种公式、概念和推导过程。
面对厚重的教材和复杂的概念,常常不知如何下手。曾经的我,抱着西瓜书生啃,看到使用西瓜藤挑西瓜、根据空气湿度研判天气的案例,进度就永远停在了
“嗯,明天一定是一个好天气”… …

既然,现在的智能体技术,已经能够把专业知识灌入到智能体团队内了,那,为何不做一个机器学习助手呢!
先设计这个 AI 专家组成的私人导师团队构成:
📚 机器学习研究员:精通各类机器学习概念,能够精确定位你需要的知识点
🔍 技术专家:将复杂的概念转化为清晰的解释,提供实用的代码示例
✅ 验证专家:确保所有建议都经过严格验证,符合业界最佳实践
📝 文档专家:把专业知识转化为通俗易懂的学习资料
其次,机器学习非常看重实操,所以,必须是一个能够指导用户进行系统性学习的团队。从概念理解到代码实现,得全方位覆盖。
所以,这是一个实用导向的团队,不止于理论,更注重实践应用。
当然,技术的变化非常快,他们还得持续更新,通过网络搜索保持知识的时效性。
先来看一下效果:
input:Error analysis on the training set #训练集误差分析
这个是专家团队给我的指导:
- \1. 机器学习概念的技术解释
- 训练集误差分析(Error Analysis on the Training Set) 是机器学习模型开发中的一个关键步骤,特别是在模型表现不佳时。
- 训练集误差分析的主要目的是识别模型在训练数据上的表现问题,尤其是高偏差(High Bias)问题。
- 高偏差通常意味着模型无法很好地拟合训练数据,导致训练误差较高。 通过分析训练集中的错误样本,可以识别出模型在哪些特定类别或场景下表现不佳。例如,在语音识别系统中,可能会发现模型在处理背景噪音较大的音频时表现较差。通过这种分析,可以有针对性地改进模型,例如增加对背景噪音的处理能力。
- \2. 实践实施指导
- 步骤1:收集和分析错误样本 从训练集中随机选择100-200个模型表现较差的样本。 对这些样本进行人工分析,识别出主要的错误类别。例如,在语音识别中,错误类别可能包括“背景噪音”、“用户说话不清”等。
- 步骤2:统计错误类别 对每个错误类别进行统计,计算每个类别在总错误中的比例。 根据统计结果,确定哪些错误类别对模型性能影响最大。
- 步骤3:针对性改进模型 根据错误分析结果,调整模型结构或训练策略。例如,如果背景噪音是主要问题,可以增加数据增强技术来模拟更多背景噪音场景。 重新训练模型,并再次进行误差分析,直到模型在训练集上的表现达到预期。
- \3. 相关代码示例 以下是一个简单的Python代码示例,展示了如何进行训练集误差分析:
- import numpy as np from sklearn.metrics import accuracy_score, classification_report, confusion_matrix # 假设我们有一个模型和训练数据 model = … # 你的模型 X_train = … # 训练数据特征 y_train = … # 训练数据标签 # 预测训练集 y_pred = model.predict(X_train) # 计算训练集误差 train_error = 1 - accuracy_score(y_train, y_pred) print(f"Training Error: {train_error:.4f}“) # 找出预测错误的样本 error_indices = np.where(y_pred != y_train)[0] error_samples = X_train[error_indices] error_labels = y_train[error_indices] # 分析错误样本 for i, sample in enumerate(error_samples[:100]): # 分析前100个错误样本 print(f"Sample {i}: Predicted {y_pred[error_indices[i]]}, Actual {error_labels[i]}”) # 在这里可以进一步分析样本的特征,例如语音识别中的音频特征 # 使用混淆矩阵和分类报告进行详细分析 conf_matrix = confusion_matrix(y_train, y_pred) print(“Confusion Matrix:”) print(conf_matrix) class_report = classification_report(y_train, y_pred) print(“Classification Report:”) print(class_report)
- \4. 框架特定的注意事项 TensorFlow/Keras 在使用Keras进行训练时,可以通过 model.evaluate() 方法直接计算训练集误差。此外,Keras提供了回调函数(Callbacks),可以在训练过程中实时监控训练误差。 # Keras 示例 train_loss, train_acc = model.evaluate(X_train, y_train, verbose=0) print(f"Training Accuracy: {train_acc:.4f}“) PyTorch 在PyTorch中,可以通过自定义训练循环来计算训练集误差。可以使用 torch.no_grad() 上下文管理器来避免在计算误差时更新模型参数。 # PyTorch 示例 model.eval() with torch.no_grad(): outputs = model(X_train) _, predicted = torch.max(outputs, 1) train_acc = (predicted == y_train).sum().item() / y_train.size(0) print(f"Training Accuracy: {train_acc:.4f}”) Scikit-learn Scikit-learn提供了多种评估指标(如accuracy_score、confusion_matrix 等),可以方便地进行误差分析。
- \5. 性能和优化建议 数据增强 如果发现模型在某些特定场景下表现不佳,可以通过数据增强技术生成更多相关场景的训练数据。例如,在图像分类任务中,可以通过旋转、缩放、添加噪声等方式增强数据。 模型复杂度调整 如果模型在训练集上表现不佳,可能是模型复杂度不足。可以尝试增加模型的层数或神经元数量,以提高模型的拟合能力。 正则化 如果模型在训练集上表现良好但在开发集上表现不佳,可能是过拟合问题。可以尝试添加正则化项(如L2正则化)来减少过拟合。 学习率调整 学习率过高或过低都会影响模型的训练效果。可以通过学习率调度器(Learning Rate Scheduler)动态调整学习率,以提高模型的收敛速度和性能。
- \6. 常见问题及解决方案 问题1:模型在训练集上表现不佳 解决方案:增加模型复杂度,调整学习率,或使用数据增强技术。 问题2:模型在训练集上表现良好但在开发集上表现不佳 解决方案:添加正则化项,或使用交叉验证来评估模型性能。 问题3:错误样本分析耗时 解决方案:使用批量处理和并行计算来加速错误样本分析。
- \7. 官方文档和研究论文的参考 Scikit-learn 官方文档: [https://scikitlearn.com.cn/]
如何实现的呢?
这不得不提到一个完整的 RAG 系统构成。
包含几个独立的工作板块:知识库(文档向量化处理)、检索系统和大模型问答系统。
如下是组件关系图。

其中,最重要的有:文档向量化处理部分。
为什么这个最重要。最终会影响知识库内的内容能否被准确查询到。因为,后续大模型的问答准确性,取决于知识是否纳入检索结果。
其中,有两个非常重要的角色。分别是:Embedding 模型和向量数据库。
Embedding 模型的解释和应用,可以参考这篇文章:https://mp.weixin.qq.com/s/-l0IWSP_FvLfOmYQgX6bCA
而向量数据库在现代 AI 应用中扮演着重要角色,特别是在需要处理和检索大量文本数据的场景中。
它为智能问答系统、搜索引擎和知识库提供了强大的基础设施支持。
简单看一下向量化的过程:
文档先执行切块处理,切块完成后,会使用 embedding 模型进行向量化处理,然后,处理完成的数据,存入向量化数据库。

一旦提及向量化,就避不开向量维度。
什么是向量维度?
向量维度是用数字表示文本特征的方式。就像用不同数量的特征来描述一个物体:
2维物体,比如一个长方形,只用长和宽描述。
3维物体,比如一个长方体:用长、宽、高描述。
维度越多,则对物体的描述就越充分。对于文本而言,2 维、3 维明显就不够了。
Embedding 模型的维度
当前,不同embedding模型使用不同数量的特征来理解文本。
文本的向量维度有两种主流模式,一个是 768 维,另一个是 1536 维。
768维:常见于 HuggingFace 的Embedding模型(如 BERT),1536维:OpenAI 的Embedding模型使用。
向量数据库的维度
这些维度会影响最终存储向量数据的数据库选型。当向量化处理的 embedding 模型维度和向量数据库维度不匹配时,这两个组件就没办法兼容。就好比,这就像用米尺去匹配以码为单位的数据,系统无法比较不同维度的向量,会导致信息检索失败。
向量维度匹配
怎么实现向量维度匹配呢?很简单,在文本向量化的时候和向量存储的时候,选择同一个 Embedding 模型。
以我现在在使用的本地化部署 Ollama nomic-embed-text 模型和Chroma 向量数据库为例,我们逐一看一下,需要怎么实现维度适配。
1-初始化 Ollama embeddings 设置
import os

from crewai import Agent, Task, Crew, Process
from crewai.tools import tool
from langchain_chroma import Chroma
from langchain_openai import ChatOpenAI
from dotenv import load_dotenv  # 添加这行导入环境变量
from langchain_ollama import OllamaEmbeddings
from langchain_community.document_loaders import PyPDFLoader
from langchain_ollama import OllamaEmbeddings
from langchain.text_splitter import RecursiveCharacterTextSplitter

# 1. 初始化 Ollama embeddings
embeddings = OllamaEmbeddings(
    model="nomic-embed-text",  # 使用 nomic-embed-text 模型
    base_url="http://localhost:11434"  # Ollama 服务地址
)
2-创建新 Chroma 数据库
# 2. 创建新的 Chroma 数据库
vectorstore = Chroma(
    collection_name="test_collection", #数据库命名为 test_collection
    embedding_function=embeddings, #使用 nomic-embed-text 模型进行向量化处理
    persist_directory="./chroma_db_test" #存储放入文件夹 chroma_db_test内
)
3-添加知识库文档
这里我用的是吴恩达的机器学习策略,这是一本用于机器学习算法调优的实战宝典,绝对值得逐字拜读。
# 3. 添加文档示例
loader = PyPDFLoader("./knowledge/Ng_MachineLearningYearning.pdf") #加载PDF文档
documents = loader.load()

# 2. 文档分块
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=1000,  # 每块文本的大小
    chunk_overlap=200,  # 重叠部分大小
    length_function=len,  # 用于计算文本长度的函数
    separators=["\n\n", "\n", " ", ""]  # 分割文本的分隔符
)

chunks = text_splitter.split_documents(documents)
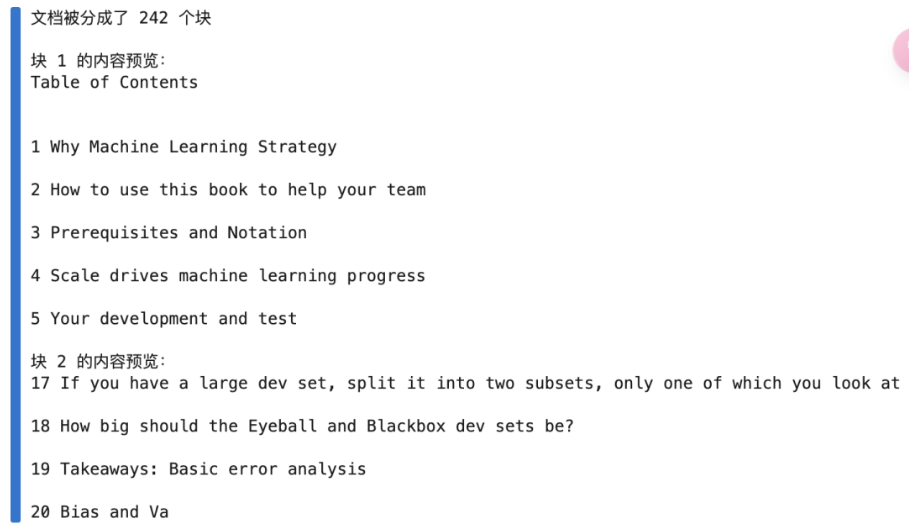
把分块信息打印出来看一下效果:
# 可选:打印分块信息
print(f"文档被分成了 {len(chunks)} 个块")
for i, chunk in enumerate(chunks[1:3]):  # 打印1-2 块,两个块的示例
    print(f"\n块 {i+1} 的内容预览:")
    print(chunk.page_content[:200])  # 只显示前200个字符
4-文档存入向量数据库
# 4. 将文档添加到向量数据库
vectorstore.add_documents(documents=chunks)
5-创建检索器,并且更新检索工具
# 创建检索器时添加搜索参数
retriever = vectorstore.as_retriever(
    search_type="similarity",
    search_kwargs={
        "k": 10  # 只使用 k 参数,返回前 10 个相关性最高的文档。
    }
)
测试一下能否执行正常的查询
#查询测试
query = "How big should the Eyeball and Blackbox dev sets be"
results = retriever.get_relevant_documents(query)
print(results)
OK,已经能够正常检索到了

接下来,配置 Crew.ai 工具
# 更新检索工具
@tool("ChromaRetriever")
def chroma_retriever_tool(query: str):
    """Retrieves relevant documents from the Chroma vector store."""
    try:
        results = retriever.invoke(query)
        return results
    except Exception as e:
        return f"Error retrieving documents: {str(e)}"

# 将函数包装为工具
chroma_tool = chroma_retriever_tool
构建 web 检索的工具
from langchain_community.tools import TavilySearchResults
from crewai.tools import BaseTool
from pydantic import Field

search = TavilySearchResults()

class SearchTool(BaseTool):
    name: str = "Search"
    description: str = "Useful for search-based queries. Use this to find current information about latest legal trends and news."
    search: TavilySearchResults = Field(default_factory=TavilySearchResults)

    def _run(self, query: str) -> str:
        """Execute the search query and return results"""
        try:
            return self.search.run(query)
        except Exception as e:
            return f"Error performing search: {str(e)}"

web_search_tool = SearchTool()
往下,就是我们熟悉的,在 Crew.ai 中配置智能体 Agents 和 Tasks 了。
Agents 配置:
retriever_agent = Agent(
    role='ML Research Agent',
    goal='从机器学习知识库中检索与"{query}"相关的内容。',
    backstory=("你是一位机器学习研究专家,擅长查找相关的机器学习概念、"
              "算法和实现细节。你能够理解复杂的机器学习主题,并能从学术论文和"
              "技术文档中识别出最相关的信息。"),
    verbose=True,
    memory=True,
    tools=[chroma_tool],
    llm=llm
)

technical_expert_agent = Agent(
    role="ML Technical Expert",
    goal="基于检索到的机器学习文档,为{query}生成详细的技术响应",
    backstory=(
        "你是一位对算法、框架和最佳实践有深入了解的机器学习专家。"
        "你擅长清晰地解释复杂的机器学习概念,并提供实用的实施指导。"
        "如果检索到的文档信息不够充分,你会使用网络搜索工具从可靠来源"
        "(如arXiv、研究论文或官方文档)查找额外的技术细节。"
    ),
    verbose=True,
    memory=True,
    allow_delegation=False,
    tools=[web_search_tool],
    llm=llm
)

validation_agent = Agent(
    role="ML Validation Expert",
    goal="验证机器学习相关响应的技术准确性和实际适用性。",
    backstory=(
        "你是一位专门从事机器学习的验证专家。"
        "你负责验证机器学习概念的技术准确性,检查代码示例是否遵循最佳实践,"
        "并确保建议在实践中可行且符合最新的机器学习发展。"
        "你在审查机器学习解决方案方面经验丰富,能够发现潜在问题或改进空间。"
    ),
    verbose=True,
    memory=False,
    allow_delegation=False,
    tools=[web_search_tool],
    llm=llm
)

documentation_agent = Agent(
    role="ML Documentation Expert",
    goal="为'{query}'创建清晰、结构良好的文档,包含代码示例和解释。",
    backstory=(
        "你是一位专门从事机器学习文档编写的技术作者。"
        "你擅长使复杂的机器学习概念变得易于理解,提供清晰的代码示例,"
        "并以易于理解的方式组织信息。你确保所有技术内容准确无误,"
        "并包含实际的实现细节。"
    ),
    verbose=True,
    memory=False,
    llm=llm
)
Tasks配置:
retrieval_task = Task(
    description="""
    从机器学习知识库中检索与'{query}'相关的文档。
    重点关注:
    - 核心机器学习概念和算法
    - 实现细节和代码示例
    - 最新研究论文和技术文档
    - 最佳实践和常见陷阱
    如有需要,可以重新构造查询以更好地匹配技术术语。
    """,
    expected_output="一份完整的相关机器学习文档列表,并突出显示关键技术细节。",
    agent=retriever_agent
)

technical_analysis_task = Task(
    description="""
    分析检索到的关于'{query}'的机器学习文档,并提供:
    1. 机器学习概念的技术解释
    2. 实践实施指导
    3. 相关代码示例
    4. 框架特定的注意事项
    5. 性能和优化建议
    仅使用经过验证的技术来源和官方文档。
    """,
    expected_output="包含代码示例和实施指导的详细技术分析。",
    agent=technical_expert_agent,
    context=[retrieval_task]
)

validation_task = Task(
    description="""
    通过以下方面验证'{query}'的技术响应:
    1. 验证算法正确性
    2. 检查代码示例是否符合最佳实践
    3. 确认框架兼容性
    4. 评估计算效率
    5. 根据当前机器学习研究进行验证
    提供准确性评分并在需要时提出改进建议。
    """,
    expected_output="包含准确性评分和技术建议的验证报告。",
    agent=validation_agent,
    context=[technical_analysis_task]
)

documentation_task = Task(
    description="""
    为'{query}'创建清晰的技术文档,包括:
    1. 机器学习概念的简明解释(2-3段)
    2. 带注释的可运行代码示例
    3. 实施步骤和要求
    4. 常见问题及解决方案
    5. 官方文档和研究论文的参考
    以最大可读性和实用性格式化响应。
    """,
    expected_output="结构良好的机器学习文档,包含代码示例和实用指导。",
    agent=documentation_agent,
    context=[technical_analysis_task, validation_task]
)
配置 Crew
os.environ["CREW_DISABLE_TELEMETRY"] = "true"

ml_crew = Crew(
    agents=[retriever_agent, technical_expert_agent, validation_agent, documentation_agent],
    tasks=[retrieval_task, technical_analysis_task, validation_task, documentation_task],
    process=Process.sequential
)
来看一下效果吧。
user_query = "Error analysis on the training set"
results = ml_crew.kickoff(inputs={"query": user_query})
print(f"Raw Output: {results.raw}")
是否有其他的向量数据库可选择?
行业内的开源的向量数据库还有Milvus、Weaviate、Qdrant 等,对比 Chroma,分别有什么优劣势,各自的应用场景又是什么呢?我整理了一个表格内容,包含了各个特性的对比:

不同的向量数据库的选用建议不一样。根据场景而言,有这些使用建议:
初学者/小项目:选择 Chroma,上手快速,集成简单。
企业应用:考虑 Milvus 或 Weaviate,功能完善,可扩展性好
中等规模项目:考虑 Qdrant,平衡了易用性和性能
多模态需求:优先考虑 Weaviate
选择合适的向量数据库需要根据具体项目需求、规模、资源限制等因素综合考虑。
建议在正式选型前进行充分的测试和评估。
如何学习大模型
现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。
作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。
下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

二、AI大模型视频教程

三、AI大模型各大学习书籍!
四、AI大模型各大场景实战案例

五、AI大模型面试题库

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
五、结束语
学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。
再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。
因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。
 384


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


