


本文详细介绍如何利用Python和大型语言模型(LLM)构建一个检索增强生成(Retrieval-Augmented Generation, RAG)系统。该系统包括完整的数据处理,向量数据库,前端以及后端结构,能够从个人文档中学习知识,并在无需GPU的情况下于笔记本电脑上运行。
1. 引言
自然语言处理(NLP)是人工智能领域研究机器与人类语言交互的学科。NLP的巅峰目前当属大型语言模型(LLM)的出现。LLM在海量文本数据上进行训练,能够学习语言模式和变体。“语言模型”一词随着深度学习和神经网络的兴起而普及。特别是2018年,谷歌引入了基于Transformer架构的模型,极大地提升了NLP模型的性能(例如谷歌的BERT和OpenAI的GPT)。
如今,LLM通常用于文本到文本任务或“文本生成”(如翻译、摘要、聊天机器人和虚拟助手,甚至撰写整本书)。这催生了生成式人工智能(GenAI)的兴起,GenAI专注于生成新内容(如文本、图像、音频、视频)。
目前最先进的LLM包括:
- OpenAI的ChatGPT
- Anthropic的Claude
- 谷歌的Bard
- Meta的Llama
- 微软的Phi(体积最小,可在笔记本电脑上运行,无需GPU)
- StabilityAI的StableLM
- Cohere的CommandR
- Snowflake的Arctic
- 阿里巴巴的Qwen
- 01AI的Yi
- X的Grok
- 英伟达的Megatron
- 亚马逊的Olympus(尚未发布)
- 苹果的MM1(尚未发布)
ChatGPT是最常用的LLM,但企业面临一个问题:无法将敏感数据上传到OpenAI(主要出于隐私和安全考虑)。因此,企业正在创建内部AI服务,以便在其私有知识库上利用LLM的强大功能。这种任务被称为检索增强生成(RAG)。RAG是一种结合检索和生成模型的技术,通过从外部来源获取知识事实来增强LLM。
在组织中,知识库通常由包含多模态内容(如文本、图像、电子表格)的文档组成。因此,最大的挑战是如何以机器能够理解的方式处理所有这些内容。简而言之,首先将每个文档转换为嵌入向量,然后将用户查询转换为相同的向量空间,从而实现余弦相似度搜索。
本文将介绍如何使用LLM和多模态数据构建一个RAG应用程序,该应用程序可以在普通笔记本电脑上运行,无需GPU。文中将提供一些有用的Python代码,这些代码可以轻松应用于其他类似案例,并对每一行代码进行注释,以便读者可以复现该示例。
2. 环境搭建
在企业环境中,PDF是使用最广泛的文档格式,因为大多数文档在共享前都会转换为PDF格式。此外,PDF也是一个很好的案例,因为它们包含图像、表格和文本。因此,本文将以一份PDF格式的上市公司财务报表作为数据集。
处理PDF文档有两种方法:将其作为文本读取或将其解析为图像。这两种方法都不完美,具体取决于用例,但OCR(光学字符识别)往往效果更好,因此本文采用这种方法。
首先,需要将文档转换为图像:
import pdf2image #1.17.0
doc_img = pdf2image.convert_from_path("data/doc_nvidia.pdf", dpi=300)
然后,使用Tesseract识别图像中的文本。Tesseract是HP在1985年开发的主要OCR系统,目前由谷歌维护。
import pytesseract #0.3.10
doc_txt = []
for page in doc_img:
    text = pytesseract.image_to_string(page)
    doc_txt.append(text)
现在,我们有了原始文本,在进行任何处理之前,必须对其进行预处理。我们将使用语言模型。目前,有几种库可以利用LLM的强大功能:Ollama、HuggingFace、DSpy、LangChain。我喜欢使用Ollama,因为它功能强大且用户友好。
首先,需要从网站下载Ollama程序。然后,在提示符下运行以下命令以在笔记本电脑上运行LLM(本文使用Phi3和LLaVa):

最后,安装Python库(pip install ollama)即可。
3. 数据预处理
在任何数据科学项目中,最困难的部分始终是数据集。无论投入多少机器学习,如果数据不好,AI就无法正常工作。
对于LLM,由于涉及嵌入,向量空间中的所有内容都应转换为文本。我们将展示如何处理最常见的多模态内容(文本、表格、图像、图表)。
文本 - 由于文档可能具有不同的结构和布局,因此应将数据集拆分为段落。除了原始文本外,还可以使用额外的信息(如标题、标签、链接)来丰富数据。这被称为元数据增强。
# 使用目录为段落添加标签
title_map = {
    "4-12" : "Business",
    "13-33" : "Risk Factors",
    "34-44" : "Financials",
    "45-46" : "Directors",
    "47-83" : "Data"
}
lst_docs, lst_ids, lst_metadata = [], [], []
for n, page in enumerate(doc_txt):
    try:
        ## 获取标题
        title = [v for k,v in title_map.items() if n in range(int(k.split("-")[0]), int(k.split("-")[1])+1)][0]
        ## 清理页面
        page = page.replace("Table of Contents","")
        ## 获取段落
        for i,p in enumerate(page.split('\n\n')):
            if len(p.strip())>5:
                lst_docs.append(p.strip())
                lst_ids.append(str(n)+"_"+str(i))
                lst_metadata.append({"title":title})
    except:
        continue
元数据增强可以显著提高文档检索效率。例如,可以使用Phi3将每个段落总结为几个关键词。
import ollama #0.2.1
def keyword_generator(p, top=3):
    prompt = "summarize the following paragraph in 3 keywords separated by , : "
    res = ollama.generate(model="phi3", prompt=prompt)["response"]
    return res.replace("\n", " ").strip()
对所有段落应用该函数:
from tqdm.notebook import tqdm
for i, doc in tqdm(enumerate(lst_docs)):
    lst_metadata[i]["keywords"] = keyword_generator(doc)
表格 - LLM可以处理顺序文本,但也可以理解结构化数据,因此可以将表格作为普通文本传递。
table = lst_docs[376]
print("Table: \n", table)
prompt = f"Summarize the following table: {table}"
res = ollama.generate(model="phi3", prompt=prompt)["response"]
print("\nSummary : \n", res)

图像 - 图像嵌入比较棘手(涉及将3D数组的维度降低到向量)。因此,一种常见的做法是使用AI生成描述图像的标题,并将其作为文本处理。
from matplotlib import image, pyplot
image_file = "data/image.jpeg"
pyplot.imshow(image.imread(image_file))
pyplot.show()
为了使LLM能够处理图像,必须将其转换为字符串:
import base64
def encode_image(path):
    with open(path, "rb") as file:
        return base64.b64encode(file.read()).decode('utf-8')
img = encode_image(image_file)
LLM无法直接处理图像,因此需要使用视觉模型来描述图像。微软的LLaVa是一个不错的选择,因为它也可以在无GPU的情况下运行。
prompt = "describe the image"
res = ollama.generate(model="llava", prompt=prompt, images=[img])["response"]
print(res)
图表 - 同样,视觉模型可以读取和总结图表,但结果不如图像准确。
image_file = "data/plot.png"
pyplot.imshow(image.imread(image_file))
pyplot.show()
img = encode_image(image_file)
prompt = "Describe the image in detail. Be specific about graphs, such as bar plots, line graphs, etc."
res = ollama.generate(model="llava", prompt=prompt, images=[img])["response"]
print(res)
 4. 数据库
向量数据库是存储、索引和搜索非结构化数据的最佳解决方案。当前,最常用的向量数据库是微软的AISearch,而最好的开源工具是ChromaDB,它功能强大、易于使用,并且是免费的。
安装ChromaDB后,可以使用Python以三种不同的方式与数据库交互:
- chromadb.Client(): 创建一个临时存在于内存中的数据库,不占用磁盘空间。
- chromadb.PersistentClient(path): 从本地机器保存和加载数据库。
- chromadb.HttpClient(host=‘localhost’, port=8000): 在浏览器中实现客户端-服务器模式。
import chromadb #0.5.0

# 创建一个持久化的数据库实例
db = chromadb.PersistentClient()

# 获取或创建一个名为 "nvidia" 的集合
collection_name = "nvidia"
collection = db.get_or_create_collection(
    name=collection_name,
    embedding_function=chromadb.utils.embedding_functions.DefaultEmb
)

# 将文档、ID和元数据添加到集合中
collection.add(
    documents=lst_docs,
    ids=lst_ids,
    metadatas=lst_metadata,
    images=None,
    embeddings=None
)
在ChromaDB中存储文档时,数据以向量形式保存,因此可以使用查询向量检索最匹配的记录。需要注意的是,除非另有说明,否则默认的嵌入函数是一个句子转换模型(Sentence Transformer model),例如 all-MiniLM-L6-v2。
# 查看集合中的一个样本
collection.peek(1)
输出示例:
{
    'embeddings': [
        [-0.06092095375061035, -0.01741098240017891, 0.0484163761138916, ...]
    ],
    'metadatas': [
        {
            'keywords': 'Renewable Energy Adoption, Supplier Engagement, Emission Reduction Goals',
            'title': 'Business'
        }
    ],
    'documents': [
        'We aim to generate enough renewable energy to match 100% of our global electricity usage for our offices and data centers. In fiscal year 2023, we increased the percentage of our total electricity use matched by renewable energy purchases to 44%. By fiscal year 2026, we aim to engage manufacturing suppliers comprising at least 67% of NVIDIA's scope 3 category 1 GHG emissions with the goal of effecting supplier adoption of science-based targets.'
    ],
    'uris': None,
    'data': None
}
文档作为包含向量和元数据的字典保存。
接下来,尝试查询一些信息:
query = "how much is the revenue?"
res_db = collection.query(query_texts=[query])["documents"][0][0:10]
context = ' '.join(res_db).replace("\n", " ")
print(context)
输出示例:
Total revenue for fiscal year 2024 was $60.9 billion, up 126% from a year ago. Data Center revenue for fiscal year 2024 was up 217%. Strong demand was driven by enterprise software and consumer internet applications, and multiple industry verticals including automotive, financial services, and healthcare. Gaming revenue for fiscal year 2024 was up 15%. Professional Visualization revenue for fiscal year 2024 was up 1%. Automotive revenue for the fiscal year 2024 was up 21%. The increase primarily reflected growth in self-driving platforms. Gross margin increased in fiscal year 2024, primarily driven by Data Center revenue growth and lower net inventory provisions as a percentage of revenue. Operating expenses increased for fiscal year 2024, driven by growth in employees and compensation increases.
数据库的响应可以作为上下文,即LLM可以利用其内存模块存储和访问的一小部分信息。使用提示,我们可以指定模型是仅使用上下文中的信息,还是也使用其在训练过程中学习到的知识。
仅使用上下文进行聊天:
res = ollama.chat(
    model="phi3",
    messages=[
        {"role": "system", "content": "Give the most accurate answer using only the following information:"},
        {"role": "user", "content": query}
    ],
    stream=True
)
print(res["message"]["content"])
输出示例:
The total recognized revenue for fiscal year 2024 was $60.9 billion, which represents an increase of 126% from the previous year. The breakdown by category in millions of dollars is as follows:
- Data Center: $47,525 million
- Gaming: $10,447 million
- Professional Visualization: $1,553 million
- Automotive: $1,091 million
- OEM and Other: $306 million
结合知识和上下文进行聊天:
res = ollama.chat(
    model="phi3",
    messages=[
        {"role": "system", "content": "Give the most accurate answer using your knowledge and the following information:"},
        {"role": "user", "content": query}
    ],
    stream=True
)
print(res["message"]["content"])
输出示例:
The total recognized revenue for fiscal year 2024 was $60,922 million (or $60.9 billion when expressed in billions). This amount represents an increase of 126% from the previous year's revenue. Additionally, there is a breakdown by product categories as follows:
- Data Center: $47,525 million
- Gaming: $10,447 million
- Professional Visualization: $1,553 million
- Automotive: $1,091 million
- OEM and Other: $306 million

It's also important to note that there are deferred revenue amounts of $233 million in fiscal 2024 and $35 million in fiscal 2023 related to customer advances, which will be recognized as revenue over future periods. The remaining performance obligations account for approximately $1.1 billion, with an expectation that about 40% of this amount will be recognized within the next twelve months.
数据库设置完成并运行良好。接下来,我们可以构建聊天机器人应用程序以执行RAG,或者更简单地说,回答有关我们文档的问题。
5. 前端
如今,Streamlit是构建快速Web应用程序最常用的Python库,因为它通过其流式功能简化了NLP应用程序的开发。
首先,定义布局:我的屏幕应有一个侧边栏,用户可以在其中查看聊天历史记录。
import streamlit as st #1.35.0

## 布局
st.title("Write your questions")
st.sidebar.title("Chat History")
app = st.session_state
if 'messages' not in app:
    app['messages'] = [{"role": "assistant", "content": "I'm ready to retrieve information"}]
if 'history' not in app:
    app['history'] = []
if 'full_response' not in app:
    app['full_response'] = ''
应用程序对象(或会话状态)是一个具有以下结构的字典:
{
    'history': [
        ': how much is the revenue?',
        ': The total revenue reported in the given information is 60 million'
    ],
    'messages': [
        {'role': 'assistant', 'content': 'I'm ready to retrieve information'},
        {'role': 'user', 'content': 'how much is the revenue?'},
        {'role': 'assistant', 'content': 'The total revenue reported in the given information is 60 million'}
    ],
    'full_response': 'The total revenue reported in the given information is 60 million'
}
如果不想聊天中的消息消失,请添加以下代码:
## 保持消息在聊天中
for msg in app["messages"]:
    if msg["role"] == "user":
        st.chat_message(msg["role"], avatar="🧑").write(msg["content"])
    elif msg["role"] == "assistant":
        st.chat_message(msg["role"], avatar="🤖").write(msg["content"])
接下来,必须编写聊天核心:用户的问题将被添加到消息列表中,传递给AI,应用程序将流式传输响应。
## 聊天
if txt := st.chat_input():
    ### 用户写入
    app["messages"].append({"role": "user", "content": txt})
    st.chat_message("user", avatar="🧑").write(txt)
    ### AI 使用聊天流式响应
    app["full_response"] = ""
    with st.chat_message("assistant", avatar="🤖"):
        for chunk in ai.respond(app["messages"], use_knowledge=True):
            app["full_response"] += chunk
            st.write(chunk)
    ### 显示历史记录
    app['history'].append(": " + txt)
    app['history'].append(": " + app["full_response"])
    st.sidebar.markdown("<br />".join(app['history']) + "<br /><br />", unsafe_allow_html=True)
在用户输入消息后,AI将调用 respond 函数,该函数将查询数据库并使用LLM生成响应。
6. 后端
后端部分我们已经熟悉,只需将其放入一个类中即可。以下是需要强调的几个要点:
- 通过在ChromaDB中调用集合名称,如果集合已经存在,数据库将“获取”而不是“创建”一个新集合。
- Ollama聊天函数的
stream参数应设置为True,以返回文本块而不是完整响应。 - 将整个聊天历史记录作为输入传递给LLM,以便它能够理解对先前消息的引用。
import chromadb #0.5.0
import ollama #0.5.0

class AI:
    def __init__(self):
        db = chromadb.PersistentClient()
        self.collection = db.get_or_create_collection("nvidia")

    def query(self, q, top=10):
        res_db = self.collection.query(query_texts=[q])["documents"][0][0:top]
        context = ' '.join(res_db).replace("\n", " ")
        return context

    def respond(self, lst_messages, use_knowledge=False):
        q = lst_messages[-1]["content"]
        context = self.query(q)
        if use_knowledge:
            prompt = "Give the most accurate answer using your knowledge and the following information:"
        else:
            prompt = "Give the most accurate answer using only the following information:"
        res_ai = ollama.chat(
            model="phi3",
            messages=[
                {"role": "system", "content": prompt},
                *lst_messages
            ],
            stream=True
        )
        for res in res_ai:
            chunk = res["message"]["content"]
            app["full_response"] += chunk
            yield chunk

ai = AI()
要运行Streamlit应用程序,必须使用以下命令:
streamlit run rag_app.py
7. 运行示例
以下是该应用程序的运行示例:
用户输入: “how much is the revenue?”
AI响应:
The total reported revenue for fiscal year 2024 was 60,922 million. This represents an increase of 126% from a year ago. Additionally, there is a breakdown by product categories as follows:
- Data Center: 47,525 million
- Gaming: 10,447 million
- Professional Visualization: 1,553 million
- Automotive: 1,091 million
- OEM and Other: 306 million
用户输入: “how did they make it?”
AI响应:
NVIDIA achieved the reported revenue through a combination of factors, including:
- **Data Center Revenue Growth**: The Data Center segment saw a significant increase of 217%, driven by strong demand from enterprise software and consumer internet applications, as well as various industry verticals such as automotive, financial services, and healthcare. Customers access NVIDIA AI infrastructure both through the cloud and on-premises, with Data Center compute revenue growing by 244% and Networking revenue by 133%.
- **Gaming Revenue Increase**: Gaming revenue rose by 15%, reflecting higher sales to partners following the normalization of channel inventory levels and growing demand.
- **Professional Visualization and Automotive Revenue**: These segments also saw growth, with Professional Visualization revenue increasing by 1% and Automotive revenue by 21%, primarily due to growth in self-driving platforms.
- **Gross Margin Improvement**: Gross margin increased due to the growth in Data Center revenue and lower net inventory provisions as a percentage of revenue.
- **Operating Expenses**: Operating expenses increased due to the growth in employees and compensation increases.
用户输入: “What is the significance of their Data Center revenue growth?”
AI响应:
The significant increase in Data Center revenue, up 217% from the previous year, highlights NVIDIA's growing dominance in the AI and data center markets. This growth is driven by several factors:
- **Enterprise Demand**: Strong demand from enterprise customers for AI infrastructure to support applications such as machine learning, data analytics, and cloud computing.
- **Diverse Industry Verticals**: The adoption of NVIDIA's AI solutions across various industries, including automotive, financial services, and healthcare, indicates a broad-based demand for AI capabilities.
- **Cloud and On-Premises**: The ability to serve customers through both cloud-based and on-premises solutions provides flexibility and meets different customer needs.
- **Compute and Networking**: The substantial growth in both Data Center compute revenue (up 244%) and Networking revenue (up 133%) underscores the importance of NVIDIA's comprehensive AI platform, which includes both hardware and software components.
用户输入: “What challenges did they face in the Automotive segment?”
AI响应:
While the Automotive revenue increased by 21%, the document does not explicitly list specific challenges faced in this segment. However, potential challenges in the automotive industry for NVIDIA could include:
- **Market Competition**: Intense competition from other technology companies and traditional automotive suppliers in the autonomous driving and AI solutions space.
- **Regulatory Hurdles**: Navigating the complex regulatory landscape for autonomous vehicles and AI technologies.
- **Technological Development**: The need to continuously innovate and improve AI algorithms and hardware to meet the demanding requirements of the automotive industry.
- **Supply Chain Issues**: Potential disruptions in the supply chain for critical components needed for NVIDIA's automotive solutions.
用户输入: “What is NVIDIA’s strategy for future growth?”
AI响应:
NVIDIA's strategy for future growth is likely to focus on several key areas:
- **Continued Expansion in Data Center**: Leveraging the strong growth in the Data Center segment by expanding its AI infrastructure offerings and targeting new industries and applications.
- **Gaming Market**: Maintaining and growing its presence in the gaming market by continuing to innovate and meet the demands of gamers and developers.
- **Professional Visualization**: Further developing its professional visualization solutions to support industries such as architecture, engineering, and design.
- **Automotive Innovation**: Investing in research and development to advance its autonomous driving and AI technologies for the automotive industry.
- **Sustainability**: Focusing on sustainability initiatives, such as increasing the use of renewable energy and setting science-based targets for emissions reductions.
- **Strategic Partnerships**: Forming strategic partnerships with other companies to expand its reach and capabilities in various markets.
8. 结论
本文展示了如何使用Python和大型语言模型构建一个检索增强生成(RAG)系统。通过以下步骤,我们成功构建了一个能够从多模态文档中学习知识并回答问题的AI应用程序:
- 数据预处理: 将PDF文档转换为图像,并使用OCR提取文本。然后,利用LLM对文本、表格、图像和图表进行预处理和增强。
- 数据库存储: 将预处理后的数据存储在ChromaDB向量数据库中,以便高效存储、索引和搜索。
- 后端开发: 使用Ollama和ChromaDB构建后端逻辑,处理用户查询并生成响应。
- 前端构建: 使用Streamlit构建用户友好的界面,允许用户与AI进行交互。
该系统展示了如何利用LLM和多模态数据构建一个强大的AI应用程序,即使在普通笔记本电脑上也能高效运行。该方法具有以下优势:
- 隐私和安全: 数据保留在本地,无需上传到第三方服务器。
- 灵活性: 可以处理各种类型的数据,包括文本、表格、图像和图表。
- 可扩展性: 可以根据需要扩展数据库和应用程序功能。
如何学习大模型
现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。
作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。
下面这些都是我当初辛苦整理和花钱购买的资料,现在我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。

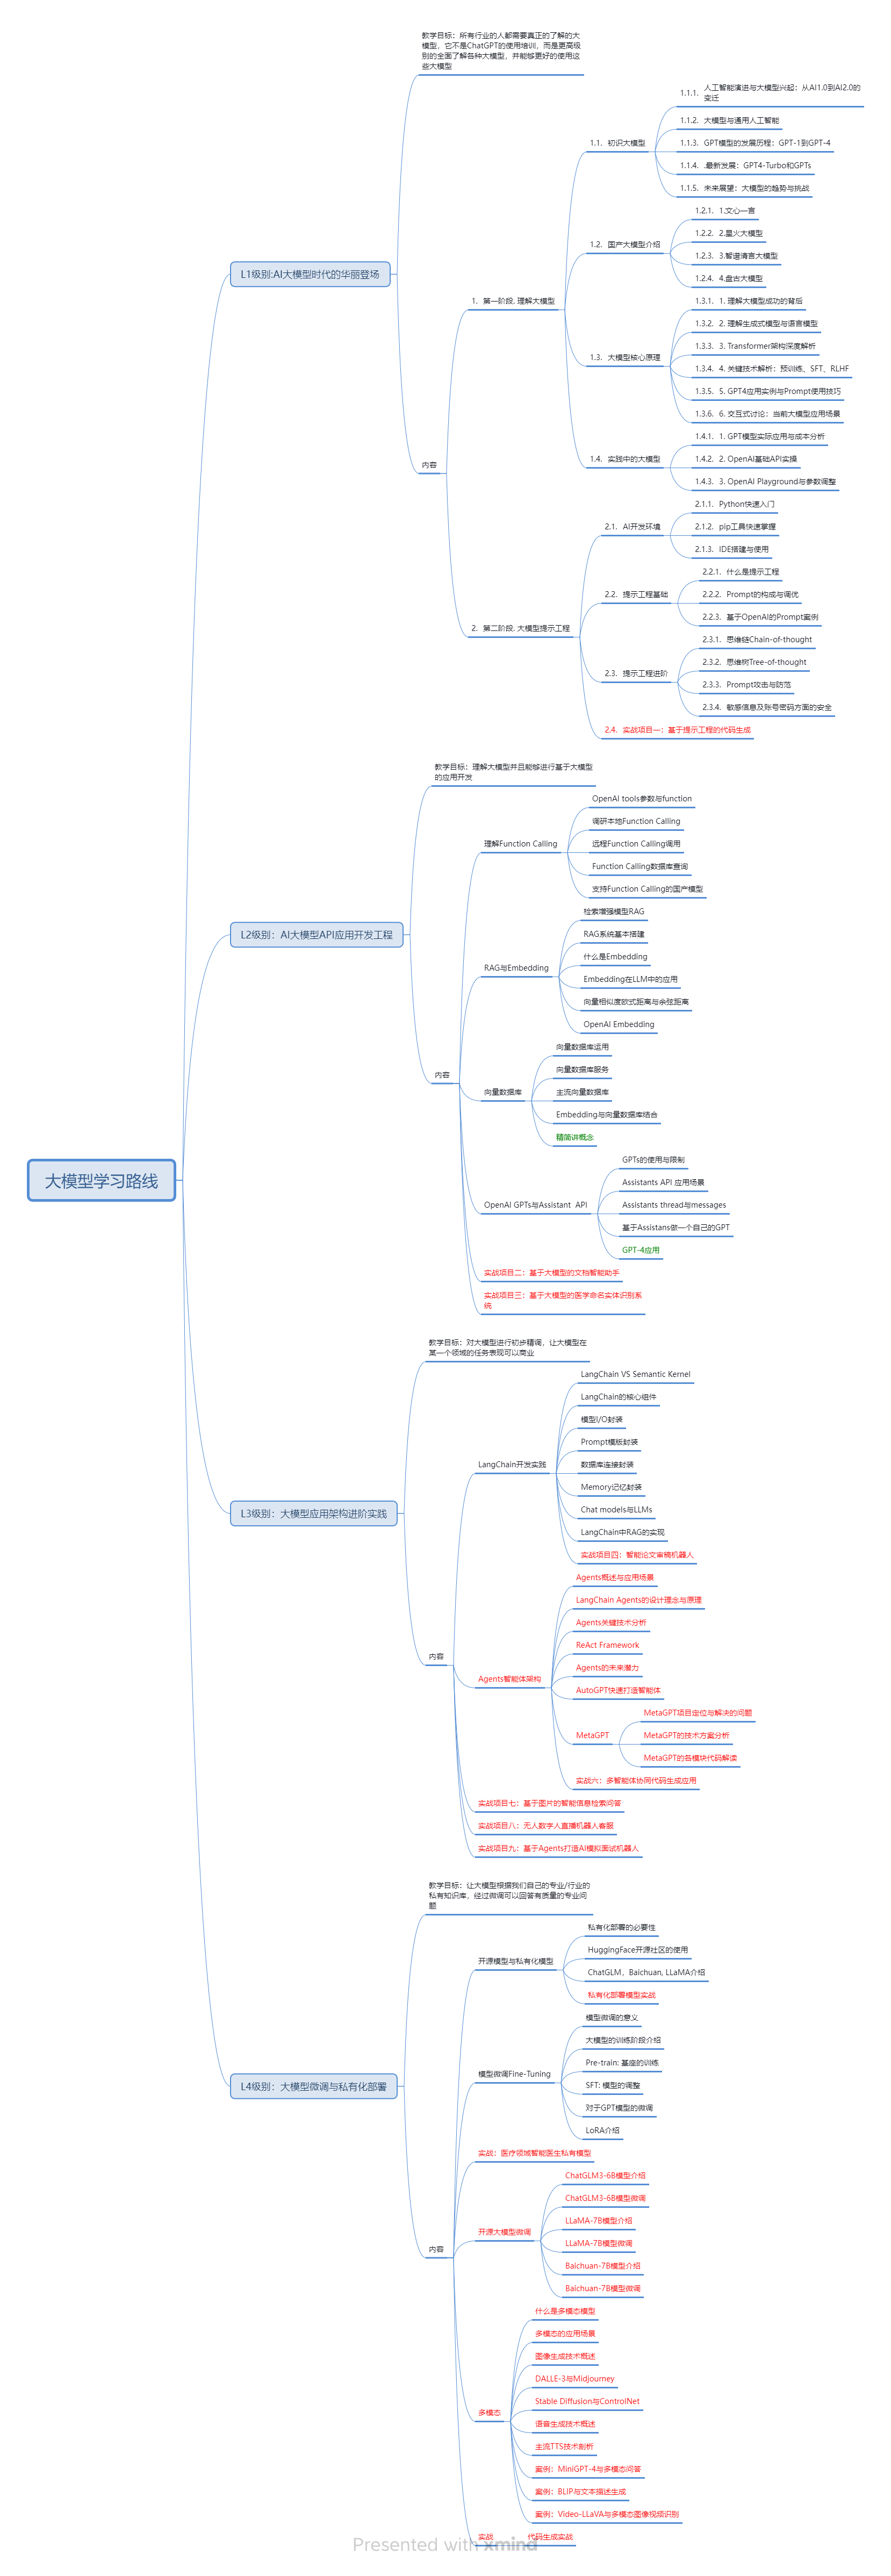
一、AGI大模型系统学习路线
很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。
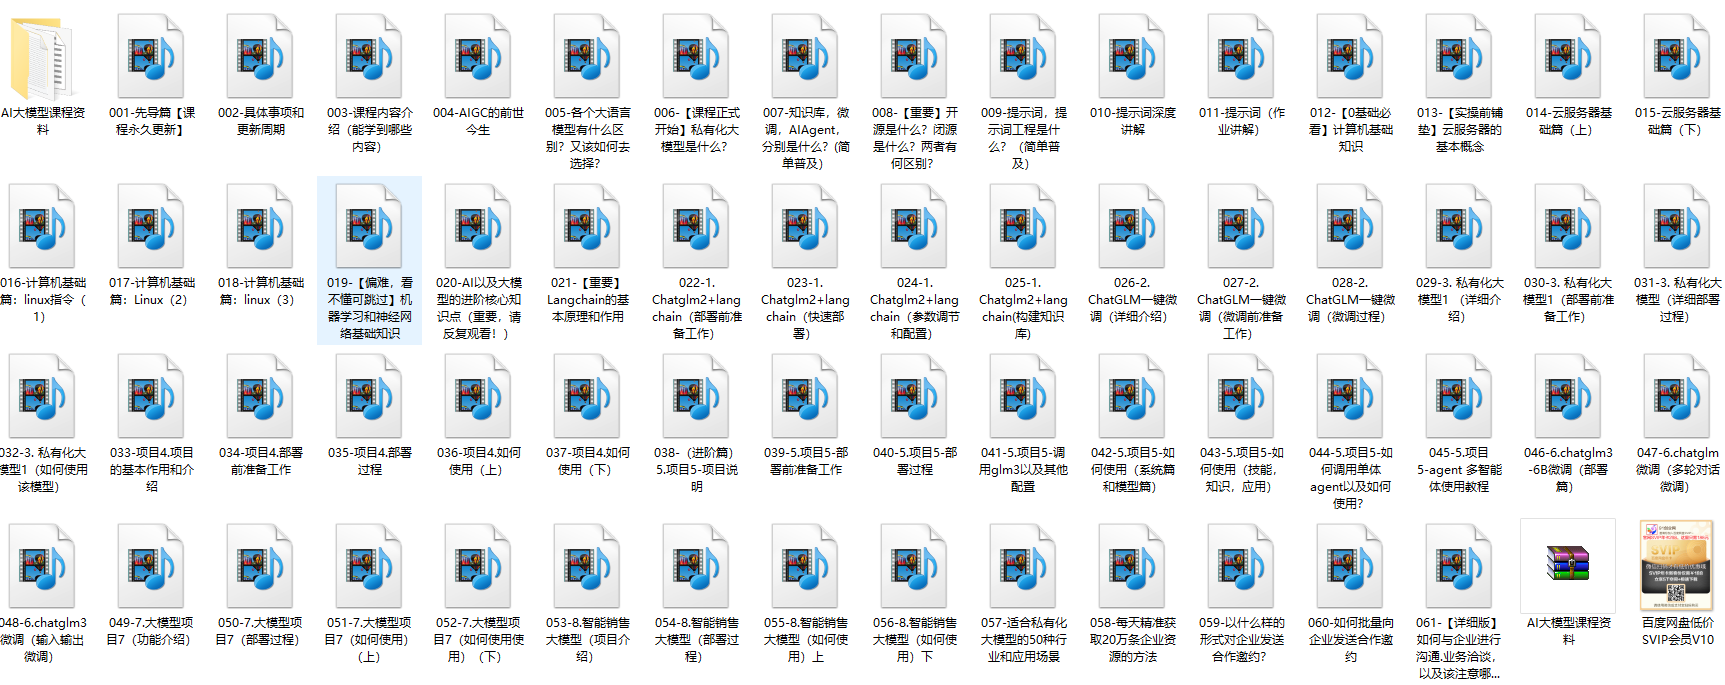
二、AI大模型视频教程
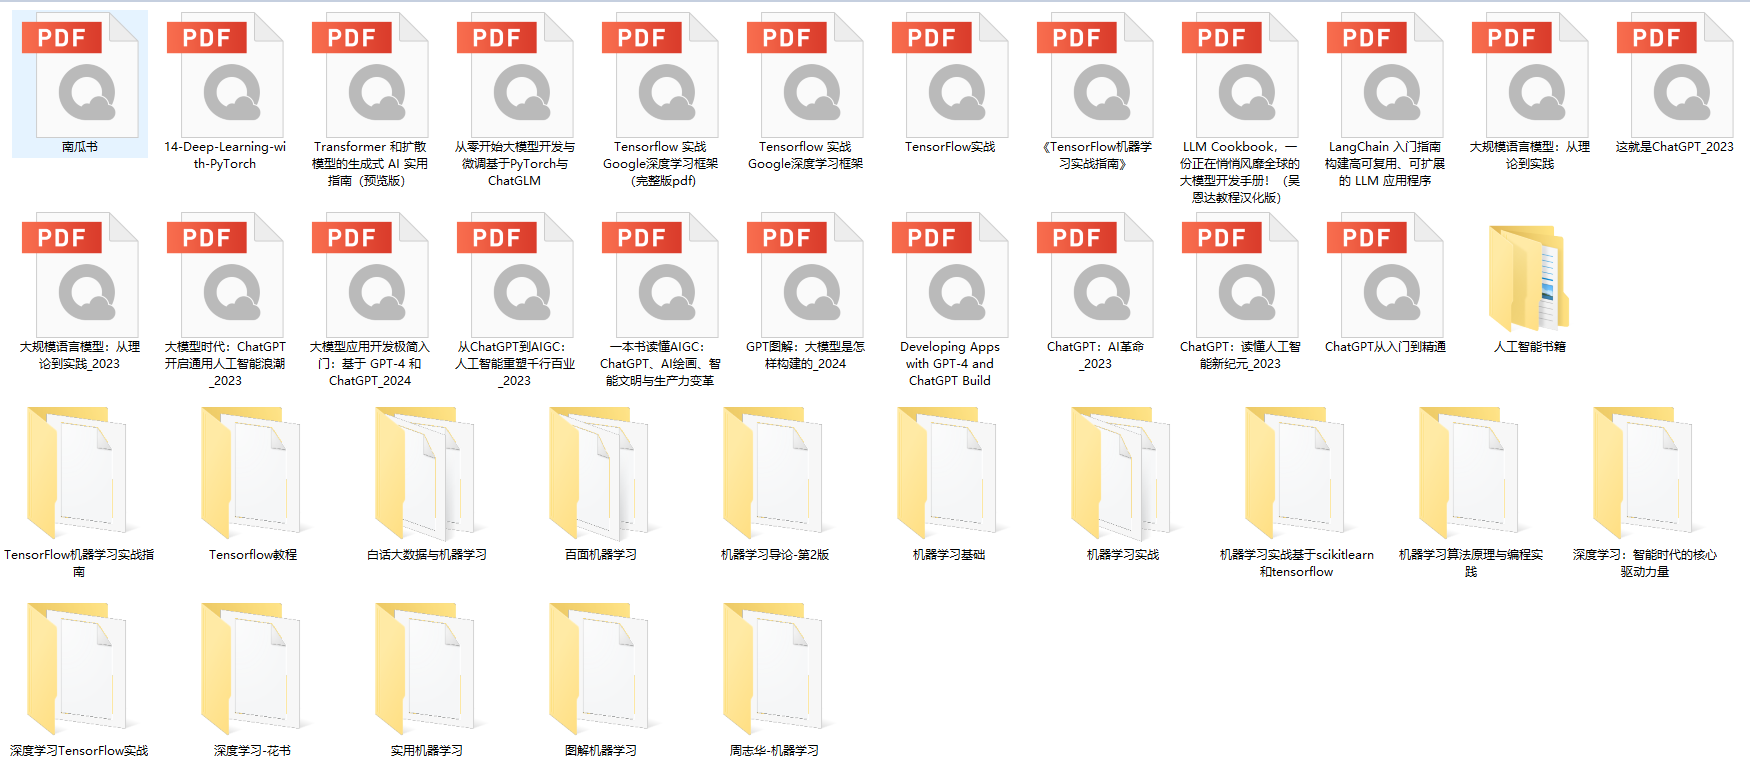
三、AI大模型各大学习书籍
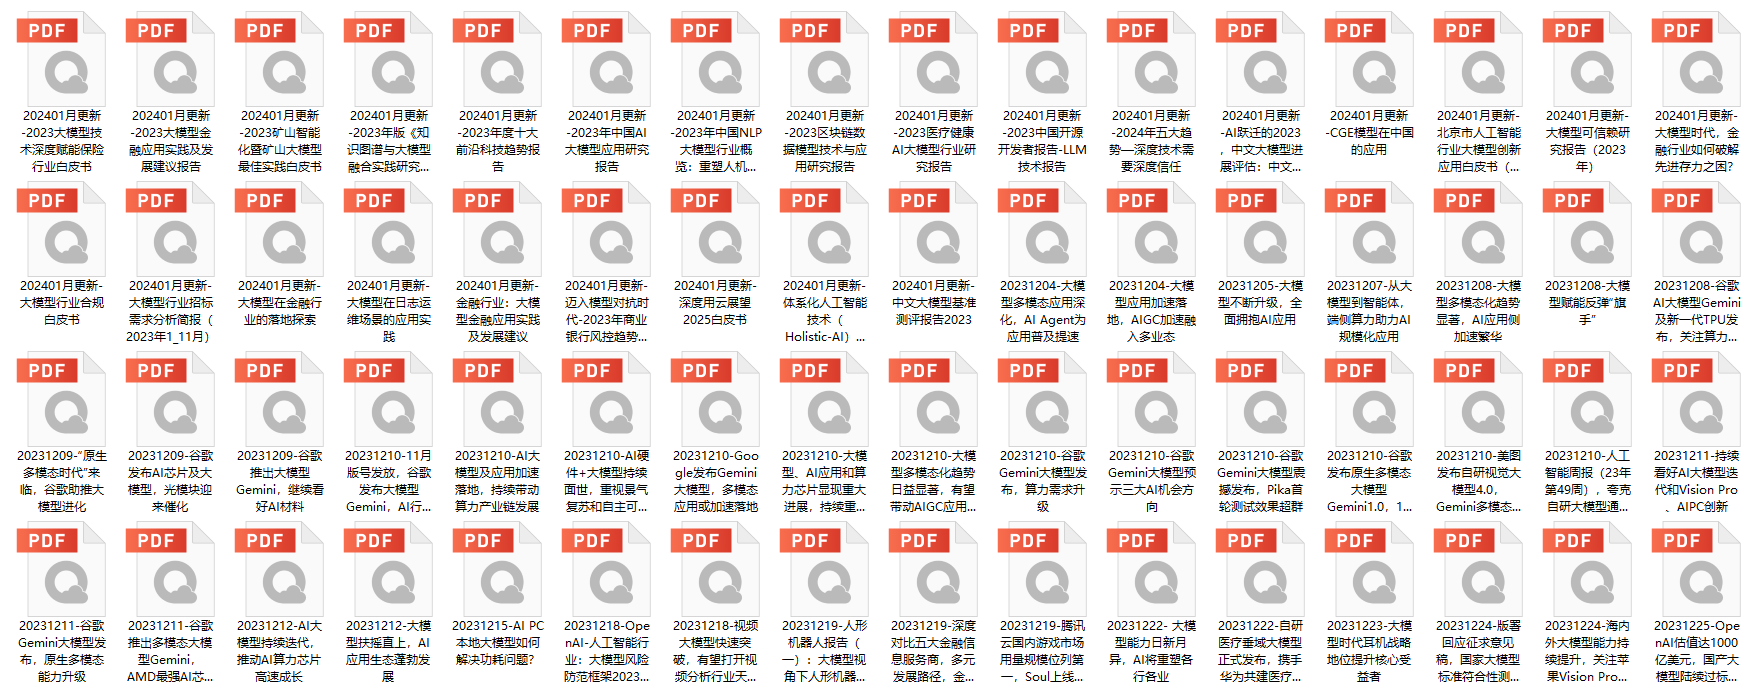
四、AI大模型各大场景实战案例
五、结束语
学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。
再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。
因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。
 1350


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


