小白学NLP:BERT知识表示、训练和压缩

Bert模型详解和训练实例 前面已经介绍了transformer,理解了transformer,那么理解bert就简单多了。对transformer不是很了解的可以跳转到https://blog.youkuaiyun.com/one_super_dreamer/article/details/105181690 Bert简介 BERT来自Google的论文Pre-training of Deep Bidirectional Tran... 阅读详情

基于Transformer的NLP模型现在广泛应用,但我们对它们的内部工作原理仍然知之甚少。

本篇论文的内容包括:

  • BERT模型的原理和预训练
  • BERT模型适用场景和
  • BERT模型分支、压缩和改进方向

BERT模型介绍

BERT是一堆Transformer编码器组成。对于序列中的每个输入,每个头计算键、值和查询向量,用于创建加权表示。同一层中所有头的输出通过一个全连接层运行合并。

原始BERT的训练流程包括两个阶段:预训练和微调。预训练使用两个自监督任务:masked language modeling(MLM,随机屏蔽输入的预测)和next sentence prediction(NSP,预测两个输入句子是否彼此相邻)。在对下游任务进行微调时,通常会在最终编码器层之上添加一个或多个全连接层。

BERT首先将给输入通过wordpieces进行处理,然后将三个嵌入层(标记、位置和段)获得固定长度的向量。特殊标记[CLS]用于预测分类,[SEP]分隔输入输入段。原始BERT有两个版本:base 和 large,分别在层数、隐藏层大小和注意力头数上存在差异。

BERT「掌握」的知识

语法知识

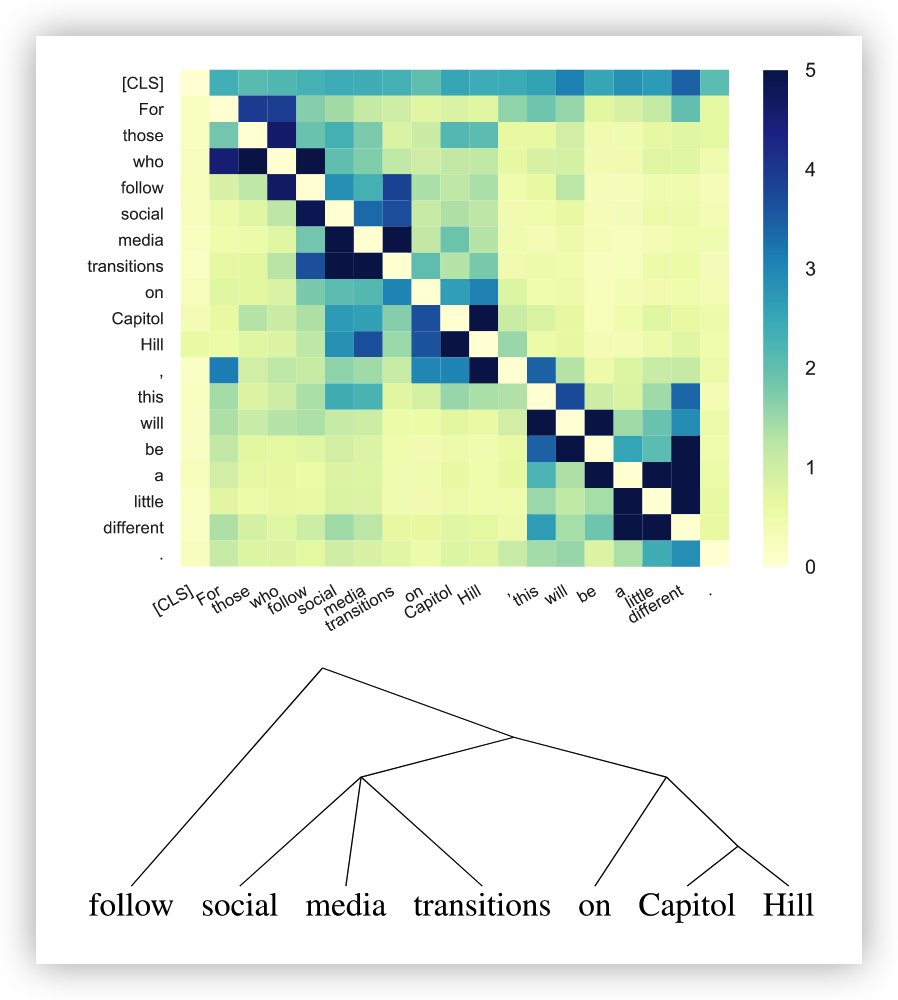
研究表明BERT表示是分层的而不是线性的,除了词序信息之外还有类似于句法树结构的知识。

句法结构似乎并没有直接编码在自注意力权重中,但它们可以从token的表示恢复出来。
图片

BERT对格式错误的输入不敏感,即使打乱词序、截断句子、删除主语和宾语,它的预测也没有改变。

语义知识

BERT能够做出正确的MLM预测,则不是简单的填写单词。BERT可以捕获实体、关系和角色等信息。

BERT很难表示数值,并且很难从训练数据中泛化。其中的一个原因,可能是wordpieces将数字进行了拆分。

通用知识

BERT通过MLM可以进行预测,并比常规的方法行囊够更好。但BERT不能直接用于逻辑推理。

BERT模型训练

Pre-training BERT

原始的 BERT是在两个任务进行预训练:下一句预测 (NSP) 和掩码语言模型 (MLM)。有多项研究对预训练任务进行了改进:

  • How to mask

    • with corruption rate and corrupted span length
    • diverse masks for training examples within an epoch
    • replace the MASK token with [UNK] token
  • What to mask

    • applied to full words instead of word-pieces
    • mask spans rather than single tokens
    • mask phrases and named entities
  • Where to mask

    • arbitrary text streams instead of sentence pairs
    • MLM with partially autoregressive LM
  • Alternatives to masking

    • deletion, infilling, sentence permutation and document rotation
    • predict whether a token is capitalized and whether it occurs in other segments of the same documen
    • train on different permutations of word order in the input sequence, maximizing the probability of the original word order
    • detects tokens that were replaced by a generator network rather than masked
  • NSP alternatives

    • remove NSP does not hurt or slightly improves performance
    • replace NSP with the task of predicting both the next and the previous sentences
    • replace the negative NSP examples by swapped sentences from positive examples
    • sentence reordering and sentence distance prediction

Fine-tuning BERT

预训练+微调是BERT的使用流程。前者是为了提供任务无关的知识,而后者教导模型学习对当前任务有用的表征。

有多项研究对微调进行了改进:

  • Taking more layers into account
  • Two-stage fine-tuning
  • Adversarial token perturbations
  • Adversarial regularization
  • Mixout regularization

BERT模型压缩

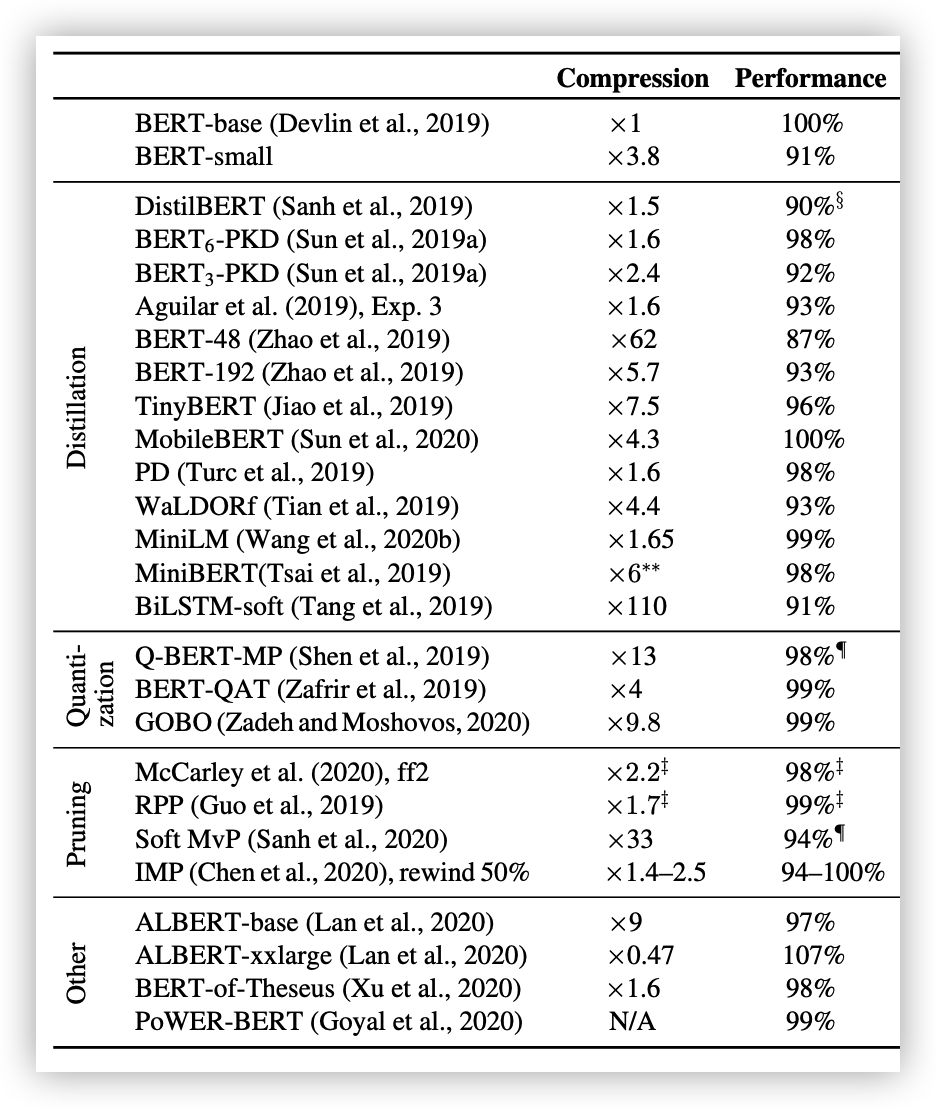
通过模型蒸馏、量化和剪枝,BERT模型可以在损失较少精度的同时获得成倍的加速。

具体的方法可以参考下表:
图片

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
bert中文分类模型训练+推理+部署 bert简介 阅读详情

相关推荐

NLP自然语言处理Bert大模型系列学习

本文介绍了BERT模型的几种主要变体及其代码实现,包括原始BERT、RoBERTa和ALBERT。原始BERT提供基础和大型版本,RoBERTa通过优化训练策略提升性能,ALBERT则采用参数共享技术降低资源消耗。文章提供了详细的PyTorch训练和推理代码示例,涵盖数据预处理、模型配置和预测流程,适用于文本分类任务。不同变体适用于不同场景,如RoBERTa适合性能优先的任务,ALBERT适合资源受限环境。

日常分享模型调优、Data Agent 搭建实操案例与行业技术思考,记录从数据预处理到智能体迭代的完整实践。沉心打磨可落地的算法方案,输出干货向技术内容,与同好一同探索数据智能与大模型进阶路径。 1503

Pytorch——BERT 预训练模型及文本分类(情感分类)

BERT 预训练模型及文本分类 介绍 如果你关注自然语言处理技术的发展,那你一定听说过 BERT,它的诞生对自然语言处理领域具有着里程碑式的意义。本次试验将介绍 BERT 的模型结构,以及将其应用于文本分类实践。 知识点 语言模型和词向量 BERT 结构详解 BERT 文本分类 BERT全称为 Bidirectional Encoder Representations from Transformer,是谷歌在 2018 年 10 月发布的语言表示模型。BERT 通过维基百科和书籍语料组成的庞.

ASS-ASH的博客 4万+

人类语言处理nlp部分笔记——二、BERT和它的家族-介绍和微调

这里所说的pre-train model是输入一串tokens,能够输出一串vectors,且每个vector可以表示对应的语义的模型,这些vectors也被称作为embeddings。以前常用的模型有word2vec,Glove等,这里并没有详细介绍,之后需要单独去看,由于英文单词太多了,只要来一个新单词,整个embedding的模型就需要重新train,为了解决这个问题,有了fasttext。

a_blade_of_grass的博客 1564

BERT 详解

BERT全称为,是Google以无监督的方式利用大量无标注文本「炼成」的语言模型,其架构为Transformer中的Encoder(BERT=EncoderofTransformer)以往为了解决不同的NLP任务,我们会为该任务设计一个最合适的神经网络架构并做训练,以下是一些简单的例子不同的NLP任务通常需要不同的模型,而设计这些模型并测试其performance是非常耗成本的(人力,时间,计算资源)。如果有一个能直接处理各式NLP任务的通用架构该有多好?......

Zheng_LH 2008

BERT模型:自然语言处理最新里程碑完整详解!

全文共7055字,预计学习时长14分钟 BERT全称是来自变换器的双向编码器表征量(Bidirectional Encoder Representations from Transformers),它是Google于2018年末开发并发布的一种新型语言模型。与BERT模型相似的预训练语言模型例如问答、命名实体识别、自然语言推理、文本分类等在许多自然语言处理任务中发挥着重要作用。 BERT是...

读芯术的博客 3066

BERT系列算法解读

从而提高模型在SQuAD、MNLI和SST-2数据集上的性能。总的来看,这些优化措施显著增强了模型的表现。

qq_52053775的博客 2029

【NLP自然语言处理】NLP中的常用预训练AI模型

在自然语言处理(NLP)领域,预训练AI模型已成为推动技术发展的重要力量。这些模型通过在大量数据集上进行预先训练,学习到了语言的通用特征或知识表示,进而可以应用于各种具体的NLP任务。

2301_76820214的博客 1070

深入详解自然语言处理(NLP)中的语言模型:BERT、GPT及其他预训练模型的原理与应用

【自然语言处理】——深入详解自然语言处理(NLP)中的语言模型:BERT、GPT及其他预训练模型的原理与应用

编程技术探索者,分享C/C++、C#、Java、数据库等开发经验,聚焦实战技巧与AI兴趣,助力编程爱好者成长。 2152

NLP发展大事记:顶会,预训练大模型,BERT系列

NLP发展历程中的重要时间线,新手入门NLP顶会,BERT系列~

u012744245的博客 3820

BERT的结构,并展示如何利用预训练的BERT模型进行自然语言处理任务的建模 BERT Explained: Stateoftheart Pretraining for NLP

BERT(Bidirectional Encoder Representations from Transformers)是一种基于Transformer的预训练语言模型,其通过构建一个双向上下文编码器对文本进行建模。在最近几年里,BERT在许多自然语言处理任务上取得了最先进的结果。它已经成为许多领域最流行的预训练模型之一,包括命名实体识别、情感分析、文本分类、问答系统等。本教程将详细阐述BERT的结构,并展示如何利用预训练的BERT模型进行自然语言处理任务的建模。

AI天才研究院 1178

自然语言处理之语言模型:BERT:BERT的变种与最新进展

RoBERTa(Robustly Optimized BERT Pretraining Approach)是BERT的一个优化版本,由Facebook AI Research和Salesforce共同开发。动态掩码:RoBERTa在预训练时,每次迭代都重新生成掩码,而不是像BERT那样在数据集加载时就固定掩码。这增加了模型训练的多样性,有助于模型学习更丰富的语言结构。无NSP任务。

zhubeibei168的博客 801

【机器学习】—机器学习和NLP预训练模型探索之旅

随着数据量的增加和计算能力的提升,机器学习和自然语言处理技术得到了飞速发展。预训练模型作为其中的重要组成部分,通过在大规模数据集上进行预训练,使得模型可以捕捉到丰富的语义信息,从而在下游任务中表现出色。

小李很执着的博客 4557

【nlp】4.3 nlp中常用的预训练模型(BERT及其变体)

对常用的nlp常用的预训练模型进行介绍

lys_828的博客 1399

掌握 BERT:自然语言处理 (NLP) 从初级到高级的综合指南(2)

文本摘要涉及将较长文本的精髓提炼成较短的版本,同时保留其核心含义。尽管 BERT 不是专门为此构建的,但它仍然可以通过提供原始文本并使用它提供的上下文理解生成简洁的摘要来有效地使用。在这篇博文中,我们踏上了 BERT 变革世界的启发之旅——来自 Transformers 的双向编码器表示。从诞生到实际实施,我们已经了解了 BERT 对自然语言处理 (NLP) 及其他领域的影响。我们深入研究了在现实场景中使用 BERT 所带来的挑战,发现了解决处理长文本和管理计算资源等问题的策略。

python1234_的博客 1478

NLP自然语言处理:10篇关键论文精读

自然语言处理(Natural Language Processing,简称NLP)是人工智能领域的一个重要分支,它涉及到让计算机理解、解析和生成人类语言的技术。本章旨在为读者提供自然语言处理的基础知识,包括其核心概念、历史背景以及目前广泛应用于产业界和研究中的技术。自生成模型,是一种先进的机器学习模型,能够在给定文本数据的条件下,生成高度连贯且语义上合理的文本输出。

weixin_34268462的博客 2143

Tesseract OCR识别不准?手把手教你用PyAutoGUI提升自动点击脚本的准确率

本文针对Tesseract OCR在屏幕自动化中识别不准的问题,提供了一套完整的优化方案。通过PyAutoGUI精准截图、结合PIL和OpenCV进行图像预处理(如灰度化、对比度增强、自适应二值化),并调优Tesseract参数(如PSM模式、白名单),显著提升文本识别准确率。文章还介绍了结合模板匹配、构建容错循环等进阶技巧,帮助开发者打造高可靠性的自动点击脚本。

weixin_29093017的博客 544

NLP(七十三)从BERT模型训练到量化、蒸馏之路

本文将会介绍笔者从BERT模型训练到模型量化、蒸馏的旅程,通过一系列文章的回顾,不难掌握模型训练和模型压缩的技能。

山阴少年 899

Unity Shader学习笔记/Urp/水墨风效果

Unity Shader学习

qq_63133691的博客 2119

什么是量化?BERT 模型压缩的秘密武器

本文探讨了 BERT 量化的多种精度补偿策略,如量化感知训练、知识蒸馏辅助量化、混合精度训练以及优化量化算法和参数。实验表明,这些策略能不同程度缓解精度损失问题,单独用量化感知训练模型变小、推理加速但精度下降,结合知识蒸馏或优化量化算法可改善精度,多种策略综合运用能使量化 BERT 模型保持压缩和加速优势且性能接近原始模型。​

紫雾凌寒 1816

信息安全管理与评估赛题解析-单机取证(含环境)

链接:https://pan.baidu.com/s/1OMzIq884dW2vAiUp0k2Ppg。链接:https://pan.baidu.com/s/1i5daMqhD53wYeQ6hYzRK6Q。链接:https://pan.baidu.com/s/1QFAjdQZK4sJ-gGRP42XPKA。链接:https://pan.baidu.com/s/1BSXvqN2ZGCQXewgFULoeyQ。链接:https://pan.baidu.com/s/1g9zu5ngBz_KMjW1eBMkJAw。

Brucye 1835

Centos7 yum 报错「Errno 256」No more mirrors to try 解决方法

首先该问题的出现是由于网络的震荡导致,这是重点。(1)将源更换成阿里云的官方源,步骤参考如上(2)同时将zabbix的官方源更换成阿里云里面的zabbix镜像源,因为zabbix官方源根本网络不通,因为国家防火墙的拦截,导致网络不通。这是阿里源的zabbix镜像地址: https://mirrors.aliyun.com/zabbix/zabbix/4.4/rhel/7/修改系统中早期生成的zabbix.repo文件,如下:主要是把baseurl替换成阿里云的zabbix镜像地址即可。

专注基础架构领域 3876

2019: 属于BERT预训练语言模型之年

点击上方,选择星标或置顶,每天给你送干货!阅读大概需要20分钟跟随小博主,每天进步一丢丢来自:专知公众号【导读】2019年对NLP来说是具有里程碑意义的一年,从阅读理解到情绪分析,各种重...

zenRRan的博客 1121

EMC诊断技术及电磁兼容理论设计

本文深入探讨了EMC诊断技术,重点在于滤波篇,详细讲解了EMI滤波器的设计、选型、测试及应用注意事项。内容涵盖噪声限值法规、滤波器的法规依据、插入损耗测试以及滤波电容的高频特性。同时,还阐述了噪声源的近场与远场特性,如何快速定位和抑制噪声。通过实例分析,提供了滤波器件和辐射噪声抑制器件的选型策略。

让你爱上电路设计 2164
上一篇: 掌握 BERT:自然语言处理 (NLP) 从初级到高级的综合指南(2)
下一篇: 上交2024最新-《动手学大模型》实战教程及ppt分享!
我爱学大模型
博客等级 码龄3年 7883粉丝 687原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值