


工业智能化这个词被说了很多年,落到执行层面却常常含糊:到底做到哪一步算「智能」?买了视觉检测算不算?上了预测性维护算不算?做了个大屏看板算不算?
我试过一个更清楚的划分方式:按「智能覆盖的范围」分三段——点、线、面。它不只是概念,还能直接用来判断一个工厂现在处于什么位置、下一步该干什么。
第一段:点——工具化智能
特征是:一个模型对应一个场景。
视觉模型查表面缺陷,时序模型预测能耗,机理模型优化工艺参数。每一件事都做得不错,指标也能量化。
但这一段有个本质特点:人驱动模型。采什么数据、什么时候调用、结果怎么处置,全由人决定。智能是局部的、被动的、一次性的——它像一把更锋利的刀,握在谁手里、切什么、切完怎么处理,还是人的事。
绝大多数工厂的 AI 建设停在这一段,而且停得挺舒服:项目好立项(单点、好验收)、ROI 好算(省了多少人、提了多少良率)、出了事也好界定责任(模型只提供参考)。
但这一段的效率天花板很低。因为真实的损失不在单点精度上,而在点与点之间的传递上。
第二段:线——流程化 Agent
第二次跃迁的标志,是 AI 从「工具」变成「员工」——它开始具备感知、规划、工具调用能力,能在单一业务域内自主完成闭环。
举个具体的:设备维护 Agent。它可以自主读取振动频谱,诊断故障模式,查备件库存,生成维修工单。整个过程不需要人一条条指令,它自己走完了「感知—判断—行动」的链条。
这是质变。因为闭环意味着它开始承担流程责任,而不只是提供一个数字。人的角色从「操作者」变成「监督者」。
但请注意这一段的边界:这位员工还没走出自己的部门。
设备 Agent 走不出设备域,它查不到排产系统的停机窗口;质检 Agent 走不出质检域,它调不动采购系统去追溯供应商;能耗 Agent 走不出能耗域,它没法让生产调整班次。
每个域内都很顺,跨域就断。这就是为什么很多工厂做了三五个 Agent,整体效率提升却很有限——它们只是在各自的部门里变得更高效,部门之间的墙一点没动。
第三段:面——全域自主协同
第三次跃迁,是多个异构智能体跨业务边界协同,覆盖采购、生产、质检、设备、安全环保、仓储物流到销售的全流程。
还是那个缺陷料的场景,但换成第三段的版本:质检 Agent 发现来料缺陷率异常,自主联动采购 Agent 追溯供应商批次,联动生产 Agent 调整工艺窗口,联动仓储 Agent 冻结在库物料。全程无需人工逐环传递信息。
设备的版本:预测到轴承 72 小时后失效,仓储 Agent 自动核对备件并触发调拨,排产 Agent 挪出计划性停机窗口,维修工单自动生成并分配到有空的班组。
从「点」到「面」,真正的瓶颈就浮出来了。不在模型,而在两层割裂:模态割裂——数据散在图像、时序、文本各套管道里,缺统一语义底座;智能体割裂——各域 Agent 基于不同框架,缺统一协同编排。
一个残酷但有用的判断
大多数工厂现在的真实位置是:点做得不错,线刚刚开始,面还没影。而且最要命的是——它们在「线」的门口反复徘徊。
为什么卡在这儿?我观察有三个原因。
第一,域内闭环需要跨系统接口,这已经要动组织协调了;跨域协同要动的接口是它的三倍,还要跨部门定权责。很多项目在这一步被组织问题拖死,而不是技术问题。
第二,每上一个新 Agent,数据管道和集成接口都要重做一遍,成本随场景数量线性上升。做到第三个 Agent 时,团队已经疲了。
第三,也是心理层面的:域内闭环已经能看到成效,KPI 能交了,没人愿意再去啃跨域那块硬骨头。
那正确的动作顺序是什么
如果你认同这个三段划分,动作顺序其实是清楚的,而且是反直觉的:先建底座,再上场景。
不是先做三个 Agent 再想办法连起来,而是在做第一个或第二个 Agent 的时候,就把两件事立起来:统一的多模态语义层(让所有模态的数据能在同一个坐标系里对齐),统一的 Agent 注册与编排机制(让不同来源的 Agent 能互相发现、互相调用)。
这两件事做在前面,第三个、第五个、第十个场景的边际成本会递减——就像在操作系统上装应用,而不是每个应用自带一套操作系统。
做在后面呢?你会得到一堆各自很聪明、彼此不认识的 Agent,然后花更大的代价回头拆墙。
落到你身上
最后给三个自查问题,判断你的工厂在哪一段:
一,你的 AI 能不能自己走完一个完整闭环,而不需要人在中间点三次?不能,你在第一段。
二,你的 AI 能不能调用本部门以外的系统?不能,你在第二段,而且卡在门口。
三,你的两个不同厂商的 Agent,能不能在同一个目标下协作?能,你才真正踏入第三段。
三段路没有捷径可走,但顺序可以选对。选对顺序,你是在修一条能一直往上走的路;选错顺序,你是在给每一座孤岛修一条更漂亮的栈桥。
三个容易混淆的「伪第三段」
很多方案声称自己做到了全域协同,其实是三种伪形态,值得分清。
伪形态一:大屏协同。把所有系统的数据汇到一个驾驶舱,看着很全域。但数据是只读的,决策还是人在各个系统里分别做。这是「看的协同」,不是「做的协同」。判断方法:大屏上发现异常之后,处置动作是谁执行的?如果是人挨个系统去点,那就是伪的。
伪形态二:硬编码协同。两个 Agent 之间写了固定调用:质检发现异常就直接调采购的接口。这个在单场景下有效,但它不是编排,是点对点集成。加第三个 Agent、或者换一个厂商,全部要改代码。判断方法:新增一个 Agent 需要改多少行已有代码?需要改,就不是第三段。
伪形态三:一个超级 Agent 包打天下。把所有能力塞进一个巨大的 Agent 里,由它统一决策。看起来协同了,实际上放弃了异构协作的可能——第三方能力接不进来,某个模块升级要整体重训。判断方法:能不能用「买来的第三方 Agent」替换掉其中一个能力?不能,就是伪协同。
真第三段的标准只有一条:新 Agent 能在不改已有代码的前提下加入协作。这条标准很苛刻,但它是「基础设施」和「集成项目」的唯一分水岭。
写方案时把这条标准写进验收条款,你会发现很多听起来很美的方案会自动出局——这对项目是好事,早出局比上线后返工便宜得多。
再补一句关于人的感受:卡在第二段门口最消耗士气,因为团队已经尝到了闭环的甜头,却在跨域这一步反复碰壁。这时候公开地把「我们在第几段、下一步要通什么」讲清楚,比闷头硬推有用得多——人不怕难,怕的是不知道难在哪。
如何学习大模型 AI ?
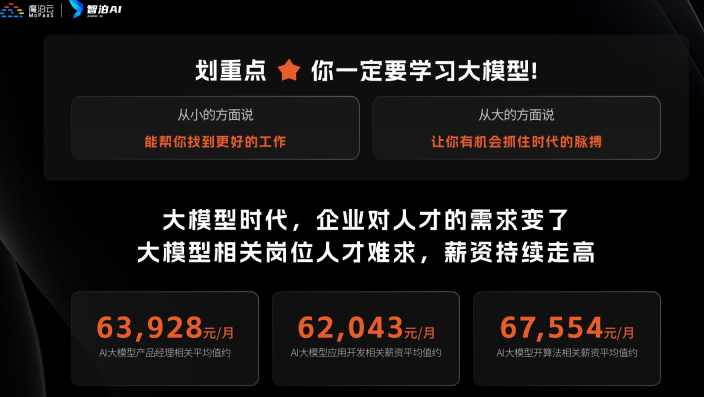
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。
我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

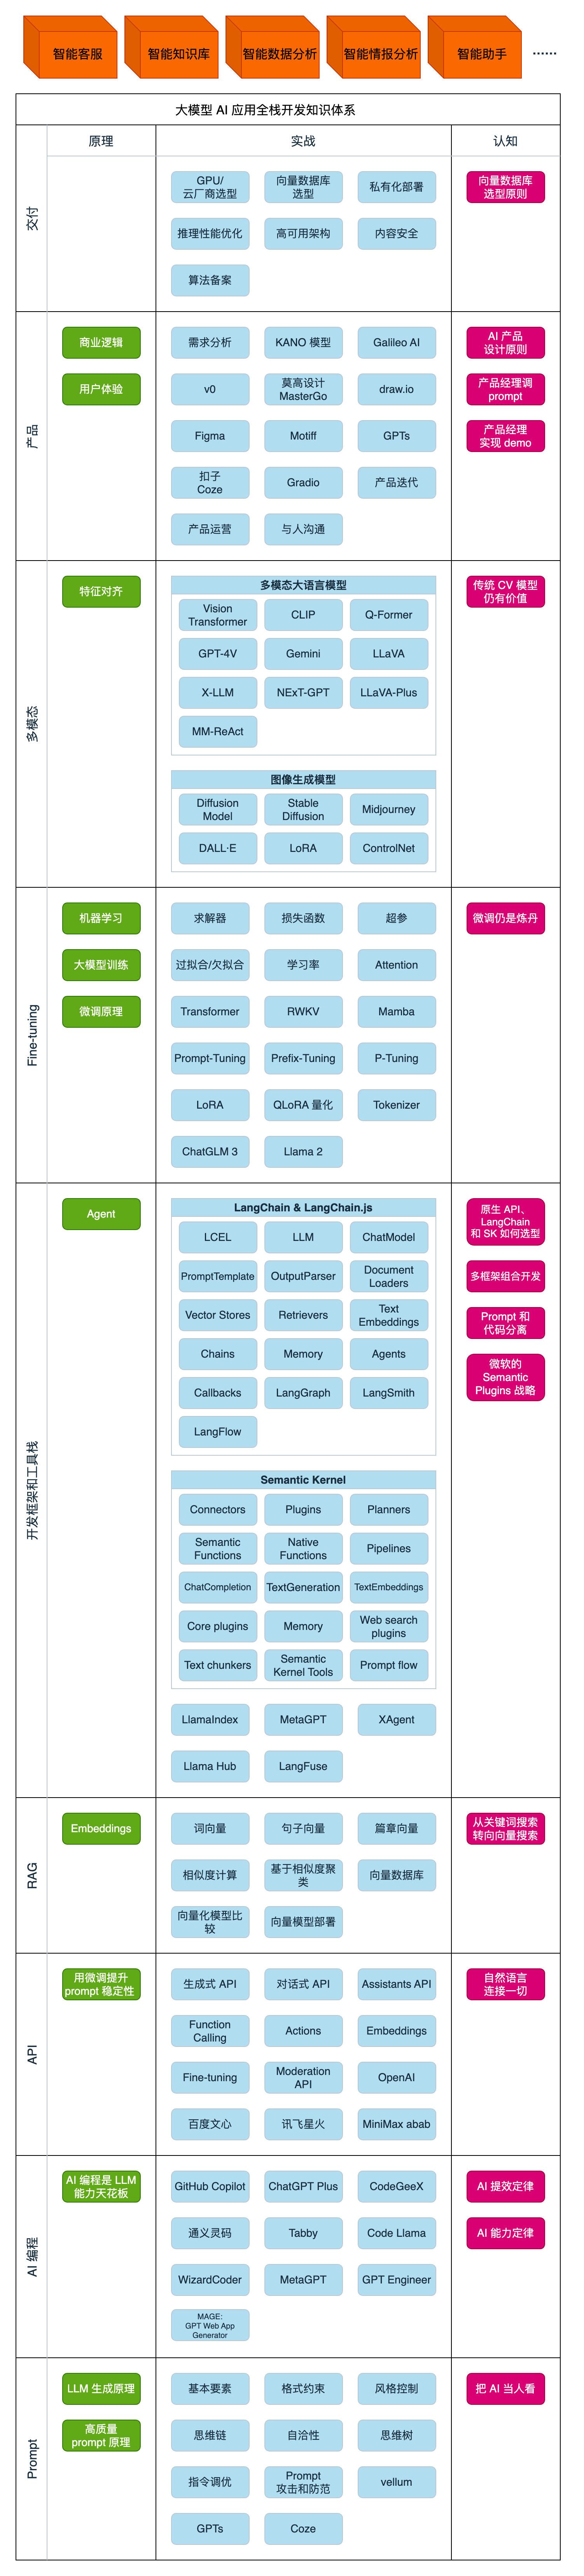
为什么要学习大模型?
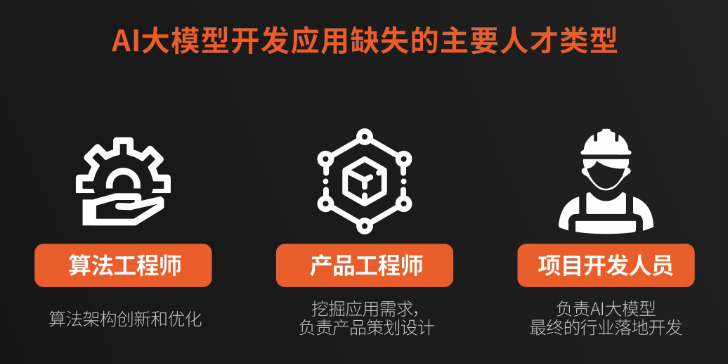
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
大模型入门到实战全套学习大礼包
1、大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
2、大模型学习书籍&文档
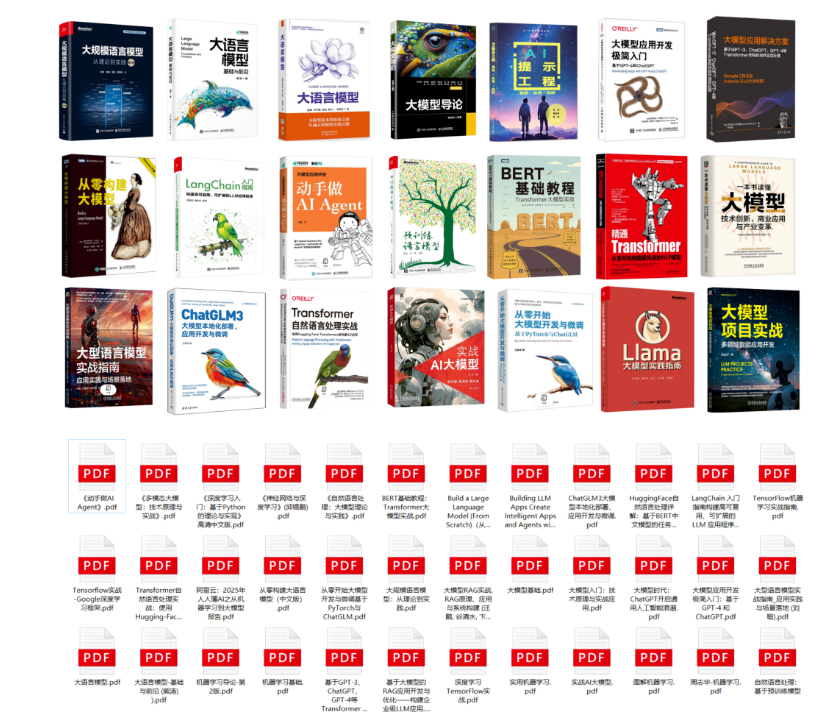
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
3、AI大模型最新行业报告
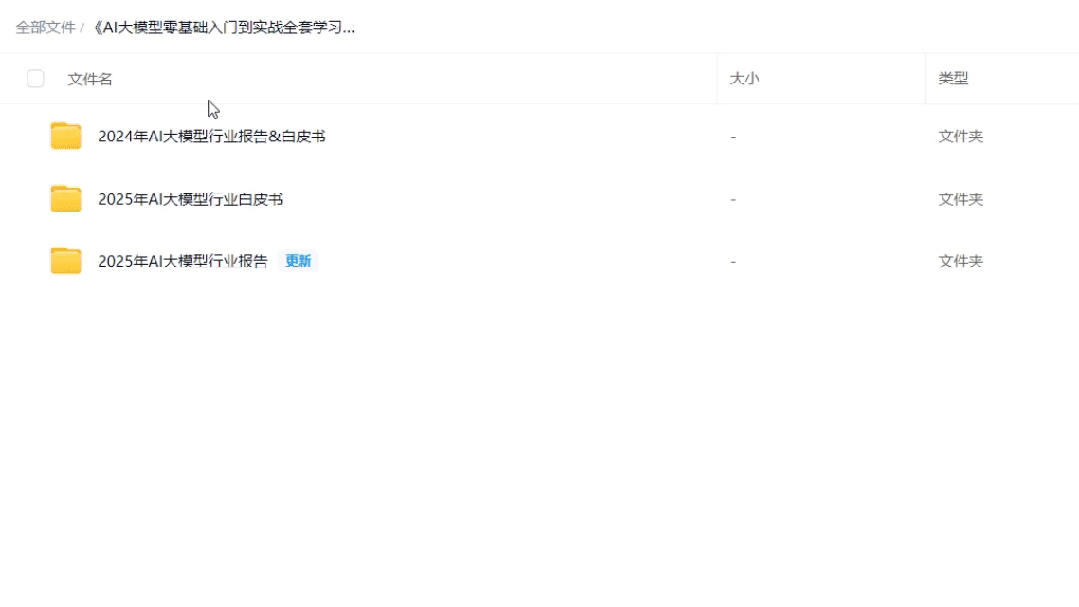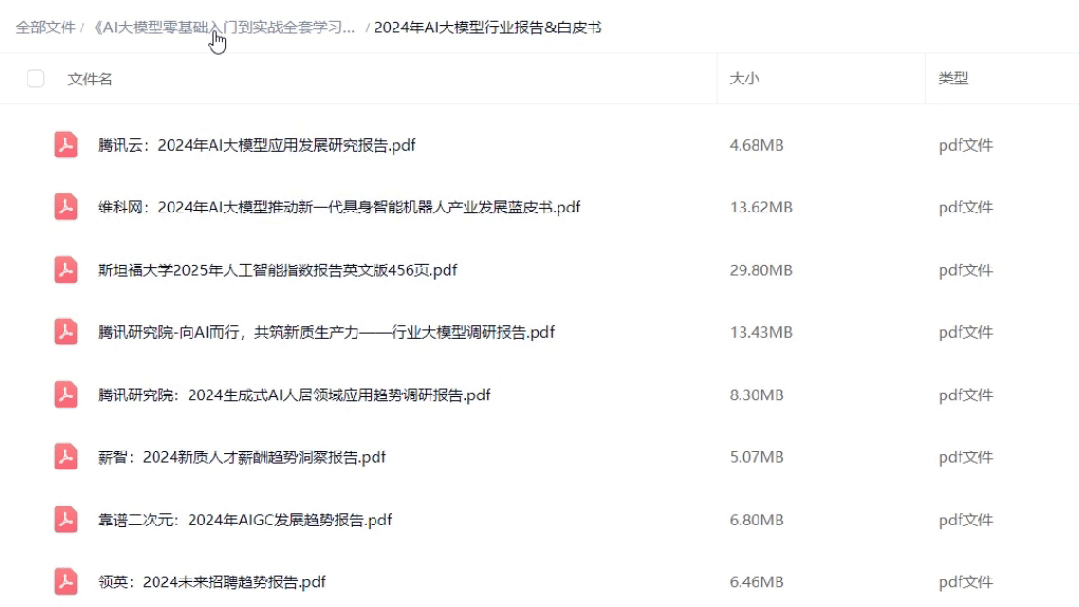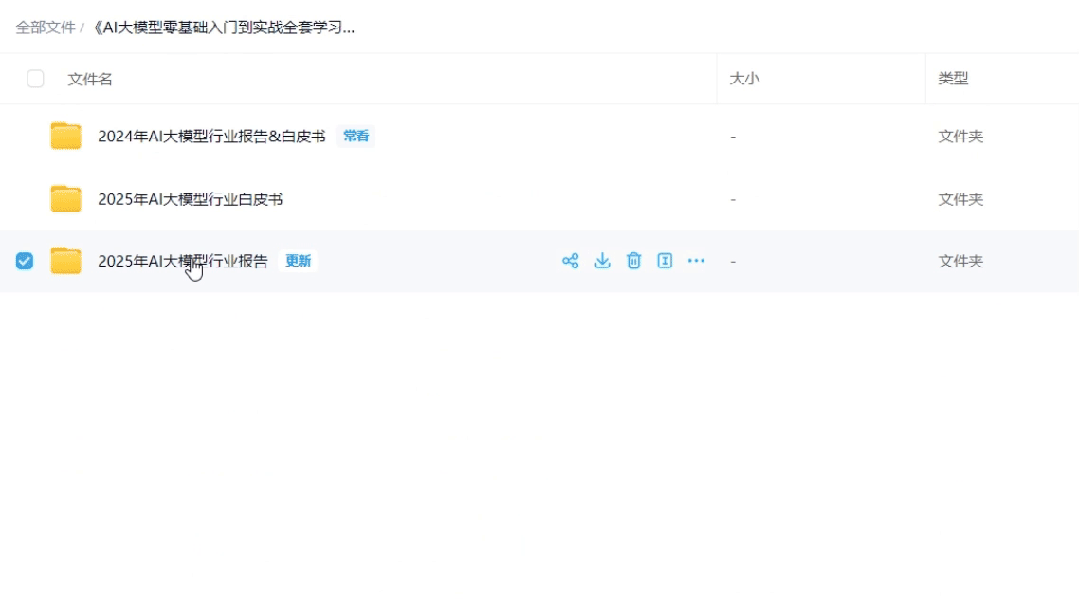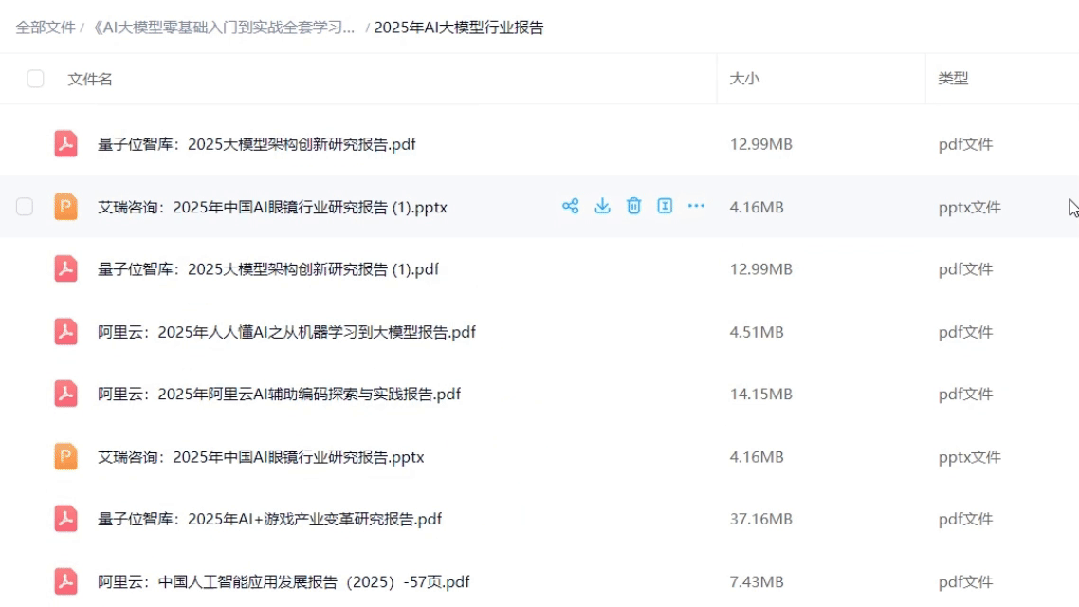
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
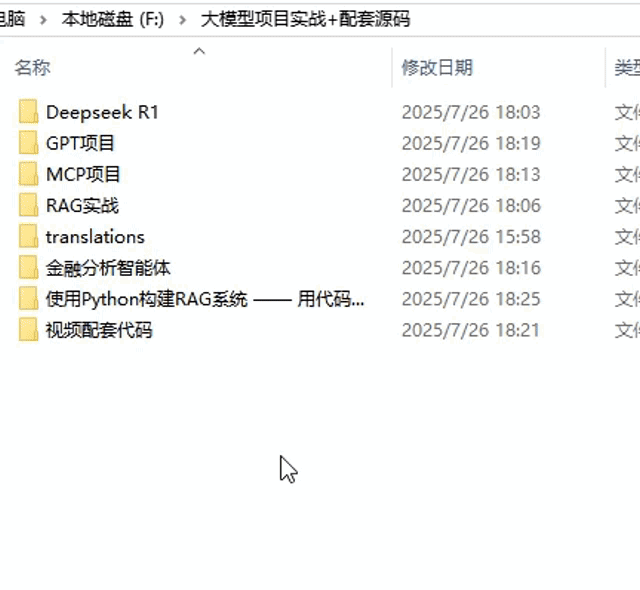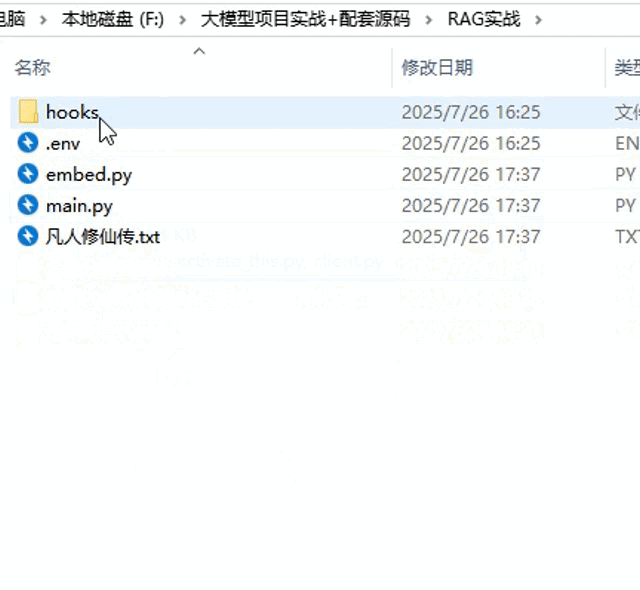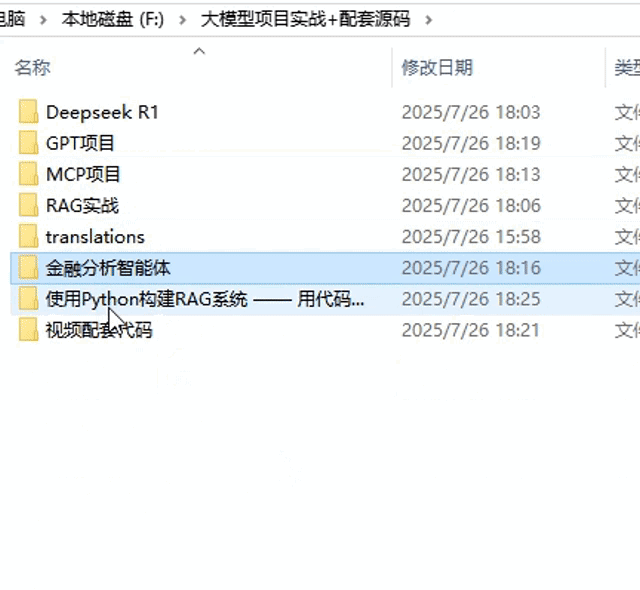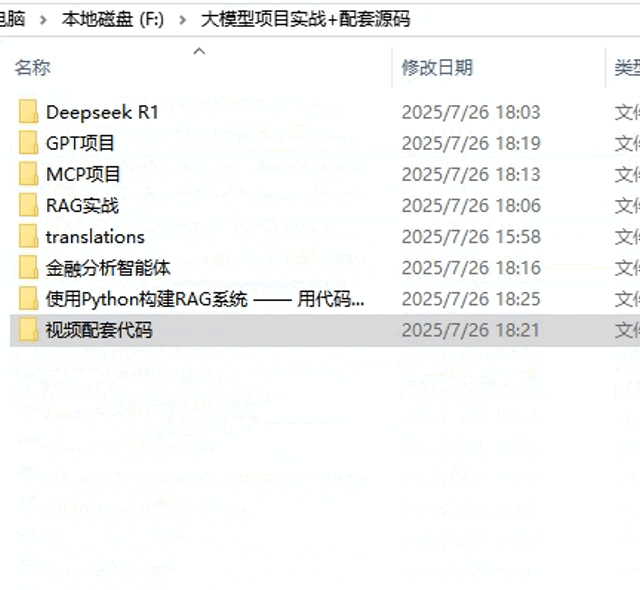
4、大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
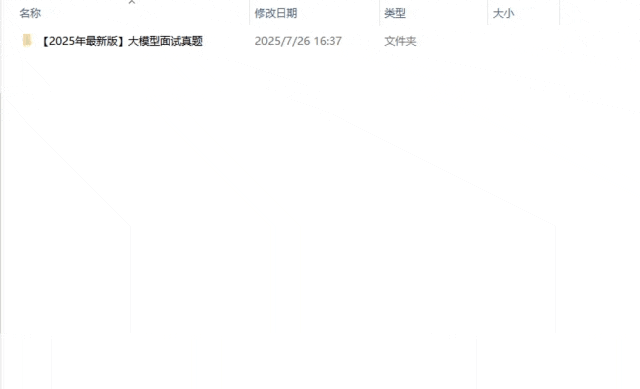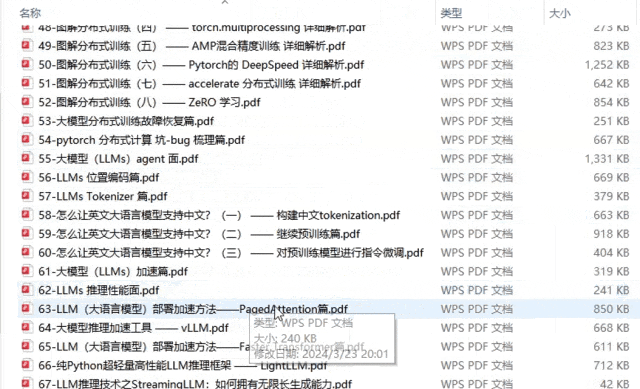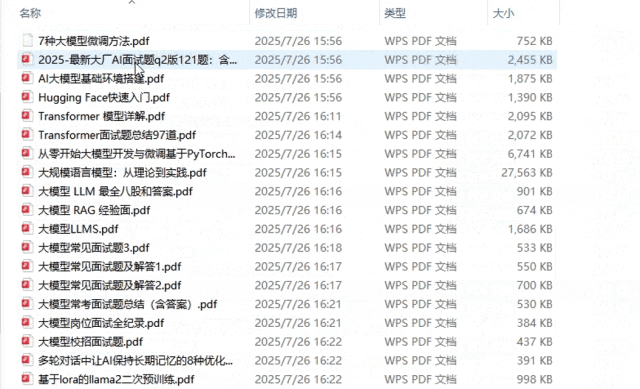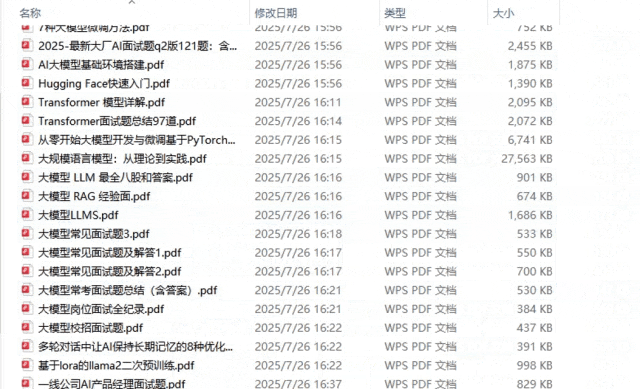
5、大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
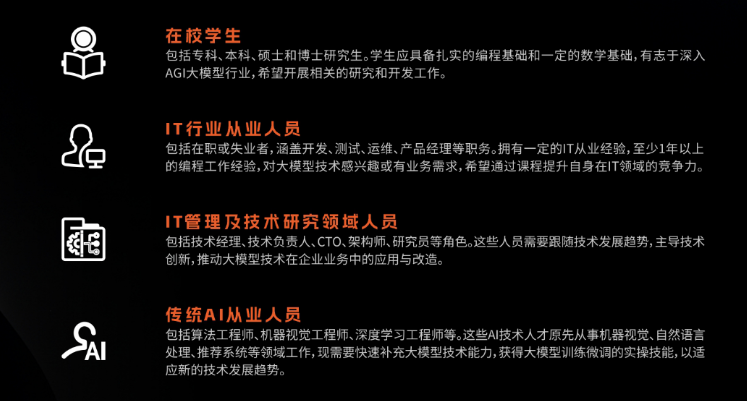
适用人群
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。
如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 1320


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


