


事情是这样的
上个月我带的一个学员面字节二面。简历上那个 Agent 项目写得挺漂亮,RAG、工具调用、评测集都写了。
面试官翻了两页简历,问:这一百二十条评测集是怎么选出来的。
他答:根据常见问题整理的。
面试官接着问:线上一天多少条真实会话。
他答:三十来万。
然后面试官就不问了,翻下一页。
我听完第一反应是心疼,第二反应是这题怪不了别人——这不是答错,是这题在他脑子里压根没当问题。一百二十条对三十万条,中间差的一万倍,就是字节要考的。
复盘的时候我们挖出三个盲区,每个盲区背后都是一块他以为不需要准备的东西。写出来给你避坑。
盲区一:把岗位当成一条线
复盘第一个发现:他根本不知道自己投的是三条线里的哪一条。
字节的 Agent 岗至少分三条线。平台侧(扣子、火山方舟这类)做的是让别人在上面搭 Agent 的那一层,日常问题是多租户怎么隔离、配额怎么算、插件谁审核、运行时崩了会不会一起崩、成本怎么摊到各业务方头上,最像传统中间件,最适合后端转过来的人。业务侧(抖音电商、客服、搜索、直播)做自己业务要用的 Agent,客服看首轮解决率和转人工率,导购看点击和成交,必问"上线三个月拿什么数字证明它有用"和"大促当天扛得住吗"。模型侧(Seed、豆包)做模型本身,招算法,后端投过去大概率连初筛都过不了。
一套项目投所有岗位,很容易在第一个问题就被问穿。他这次就是。
顺带把两条线的"硬题"也记下来,它们比线本身更容易漏。业务侧绕不开大促:最后都会被问一句"大促当天扛得住吗",十万 QPS 怎么排考的不是加机器,是分层——哪些请求能合并、哪些结果能缓存、哪些步骤能异步、哪些能力能前置到端上。平台侧绕不开成本:Token 成本砍一半砍哪——上下文少放无关段落做分层摘要、调用能并行不串行、难的走大模型简单的走小模型。这两道他都没准备过,但都是各自岗位的日常。
盲区二:知道评测集,不知道评测闭环
第二个盲区是那一百二十条本身。他准备过 RAG 和工具调用,以为评测集"有"就够了,没想到面试官会问"怎么选的"。
离线这一侧,固定评测集要有交代:多少条、覆盖哪些意图、bad case 怎么回流、谁来标注、改一版 prompt 跑一遍要多久——没有标准答案,但必须有。线上这一侧,灰度、AB、埋点、会话留存一样不能少,指标至少六个:任务完成率、工具选择准确率、参数错误率、P99 延迟、单次会话 Token 成本、人工接管率。
面试里两句问法最容易露底:“你怎么证明这次改动让它变好了”;“如果完成率涨了,但用户投诉也涨了,你信哪个”。第二句能答出"完成率是模型自评,投诉是用户自评,冲突的时候以用户为准"的人,是真的跑过线上。他没跑过,所以接不住。
顺带补一句相关认知:扣子前阵子把 Loop 开源出来,做的就是 prompt 版本管理、评测、线上 trace 这一套。平台愿意开源这种东西,说明它在内部是刚需,不是加分项。
盲区三:没把工程基础当"入场券"
第三个盲区挖出来的时候他自己都愣了——他以为 Agent 岗考的是 AI,结果必答题全是工程题。
一个请求进来,后面串着模型调用、向量检索、工具执行、状态写入,四段里任何一段抖,用户看到的就是转圈或白屏。字节体量下一次抖动放大到千万级用户手上, 稳定性是入场券,不是加分项 。必答题:模型八秒没回,你返回什么。答"再等等"基本结束;答"先返回中间态、后台继续跑、前端轮询"、再补上状态持久化的,是真做过。
RAG 那边同理:知识库里明明有答案但没召回,答"我会调大 topK"的直接出局——得会定位:切块边界、索引排序、解析丢失,一个一个排查。工具调用那边:超时重试前查幂等键、连续三次调同一接口靠什么终止、付款删除这类副作用要不要人工确认,还有失败返回什么(返回"稍后再试"模型会自己编答案,要返回结构化错误码加"建议下一步")。
面试最后还有三刀:量(十万 QPS 靠分层:合并、缓存、异步、前置到端上)、钱(Token 砍半:上下文分层摘要、调用能并行不串行、难的走大模型简单的走小模型)、换模型(豆包换一版,分清哪些是模型的脾气、哪些是系统的契约)。这三刀他都没准备过。
还有几道必答题,一并记下
复盘时发现的盲区之外,面试里还有几道高频必答题,补在这里。
工具描述怎么写。“查询订单信息"这种写法,模型会把用户随口说的一串数字当订单号填进去;写清"订单号必须十八位纯数字,用户没给就先问”,参数错误率能掉一半。失败返回同理:返回"稍后再试"模型会自己编答案,返回结构化错误码加"建议下一步"它才知道该怎么办。
平台侧的深水区。沙箱里跑业务方上传的代码,怎么限 CPU、内存、网络出口;第三方工具读到机密文件,内容能不能进上下文;会话跑到第八步断了,用户再进状态从哪恢复。学员这次没面到这些,是因为在前面的题就停了——这些题是过了前两关才会出现的。
RAG 的容量算术。召回二十段、上下文只放得下五段,怎么筛:按相关性、时效、业务权重排,权重是你拍的还是有依据的,面试官一定会追问。
复盘之后改的练法
我们重新排了每天的练法,一天两小时:补基础一天一个主题,分布式、缓存、消息队列、索引轮着来,讲到"为什么这么设计"就行;手写一遍两百行以内的 Agent 循环,不用框架,终止条件、工具调用、上下文裁剪自己写;把项目里的异常一条条往下写到第五层根因——从"模型答错了"挖到"检索把表格标题切掉了,模型看到的是一段没有表头的数字";每周画一遍系统设计链路:入口、编排、检索、工具、写入、回流,拿固定评测集跑一次记下分数。
写在最后
那次二面的损失换来了一个认识:字节考的从来不是"你做过 Agent",是"你的 Agent 在三十万条会话上还能不能活"。三个盲区补上,下一场再战。
给同样在准备的人一个自查办法:把自己的简历拿给朋友看,让对方扮演面试官,从"这个数字怎么来的"开始问。凡是答的时候心里发虚的数字——评测集条数、会话量、指标涨跌——都是还没想清楚的地方。把这些发虚的地方提前补实,比多刷十个框架教程管用。希望这一万倍的差距,你没等到面试官翻下一页才意识到。
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
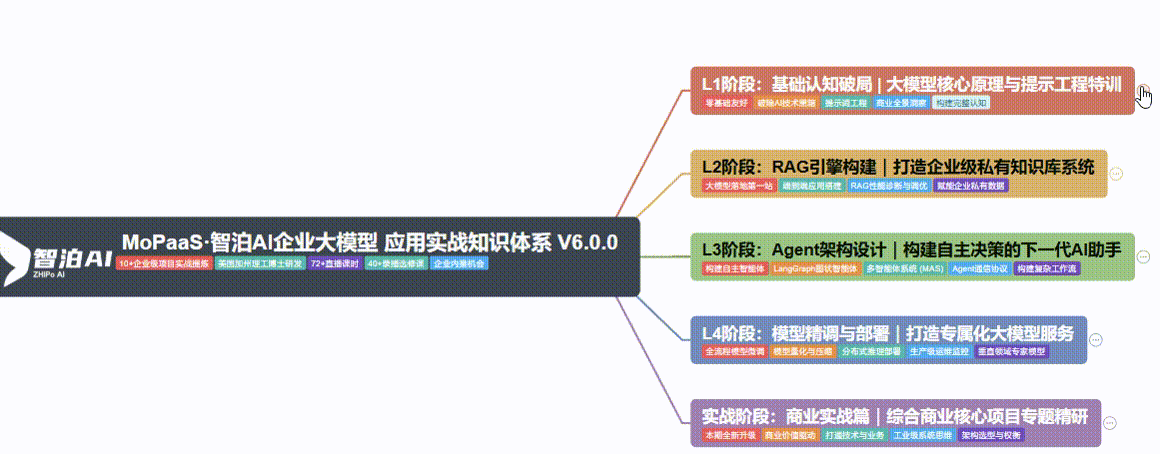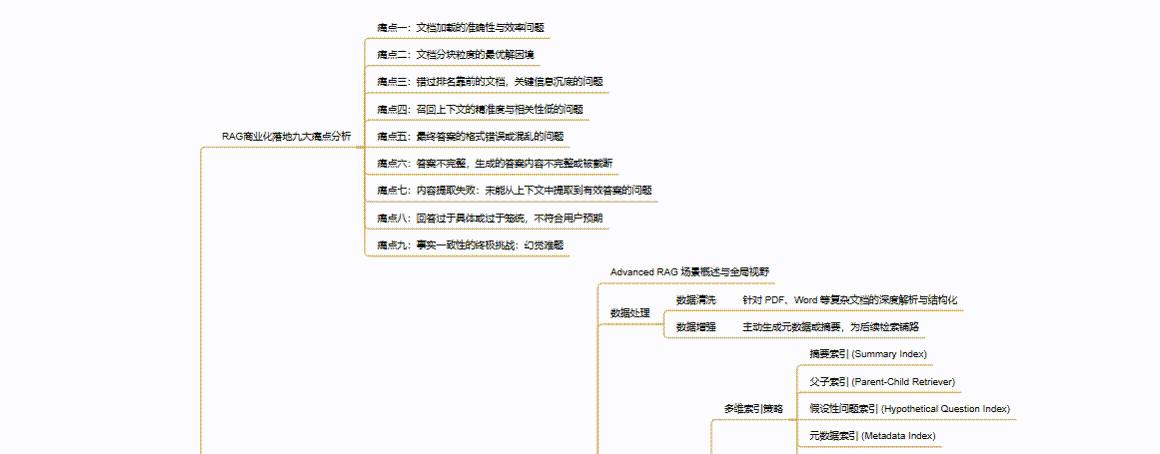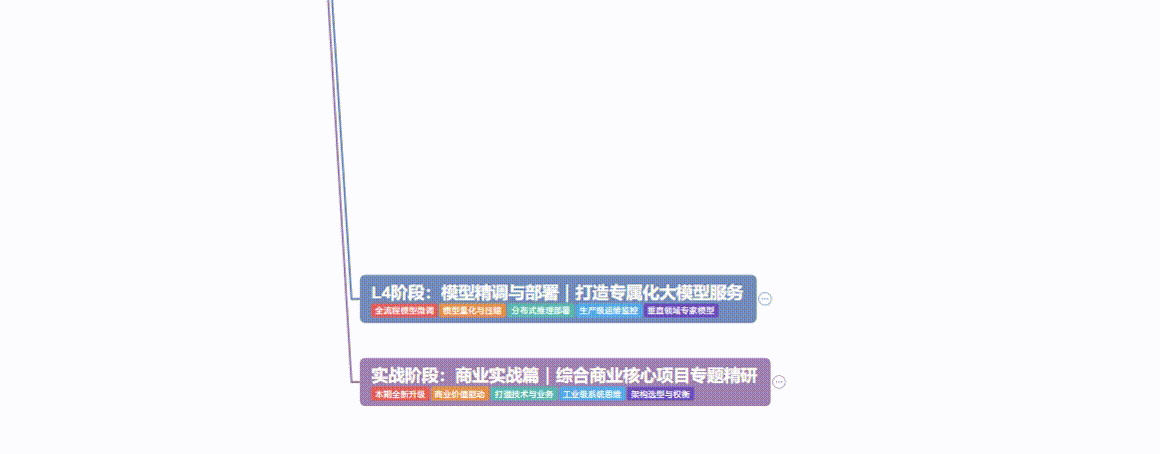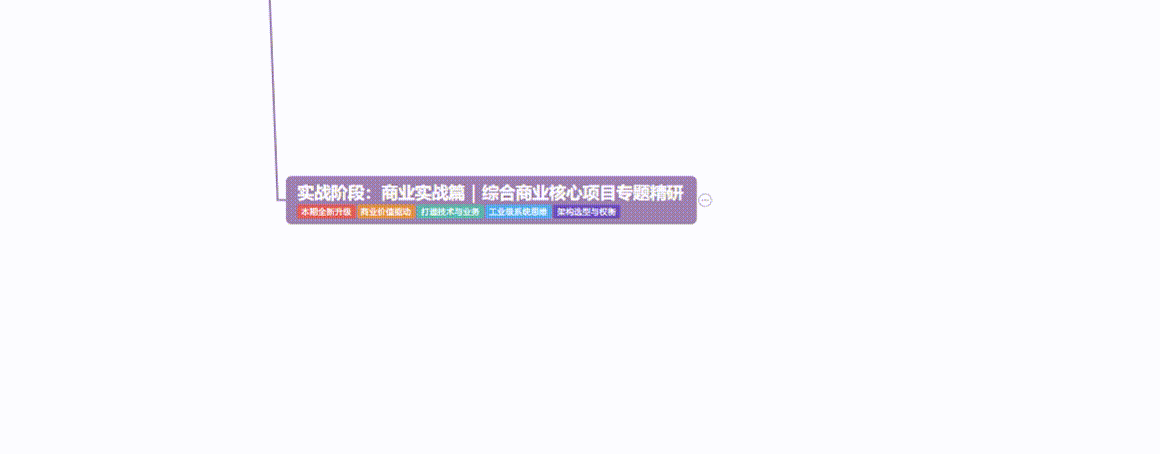
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
2、大模型学习视频教程
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
7、为什么要学习大模型?
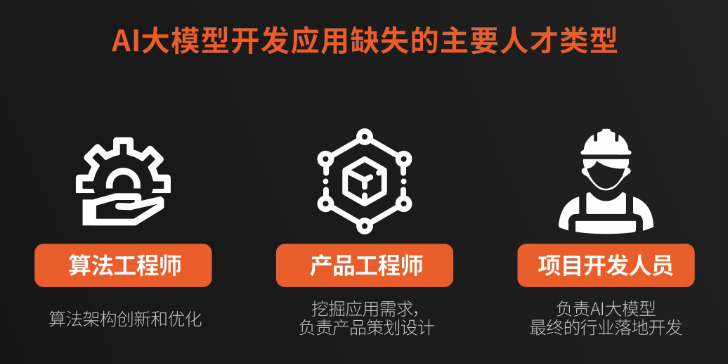
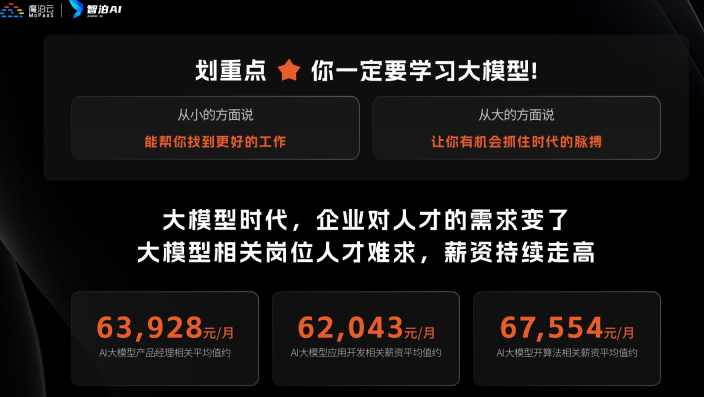
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。
 1325


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


