


 本文面向前端工程师,系统阐述其在AI Agent开发中的能力迁移路径:API集成、异步交互、状态建模、执行过程可视化、UI设计及工程化能力均可复用;同时明确需补齐的服务端开发、LLM基础、Tool Calling、RAG、Agent Loop机制及可观测性等关键技术。提出以TypeScript/Node.js为起点、分四阶段渐进式学习路线,并警示转型中常见误区。
本文专为前端工程师设计,探讨AI Agent开发中的能力迁移与学习路径。文章指出,前端工程师在API调用、异步交互、状态管理及UI设计等方面的经验可直接迁移至Agent开发中,并强调传统软件工程能力在构建可靠Agent应用中的重要性。同时,文章也明确了需要补齐的服务端开发、LLM基础及Agent运行机制等知识,并提供了一条循序渐进的学习路线,帮助前端工程师顺利转型AI Agent开发领域。
看到 Python、RAG、Tool Calling、MCP、LangGraph 这些陌生名词时,不少前端工程师的第一反应是:转向 AI Agent,是不是意味着换掉技术栈、从头再学一遍?
答案并不是简单的“是”或“否”。你确实需要补齐后端、模型与 Agent 运行机制等知识,但过去积累的 API、异步编程、状态管理、实时通信、用户体验和工程化能力并不会失效。
恰恰相反,这些能力正是构建可靠 Agent 应用的重要基础。尤其对于做过复杂交互、系统集成、实时通信或工程化建设的前端工程师,这种迁移优势会更加明显。
一、先理解:AI Agent 开发到底在做什么?
最简单的大模型应用通常只有一轮交互:接收输入、调用模型、返回结果。
用户输入 → 调用大模型 → 返回内容
Agent 则要围绕一个目标持续执行。它可能需要分析任务、选择工具、读取工具结果、更新状态,并根据当前结果决定继续执行还是结束。
用户目标 ↓模型判断下一步动作 ↓调用工具或生成回答 ↓读取结果并更新状态 ↓继续执行,或满足条件后结束
不过,需要先明确:接入知识库并不等于构建了 Agent。如果问题可以通过固定的“检索—生成”链路完成,它更接近一个 RAG 应用或知识问答 Workflow。只有当系统需要根据当前信息动态选择工具、补充条件并决定下一步时,Agent 的特征才会更加明显。
例如,一个企业知识问答 Agent 接到“我下周去上海出差,可以订什么标准的酒店?”这一问题后,可能经历以下过程:
-
分析问题,识别用户正在查询差旅住宿标准。
-
检索企业知识库中的最新差旅管理制度。
-
调用员工信息工具,确认用户的职级和所属地区。
-
根据出差城市、职级和制度版本匹配适用标准。
-
如果信息不足,继续询问出差日期或其他必要信息。
-
汇总适用规定,标注制度来源并生成回答。
-
如果用户准备预订,再询问是否进入差旅申请或酒店查询流程。
因此,Agent 并不是“多写几段 Prompt”,而是一个由模型参与决策、由程序约束执行过程的软件系统。
LLM 提供概率性的理解与决策能力,传统代码负责工具执行、状态管理、权限边界和可靠性保障。
这个本质决定了:传统软件工程经验不仅仍然有用,而且在 Agent 从演示走向生产时会越来越重要。

图:Agent 不是一次模型调用,而是“决策—执行—更新状态—继续判断”的闭环。
二、前端能力与 Agent 开发如何对应?
前端和 Agent 开发使用的语言、框架可能不同,但底层问题有大量重合。
| 前端常见能力 | 在 Agent 系统中的对应场景 |
|---|---|
| API 调用 | 模型、搜索、向量库、MCP Server 和业务工具接入 |
Promise 与异步任务 | 模型调用、并行检索、网页读取与批量工具执行 |
| 状态管理 | 消息、计划、步骤、工具结果和执行状态管理 |
| SSE、WebSocket | Token、步骤、日志和工具事件的实时推送 |
| Reducer 与事件驱动 | 将 Agent 事件还原为可预测的界面状态 |
| 组件化与交互设计 | 计划面板、工具卡片、引用、审批和恢复界面 |
| 工程化 | 配置、测试、日志、监控、发布和故障治理 |
这种对应关系并不意味着两者完全相同,而是说明前端工程师已经具备理解 Agent 系统的多种“工程直觉”。

图:前端积累不会消失,而会在 Agent 的工具、状态、流式交互和工程治理中继续发挥作用。
三、优势一:API 与系统集成经验可以迁移
前端开发离不开 HTTP API:组织参数、处理认证、解析响应、区分错误类型,并把数据转化成界面状态。
const response = await fetch('/api/orders', { method: 'POST', headers: { 'Content-Type': 'application/json' }, body: JSON.stringify(input),}) if (!response.ok) { throw new Error(`Request failed: ${response.status}`)} const order = await response.json()
Agent 系统需要接入多种模型、数据和工具能力,例如模型 API、搜索服务、数据库、企业内部接口、第三方工具,以及通过 MCP 暴露的本地或远程能力。
MCP Server 不一定是远程 HTTP 服务,也可以运行在本地进程中。它通过标准协议暴露工具、资源和提示模板等能力,由 Host 内的 MCP Client 与其建立连接并调用,因此不能简单等同于普通 REST API。
变化不只是在 JavaScript 和 Python 之间切换。Agent 工具通常还需要更严格地处理:
输入参数的结构化校验
超时、重试与幂等性
调用权限与用户确认
返回结果的大小和可信度
错误信息如何反馈给模型
调用日志、耗时与成本记录
前端工程师已有的接口协作和异常处理经验,能够直接帮助理解这些问题;需要补充的,是服务端安全边界与可靠性设计。
四、优势二:异步交互经验有助于理解 Agent 的任务协作
前端工程师经常与“结果不会立即返回”的系统打交道:接口请求可能超时,搜索结果可能乱序,用户可能中途取消,页面也可能需要持续接收流式数据。做过搜索联想、文件上传、实时消息或复杂表单的人,通常已经形成了一些有价值的工程直觉:
不把请求发出等同于任务完成。
不默认异步结果一定按发起顺序返回。
对超时、取消、重复请求和过期结果保持警惕。
将执行中的状态持续反馈给用户。
这些直觉可以迁移到 Agent 应用。一次 Agent 运行可能依次调用模型、检索知识库、执行工具,也可能并行处理多个彼此独立的子任务。无论采用串行还是并行方式,系统都需要回答:
哪些任务可以并行,哪些任务存在前后依赖?
某个步骤失败后,是重试、跳过、降级还是终止?
用户取消后,尚未结束的模型和工具调用如何停止?
如何限制并发,避免服务限流和成本失控?
如何把后台执行过程转换为用户能够理解的进度?
不过,熟悉 Promise 并不等于已经掌握 Agent 后端调度。浏览器中的请求管理与服务端的任务队列、并发控制、资源回收和长任务生命周期并不相同。真正能够迁移的是对异步问题的敏感度,而服务端执行模型仍然需要单独学习。
五、优势三:状态建模经验有助于理解 Agent Workflow
复杂前端不会只有一个 loading。它通常需要区分数据、请求状态、错误、缓存和交互步骤,并明确什么事件会让界面从一种状态进入另一种状态。
Agent Workflow 同样需要显式状态,但它管理的不只是界面展示。一次研究任务可能包含用户目标、执行计划、当前步骤、工具结果、最终答案和错误信息:
interface ResearchState { query: string plan: string[] currentStep: number searchResults: SearchResult[] finalAnswer?: string error?: string}
规划步骤写入 plan,检索步骤追加 searchResults,写作步骤生成 finalAnswer。这种“明确描述状态,并让不同步骤按规则更新状态”的方式,与前端熟悉的状态机、Reducer 和单向数据流有相通之处,因此前端工程师通常更容易理解 Node、Edge、State 和事件之间的关系。
但 Agent 系统中的状态至少要分成三层:
运行状态:消息、计划、当前步骤和工具结果,用于决定下一步执行什么。
持久化状态:检查点、运行标识和审批结果,用于暂停、恢复与故障重试。
展示状态:进度、工具卡片、引用和错误提示,用于帮助用户理解执行过程。
这三层不能简单混在同一个前端 Store 中。尤其对于长任务,系统还要处理状态持久化、节点幂等性、并发更新和副作用去重。以 LangGraph 为例,配置 Checkpointer 后,框架可以在工作流执行过程中保存状态快照,并通过稳定的运行标识定位状态,从而支持 Human-in-the-loop、故障恢复、状态历史和回放。
所以,前端状态管理经验提供的是一种建模起点,而不是可直接照搬的实现方案。真正进入 Agent Runtime 后,仍然需要补齐持久化、分布式执行和故障恢复等服务端知识。
六、优势四:前端懂得如何呈现 Agent 的执行过程
普通聊天界面主要展示用户消息和模型生成的 Token。Agent 的过程更丰富:
agent.startedplan.createdtool.startedtool.completedapproval.requiredstep.completedagent.interruptedagent.completed
服务端可以通过 SSE 或 WebSocket 推送这些事件,前端经过解析和归并后渲染为用户可理解的状态。
Agent Runtime ↓ SSE events事件解析与校验 ↓Reducer / Store ↓计划、工具、引用、进度与最终答案
这里不能只考虑“能不能实时显示”,还要解决:
断线重连后如何补齐丢失事件?
重复事件是否会造成状态重复写入?
事件乱序时如何恢复正确顺序?
页面刷新后能否继续观察运行中的任务?
哪些内部信息应展示,哪些推理内容不应直接暴露?
做过消息流、实时日志、上传进度或订单状态的前端工程师,对这些问题并不陌生。
七、优势五:Agent UI 是一个新的产品设计空间
Agent UI 不应只是“历史记录 + 对话框 + 输入框”。不同任务需要不同的交互结构。
一个研究型 Agent 可以包含:
研究计划和当前步骤
搜索、网页读取等工具卡片
来源列表和正文引用
执行时间线与阶段进度
敏感操作的确认按钮
暂停、恢复、重试和取消入口
失败原因与可执行的恢复建议
一个编码 Agent 可能更需要文件变更、终端输出、测试结果和差异审查;一个数据 Agent 则需要查询预览、图表、筛选器和导出操作。
前端工程师的价值不只是把后端事件“画出来”,而是把模型不稳定、工具异步执行和用户控制权转化成清晰、可信的产品体验。
好的 Agent UI 需要回答三个问题:系统正在做什么、为什么需要用户介入、用户下一步可以做什么。
八、优势六:生产级 Agent 最终拼的是工程能力
演示一个 Agent 可能只需要模型、Prompt 和几个工具。让它稳定服务真实用户,则必须面对传统软件工程问题:
可靠性:超时、重试、降级、熔断与任务恢复。
安全性:身份认证、最小权限、敏感操作确认和输入防护。
可观测性:日志、Tracing、模型与工具耗时、错误分类。
质量保障:测试集、离线评测、线上反馈和回归检测。
成本控制:模型选择、上下文裁剪、缓存和调用预算。
数据治理:隐私、保留策略、审计与敏感信息处理。
交付能力:配置管理、版本发布、灰度、监控与回滚。
Prompt 很重要,但 Prompt 不能替代权限系统、测试、监控和故障恢复。
前端工程师如果参与过中大型项目,通常已经理解模块边界、环境配置、质量门禁、监控和发布流程。这些经验会成为转型后期真正的竞争力。
九、哪些差距必须正视?
“能力可以迁移”不等于“几乎不用学习”。前端工程师通常需要系统补齐以下内容。
- 服务端开发与主要语言
需要理解 Web 服务、鉴权、数据库、任务队列、部署与并发模型,并选择一门主要的服务端语言。
前端工程师可以先使用熟悉的 TypeScript/Node.js 完成模型调用、Tool Calling、流式响应和最小 Agent Loop;如果希望深入 RAG、数据处理、模型实验或 Python 主导的 Agent 生态,再系统补齐 Python 的类型标注、异步编程、包管理、测试和常用数据模型。
无论选择 Node.js 还是 FastAPI 等 Python 框架,框架 API 都不是学习终点,真正需要掌握的是服务端的安全边界、任务生命周期和可靠性设计。
- LLM 应用基础
需要理解消息结构、上下文窗口、结构化输出、Tool Calling、Token 与成本,以及采样参数对结果的影响。模型输出具有不确定性,应用不能默认它始终正确或满足业务约束。即使使用结构化输出,也需要进行 Schema 校验、业务规则校验,并设计重试、降级和失败处理。
- Agent 运行机制
需要真正理解 Agent Loop:模型提出工具调用,应用执行工具,将结果写回上下文,再由模型决定下一步,直到满足停止条件或触发预算限制。
- RAG 与数据处理
RAG 不等于“把文档放进向量数据库”。还涉及内容清洗、分块、召回、过滤、重排、引用、权限隔离和效果评测。
- 安全、评测与可观测性
Agent 能够调用工具,也就可能产生真实副作用。需要关注提示注入、越权调用、数据泄露、危险操作确认,以及如何用可重复的评测判断系统是否真的变好。
十、为什么不建议一上来就学 Agent 框架?
直接学习框架,容易出现一种错觉:代码跑通了,就等于理解了 Agent。
但如果无法解释以下问题,通常只是会调用框架 API:
Tool Calling 的请求由谁发起、工具又由谁执行?
当模型需要根据工具结果继续判断时,为什么应用要把结果写回后续上下文?
Agent 为什么会继续循环,又如何停止?
State、Node 和 Edge 分别解决什么问题?
什么时候应该使用固定 Workflow,什么时候才需要动态决策?
如何限制步数、时间、成本与工具权限?
更合理的方式,是先用一段接近 Python 的伪代码理解最小 Agent Loop:
async def run_agent(messages, tools, max_turns=8): for _ in range(max_turns): response = await call_model( messages=messages, tools=tools, ) messages.append(response.message) if not response.tool_calls: return response.content for tool_call in response.tool_calls: result = await execute_tool_safely(tool_call) messages.append( create_tool_result_message( tool_call_id=tool_call.id, result=result, ) ) raise RuntimeError(”Agent exceeded the maximum number of turns”)
这是一段用于解释控制流程的伪代码,并不对应某个模型 SDK。真实系统还需要处理工具白名单、参数校验、未知工具、并发执行、超时、重试、权限确认、取消和状态持久化。理解这一层后,再学习 LangGraph 等框架如何管理状态、分支、循环、检查点和人工介入,会轻松很多。
十一、一条更适合前端工程师的学习路线
这条路线不必从“先学完 Python 和后端”开始。前端工程师可以先使用熟悉的 TypeScript、Node.js 或全栈框架跑通模型应用,再随着工具调用、长任务和数据接入逐步补齐服务端知识。更合理的顺序是:先完成最小闭环,再理解 Agent Loop,最后增加知识、工作流和工程约束。

图:先用熟悉的技术栈完成模型应用闭环,再逐步引入 Agent Loop、知识库、工作流与生产工程能力。
第一阶段:用熟悉的技术栈跑通最小模型应用
使用 TypeScript/JavaScript 接入模型 API
理解消息、上下文和流式输出
处理基本的错误、超时与加载状态
通过服务端代理或安全运行环境保护 API Key
阶段成果:完成一个带流式响应、错误提示和基本对话能力的模型应用。
第二阶段:理解 Tool Calling 与 Agent Loop
工具描述、参数 Schema 与结构化输出
工具白名单、参数校验与结果回传
Agent Loop、停止条件和最大步数
超时、取消、失败处理与调用日志
Token、延迟、成本和 Prompt 测试
阶段成果:手写一个有工具白名单、最大步数和失败处理的 Agent Loop。
第三阶段:加入知识与工作流
文档解析、分块、检索与重排
来源引用与权限过滤
State、Workflow、分支和循环
Checkpoint 与 Human-in-the-loop
持久化 Checkpointer 与运行标识
可序列化状态、恢复入口与节点幂等性
阶段成果:完成一个能够保存运行状态、暂停等待用户输入、恢复执行并展示来源的研究型 Agent。
暂停和恢复并不只是保存一个 State。系统还需要用稳定的运行标识定位检查点,并保证节点重新执行时不会重复产生不可逆的副作用。
第四阶段:进入工程化与生产实践
MCP 与企业工具接入
评测、Tracing 与监控
权限、Guardrail 与审计
缓存、并发、预算和成本治理
灰度发布、故障恢复和质量回归
阶段成果:把 Agent 从“能运行的 Demo”升级成可验证、可观测、可控制的服务。
十二、前端转型时最容易踩的五个坑
- 把转型理解为换一门语言
语言只是载体。无论选择 TypeScript/Node.js 还是 Python,真正需要补齐的都是服务端、模型机制、Agent 运行时与生产工程能力。
- 追逐框架名称
框架会变化,Tool Calling、状态、工作流、权限、评测和可观测性等问题会长期存在。应优先学习稳定的底层概念。
- 把聊天界面当成完整 Agent 产品
复杂任务还需要过程可视化、来源、审批、失败恢复和用户控制权。
- 只关注模型效果,不关注系统约束
模型更聪明不等于系统更可靠。生产环境必须设置停止条件、调用预算、工具权限和失败策略。
- 过早追求“全自主”
并非所有任务都需要 Agent。对于步骤固定、输入边界明确的任务,普通代码或固定 Workflow 通常更容易测试和控制。它们减少了模型动态决定执行路径的空间,但内部模型调用仍然需要校验、重试和失败处理。高风险操作还应保留人工确认。
十三、转型的本质:不是清空技能树,而是扩展边界
前端工程师过去主要处理:
用户操作 → API 请求 → 状态变化 → 页面渲染
进入 Agent 应用开发后,系统链路扩展为:
用户目标 → 模型决策 → 工具执行 → 状态更新 → 工作流推进 → 实时事件 → Agent UI
API、异步、状态、事件、UI 与工程化仍然存在,只是系统中增加了一个具有概率性、能够参与决策的 LLM 组件。
所以,这条路径更准确的描述不是“前端改行学 AI”,而是:
以前端工程能力为起点,把自己的边界扩展到模型、后端、Agent Runtime 与智能产品设计。
总结
前端工程师适合转向 AI Agent 开发,并不是因为这条路没有门槛,而是因为已有能力与 Agent 系统存在大量可迁移的连接点:
API 经验有助于接入模型和工具。
异步经验有助于理解并发任务与流式执行。
状态管理经验有助于设计 Agent Workflow。
SSE、WebSocket 和事件驱动经验有助于呈现执行过程。
UI 与产品经验有助于构建真正可用的 Agent 交互。
工程化经验是 Agent 从 Demo 走向生产的关键条件之一,最终效果还取决于任务是否适合模型处理、模型与数据质量、安全边界、评测体系和业务流程设计。
需要补齐的重点也很明确:服务端开发、LLM 基础、Tool Calling、RAG、Agent Loop,以及安全、评测和可观测性。TypeScript/Node.js 可以成为前端工程师的第一站,Python 则可以根据项目方向和生态需求逐步补齐。
不要从框架名称开始,也不要试图一次学完所有概念。先完成一个最小闭环,再逐层增加状态、知识、工具和工程约束,会是一条更稳、更可验证的路径。
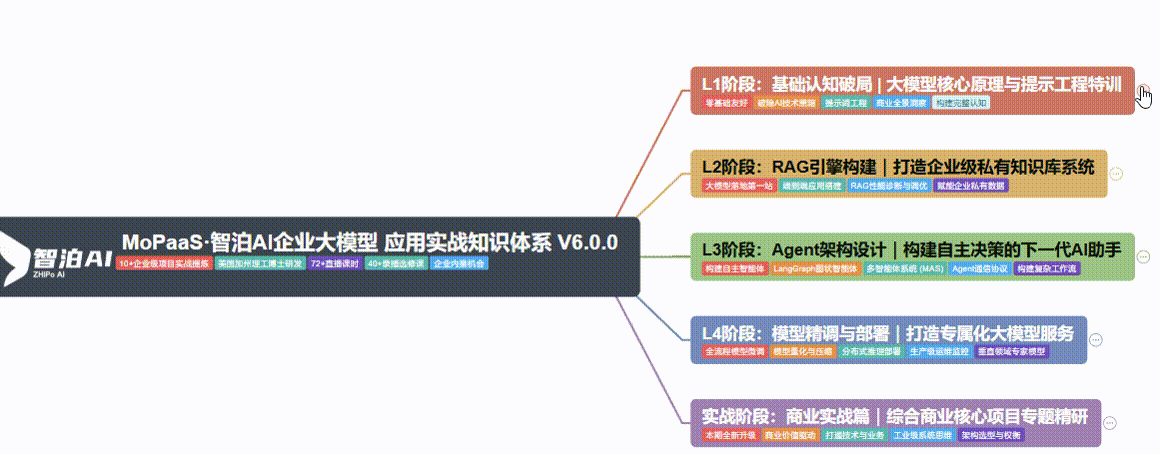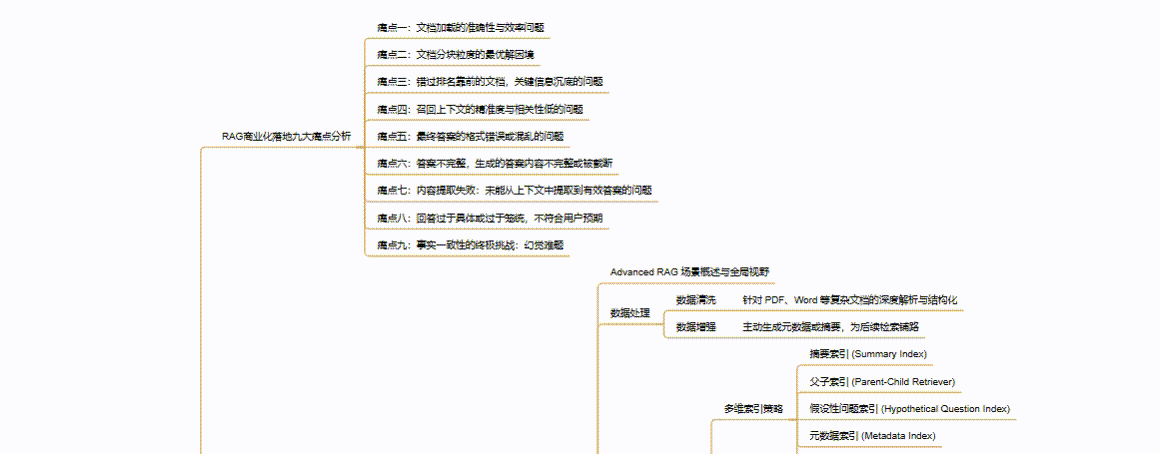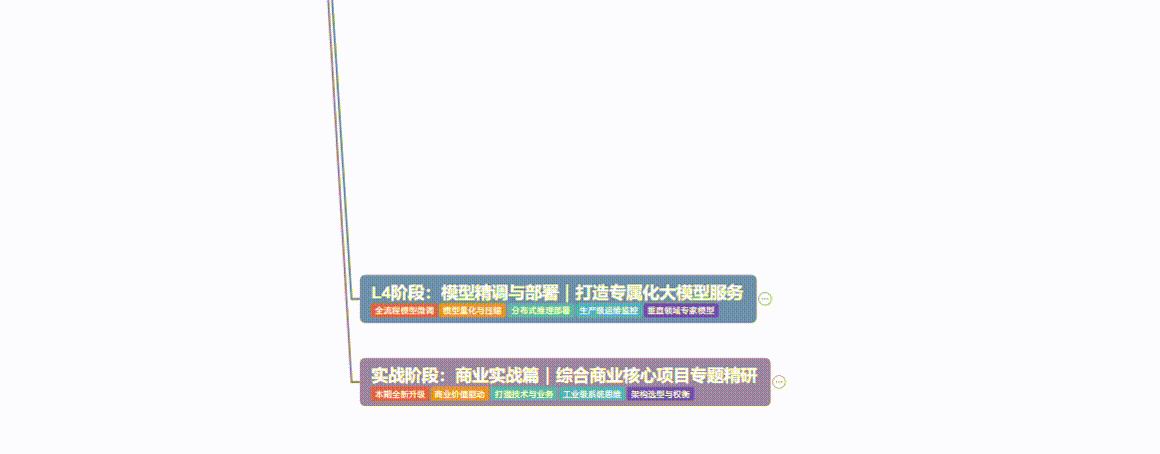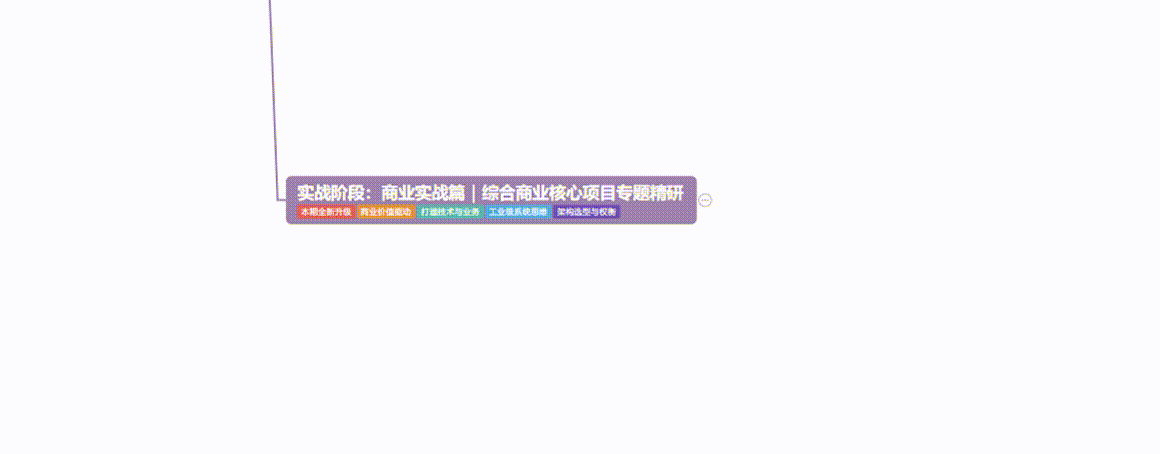
大模型的知识又多又杂,到底怎么学?
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
2、大模型学习视频教程

3、大模型学习书籍&电子文档
4、AI大模型最新行业报告

5、大模型项目实战&配套源码

6、2026大模型大厂面试真题

7、为什么要学习大模型?
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。


8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方优快云官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。


 扫一扫


 435

 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


