


本文针对2026年大厂前端面试,提出了一系列深度回答指南,涵盖独立负责业务、React深度、现代前端工程化、全栈视野、AI与研发流、跨端与小程序、前端监控、性能优化、AI应用开发以及系统设计等多个方面,旨在帮助程序员提升面试竞争力,获得高薪职位。

如果你正在准备高级前端的面试,或者想冲击 30K - 50K 的高薪,请务必抛弃以往“背八股文”的思维。今天,我们就来盘点一下,2026年大厂面试官真正想听到的“深度回答”长什么样。
一、真正的“独立负责业务”:别再只是说“我写了这个页面”
大厂 JD 第一句永远是:“具备独立负责复杂业务模块或中小型产品的设计能力”。 面试官真正想问的是:你负责过最大的项目是什么?
❌ 普通回答: “我用 React 和 Ant Design 开发了后台管理系统,主要负责表单渲染和数据绑定,按时完成了任务。”
✅ 高级回答(基于 STAR 法则与架构思维):
“我主导了整个大促活动/会员中心的前端架构设计,覆盖 PC、H5 和小程序三端。 背景与职责: 团队有 10 余名前端,我负责核心技术选型、权限体系设计、接口防刷设计以及性能监控方案。 行动与难点: 针对高并发场景,我设计了基于 Node.js BFF 层的请求聚合,解决了原有客户端请求 4 次才能渲染首屏的问题;并统一了跨端的 CI/CD 自动化发布流水线。 业务结果: 上线后,页面首屏打开速度提升了 40%,接口请求量下降 35%,线上 Bug 发现时效缩短到 5 分钟内。”
二、React 深度:不再问 API,直接深入源码层
对于熟练掌握 React/Vue,面试官不会再问 useState 怎么用,而是直接探底你对渲染机制的理解。
❓ 面试题:React 为什么需要引入 Fiber 架构?
❌ 普通回答: “因为以前的渲染会卡顿,Fiber 可以让渲染变快。”(太浅了)
✅ 高级回答(直击底层):
“React 16 之前的架构是同步递归渲染,如果 DOM 树节点过万,一次更新可能远超 16ms,导致主线程被阻塞,浏览器掉帧。 Fiber 的本质是将 Virtual DOM 从树变成了链表结构。每一个 Fiber 节点都是一个独立的工作单元(包含
child,sibling,return,lanes等核心字段)。 结合 Scheduler,React 实现了时间切片(Time Slicing)和可中断渲染。它可以暂停低优先级的渲染任务,优先处理用户的交互输入,然后再恢复之前的渲染。这也是 Concurrent Rendering(并发渲染)的核心基础。”
三、现代前端工程化:不仅要会用,还要懂“为什么快”
Vite、Rspack 已经是标配,面试官需要你具备重构大型项目构建流的能力。
❓ 面试题:Vite 为什么比传统的 Webpack 快那么多?Rspack 呢?
❌ 普通回答: “因为 Vite 用了 ESM 模块,所以快。”
✅ 高级回答(多维度拆解):
“Vite 的快主要体现在四个维度:
- 不 Bundle(开发环境): Webpack 需要全量打包后才启动服务;Vite 利用浏览器原生 ESM,按需编译,请求什么模块就编译什么模块。
- esbuild 预构建: 依赖项使用 Go 语言编写的 esbuild 进行预构建,比 JS 编写的打包器快几十倍。
- 生产环境: 底层使用 Rollup,提供极其优秀的 Tree Shaking 和产物优化。
- HMR(热更新): 模块级别的热替换,不受项目体积增长的严重影响。
至于 Rspack 更快的原因,是因为它底层完全由 Rust 编写,借助 SWC 替代了 Babel 等工具链,并在内存布局(Memory Layout)和多线程并行计算上做了深度优化。”
四、全栈视野:BFF 层与性能调优
2026 年的高级前端,基本都要求具备 Node、Bun、Go 或 Java 等至少一门后端语言能力。
❓ 面试题:为什么在复杂的 C 端场景中,我们需要引入 Node BFF 层?
❌ 普通回答: “因为前端可以自己写接口,不用等后端排期。”
✅ 高级回答(面向用户体验与系统调用):
“BFF(Backend For Frontend)的核心价值在于接口聚合与裁剪。 在一个复杂的业务场景(比如用户个人中心),页面可能需要同时展示:订单状态、积分余额、优惠券数量、系统消息。如果让前端直接调后端微服务,会产生严重的跨域管理问题,且需要发起 4 次甚至更多网络请求(增加大量的 RTT 延迟)。 引入 Node BFF 层后:前端只需向 Node 发起 1 次请求。Node 在内网并发调用后端的多个微服务,进行数据清洗和聚合后,返回给前端一份刚好适配 UI 的数据。这极大减少了客户端的网络开销、简化了鉴权流程,并且可以利用 Redis 在 BFF 层做数据缓存。”
五、AI 与研发流:最重要的分水岭
“熟练使用 AI 辅助编程”绝对不是“我会用 ChatGPT 写个正则”。
❓ 面试题:你平时是如何利用 AI 提升日常研发效率的?
❌ 普通回答: “我遇到不会写的逻辑就问 Claude 或 GPT,然后把代码复制过来。”
✅ 高级回答(工程化视角):
“我已经将 AI 深度融入了完整的研发全生命周期:
- 需求阶段: 导入 PRD,利用 LLM 自动提取边界条件,生成状态流转图和 Mock 数据模型。
- 编码阶段: 依托 Cursor 和 GitHub Copilot 进行上下文感知补全;复杂的老代码重构时,利用 Claude 解释历史包袱并生成安全的 TypeScript 类型重构方案。
- CI/CD 阶段: 在流水线中接入自动化 Agent,对提交的合并请求进行 AI Code Review,不仅检查语法,还排查潜在的性能瓶颈(如无意义的重渲染)和安全漏洞。
- 应用侧全栈: 我在项目中实际落地过基于 LLM API 的智能业务模块(如基于 RAG 的文档问答、智能客服 Agent),熟悉 Embedding、向量数据库以及 Tool Calling 的工作流。 整体下来,团队的交付效率提升了约 35%,且 Bug 逃逸率显著下降。”
基于这份 2026 年高级前端 JD 的深度拆解,我们接着往下看,面试官还会用哪些硬核问题来检验你的真实水位。以下是为你补充的推文第六至第十部分:
六、跨端与小程序:别说你会写页面,说说“编译原理”
现在的业务往往要求多端覆盖,面试官一定会问跨端方案背后的底层逻辑,而不是 API 怎么调。
❓ 面试题:为什么不用 React Native?Taro 或 UniApp 为什么可以实现跨端?
❌ 普通回答: “因为 Taro 提供了统一的写法,一套代码可以多端运行。”
✅ 高级回答(直击编译本质):
“跨端框架的核心本质其实是编译,而不是单纯的运行时封装。 比如使用 Taro 时,它的流程是将 React JSX 转换为 AST(抽象语法树),随后通过自定义的转换逻辑(Transform),结合 Babel 插件和 Visitor,最后通过代码生成器(Code Generator),将其分别编译成微信模板、支付宝模板或是 H5 代码。 这样做的最大优势是,在运行时几乎没有厚重的 Bridge 通信损耗。所以,真正的跨端考验的是前端在编译构建层面的工程化掌控力,而不是死记硬背各家小程序的 API。”
七、前端监控:告别 console.log,建立企业级护城河
高级前端必须要对线上业务的稳定性负责。JD 中明确提到了前端监控,这通常是一道必考题。
❓ 面试题:如果让你从 0 到 1 设计一个企业级的前端监控平台,你会怎么做?
❌ 普通回答: “我会用 try...catch 捕获报错,然后通过 Ajax 发给后端。”
✅ 高级回答(体系化架构思路):
“我会将前端监控设计为四层采集体系加完整的数据上报与展示链路:
- 第一层 JS 异常监控: 通过全局监听
window.onerror捕获常规错误。- 第二层 Promise 异常: 监听
unhandledrejection处理未捕获的异步报错。- 第三层 接口监控: 劫持并重写
fetch、axios或XMLHttpRequest以收集请求成功率和耗时。- 第四层 核心性能监控: 利用
PerformanceObserver收集核心 Web Vitals 指标,如 LCP、CLS、FID 和 INP 等。在上报阶段,为了防止高并发拖垮后端,我会设计统一的上传策略,数据先打入 Kafka 进行削峰,落盘到 ClickHouse 用于海量日志分析,最后通过 Grafana 配置可视化数据大盘与告警规则,形成闭环。”
八、性能优化:别再拿“懒加载”敷衍面试官
性能优化是高级前端的看家本领,但如果你没有体系化的方法论和真实数据,直接就会被 Pass。
❓ 面试题:你做过哪些深度的前端性能优化?
❌ 普通回答: “我做了图片压缩、组件懒加载,还有打包时把文件变小。”
✅ 高级回答(五大维度与数据说话):
“我对性能优化有一套系统的方法论,通常会从五个维度去诊断和改进:
- 网络层: 推进落地 HTTP2、CDN 预热以及强缓存策略。
- 资源层: 严格配置 Tree Shaking 清理冗余代码,实施 Code Split 细化包体积,并开启 Gzip 与 Brotli 压缩。
- 渲染层: 针对长列表采用 Virtual List,精准使用
React.memo与 Suspense 控制组件不必要的重渲染。- 数据层: 引入防抖节流,使用 SWR 进行请求缓存处理。
- 监控层: 借助 Lighthouse 和 Web Vitals 建立长效机制。
业务收益(敲黑板,重点): 通过这套组合拳,我将核心页面的 LCP 从 4.5s 降到了 1.8s,CLS 从 0.35 优化到 0.03,总体 Bundle 体积由 6MB 缩减至 1.9MB。”
九、AI 应用开发 (LLM & Agent):2026年最核心的溢价点
“参与过 Agent 类项目”赫然写在 JD 上。如今,前端离 AI 最近,能把 AI 转化为产品体验的人,最值钱。
❓ 面试题:你开发过 AI 相关的项目吗?具体是怎么落地的?
❌ 普通回答: “我调用过 OpenAI 的接口,做了一个类似 ChatGPT 的网页聊天框。”
✅ 高级回答(深入 RAG 与 Agent 工作流):
“我主导开发过企业级的 RAG(检索增强生成)知识库问答和智能客服系统。 完整的数据与业务流是: 前端(React)负责交互并上传 PDF 文档,Node 后端接收后解析文档并进行分块,随后调用 Embedding 模型将文本转化为向量并存入向量数据库。当用户提问时,系统会先在数据库进行 TopK 相似度检索,再将召回的上下文拼接后喂给 LLM,最终流式输出回答。 除此之外,我不仅限于 Prompt 调用,还深入实践过 Function Call 和 Tool Calling,并能基于 Memory 和 Workflow 编排 Multi-Agent(多智能体)去解决链路极长的复杂业务需求。”
十、终极考验:系统设计与真实面试推演
如果让你去面这份岗位,面试官大概率会为你准备一场极具压迫感、长达近两个小时的“技术拷问”。
通常会按照这样的节奏展开:
- 第一部分:项目深挖(约 30 分钟)。 面试官会盯着你负责的最复杂的业务模块,问你为什么这么拆分?权限系统如何设计?线上事故怎么排查?如何做国际化与多租户架构?
- 第二部分:React 深度(约 40 分钟)。 深入拷问 Fiber 字段作用、Scheduler 时间切片原理、状态批处理机制,甚至让你聊聊 React Compiler 解决了什么问题。
- 第三部分:工程化(约 30 分钟)。 探讨 Vite 与 Rspack 差异、Monorepo 的设计优劣、以及 CI/CD 流水线与 A/B Test 灰度发布的真实落地经验。
- 第四部分:全栈与 AI(约 30 分钟)。 讨论 BFF 职责、大文件断点续传设计、LLM API 的 Token 管理策略以及如何规划一个完整的 AI 辅助研发平台。
💡 给你的冲刺建议 如果你渴望拿下 30K~50K 的高级前端/Tech Lead Offer,你需要具备从 0 到 1 设计一个中型产品的系统架构能力,并能量化各项指标的提升。把你学习的重点放在:React 源码机制、深度工程化体系、Node/Bun 全栈开发,以及前沿的 AI 工程能力(RAG、Agent)上。
最后
如果说程序员已经是高薪职业,那么干AI的程序员,就是高薪中的高薪。

现在的市场,已经用数据给程序员指明了方向:学AI大模型,就是冲刺高薪的最优解!

看着身边越来越多的同行转型大模型、拿到高薪offer,很多人心里都动了心,但真正的难题来了:零基础小白不知道从哪入门?有基础的程序员找不到系统学习路径?实战项目练手无门?面试不知道考什么?
别慌!今天就给大家整理了一份【2026年最新版】AI大模型免费学习资源包,覆盖从入门到实战、从理论到面试、从基础到进阶的全流程,所有资料均已整理归档,无冗余、无套路,免费分享给每一位想抓住AI风口的程序员和小白!
👇👇扫码免费领取全部内容👇👇

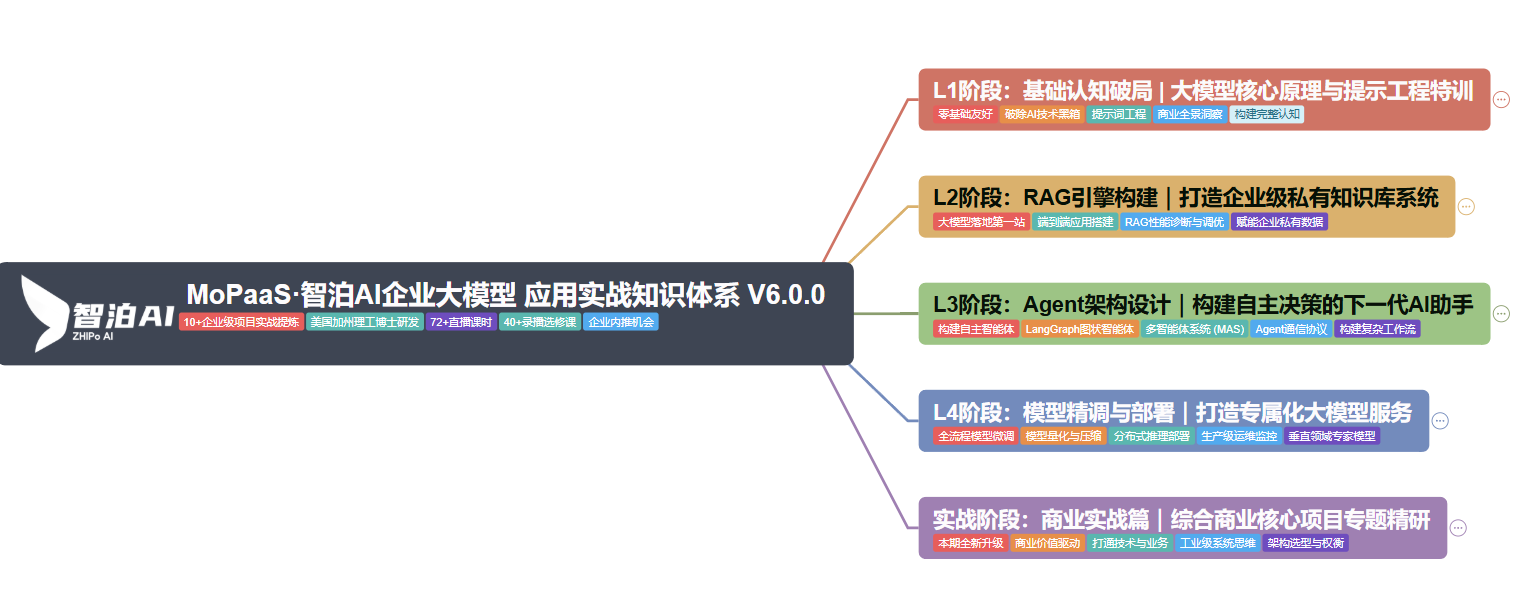
1、大模型系统化学习路线
2、大模型学习书籍&文档

3、AI大模型最新行业报告
4、大模型项目实战&配套源码

5、大模型大厂面试真题

四阶段精细化学习规划(附时间节点,可直接照做)
结合上述资源,给大家整理了一份可直接落地的四阶段学习规划,总时长约2个月,小白可循序渐进,程序员可根据自身基础调整节奏,高效掌握大模型核心能力,快速实现从“入门”到“能落地、能面试”的跨越。
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
👇👇扫码免费领取全部内容👇👇
6、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 3323


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


