


本文分享了字节跳动后端校招面试的核心考点,涵盖设计模式(策略模式、责任链模式)、HashMap并发安全、MySQL索引优化、消息队列与分布式事务等硬核知识。从数据库层面到应用层,详细解析了高并发扣减库存的优化策略,并对比了RabbitMQ与RocketMQ的优劣。
我之前还以为今年小红书校招薪资能稳坐第一呢,毕竟月薪基本都 30k 往上,高的都能冲到 38k。
结果字节一开奖,直接绝杀全场!后端开发岗的 base 薪资居然有开到 40k + 的,再加上签字费,第一年总包直接干到 70 万以上。

这薪资真的离谱到家了,不光是今年最高,估计也是字节校招历史以来最高的。这入职不得直接是 2-1 级别?老员工要是看到旁边刚毕业的应届生,薪资比自己还高,不得偷偷哭晕?
不过能拿到 40k+base 的还是少数人,大部分同学的薪资还是在 25k-35k 这个区间。
我特意收集了一波已开奖的开发岗薪资(后端/客户端/前端/大数据开发),整理出来给大家参考:
| 档次 | 薪资构成 | 总包(第一年) |
|---|---|---|
| SSP+ | 40k×15 + 10w(签字费) | 70w |
| SSP | 36k×15 + 9w(签字费) | 63w |
| SSP | 38k×15 + 5w(签字费) | 62w |
| SSP | 35k×15 + 8w(签字费) | 60.5w |
| SSP | 34k×15 + 9w(签字费) | 60w |
| SSP | 32k×15 + 5w(签字费) | 53w |
| SP | 30k×15 + 1w(签字费) | 46w |
| SP | 29k×15 | 43.5w |
| SP | 28k×15 | 42w |
| 白菜档 | 26k×15 | 39w |
上面的薪资档次是我自己猜的啊,不是官方数据,仅供大家心里有个数。
跟 HR 谈薪的时候,要是他明确说 base 没法再涨了,你可以试试多要点头签字费,说不定有戏。
这时候 HR 一般会帮你内部申请申请,要是你手上还有其他同级别公司的 offer,成功率就更高了。
所以有时候你会发现,有些 base 高的签字费,反而不如 base 低的多,大概率就是谈薪时 base 涨不动了,公司就用签字费补了。
现在都快 12 月了,但我还是想鼓励还在秋招的同学:春节前都别放弃投递!就算之前投过的公司,也多去官方招聘网更新下简历,这个动作真的有用。
后面这几个月,捡漏 offer 的机会特别大, 现在各大公司开奖都差不多了,肯定有很多人拒 offer,HC 一空出来,说不定你就能速通面试,直接拿下 offer。
这次就给大家看看今年字节跳动的后端一面校招面经。我感觉这场面试考察得挺有深度,特别值得学习。它不只是单纯问八股,更多是考察你对知识点背后逻辑的理解。
主要考的知识点有设计模式、Java 集合、MySQL 索引、消息队列、分布式事务这些,都是实打实的硬知识。

字节跳动(后端一面)
1. 介绍一下策略模式和责任链模式,分别用在哪些场景?
这两个设计模式都属于行为型模式,而且在实际开发中,它们往往都是为了解决同一个痛点:如何消除代码中复杂的if-else或switch-case逻辑,从而让系统更易于扩展。
策略模式
策略模式定义一系列算法,把它们一个个封装起来,并且使它们可相互替换。从而让算法可独立于使用它的客户而变化。
假设你正在开发一个电商网站的支付模块。用户可以选择支付宝、微信支付或者银行卡支付。每种支付方式的底层逻辑(比如调用的 API、加密方式、参数构造)都完全不同,但对于调用支付功能的上层业务逻辑来说,它只需要调用一个统一的 “支付” 方法即可,无需关心具体是哪种支付。
这就是策略模式的用武之地。我们把每种支付方式(支付宝、微信)都封装成一个独立的 “策略” 类,它们都遵循一个共同的接口。上层业务代码通过这个共同的接口来调用支付功能,并可以在运行时根据用户的选择,动态地切换不同的策略。
所以,策略模式适用场景如下:
- 当一个系统需要动态地在几种算法中选择一种时。
- 当一个对象有很多行为,不想使用大量的
if-else或switch-case语句来选择时。 - 当你希望算法的变化不会影响到使用它的客户端时。
责任链模式
责任链模式核心思想是为请求创建一个接收者对象的链。对请求的发送者和接收者进行解耦,让多个对象都有机会处理这个请求。请求沿着链传递,直到链上的一个对象处理它为止。
想象一下公司里的请假审批流程。一个员工要请假,他首先会把请假条交给自己的直属经理。如果请假天数很短(比如 1 天),经理自己就能批准。如果天数较长(比如 5 天),经理没有权限,就需要把请假条上报给部门总监。总监也有自己的审批权限上限,如果超过了,就需要继续上报给总经理。
在这个过程中,请假条(请求)就在一条由经理 -> 总监 -> 总经理(接收者链)上传递,直到某个角色(接收者)能够处理它。发送请假条的员工(客户端)并不知道最终是谁批准了他的假,他只需要把请求提交给链的第一个节点(经理)即可。
所以,责任链模式适用场景总结:
- 当有多个对象可以处理同一个请求,但具体由哪个对象处理需要在运行时决定时。
- 当你希望请求的发送者和接收者解耦,不直接通信时。
- 当你需要动态地指定和修改处理一个请求的对象集合时。
2. HashMap并发不安全的原因是什么?
HashMap 之所以并发不安全,根源在于它为了性能,摒弃了所有同步手段。
- 在 JDK 1.7 中,并发扩容导致的链表成环是最大隐患,会导致 CPU 飙升。
- 在 JDK 1.8 中,虽然修复了成环问题,但并发执行
put操作时的竞态条件会导致数据覆盖,依然是不安全的。
除了上述两个核心结构上的问题,还有一个更基础的并发问题,那就是 size计数。
HashMap 内部有一个 size 变量来记录键值对的数量。无论 1.7 还是 1.8,这个 size++ 操作都不是原子性的。它分为读取、增加、写回三步。多线程下,两个线程同时拿到旧值,同时加 1,最后写回。结果就是明明插入了两个数据,size 却只增加了 1。
如果业务场景涉及多线程,我肯定不会去用 HashMap,而是直接上 ConcurrentHashMap,或者在极少写入的场景下用 Collections.synchronizedMap 包装一下。
3. HashMap为什么使用拉链法解决哈希冲突?
设计 HashMap 时,本质上是在开放寻址法和拉链法之间做权衡。Java 选择拉链法,我认为主要看重了它的隔离性和扩展上限。
- 第一,避免“堆积”效应。开放寻址法遇到冲突要往后找空位,数据容易连成一片,导致后续插入和查询越来越慢。而拉链法的冲突是隔离的,Bucket A 的拥堵绝对不会影响 Bucket B,即使负载较高,性能下降也更平缓。
- 第二,删除操作简单。开放寻址法删除元素很棘手,为了不断掉查找链路,通常需要打标记,逻辑复杂且容易出错。而拉链法本质是链表,删除节点只需调整指针,逻辑非常干净。
- 第三,也是最关键的,它为 JDK 1.8 的红黑树优化提供了基础。正是因为数据通过拉链聚在了一起,当链表过长时,我们才能将其“原升级”为红黑树,将查询复杂度锁定在 O(log n)。如果是散落在数组各处的开放寻址法,就很难做这种局部的数据结构“进化”了。
综合来看,HashMap 作为通用组件,拉链法的下限更高,处理极端冲突的能力更强。
4. MySQL建立索引的字段的要求是什么?
判断一个字段是否适合建立索引,我主要依据四个硬性指标,核心逻辑是保证查询效率提升的同时,将对写性能和存储的负担降到最低。
第一,字段的区分度(基数)必须高。 这是最关键的指标。如果一个字段的取值很少(比如性别、状态枚举),大量数据重复,MySQL 优化器往往会认为全表扫描比走索引更快,导致索引失效。只有当字段能过滤掉绝大部分数据时(比如 ID、手机号),索引的效率才高。
第二,必须是高频被使用的字段。 索引字段必须经常出现在 WHERE 查询条件、JOIN 连接条件、或者 ORDER BY 和 GROUP BY 语句中。特别是作为 JOIN 关联字段时,不仅要建索引,还必须保证左右两张表的字段类型完全一致,避免因类型转换导致索引失效。
第三,字段长度尽量小。 字段占用的字节越少,单个 B+ 树索引页(Page)能存储的节点就越多,一次磁盘 IO 能读取到的索引数据也就越多。对于长字符串(如 varchar 255),我不建议全字段索引,而是应该指定长度建立前缀索引。
第四,更新频率不能过高。 索引虽然加速了查询,但会拖慢写入。每次字段更新,数据库都需要同步调整 B+ 树的结构。如果某个字段(如“访问计数”)变化极快,维护索引的代价会超过查询带来的收益,这种字段不适合建索引。
简单来说,我会优先选择那些区分度高、频繁参与查询、字节长度小且更新相对稳定的字段建立索引。
5. 一张表有主键id、a、b三个字段,where条件使用a字段,如何优化查询?
我会从索引策略和查询结构两个维度分层次进行优化。
首先,最基础的操作肯定是在 a 字段上建立索引。这是为了解决最根本的问题,将全表扫描转化为 B+ 树的范围查找,这是性能提升的第一步。
其次,为了追求极致性能,我会进一步检查 SQL 语句中需要 SELECT 出来的字段。如果查询涉及 b 字段(例如 SELECT b FROM table WHERE a = ?),单给 a 建索引是不够完美的,因为数据库通过 a 的索引找到主键 ID 后,还需要进行一次“回表”操作去聚簇索引中获取 b 的数据。
在这种情况下,我会选择建立 (a, b)的联合索引。因为在 InnoDB 中,联合索引的叶子节点本身就包含了 a、b 的值以及主键 id。这样一来,查询所需的所有数据都能直接在索引树上取到,实现了覆盖索引,完全避免了回表的随机 IO 开销,这才是效率最高的方案。
最后,我也会排查一下客观条件。比如确认 a 字段的区分度是否足够高,如果 a 的重复数据太多,索引可能根本不会生效。同时,我要确保 SQL 语句中没有对 a 字段做函数运算或者发生了隐式类型转换(比如字符串没加引号),防止因为语法问题导致前面的索引优化全部失效。
6. 如果a字段是一个文本类型(大json),无法建立索引,如何优化查询?
面对这种无法直接建立索引的大文本或 JSON 字段,单纯的“硬查”肯定会导致全表扫描。我会根据具体的查询业务场景,采用不同的策略来绕过这个限制:
第一种情况:如果业务是根据 JSON 内部的某个特定字段查询。 这是最常见的场景。比如 WHERE a->'$.status' = 1。 我会使用 MySQL 5.7+ 引入的 “虚拟列” 功能。我可以创建一个虚拟列,专门提取 JSON 中的 status 字段,然后直接给这个虚拟列建立索引。 这样既不需要修改原有数据结构,又能利用 B+ 树索引直接定位到行,这是处理 JSON 字段查询最高效的方法。
第二种情况:如果业务是查询整个文本的“完全匹配”。 比如 WHERE a = '一大段特定的JSON字符串'。 直接比对字符串太慢且无法建索引。我会引入一个辅助字段,比如 a_hash。在插入或更新数据时,同步计算内容 a 的 MD5 或 CRC32 值存入 a_hash,并给 a_hash 建索引。 查询时,改为 WHERE a_hash = ? AND a = ?。先通过 Hash 值快速过滤出极少数候选行,再通过文本比对确认最终结果,性能提升非常明显。
第三种情况:如果业务是模糊查询或关键词搜索。 比如 WHERE a LIKE '%关键词%'。 这种情况下 B+ 树索引基本失效。如果并发量不大,可以尝试 MySQL 自带的 Full-Text 全文索引(倒排索引机制)。但如果数据量级非常大且查询复杂,我会建议将这部分数据同步到 ElasticSearch 这样的搜索引擎中进行处理,MySQL 仅负责存储原数据,不再承担此类查询压力。
核心思路是 “把不可索引的数据转化为可索引的数据”。 如果是查 JSON 里的值,就抽离出虚拟列建索引;如果是查全量内容,就利用 Hash 映射建索引;如果是搜文本,就走全文检索。
7. 一张表,有主键id和库存数量两个字段,每次一个请求会对库存数量减1,如何突破性能瓶颈?
针对这个高并发扣减库存的场景,核心瓶颈非常明确:在于数据库的行锁竞争。
因为所有请求都在更新同一行数据,InnoDB 必须按顺序排队处理,这会导致严重的锁等待和上下文切换,数据库的 TPS 会被限制在这个单行的处理能力上。要突破这个瓶颈,我的优化思路如下。
首先,在数据库层面,我会采用“热点库存分段”的策略。 既然瓶颈是所有的压力都打在同一行 id 上,那我就把这一行库存拆解成多行。比如,把总库存 1000 拆分成 10 条记录,每条存 100,放在一张子表里。当请求进来时,我随机(或轮询)选择其中一条子记录进行扣减。这样一来,我就把针对一把锁的竞争,分散到了 10 把锁上,理论上数据库的并发性能直接提升了 10 倍。
如果分段锁的性能还是不够,或者不想改动数据库结构,我会将扣减逻辑上移到 Redis。 Redis 是基于内存的操作,且单线程天然无锁竞争(针对单个命令),性能远超数据库。我会编写一个 Lua 脚本,在脚本里原子性地执行“判断库存是否充足”和“执行 DECR”这两个动作。前端流量全部挡在 Redis 层,只有扣减成功的请求,才会被允许进入下一步。
这里引入了一个新问题:Redis 和数据库的数据一致性。 为了不让数据库拖后腿,我不会同步回写数据库,而是采用“异步架构”。Redis 扣减成功后,发送一条消息到消息队列(MQ),由后端服务消费消息,慢慢地将最终的库存变动更新回数据库。这样,数据库只承担持久化存储的功能,不再承担高并发的实时扣减压力。
最后,为了进一步极致优化,我会在应用层做“请求合并”*。 我可以在内存中维护一个队列,每积攒 100 个请求或者每过 100 毫秒,就把这一批扣减合并成一次数据库操作(比如 stock = stock - N)。这样能极大地减少网络 IO 和数据库交互次数。
8. 介绍一下RabbitMQ和RocketMQ的不同点?
简单来说,RabbitMQ 追求灵活性和标准性,而 RocketMQ 追求高吞吐量和在复杂分布式场景下的稳定性。
我会从三个主要维度来介绍它们的不同:
1、 基础架构与协议
- RabbitMQ: 它是基于 Erlang 语言开发的,默认使用 AMQP协议,这是一个国际标准。这种设计让 RabbitMQ 在处理复杂的路由规则时非常强大且灵活,但在高并发下,其 Erlang 运行时和协议的解析会有一定的性能开销。
- RocketMQ: 它由阿里巴巴基于 Java 开发,使用自定义的私有 TCP 协议。这种协议完全是为了高吞吐量而定制的,并且整个架构引入了 NameServer 进行元数据管理,Broker 节点可以轻松地进行水平扩展,这是它应对大规模流量的基础。
2、存储机制与性能
这是两者最大的区别,直接决定了性能上限。
- RabbitMQ: 它的消息处理更依赖内存和标准的文件 I/O。当消息堆积时,虽然会将消息落地到磁盘,但磁盘 I/O 效率相对不高,因此它不太擅长处理大规模的消息积压。它更适合低延迟、小消息量的场景。
- RocketMQ: 它的核心设计是为了追求极致的性能和可靠性。它采用内存映射文件,所有消息都以顺序追加的方式写入 CommitLog 文件,并利用操作系统页缓存机制进行读写优化。这种设计让 RocketMQ 能够充分利用磁盘的顺序写优势,因此在高并发、高吞吐和消息堆积的场景下表现极其出色。
3、特性支持与业务场景
于 RocketMQ 是为大规模电商交易场景设计的,它提供了 RabbitMQ 缺失的关键特性:
- 事务消息: RocketMQ 原生支持分布式事务消息,能够保证生产者发消息和本地事务的原子性,这对于电商订单、支付等业务至关重要。RabbitMQ 需要依赖外部补偿机制或 TCC 模式实现。
- 顺序消息: RocketMQ 可以保证一组消息(比如同一订单的所有操作)严格按照发送顺序进行消费,这在处理业务逻辑强依赖时序的场景非常实用。
- 延迟/定时消息: RocketMQ 原生提供定时消息功能(通过特定的延迟等级实现)。
如果需要复杂的路由逻辑,或者要求使用AMQP 等标准协议进行跨平台集成,我会选择 RabbitMQ。但如果面对的是日均百亿级以上的高并发、大吞吐、需要事务性或顺序性的互联网场景,RocketMQ 则是更可靠、性能更高的选择。
9. 如何本地实现事务消息?
首先要明确,“本地事务消息” 并非标准的分布式事务解决方案(如 2PC、TCC、Saga),而是一种轻量级的、基于本地事务 + 消息队列的异步一致性方案。
核心目标是:在本地事务执行成功后,确保消息可靠发送;若本地事务失败,消息不发送,从而保证 “本地操作” 与 “消息发送” 的原子性,避免数据不一致。
其核心设计思想是 “本地事务与消息存储在同一个数据库中,利用数据库事务的原子性来保证消息的可靠性”。

整个实现流程可以分解为以下三个关键步骤:
1、本地事务中的原子操作
首先,在应用服务内部,我会启动一个本地数据库事务。在这个事务中,我们执行两个操作:
- 业务数据修改: 比如扣减库存。
- 插入发件箱记录: 向一张专门的
Outbox表中插入一条记录。这条记录包含了需要发送的消息的所有信息(如 Topic、Payload、状态)。
因为这两个操作处于同一个数据库事务中,要么同时成功,要么同时失败。这样就保证了业务数据变更和发送消息的意图在本地是原子性的。
2、消息接力与转发
本地事务提交成功后,业务数据和待发送的消息记录都已经安全地持久化到了数据库中。接下来需要一个机制将这个“意图”转化为实际的消息发送:
- 轮询机制: 部署一个独立的 Relay 服务(接力服务),定期扫描
Outbox表中状态为“待发送”的新记录。 - 或者用阿里巴巴的 canal 组件,它直接监控数据库的事务日志(Binlog),一旦发现
Outbox表有新记录,就立即捕获并通知 Relay 服务。
Relay 服务获取到发件箱记录后,负责将消息发送给实际的消息队列(如 RabbitMQ 或 Kafka)。
3、状态更新与幂等性保证
Relay 服务成功将消息发送到 MQ 后,会回来更新 Outbox 表中对应记录的状态,将其标记为“已发送”或直接删除。
这里需要注意的是,消息发送和更新 Outbox 状态这两个动作,本身并不是一个事务。因此,如果 Relay 服务发送成功了,但在更新 Outbox 状态时失败了,会导致消息被重复发送。
所以,事务发件箱模式对下游消费端有严格要求:必须保证幂等性。消费者接收到消息后,必须能够安全地处理重复的消息,这是保证最终一致性的关键环节。
通过这种模式,我们把原本需要分布式协调的难题,转化为了单个本地数据库事务的原子性和异步的消息接力,从而实现了业务操作和消息发送的可靠一致性。
10. 说一下你对分布式事务的理解?
在单体应用中,我们靠本地事务来保证操作的 ACID。但在分布式环境中,由于资源是隔离的,一个操作可能需要在 A 服务扣库存,B 服务创建订单,这两步必须同时成功或失败。
常见的分布式事务解决方案如下:
| 方案 | 一致性 | 性能 | 复杂度 | 适用场景 |
|---|---|---|---|---|
| 2PC | 强一致性 | 低 | 中 | 传统数据库、XA协议 |
| 3PC | 强一致性 | 中低 | 高 | 需减少阻塞的强一致场景 |
| TCC | 最终一致性 | 高 | 高 | 高并发业务(支付、库存) |
| Saga | 最终一致性 | 中 | 高 | 长事务、跨服务流程 |
| 消息队列 | 最终一致性 | 高 | 中 | 事件驱动架构 |
| 本地消息表 | 最终一致性 | 中 | 低 | 异步通知(订单-积分) |
- 两阶段提交协议(2PC):为准备阶段和提交阶段。准备阶段,协调者向参与者发送准备请求,参与者执行事务操作并反馈结果。若所有参与者准备就绪,协调者在提交阶段发送提交请求,参与者执行提交;否则发送回滚请求。实现简单,能保证事务强一致性。存在单点故障,协调者故障会影响事务流程;性能低,多次消息交互增加延迟;资源锁导致资源长时间占用,降低并发性能。适用于对数据一致性要求高、并发度低的场景,如金融系统转账业务。
- 三阶段提交协议(3PC):在 2PC 基础上,将准备阶段拆分为询问阶段和准备阶段,形成询问、准备和提交三个阶段。询问阶段协调者询问参与者能否执行事务,后续阶段与 2PC 类似。降低参与者阻塞时间,提高并发性能,引入超时机制一定程度解决单点故障问题。无法完全避免数据不一致,极端网络情况下可能出现部分提交部分回滚。用于对并发性能有要求、对数据一致性要求相对较低的场景。
- TCC:将业务操作拆分为 Try、Confirm、Cancel 三个阶段。Try 阶段预留业务资源,Confirm 阶段确认资源完成业务操作,Cancel 阶段在失败时释放资源回滚操作。可根据业务场景定制开发,性能较高,减少资源占用时间。开发成本高,需实现三个方法,要处理异常和补偿逻辑,实现复杂度大。适用于对性能要求高、业务逻辑复杂的场景,如电商系统订单处理、库存管理。
- Saga:将长事务拆分为多个短事务,每个短事务有对应的补偿事务。某个短事务失败,按相反顺序执行补偿事务回滚系统状态。性能较高,短事务可并行执行减少时间,对业务侵入性小,只需实现补偿事务。只能保证最终一致性,部分补偿事务失败可能导致系统状态不一致。适用于业务流程长、对数据一致性要求为最终一致性的场景,如旅游系统订单、航班、酒店预订。
- 可靠消息最终一致性方案:基于消息队列,业务系统执行本地事务时将业务操作封装成消息发至消息队列,下游系统消费消息并执行操作,失败则消息队列重试。实现简单,对业务代码修改小,系统耦合度低,能保证数据最终一致性。消息队列可靠性和性能影响大,可能出现消息丢失或延迟,需处理消息幂等性。适用于对数据一致性要求为最终一致性、系统耦合度低的场景,如电商订单支付、库存扣减。
- 本地消息表:业务与消息存储在同一个数据库,利用本地事务保证一致性,后台任务轮询消息表,通过MQ通知下游服务,下游服务消费成功后确认消息,失败则重试。简单可靠,无外部依赖。消息可能重复消费,需幂等设计。适用场景是异步最终一致性(如订单创建后通知积分服务)。
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
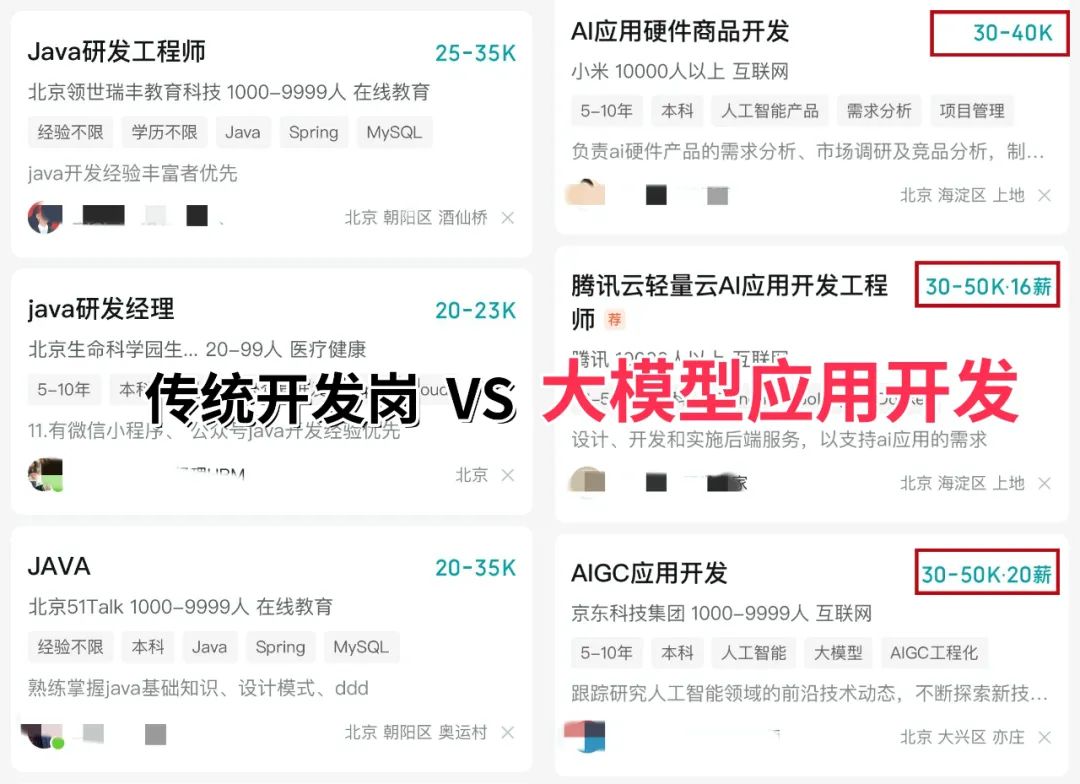
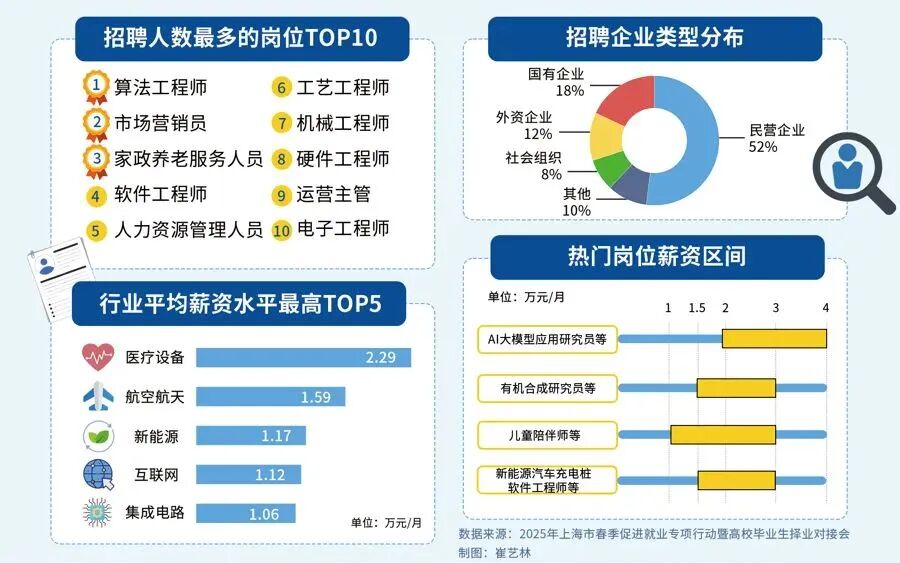
对于想入局大模型、抢占未来10年行业红利的程序员和小白来说,现在正是最好的学习时机:行业缺口大、大厂需求旺、薪资天花板高,只要找准学习方向,稳步提升技能,就能轻松摆脱“低薪困境”,抓住AI时代的职业机遇。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。

👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线

2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。

3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)

4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

5、面试试题/经验

【大厂 AI 岗位面经分享(107 道)】
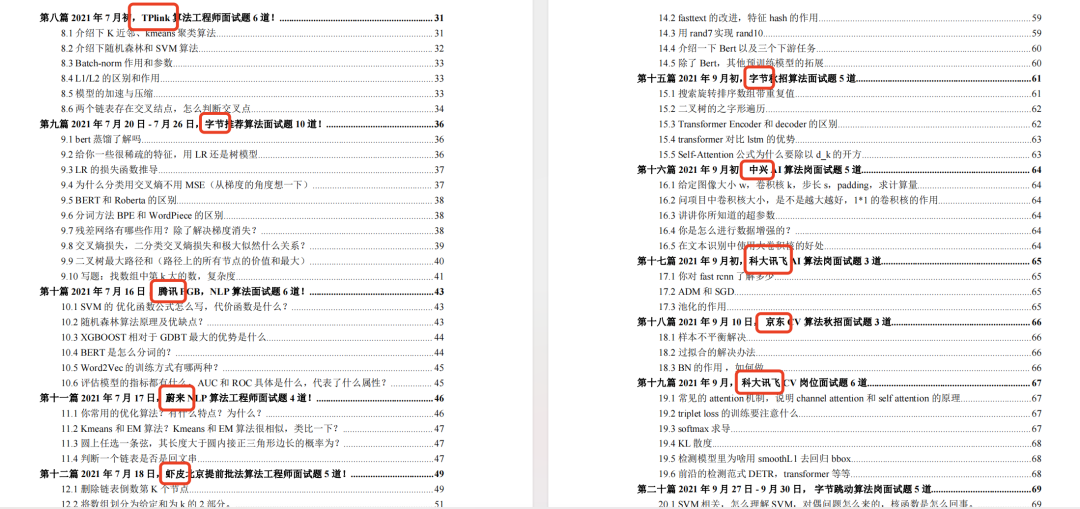
【AI 大模型面试真题(102 道)】
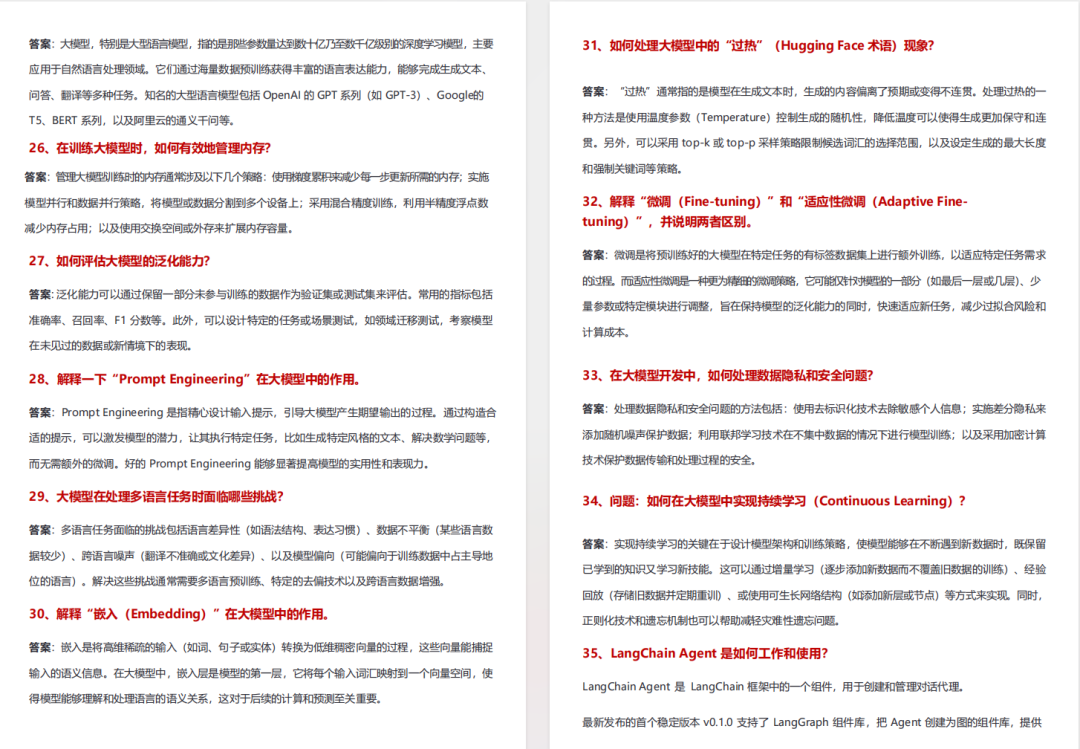
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码

适用人群

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇
3、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 9425


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


