


本文深入探讨了Agent应用的开发,从广义和狭义的定义出发,阐述了完整智能Agent系统应具备的五大能力:规划、行动、观察、工具调用和学习。文章详细介绍了Agent开发的三阶段流程,重点讲解了功能实现和工程优化阶段的关键技巧,如最小上下文原则、最低信息熵原则、ReAct模式等。此外,还探讨了上下文工程的重要性以及如何用好提示词,最后强调了大模型作为工具的价值,并指出工程师的技术护城河在于领域知识和LLM工具驾驭能力。
一、什么是Agent
狭义上的Agent:完全无人监督、自主拆解目标、寻找资源、使用工具,完成全部工作的系统广义上的Agent:指以 LLM(大语言模型)为核心驱动,具备基础任务响应与外部交互能力的系统市面上百分之99的Agent应用,其实只属于广义-简单Agent的范畴
一个真正完整且智能的智能Agent系统,以下五个能力缺一不可
- Planning:自行对任务进行详细拆解,完成执行方案规划
- Action:根据方案,按流程一步步执行
- Observation:在Action过程中,应当能动态感知环境反应,动态调整规划
- Tool_call:具备精准调用外部工具来解决任务的能力
- Learning:能自主学习好坏case、外部新知识、新工具,不断进化
在目前的Ai Coding领域:
- 目前图形化的cursor和命令行claude-code,在前4个能力上已做的相当完备
- 但是最后一个——Agent的自主学习能力,尚任重道远
- 它要求Agent能自动学习新知识、调用新工具、学习交互的good case、bad case转化为经验
二、怎么做出一个Agent
广义上的功能性Agent开发流程大体上可以分为三个阶段****架构选择、功能实现、工程优化
- 架构选择阶段:根据业务特点、QPS、准确率、稳定性等需求选择合适的编程语言/工作流平台、后端服务架构
- 功能实现阶段:实现业务的Agent解决方案
- 工程优化阶段:
- 准确率优化
- 效率优化
- 成本问题
这里我想重点讨论功能实现和工程优化;怎么才能做好这两个阶段呢?
2.1功能实现阶段
2.1.1How?Why?
如何让Agent能够完美地完成任务?
多项研究表明——因为Transformer架构固有局限,随上下文逐步增长,LLM注意力逐渐分散,回归能力逐渐下降大模型的生成过程本质是预测,会根据用户给出的信息,逐渐去“预测”最优质的回答大模型接收到的上下文,本质上就是一种信息,用于消除预测过程中的不确定性,降低其信息熵
我认为,在Agent开发过程中**,完美遵守下面两个原则,就可以——开发出一个可用、高效的Agent**
- 最小上下文原则:每次交互中,给大模型的上下文尽可能小
- 最低信息熵原则:需要清晰、精确、完整地表述需要大模型完成的任务
因此:和大模型交互,其实就是一种语言的艺术——最少的词语,完成最完整意图的表述
2.1.2How to do?
应该怎么做才能完美遵守上面的原则呢?
-
工具调用:正确指导LLM在合适的时候用对应的工具,而不是给多个工具让它选择
-
上下文管理
-
只给主agent最重要的关键信息,sub agent去filter其他信息
-
不重要的信息/当下用不到的历史信息,不代入上下文
-
使用外部存储技术,存储在文件/数据库/临时变量中;在需要时再做回归
-
非必要,不Ai:固定的流程使用固定函数完成,不要为了用Agent而用
-
在需要LLM动态执行的模块,一定要给出最精致的prompt——最准确的上下文信息
2.2工程优化阶段
功能完整后,如何让Agent在线上环境稳定、高效、低成本地运行?
- 准确率/稳定性优化:整个工作流必须以高准确率完成用户的需求
- 效率优化:步骤合并、任务并行
- 成本问题:更小的模型、更小的上下文窗口、蒸馏后的模型
2.2.1准确率/稳定性优化
大模型每次输出都不稳定,Agent的多次调用,会导致结果更加不稳定可以用一个不太严谨的计算方式来理解假设单轮回答符合对的期望是0.8,那经过10次迭代,0.8^10,正确回答的期望就是0.1074
实用技巧——完成Agent输出的超高准确率
-
任务拆解:将复杂任务拆分别更细粒度子步骤,减少单步误差累计
-
多轮校验机制:关键的中间结果增加校验,无效则重新规划&生成
-
异常兜底策略:预设每一个节点的故障处理方案
-
工具超时、接口报错、多轮准确率不达标等问题;都要建立流程上的兜底或信息上的兜底
-
定制化微调:总结Agent历史调用链中的good case,合并为数据集,进行微调
2.2.2效率优化
- 步骤合并与剪枝:剔除冗余步骤,简化非必要流程;固定步骤函数化
- 任务并行处理:支持多工具/子任务同时执行
- 预处理缓存:缓存高频复用数据(避免重复请求、计算)
- 模型优化:使用更小参数的模型
- 响应优先级调度:高实时性任务实时调用,近线任务采用离线推理
2.2.3成本优化
-
模型优化:
-
轻量化:在能完成任务的前提下,尽量选小参数模型(我实践中:小参模型迭代多次,效果一般好过大参模型一次生成)
-
模型蒸馏:对模型微调后再蒸馏
-
上下文窗口压缩:通过摘要、关键词提取、文本精简、无关信息filter等
-
资源动态调度:非高峰时段减少算力节点,高峰时段动态扩容
2.3如何让agent乖乖听话
一个Agent其实是由多个小模块组成的,其实Agent的开发过程和“搭积木”很像在搭积木过程中,需要不断地回过头去检查当下的结果——是否多用了零件、桌子有没有少一个腿、房间会不会太小了那么,想用积木搭好一个城堡,我们应该怎么做呢?
- 建筑图纸:整个城堡应该有多少层、多少个房间、最终是什么样子、什么设计风格
- 完成小模块:先拼接好书桌、床、电视机等一个又一个小模块
- 模块协同:将一个又一个小模块“协同”起来,成为一个大城堡
完成整个城堡的过程其实和Agent常用也是最有效的工作模式ReAct几乎一摸一样:Reasoning、Action、ObservationReAct 模式的核心是通过 “推理 - 行动 - 感知” 的闭环循环,让 Agent 具备处理复杂任务的能力其设计逻辑可拆解为三个核心环节及闭环机制:
- Reasoning(推理):Agent 会先解析用户需求,拆解目标为可执行的步骤,并判断当前是否需要调用工具。
- Action(行动):按推理阶段的规划执行具体操作,包括直接生成内容或调用外部工具
- Observation(观察):接收并解析行动阶段的输出(如工具返回结果、错误信息),判断是否符合预期
- 若数据完整,则将结果反馈给推理环节,进入下一轮规划;若出现异常,则触发推理环节重新决策
还有其他很多设计模式,但是其实核心思想都类似,这里不再展开:Cot、AutoGPT…
三、最近很火的上下文工程是啥
上下文工程来源
- 对经典的文本这单一模态而言,使用llm的唯一方式是一次性的一问一答
- 为了提出更好的问题引导更好的回答,发展出了提示词工程
- 为了多轮对话、多模态支持、信息更全面、与环境交互,在提示词工程上发展出来上下文工程
研究表明:当关键信息位于文本中段时,召回率下降40%以上LLM 的本质是概率预测模型,若输入的冗余信息过多,必然会干扰其对核心逻辑的判断,导致精准度与召回率下降。我在 Agent 应用开发实践中对此深有体会:每次与 LLM 交互时,传递的信息必须经过筛选,只保留 “足够必要” 的内容因此,Agent 开发其实就是在进行上下文工程 —— 在 LLM 需要输出的每个阶段,精准供给它完成任务所需的关键信息;无论是 tool_call 的返回结果、用户的原始输入,还是环境变量,本质上都是需纳入考量的上下文,并无主次之分,唯有全面且精简地整合,才能让 LLM 高效输出
- 上下文工程的本质:就是模型输入整理
- 无论是:user_prompt、system_prompt、tool_call_para、tool_call_result、env_state都是chat_history
- 在每个需要交互的节点,应当从chat_history中拿出哪些内容,经过拼接、优化、整理后
- 给到模型,就是上下文工程要做的工作
四、如何用好提示词
OpenAI 提到 6 条大的原则:
1.Write clear instructions(写出清晰的指令)
2.Provide reference text(提供参考文本)
3.Split complex tasks into simpler subtasks(将复杂的任务拆分为更简单的子任务)
4.Give the model time to “think”(给模型时间「思考」)
5.Use external tools(使用外部工具)
6.Test changes systematically(系统地测试变更)
4.1先激活再思考
先通过精准提问,让对应领域上下文信息,加入LLM的chat_history,再提出问题样例1
q:请你告诉我什么是shiro550漏洞,一般攻击者怎么利用它a:这漏洞是因为低版本shiro框架中..q:我测试一个靶机,存在shiro550漏洞,你帮我看看,我这个请求包为什么没有work,请求包如下:..
样例2
q:请你帮我总结/my_path/to_test_file/test.py文件中的代码逻辑a:这是一个爬虫的工具类,它通过..q:请你帮我修改代码,增强他的反爬绕过能力
4.2结构化提示词
类似XML格式
<instruction>你希望 Claude 执行的主要任务或目标</instruction><context>任务的背景信息,比如涉及的框架、业务逻辑、团队规范等</context><code_example>可以参考的代码片段、接口规范或已有实现</code_example>
JSON格式提示词样例
{ "task": "generate_product_review","parameters": { "product_type": "智能手机", "product_name": "XPhone Pro", "key_features": ["6.7英寸OLED屏幕", "5000mAh电池", "1亿像素摄像头", "骁龙8 Gen3处理器"], "review_perspective": ["性能体验", "续航能力", "拍照效果", "性价比"], "tone": "客观中立,略带专业分析", "word_count": "500-800", "structure": { "include_introduction": true, "include_feature_analysis": true, "include_pros_cons": true, "include_conclusion": true }, "requirements": [ "避免使用夸张修辞", "针对每个核心功能给出具体评价", "对比同价位机型的优势与不足", "数据支撑评价(如续航具体时长、跑分数据等)", "提及目标用户群体适配性", "分析系统优化对硬件性能的影响" ] }}
4.3提示词工程
-
few shot (少样本学习)
-
人工给出几个示例激活模型在特定任务的思考模式
-
Chain of thought(思维链COT)
-
概念:通过中间推理步骤——实现复杂推理能力
-
因为大模型本质是预测下一个词出现的概率,通过中间步骤引导,增加向正确方向预测的概率
-
Few-Shot + Cot:少样本学习配合思维链
-
Zero-Shot-Cot:在样本结尾加入引导逐步思考的Prompt
-
eg:买了10个苹果,给了邻居2个苹果和修理工2个苹果,又买了5个苹果吃了1个,还剩下多少苹果?让我们逐步思考
-
Auto-Cot:对用户问题聚类后,抽样出每类中心问题,使用简单启发式Zero-Shot-Cot生成推理链
-
准备步骤:问题聚类、抽样、用简单启发式Zero-Shot-Cot生成推理链
-
回答步骤:问题分类、回归该类问题的cot_prompt、合并user_prompt和cot_prompt、llm.invoke(merge_prompt)
-
自我一致性:
-
概念:通过少样本思维链,采样多个不同推理路径、用多个推理结果进行多轮投票
-
角色扮演
-
ReACT
-
…
五、Api调用Tips
- 通过动态步长温度、随机数种子,增加多轮投票中的随机性&强制不使用缓存
- 模型回复被截断,并不是上下文不够,很多模型有默认输出 token限制,需要设置 maxtokens参数
- 在逻辑性强的任务里,用 json 格式的提示词效果很好
- few-shot 在标准化输出任务中表现很好
- 根据不同任务特性调节温度
- 有时模型怎么都不能满足好一个需求,可能是这个模型能力不够 or 模型不适合这个任务
- 动态化提示词.format/.replace
- 做提示词版本管理很重要
六、最后聊两句
最后,我想抛出一个观点:在当下LLM既没有想象中那么强,归根结底,他只是一个工具,使用者水平决定了他的能力边际LLM更没有我们想的那么菜,我们可以完全相信算法工程师迭代基座模型的速度和大模型应用工程师的工程能力但是我对ai的发展十分有信心,在可预见的将来,他能够替代掉绝大部分的编码工作Agent is all you need到时候作为工程师的技术护城河,我想除了足够深刻的垂类领域知识,就是超越常人的LLM工具驾驭能力
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
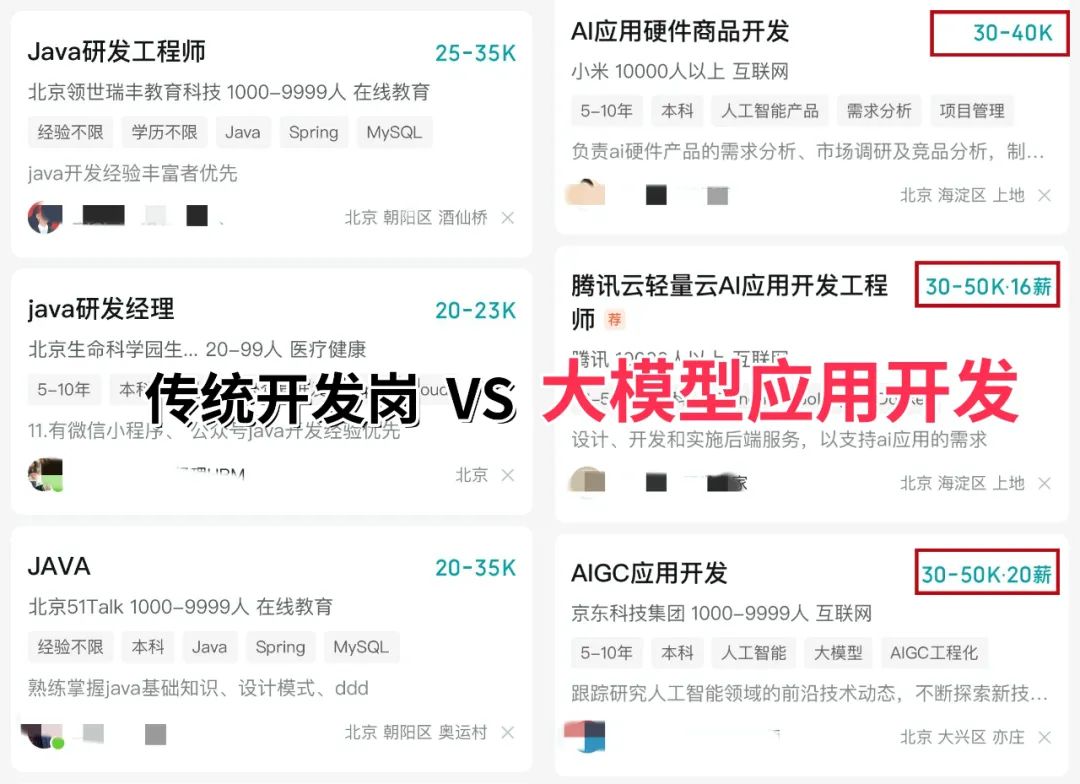
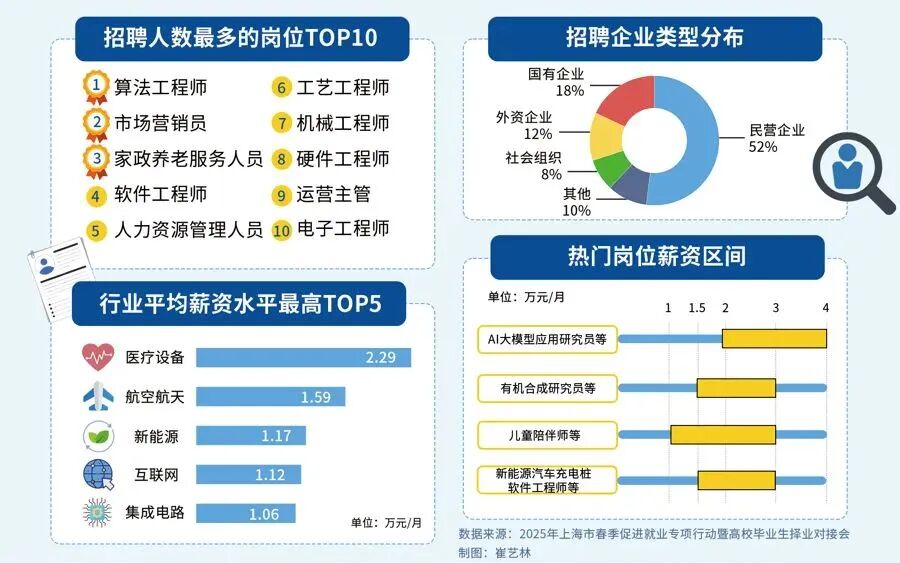
对于想入局大模型、抢占未来10年行业红利的程序员和小白来说,现在正是最好的学习时机:行业缺口大、大厂需求旺、薪资天花板高,只要找准学习方向,稳步提升技能,就能轻松摆脱“低薪困境”,抓住AI时代的职业机遇。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。

👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线

2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。

3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)

4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

5、面试试题/经验

【大厂 AI 岗位面经分享(107 道)】
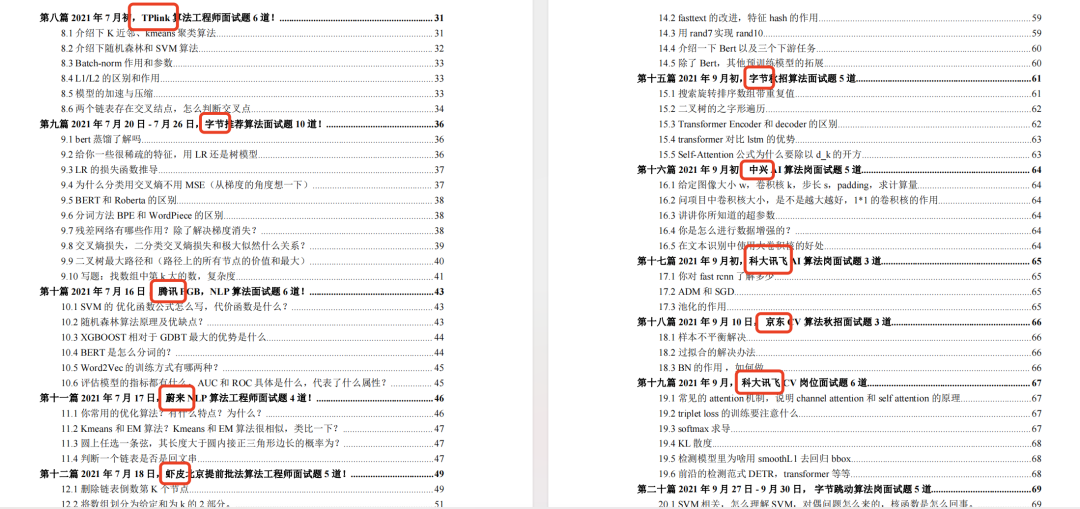
【AI 大模型面试真题(102 道)】
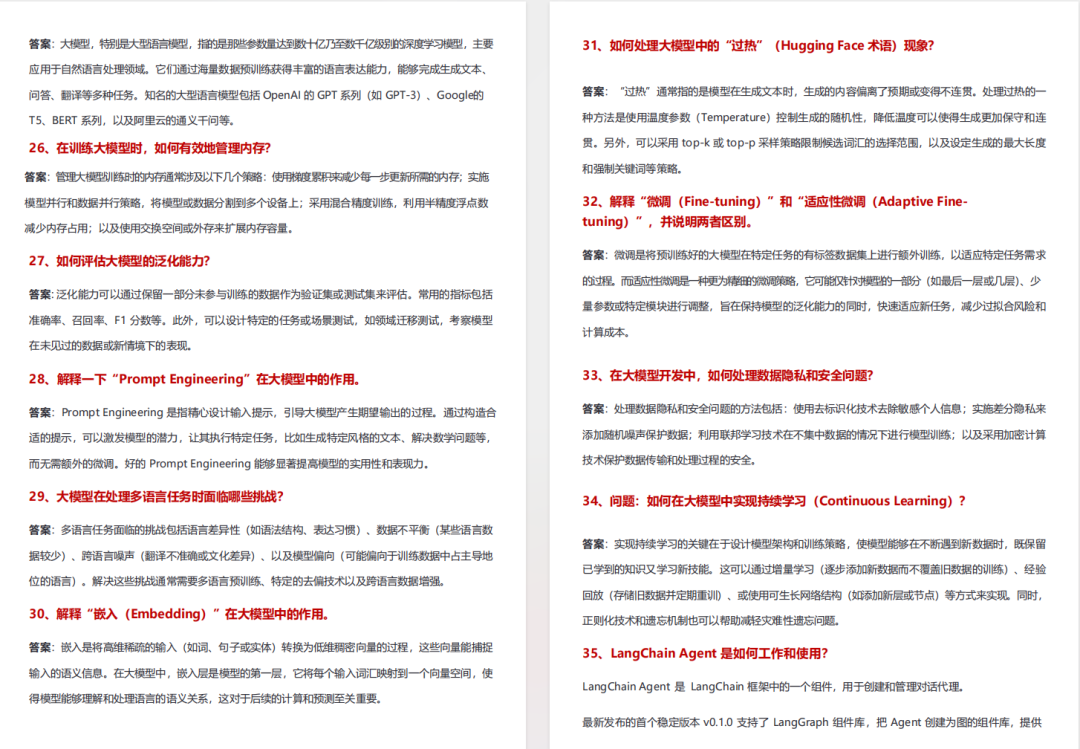
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码

适用人群

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇
3、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 4144


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


