


本文全面梳理2025年大语言模型(LLM)的核心发展脉络,重点拆解推理模型崛起、RLVR与GRPO算法成为主流训练方案、架构向高效混合模型转型、推理侧缩放与工具调用规模化应用四大核心趋势。同时结合程序员实操场景,探讨AI在编程、技术写作与科研中的实用价值,强调私有数据对企业及开发者的核心竞争力意义,并精准预判2026年技术走向,明确未来LLM进步将依赖多维度协同,而非单一技术突破,小白可快速入门,程序员可借鉴实操方向
一、推理之年:RLVR 与 GRPO 的崛起
聊2025年的LLM,绕不开“推理”这个关键词。咱们按时间线梳理,从2025年1月的一个行业转折点说起,小白也能轻松get核心逻辑。
在2025年之前,LLM的发展大多依赖“堆算力、堆数据”——虽然Scaling Laws(缩放定律)依然有效,但这种模式并没有让用户体验产生质的飞跃,唯一的例外是当时OpenAI刚发布的o1模型,它通过引入“推理轨迹”,首次让模型能清晰展现思考过程。
直到2025年1月,DeepSeek发布R1论文,整个AI圈被彻底震撼。这篇论文用实打实的实验证明了一个关键结论:类人类的推理行为,能通过强化学习刻意培养出来。(小白科普:LLM语境下的“推理”,简单说就是模型给出答案时,会主动一步步解释“为什么这么算、这么想”,而这种解释过程,本身就能大幅提升答案的准确性,比如解数学题、写代码时,步骤越清晰,出错率越低。)

Figure 1: A short response and a longer response including intermediate steps that is typically generated by reasoning models.
1.1 DeepSeek 时刻
DeepSeek R1 之所以能引发如此巨大的关注,主要有以下几个原因:
首先,DeepSeek R1 是以“Open-weight”的形式发布的。 它的性能极其出色,足以与当时市面上最顶尖的商业闭源模型(如 ChatGPT、Gemini 等)并驾齐驱。
其次,DeepSeek R1 的论文促使许多人——尤其是投资者和媒体——开始重新审视其 2024 年 12 月发布的 DeepSeek V3 论文。 这导致业界得出了一个颠覆性的新结论:虽然训练最尖端的模型依然昂贵,但其成本可能比之前预想的要低一个数量级。此前大家普遍认为需要耗资 5000 万甚至 5 亿美元,而现在的估算更接近 500 万美元。

此外,DeepSeek R1 的补充材料中提到: 在 DeepSeek V3 的基础上通过强化学习训练出 R1 模型,仅额外花费了约 29.4 万美元。这个数字再次刷新了所有人的认知,远低于此前业界的普遍预期。

当然,这 500 万美元的估算值存在许多限制条件。例如,它仅仅涵盖了最终模型训练运行时的计算算力成本,并没有将研究人员的薪资,以及与超参数调优、前期实验相关的其他研发投入计算在内。
第三点,也是最令人玩味的一点: 该论文提出了基于可验证奖励的强化学习,并结合 GRPO 算法。这不仅是一套全新的(或者说至少经过改良的)算法方案,更是一种在后训练(Post-training)阶段开发所谓“推理模型”并提升 LLM 性能的有效途径。

Figure 4: Broad overview of how / when reinforcement learning is applied. There are many details that I am skipping in this overview, but interested readers can read more in my The State of Reinforcement Learning for LLM Reasoning article.
在此之前,诸如监督微调(SFT)和基于人类反馈的强化学习(RLHF)等后训练方法,虽然至今仍是训练流程中不可或缺的一环,但它们始终面临着一个巨大的瓶颈:即需要极其昂贵的人工编写回复或偏好标注。(当然,你也可以用其他大模型来生成合成数据,但这在某种程度上陷入了“先有鸡还是先有蛋”的悖论。)
DeepSeek R1 和 RLVR(可验证奖励的强化学习)之所以如此重要,是因为它们允许我们在海量数据上对大模型进行后训练。 在算力预算充足的前提下,这使其成为了通过后训练阶段的“算力缩放(Scaling Compute)”来提升并释放模型能力的绝佳方案。
RLVR 中的 “V” 代表“可验证(Verifiable)”。这意味着我们可以利用确定性的方法来判定答案是否正确,而这些标签足以让大模型学会解决复杂的逻辑问题。(目前最典型的应用领域是数学和代码,但这一思路完全可以扩展到其他领域。)

Figure 5: A simple example of a verifiable reward.
话虽如此,今年的核心要点在于:LLM 的发展基本上是由采用 RLVR 和 GRPO 算法的推理模型所主导的。
实质上,在 DeepSeek R1 发布之后,几乎每一家主流的开源或闭源 LLM 开发商都相继推出了其模型的“推理(通常被称为‘思考’)”版本。
1.2 LLM 的核心演进点
如果我必须简明扼要地总结每一年的 LLM 开发重心(除了架构扩容和预训练算力增长这些常规操作外),我的清单会是这样的:
- 2022 年: RLHF + PPO
- 2023 年: LoRA SFT
- 2024 年: 中间训练(Mid-Training)
- 2025 年: RLVR + GRPO
当然,预训练依然是所有大模型不可或缺的基石。除此之外,正是 RLHF(通过 PPO 算法),才让我们在 2022 年底迎来了最初的 ChatGPT 模型。
到了 2023 年,业界的关注焦点大量集中在 LoRA 以及类似的“参数高效微调(PEFT)”技术上,这让训练自定义的小型大模型变得触手可及。

Figure 6: Some of the focus areas of proprietary and open-weight LLM development over the years. Note that this is cumulative, meaning that RLHF + PPO, for example, is still relevant and being used. However, it’s no longer the most hotly discussed topic.
随后,在 2024 年,各大主流实验室开始让他们的(预)训练流水线变得更加精细化。重点转向了合成数据、数据配比优化、领域特定数据的应用,以及加入专门的长上下文训练阶段。我在 2024 年的一篇文章中总结过这些不同的方法(当时我将这些技术归类在预训练之下,因为“中间训练”这个词在那个时候还没被创造出来):
当时,我将这些视为预训练技术,因为它们使用的是与预训练相同的算法和目标。而到了今天,这些在通用数据大规模预训练之后、且更具针对性的预训练阶段,通常被称为“中间训练(Mid-training)”(它是常规预训练与后训练之间的桥梁,后者包括 SFT、RLHF 以及现在的 RLVR)。
那么,你可能会好奇接下来的方向是什么?
我认为明年我们将看到(更)多关于 RLVR 的关注。目前,RLVR 主要应用于数学和代码领域。
下一个逻辑上的必然步骤是:不仅要将最终答案的正确性作为奖励信号,还要在 RLVR 训练期间评判 LLM 的解释过程。这种做法其实已经存在很多年了,在研究领域被称为“过程奖励模型(PRM)”。然而,目前它还算不上非常成功。例如,DeepSeek R1 的论文中就曾提到:
4.2 失败的尝试 ……总之,虽然 PRM 在对模型生成的 Top-N 个回复进行重排序,或辅助引导搜索方面表现出了不错的能力,但在我们的大规模强化学习实验中,与其带来的额外计算开销相比,它的优势非常有限。
然而,纵观上个月发布的DeepSeekMath-V2论文(我在之前的文章《从 DeepSeek V3 到 V3.2:架构、稀疏注意力和 RL 更新》中讨论过),我认为在未来,我们会看到更多将“解释评分”作为训练信号的案例。 目前,对解释过程进行评分通常需要引入第二个 LLM。这引出了我预见的 RLVR 的另一个发展方向:向数学和代码以外的其他领域扩张。
所以,如果你今天问我 2026 年和 2027 年的愿景是什么,我会给出如下预测:
- 2026 年: RLVR 的扩展应用以及更多的推理侧缩放(Inference-time Scaling)
- 2027 年: 持续学习(Continual Learning)
除了刚才提到的 RLVR 扩展,我认为 2026 年的重心将更多地放在推理侧缩放上。推理侧缩放意味着我们在训练完成后,当让 LLM 生成答案时投入更多的时间和资金成本,但这种投入是非常值得的。
推理缩放并不是一个全新的范式,许多 LLM 平台在后台已经使用了一些相关技术。这本质上是延迟、成本和回答准确性之间的一种权衡。但在某些特定的应用场景中,当准确性比延迟和成本更重要时,极致的推理侧缩放完全是物有所值的。例如,最近的 DeepSeekV2-Math 论文显示,这种技术将模型在极具挑战性的数学竞赛基准测试中的表现推向了金牌级水平。

Figure 7: Combination of two inference-time scaling methods: self-consistency and self-refinement. Additional self-refinement iterations improve accuracy. Annotated figure from the DeepSeekMath-V2 paper. Self-consistency and self-refinement are covered in chapters 4 and 5 of my Build A Reasoning Model (From Scratch) book.
今年,同行之间关于持续学习(Continual Learning)的讨论也显著增多。简而言之,持续学习是指在不从零开始重新训练模型的情况下,让模型直接学习新的数据或知识。
这并非一个全新的概念,我甚至有些好奇为什么今年它会被如此频繁地提及,因为目前在持续学习领域并没有出现任何实质性的突破。持续学习面临的核心挑战是灾难性遗忘(Catastrophic Forgetting)——正如持续预训练实验所显示的,LLM 在学习新知识的同时,往往会在某种程度上遗忘旧知识。
尽管如此,既然这个话题如此火热,我确实期待在未来几年里,我们在减少灾难性遗忘方面能取得更多进展,并使持续学习方法的研发成为未来的一个重要发展方向。
二、GRPO:年度学术研究的宠儿
在 LLM 动辄耗资巨大的时代,近年来的学术研究一直面临着不小的挑战。当然,尽管预算有限(或者正因为预算有限),学术界依然能产生许多被主流采纳、并成为 LLM 进步基石的重要发现。
近年来的典型案例包括 LoRA(《LoRA: Low-Rank Adaptation of Large Language Models》,2021年)以及相关的参数高效微调(PEFT)方法。

Figure 8: A code-based introduction to LoRA tutorial
另一个例子是 DPO(《Direct Preference Optimization: Your Language Model is Secretly a Reward Model》,即:直接偏好优化:你的语言模型其实秘密地就是一个奖励模型),以及相关的“无奖励模型对齐”方法,它们作为基于人类反馈的强化学习的一种替代方案而备受关注。

Figure 9: A code-based introduction to DPO tutorial
在我的圈子里,今年的研究亮点非 GRPO 莫属。尽管它最初源自 DeepSeek R1 论文而非学术界,但它依然为研究者们带来了极其兴奋的一年:从概念上讲,RLVR 和 GRPO 都非常有趣,而且根据实验规模的不同,它们的实验成本并不像预训练那样令人望而却步。
因此,今年我在 LLM 研究文献中(无论是来自企业还是学术界)看到了许多针对 GRPO 的数学改进,其中不少后来被最尖端的 LLM 训练流水线所采纳。例如,部分改进点包括:
Olmo 3 团队采用的方案:
- 零梯度信号过滤(出自 Yu 等人,2025 的 DAPO)
- 主动采样(出自 Yu 等人,2025 的 DAPO)
- Token 级别损失函数(出自 Yu 等人,2025 的 DAPO)
- 去除 KL 散度损失(出自 Yu 等人,2025 的 DAPO 以及 Liu 等人,2025 的 Dr. GRPO)
- 提高裁剪阈值(Clip higher)(出自 Yu 等人,2025 的 DAPO)
- 截断重要性采样(Yao 等人,2025)
- 取消标准差归一化(出自 Liu 等人,2025 的 Dr. GRPO)
DeepSeek V3.2 采用的方案:
- 特定领域的 KL 强度调节(例如数学领域设为零)
- 重加权 KL 散度
- 离线策略序列掩码(Off‑policy sequence masking)
- 保留针对 Top-p / Top-k 的采样掩码
- 保留原始 GRPO 的优势函数归一化(Advantage normalization)
我可以从实践经验中证实,这些 GRPO 的“技巧”或改进对实际训练效果有着巨大影响。例如,在应用了其中一项或多项修改后,训练过程中那些“糟糕的更新”不再会导致整个训练崩溃,我也再也不需要周期性地去回滚和重新加载检查点了。
即使是在非常短的训练运行中,我观察到采用这些技巧也能带来巨大的收益:

Figure 10: Small excerpt of the results from my from-scratch GRPO training code, which is available on GitHub
无论如何,在我的“从零开始构建推理模型”(Build A Reasoning Model From Scratch)代码仓库中,我提供了一个最基础的(vanilla)GRPO 脚本,感兴趣的读者可以去动手试玩。(不久后,我还会增加更多针对上述各种改进方案的消融实验研究。)
三、LLM 架构:分水岭已现?
谈到 LLM 架构,目前最尖端(state-of-the-art)的模型依然沿用着我们熟悉的“纯解码器(decoder-style)”Transformer 结构。然而,在过去的一年里,开源大模型界几乎达成了一个共识:转向使用混合专家模型(MoE)层,并且至少会采用一种“经过效率优化”的注意力机制,如:分组查询注意力(GQA)、滑动窗口注意力(SWA)或多头潜在注意力(MLA)。
除了这些已经相对标准化的 LLM 架构优化外,我们也看到了一些更为激进的效率改进,旨在使注意力机制的计算复杂度随序列长度线性缩放。这方面的代表性成果包括 Qwen3-Next 和 Kimi Linear 中采用的 Gated DeltaNets,以及 NVIDIA Nemotron 3 中使用的 Mamba-2 层。
关于这一点,我不打算在这里展开太细,因为我专门写了一篇长达 1.3 万字且最近刚更新的文章来深度剖析这些架构。如果你想深入了解,请移步:《大语言模型架构大比拼》(The Big LLM Architecture Comparison)。

Figure 11: The Big LLM Architecture Comparison
我的预测是,我们至少在未来几年内仍将围绕 Transformer 架构进行开发,至少在追求最尖端的模型性能(SOTA)时是如此。
与此同时,我确实认为我们会看到越来越多像 Gated DeltaNet 和 Mamba 层这类针对效率和工程化的改进。因为在 LLM 训练、部署和使用的庞大规模下,对于那些仍在为提供大模型服务而疯狂烧钱的公司来说,从财务角度来看,这样做是极其明智的。
这并不意味着市面上没有其他替代方案。正如我在《超越标准 LLM》中所写,文本扩散模型(Text Diffusion Models)就是一个有趣的研究方向。目前,它们还属于实验性研究模型的范畴,但谷歌已经透露他们将发布一款 Gemini Diffusion 模型。虽然它在建模质量上可能无法与他们的顶级旗舰模型抗衡,但它的速度极快,对于有低延迟要求的任务(如代码补全)极具吸引力。
此外,两周前开源权重模型 LLaDA 2.0 刚刚发布。其中最大的模型拥有 1000 亿参数,是迄今为止最大的文本扩散模型,性能与 Qwen3 30B 相当。(没错,它虽然没有推高整个行业的性能上限,但在扩散模型领域仍是一个值得关注的里程碑。)
四、推理侧缩放与工具调用的爆发之年
通过扩展训练数据和架构规模来提升 LLM 性能,是一个已被证明行之有效且(目前)依然奏效的公式。然而,特别是在今年,这已经不再是“唯一”充足的秘诀了。
我们从 2025 年 2 月发布的 GPT 4.5 身上就能看到这一点。据传 GPT 4.5 的规模远大于 GPT 4(以及后来发布的 GPT 5),这说明纯粹的规模扩张通常不再是向前推进最理智的方式。GPT 4.5 的能力或许优于 GPT 4,但增加的训练预算被认为“性价比极低”。
相反,更精细的训练流程(更加侧重于中间训练和后训练)以及**推理侧缩放(Inference Scaling)**驱动了今年大部分的进展。
例如,正如前文讨论取得金牌级数学表现的 DeepSeekMath-V2 时所提到的,推理侧缩放是我们让 LLM 按需解决极端复杂任务的有力杠杆之一(OpenAI 的 GPT “Heavy Thinking” 或 “Pro” 模式也是类似的例子)。虽然由于高延迟和高成本,将这种模式用于所有任务并不明智,但在某些特定场景下——如挑战性的数学题或编程难题——高强度的推理缩放就显得非常有意义。
另一个重大进步源于在训练 LLM 时就植入“工具调用”的意识。众所周知,幻觉是 LLM 面临的最大难题之一。可以肯定的是,幻觉率正在持续改善,我认为这很大程度上归功于上述的工具调用能力。例如,当被问及“谁赢得了 1998 年世界杯”时,LLM 不再尝试凭记忆作答,而是通过工具调用使用传统的搜索引擎,从相关主题的权威网站(如国际足联 FIFA 官网)筛选并抓取信息。解决数学问题时使用计算器 API 也是同理。
比如,OpenAI 今年早些时候发布的 gpt-oss 模型,就是首批专门针对工具调用能力而开发的开源权重模型之一。

Figure 12: Annotated table from the gpt-oss model card paper.
不幸的是,开源生态系统目前还没有完全跟上这一步伐。许多(如果不是大多数的话)工具在运行这些 LLM 时,默认仍处于“非工具调用”模式。原因之一是这是一种正在演进的新范式,现有的工具链需要时间去适配;另一个原因则是出于安全考虑,这本身就是一个更难解决的问题——给予 LLM 不受限制的工具调用权限可能会带来潜在的安全风险,甚至对你的系统造成毁灭性的打击。我认为一个永远值得深思的问题是:你会信任一个刚入职的实习生,在拥有同样系统访问权限的情况下执行这些任务吗?
但我坚信,在未来几年内,随着本地运行 LLM 的普及,启用并允许工具调用将变得越来越普遍。
五、年度词汇:刷榜狂热(Benchmaxxing)
如果非要选一个词或一种趋势来描述今年的 LLM 发展,“Benchmaxxing”再合适不过了。
在这里,“Benchmaxxing”指的是一种过度追求排行榜分数的强烈倾向。有时,这种倾向甚至到了荒谬的程度:提升基准测试(Benchmark)成绩本身成了终极目标,而不再是衡量模型通用能力的参考指标。
一个显著的例子是 Llama 4。它在许多公认的基准测试中得分极高,表现惊人。然而,一旦开发者和用户真正上手使用,大家就意识到这些高分并不能完全转化为现实世界的实操能力和实用价值。
正如那句流行语所说:如果测试集是公开的,那它就不再是真正的测试集。 如今的问题在于,测试集数据不仅(有意或无意地)成了训练语料库的一部分,甚至在 LLM 开发过程中被直接作为优化目标。
回想当年,即使公开测试集上的基准分数存在水分,至少模型的相对排名通常还是可靠的。例如,参考下方摘自 2019 年论文《ImageNet 分类器能否泛化到 ImageNet?》(Do ImageNet Classifiers Generalize to ImageNet?)的标注图:

Figure 13: Annotated figure from the 2019 Do ImageNet Classifiers Generalize to ImageNet? paper.
在 LLM 的开发过程中,这种“刷榜”现象已经演变到了一个极点,即基准测试分数已不再是衡量 LLM 性能的可靠指标。
不过,我确实认为基准测试依然是 LLM 必须跨越的必要门槛。换句话说,如果我看到一个 LLM 在基准测试 Y 上的得分低于 X,那我就已经能断定它不是一个优秀的模型。然而,如果它的得分超过了 X,这并不意味着它一定比另一个同样得分超过 X 的模型更好。
另一个需要考虑的维度是:图像分类器的任务非常单一,即对图像进行分类。但 LLM 会被用于许多截然不同的任务:文本翻译、摘要提取、编写代码、头脑风暴、解决数学难题等等。评估图像分类器(拥有分类准确率这类明确的指标)要比评估处理确定性任务和开放式任务的 LLM 简单得多。
遗憾的是,除了在实践中亲自尝试模型以及不断生成新的基准测试外,目前还没有完美的解决方案。
六、用于编程、写作与科研的 AI
由于这个话题经常被提及,我也想分享一下我对于“LLM 是否会取代人类处理某些任务(甚至是职业)”的一点拙见。
从宏观角度看,我将 LLM 视为赋予某些职业从业者“超能力”的工具。我的意思是,当 LLM 被妥善使用时,它们可以大幅提高个人的生产力,并消除日常工作中的许多摩擦。这些任务的范围很广:从相对琐碎的小事(比如确保文章的所有标题大小写格式统一),到在庞大的代码库中寻找复杂的 Bug。
6.1 编程(Coding)
时至今日,我关心的核心代码依然坚持亲手编写。我所说的“关心”,是指那些对我而言至关重要、必须确保完全理解且绝对正确的代码。
例如,如果我要编写一个 LLM 训练脚本,我会亲自实现并仔细审阅训练逻辑。这样做有两个目的:
- a) 确保代码的行为完全符合我的预期;
- b) 保持并磨练我在该任务上的知识和专业能力。
不过,我现在会利用 LLM 来处理核心逻辑之外那些繁琐的“周边代码”,比如添加命令行参数解析(argparse)的模板代码,这样我就可以更方便地从命令行调用我写的程序了。

Figure 14: Example adding command line arguments to a training script using the prompt “Add argparse for all hyperparameter options to training-script.py”.
但也正因如此,我越来越依赖 LLM 来发现潜在问题、提供改进建议或对某些想法进行可靠性检查(Sanity-check)。与此同时,我依然坚持要理解自己所构建的东西。作为个人目标,我旨在深化自己的知识和技能,并持续增长专业能力。
此外,LLM 在我不擅长的核心领域之外表现出了极高的价值。它们让我能够自动化处理一些原本我没有时间或精力去对付的任务。一个典型的例子是,我最近写了一个工具,用于提取我的 Substack 文章并备份为 Markdown 格式(我所有的稿件都是用 Markdown 起草的,但我经常直接在 Substack 编辑器中修改和扩充内容,所以本地草稿并不总是最新的)。LLM 还帮我清理了网站上的 CSS 代码,那些代码经过多年积累,充满了重复和冲突。今年这类使用 LLM 的案例还有很多。
简而言之,我认为其中的诀窍在于识别何时该用 LLM,何时不该用。以及如何以一种既能帮你增长专业知识,又让你感到有成就感的方式去使用它。
6.2 代码库与库函数
LLM 编写代码的能力确实增强了,但尽管听过一些人持相反意见,我并不认为代码会变得“转瞬即逝”或是“彻底过时”。LLM 赋予了人们一种“超能力”,让他们能够生成某些原本需要付出极大努力才能独立完成的编程项目。
然而,纯粹由 LLM 生成的代码库无法取代专家精心打造的代码库。 这些专家级代码库可能本身就是人类程序员在使用 LLM 的辅助下创建的,但关键点在于:在该领域拥有专业知识的人投入了大量的时间和精力进行创建、测试和精炼。如果其他人想要复制它,也需要付出大量的工作,所以既然它已经存在,为什么不直接采用呢?
简单来说,我认为一个优秀的全栈 Web 开发人员——他了解优秀的设计模式,明白各种权衡取舍,并在职业生涯中研究、见过并构建过许多平台——他构建出的平台绝对比一个随意向 LLM 发送提示词(Prompt)的人构建出的要好。
最棒的一点是,现在一个普通人也可以构建出一个平台,即便它不是最好的。然而,使用和“调教”LLM 只能让这个人走这么远,平台的质量很快会遇到瓶颈。因此,如果这个人真的在乎改进这个平台,深入钻研、学习他人是如何构建平台的,然后带着更丰富的知识回来,利用 LLM 更有效地指导和改进平台设计,这才是上策。
6.3 技术写作与科研
与编程类似,我不认为 LLM 会让技术写作过时。写一本优秀的技术书籍需要数千小时的投入以及对主题的深刻洞察。这个过程可能会涉及利用 LLM 来提高表达的清晰度、检查技术准确性、探索替代方案或运行小型实验,但核心工作依然取决于人类的判断和专业知识。

Figure 15: A non-staged example where an LLM just helped me to find and fix an error in a previous article.
的确,LLM 可以让技术书籍变得更出色。它们能帮助作者发现错误、扩展参考文献,并普遍减少在琐碎任务上消耗的时间。这让作者能腾出更多精力去处理那些真正需要创意和经验的深度工作。
从读者的角度来看,我也并不认为 LLM 会取代技术写作。对于快速提问和入门级解释,使用 LLM 学习某个主题效果很好。然而,当你想要建立更深层次的理解时,这种方式很快就会变得一团乱。
在那个阶段,与其为了一个你正尝试学习但(还)不是专家的主题,自己浪费数小时去过滤 LLM 的回复,往往不如遵循由专家设计的结构化学习路径更有意义(专家在设计路径时可能用了 LLM,也可能没用)。
当然,在参加课程或通过书籍学习时,使用 LLM 来澄清疑问或探索分支路径仍然完全合情合理。让它设计测验或练习题来巩固知识也非常棒。
总的来说,我认为 LLM 对作者和读者来说都是一种双赢。 但其中的诀窍在于,要学会识别何时该用 LLM,何时不该用。例如,一个主要的负面影响是:当一个主题变得困难时,人们很容易产生立即求助于 LLM 的冲动。然而,首先自己独立钻研问题并苦苦思索,往往能带来更扎实、更深刻的学习效果。
我看待科研(Research)的方式也大抵如此。LLM 在寻找相关文献、发现数学符号错误以及建议后续实验方案方面非常有用。但让一位人类研究者稳坐驾驶席依然是有意义的。
也许这里可以总结出一些经验法则:
- 如果这篇(研究)论文或这本书完全是由人类生成的,它可能还有进一步改进的空间;
- 而如果这篇(研究)论文或这本书仅靠向 LLM 发送提示词就能生成,那么它可能不够新颖,或者深度不足。
6.4 LLM 与职业倦怠(Burnout)
LLM 仍然是一个相对较新且不断演进的事物,我认为过度使用 LLM 还存在一个较少被讨论的弊端。例如,我认为如果模型承担了所有的实操工作,而人类主要负责监督,那么工作可能会开始变得空洞。
诚然,有些人的确享受专注于管理系统和协调工作流,这完全是一种合理的偏好。但对于那些热爱“亲自动手做这件事”本身的人来说,我认为这种工作模式可能会加速职业倦怠(尤其是考虑到现在有了 LLM,公司往往会期望更快地获得更多成果,情况可能更是如此)。
当你苦苦钻研一个难题并最终看到它成功运行时,会有一种特殊的成就感。而当 LLM “一发入魂”直接给出解决方案时,我并不会产生同样的感觉。我想这和烹饪很像(这只是我脑子里跳出的一个想法,我并不是个大厨):如果你喜欢做披萨,使用现成的面团只负责撒调料,可能会剥夺大部分乐趣,烹饪就变成了一种达成目的的手段。这未必是坏事,但如果你每天花很多时间、长年累月(数月或数年)都在做这样的工作,我可以预见这会让人感到空虚,并最终导致职业倦怠。
所以,从一个“自私”的角度来看,写代码通常比读代码更有趣。你可能也会同意,提交代码(Pull Request)通常比审核代码(Review)更快乐(当然,这并不适用于所有人)。
也许,关于如何以一种可持续的方式使用 AI,国际象棋是一个很棒的、理想化(虽然并不完美)的类比。
早在几十年前,国际象棋引擎就超过了人类玩家,但由人类参与的职业象棋比赛至今依然活跃且蓬勃发展。我不是象棋专家,但我敢说,这项游戏可能变得比以前更丰富、更有趣了。
根据我所听到的(例如加里·卡斯帕罗夫的《深度思考》一书,以及马格努斯·卡尔森参与的播客),现代棋手一直在利用 AI 探索不同的思路、挑战自己的直觉,并以一种以前根本无法企及的深度来分析错误。
我认为这为我们思考 AI 在其他形式的知识性工作中的应用提供了一个有用的模型。如果使用得当,AI 可以加速学习并扩展单个人的能力边界。我认为我们应该更多地将其视为一个合作伙伴,而不是替代品。
但我也认为,如果利用 AI 来完全外包思考和编码,则会面临破坏动力和长期技能发展的风险。

Figure 16: LLMs lower the barrier of entry, and they make coders (beginners and experts) more productive. However, as we are wrapping up the year 2025, I think it’s still worth investing in becoming an expert, because then you will get even more out of LLMs and will be able to deliver even better results.
七、竞争优势:私有数据
LLM 在通用编程、知识问答和写作方面的能力仍在持续提升。这很大程度上是因为,得益于训练流程和范式(如 RLVR)的改良,以及推理侧缩放和工具调用技术的进步,单纯的“规模化”投入依然能带来正向的投资回报。
然而,这种增长终究会在某个时间点进入平台期(正如我们在 GPT-4 到 GPT-4.5 的演进中所看到的),除非我们能不断发明全新的训练方法或架构(虽然目前还没人知道这些新东西究竟长什么样)。
目前的 LLM 已经能够胜任大量的通用任务,并解决掉那些“低垂的果实”。但若想让它们在特定行业深耕并站稳脚跟,则需要更深入的领域专业化。我认为 LLM 供应商们做梦都想获得高质量的领域特定数据,但就目前来看,这无疑是一项巨大的挑战。
例如,据观察,大多数被接触过的公司都拒绝了这类数据交易。原因显而易见:这些数据是私有的,更是他们维持商业差异化的核心竞争力。(我从多个渠道听到了这种说法,The Information 之前也有一篇专门探讨此话题的文章。)
在我看来,这种做法完全合情合理。为了眼前的利益将宝贵的私有数据出售给 OpenAI 或 Anthropic,无异于杀鸡取卵,从长远来看是非常短视的。

Figure 17: Example of sectors and types of data that could be useful for training domain-specific LLMs, but where selling the data externally would be concerning. (I am not a legal expert, and this is not legal advice, but I can imagine that if it’s a pure local LLM that doesn’t leave the companies’ secure servers, training the model on patient health data is no different than developing other types of internal software that works with that patient health data.)
目前,大规模的 LLM 开发成本极高且极具挑战性,这也是为什么只有少数几家大公司能够研发出顶尖 LLM 的原因。然而,我认为 LLM 的开发正日益趋向于“商品化”。随着 LLM 开发者在不同雇主之间频繁跳槽,他们最终会被财力雄厚的大型金融机构、生物技术公司以及其他企业招致麾下。这些公司拥有足够的预算,能够利用其特有的私有数据,开发出极具竞争力的企业内部 LLM。
这些模型甚至不需要完全从零开始训练;目前许多顶尖的 LLM(如 DeepSeek V3.2、Kimi K2 和 GLM 4.7)都在持续发布,企业完全可以对这些模型进行适配,并开展进一步的后训练。
八、2025 年的惊喜与 2026 年的预测
我想以一些核心心得来结束这篇文章,重点谈谈那些令我感到意外的进展,以及我对 2026 年的预判。
8.1 2025 年值得关注的惊喜
首先回顾一下 2025 年的惊喜。如果在一年前(2024年)问我,我可能不会预料到以下发展:
- 推理模型表现超预期: 已有数款推理模型在主流数学竞赛中达到金牌水平(包括 OpenAI 的某款未定名模型、Gemini Deep Think,以及开源权重的 DeepSeekMath-V2)。我并不惊讶这最终会发生,但我惊讶于它在 2025 年就实现了,而不是 2026 年。
- 开源社区重心转移: Llama 4(或者说 Llama 系列)在开源社区几乎完全失宠,Qwen(通义千问)在受欢迎程度、下载量以及衍生项目数量上已全面超越 Llama(参考 Nathan Lambert 的 ATOM 项目报告)。
- 架构的融合与借鉴: Mistral AI 在 2025 年 12 月发布的最新旗舰模型 Mistral 3 中,采用了 DeepSeek V3 的架构。
- 开源竞技场百花齐放: 除了 Qwen3 和 DeepSeek R1/V3.2 之外,开源 SOTA(最尖端)模型的角逐中涌现了大量有力竞争者,包括 Kimi、GLM(智谱)、MiniMax 和 Yi(零一万物)。
- 高效架构成为主流: 领先的实验室已将开发重点转向更便宜、更高效的混合架构(如 Qwen3-Next、Kimi Linear、Nemotron 3),而不再仅仅将其视为边缘课题。
- OpenAI 拥抱开源: OpenAI 发布了开源权重模型(gpt-oss,我今年早些时候专门写过一篇文章介绍它)。
- MCP 协议的统一: MCP(现已加入 Linux 基金会)已迅速成为智能体(Agent)类 LLM 系统在工具和数据访问方面的标准。我原本预计 2025 年该生态仍会保持碎片化,至少要到 2026 年才会统一。
8.2 2026 年大预测
- 扩散模型重塑推理: 我们可能会看到工业级、面向消费者的文本扩散模型,用于实现廉价、可靠且低延迟的推理,Gemini Diffusion 可能会率先领跑。
- 智能体本地化: 开源社区将缓慢但坚定地转向支持“本地工具调用”和具备更强“自主智能体(Agentic)”能力的 LLM。
- RLVR 跨界: RLVR(可验证奖励的强化学习)将广泛扩展到数学和代码之外的其他领域(如化学、生物学等)。
- 传统 RAG 的退场: 在文档查询中,经典的 RAG 架构将逐渐淡出。开发者将更多地依赖强大的“长上下文处理”能力,尤其是随着更优秀的“小型”开源权重模型的出现。
- 推理驱动进步: 很大一部分 LLM 的基准测试提升和性能进步将源于工具链的改进和推理侧缩放,而非训练过程或核心模型本身。这看起来像是 LLM 变强了,但主因是外围应用的进化。同时,开发者将专注于降低延迟,并在不必要的地方减少推理 Token 的消耗。别误会,2026 年 SOTA 水平仍会提升,但进步的比例将更多来自推理侧,而非纯粹的训练侧。
如果要为 2025 年总结一条“元经验(Meta-lesson)”,那就是:LLM 的进步不再依赖于单一的突破,而是通过多个独立杠杆在多个战线上齐头并进。这包括架构微调、数据质量提升、推理训练、推理侧缩放、工具调用等等。
与此同时,评估依然困难,基准测试并不完美,对于“何时以及如何使用这些系统”的专业判断力依然至关重要。
我对比 2026 年的希望是:我们不仅能继续看到有趣的进步,还能清晰地理解这些进步从何而来。这需要更完善、更一致的基准测试,以及必不可少的透明度。
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
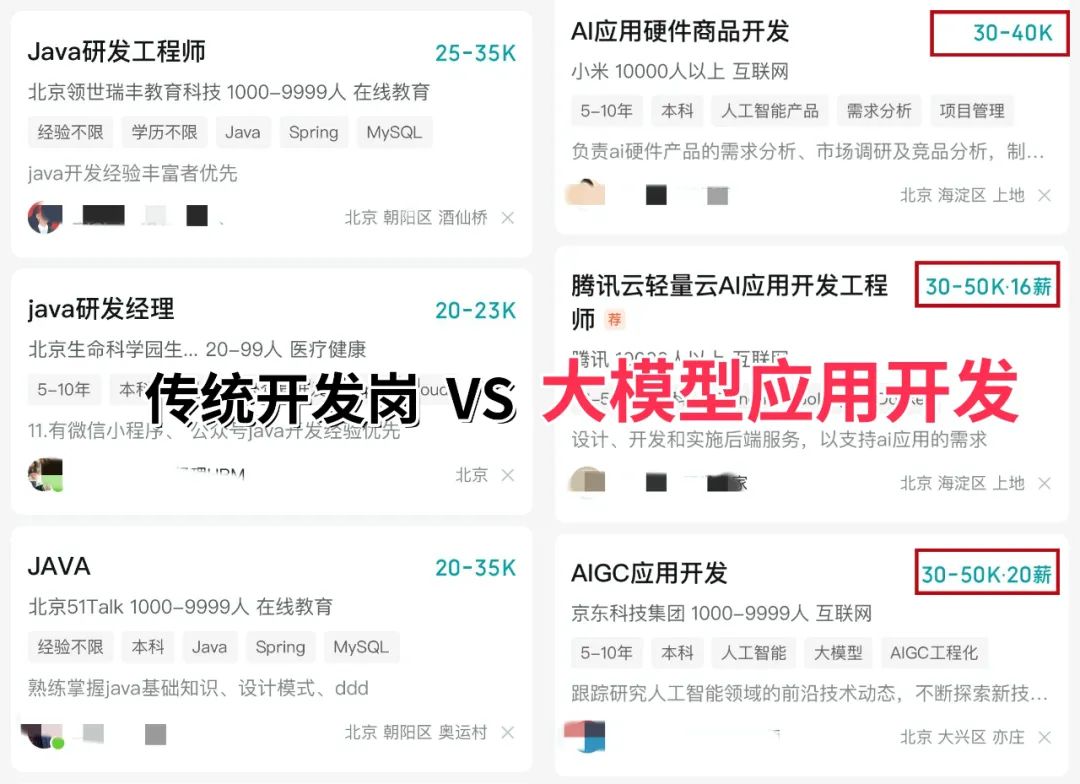
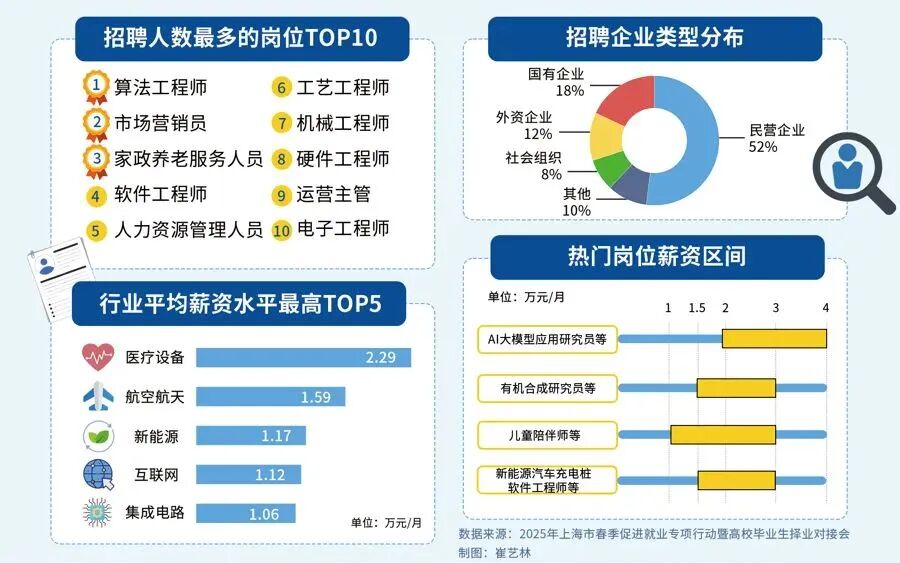
对于想入局大模型、抢占未来10年行业红利的程序员和小白来说,现在正是最好的学习时机:行业缺口大、大厂需求旺、薪资天花板高,只要找准学习方向,稳步提升技能,就能轻松摆脱“低薪困境”,抓住AI时代的职业机遇。
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。

👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线

2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。

3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)

4、 AI大模型最新行业报告
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

5、面试试题/经验

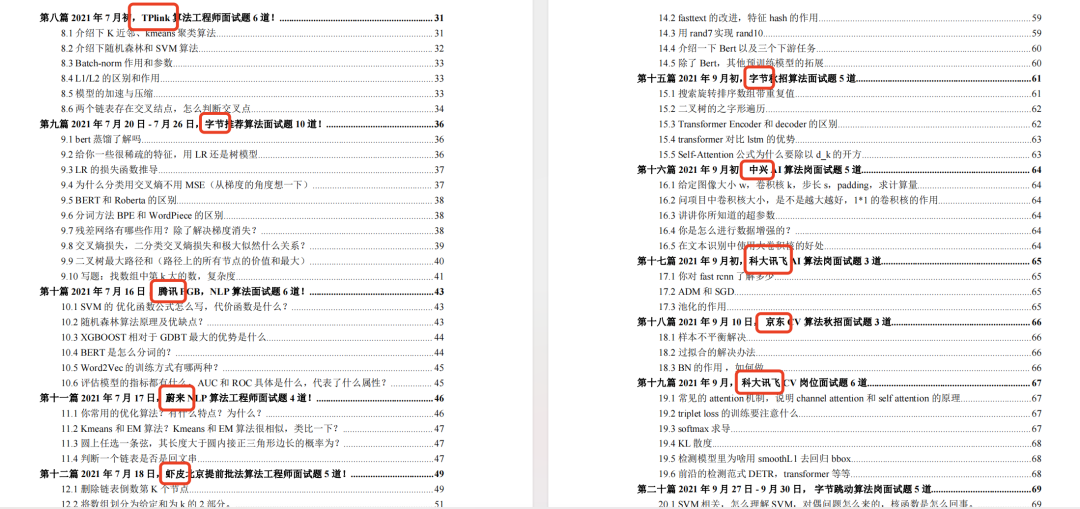
【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
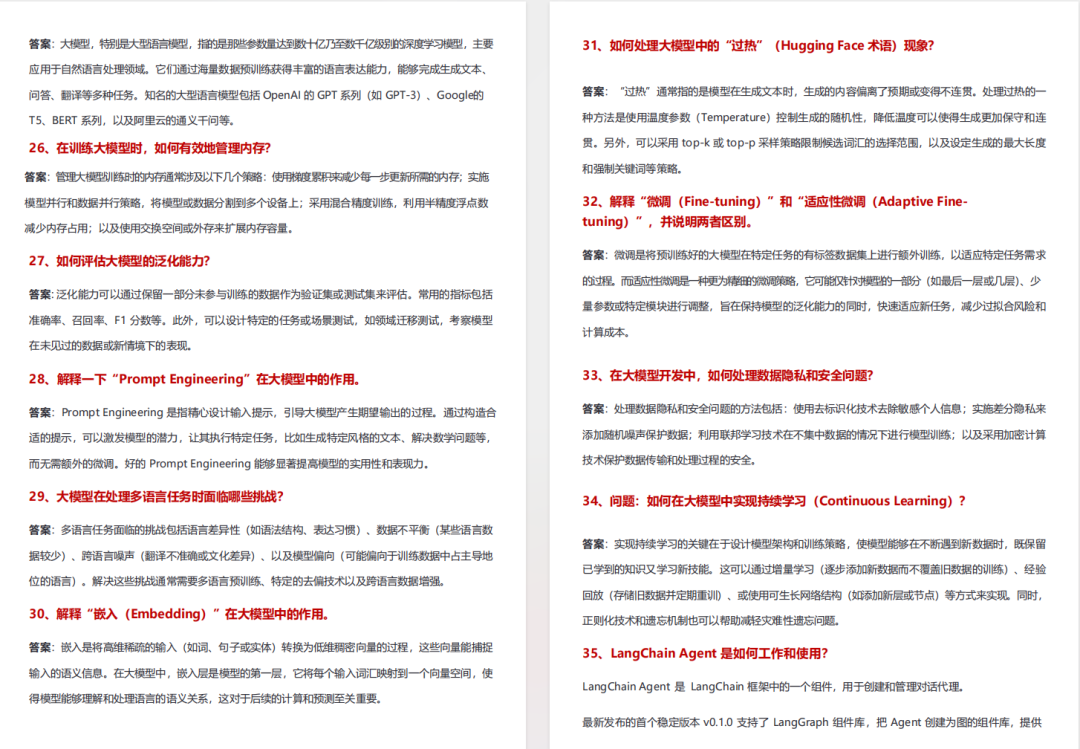
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码

适用人群

四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇
3、这些资料真的有用吗?
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。


这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
 794


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


