收藏必备!一文读懂检索增强生成(RAG)技术:企业级大模型增强利器

用ChromaDB构建大模型私有知识引擎:从向量检索到RAG落地 向量数据库是实现检索增强生成(RAG)的核心基础设施,其本质是将文本映射为高维语义向量,通过相似度计算跨越关键词搜索的语义鸿沟。相比传统倒排索引,向量检索能理解‘自动停一下’与‘服务熔断’的等价性,显著提升大模型对私有文档的理解准确率。ChromaDB凭借轻量架构、DuckDB+Parquet存储优化及与LangChain原生兼容等特性,成为中小规模RAG系统首选工具。本文聚焦工程落地细节,涵盖语义分块、嵌入模型选型、自适应查询、Prompt鲁棒设计及HNSW调优等关键实践,助力开发者快速构建可靠、可演进的 阅读详情

本文详细介绍了检索增强生成(RAG)技术,这是一种利用企业专有数据增强开源预训练模型的方法,无需重新训练即可创建特定领域的LLM。文章探讨了RAG的工作流程、标准解决方案架构、相关技术以及在实际应用中的计算需求、数据隐私和安全性考量,并特别介绍了英特尔在RAG优化方面的技术贡献。
1、检索增强生成 (RAG) 是什么?

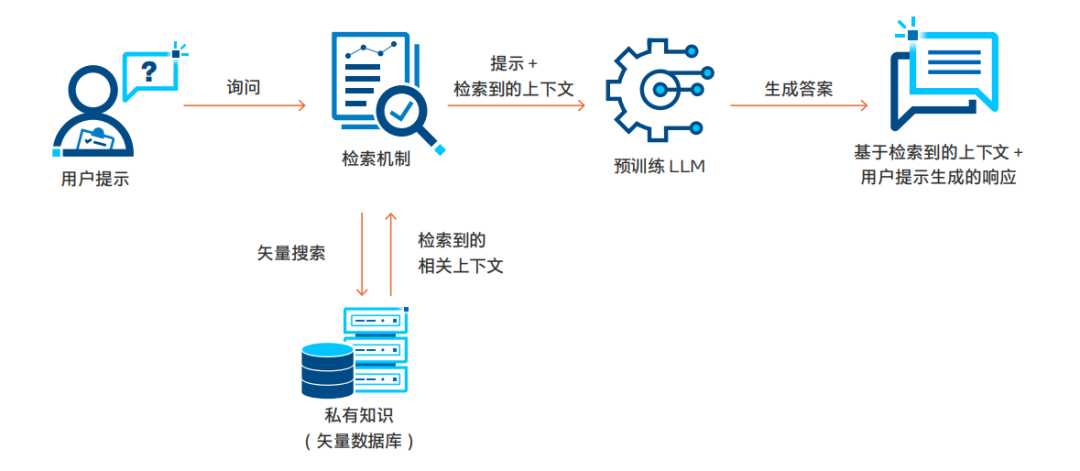
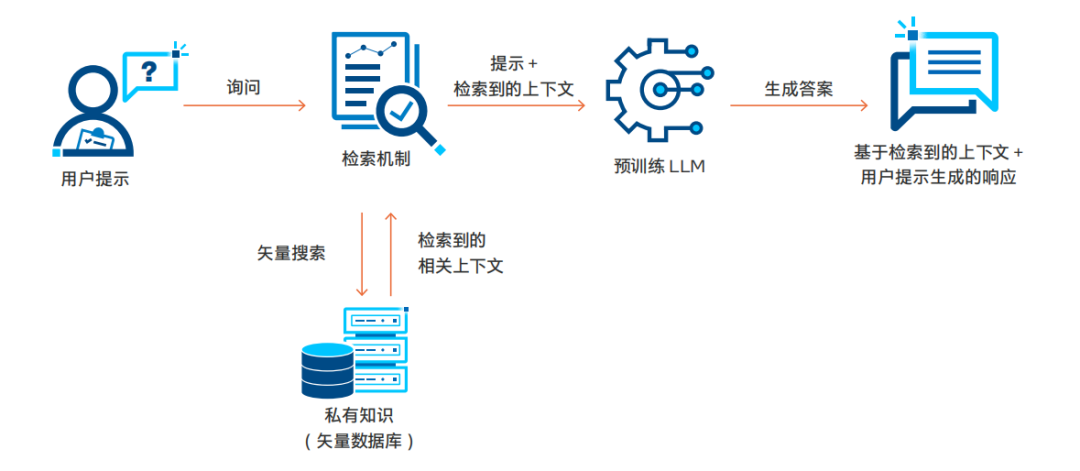
RAG 技术将动态、依赖查询的数据添加到模型的提示流中,再从存储在矢量数据库中的专有知识库中检索相关数据。提示和检索到的上下文可以丰富模型的输出,从而带来更加相关和准确的结果。因为数据不会被发送给管理模型的第三方,因此,RAG 可让企业在保护数据隐私性和完整性的同时更好地通过 LLM 充分利用数据。RAG 工作流程的关键构成可简单分为四个步骤:用户查询处理、检索、上下文整合和输出生成。下图展示了这一基本流程。
RAG 的实用性不仅限于文本,它还可以极大地改变视频搜索和交互式文档探索的方式,甚至使聊天机器人能够利用 PDF 内容来回答问题。

RAG 的应用过程通常被称为“RAG 管线”,因其从用户提示开始,整个数据处理流程都是一致的。用户提示首先进入关键步骤“检索机制”中。在这一步,相关提示会被转换为矢量嵌入,接着使用矢量搜索在预先构建的矢量数据库(如 PDF、日志、转录文本等)中找到相似的内容。检索到最相关的数据后,RAG 会将其与用户提示整合,然后传送给模型用于推理服务和最终输出生成。这种上下文整合为模型提供了在预训练阶段无法获得的额外信息,使模型能够更好地契合用户的任务或兴趣领域。由于 RAG 无需重新训练或调优模型,因此能够高效地添加数据来为 LLM 提供上下文。

2、标准RAG解决方案的架构

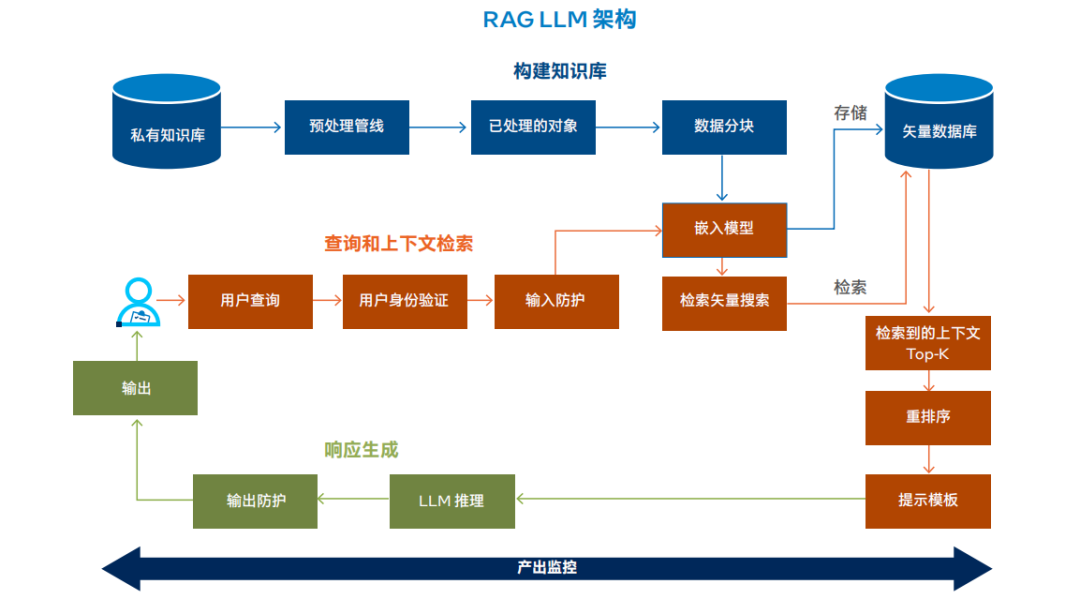
下图所示的 RAG 解决方案架构展示了标准 RAG 实施方案的构建模块。RAG 实施流程主要包括构建知识库、查询和上下文检索、响应生成和跨应用产出监控几个核心部分。
1、构建知识库:

• 数据收集:从基于文本的来源(如转录文本、PDF 和数字化文档)中收集数据建立私有知识库。

• 数据处理管线:利用特定 RAG 管线来提取文本、格式化内容以进行处理,并将数据分块成可管理的大小。

• 矢量化:通过嵌入模型处理数据块,将文本转换为矢量,可包括用于丰富上下文的元数据。

• 矢量数据库存储:将矢量化数据存储在可扩展的矢量数据库中,以便进行高效检索。

2、查询和上下文检索:

• 查询提交:用户或子系统通过聊天式界面或 API 调用提交查询,并通过安全服务进行身份验证。

• 查询处理:采取输入保护措施来确保安全性和合规性,然后进行查询矢量化。

• 矢量搜索和重排序:进行初始矢量搜索以检索相关矢量,然后使用更复杂的模型重排序以优化结果。

3、响应生成:

• LLM 推理和响应生成:将顶层上下文与用户查询结合,再通过预训练或调优的 LLM 进行处理,然后再进行后处理以提升质量和增强安全性。

• 响应交付:通过界面将最终响应返回给用户或子系统,确保答案的连贯性和上下文准确性。

4、产出监控:

• 检索性能:监控检索过程的时延和准确性,并保留记录以用于审核。

• 重排序的效率:跟踪重排序的表现,确保上下文相关性和速度。

• 推理服务质量:观察 LLM 推理的时延和质量,维护日志以便审核和改进。

• 安全防护有效性:监控输入和输出处理的安全防护 (guardrail),确保合规性和内容安全性。

3、RAG相关技术

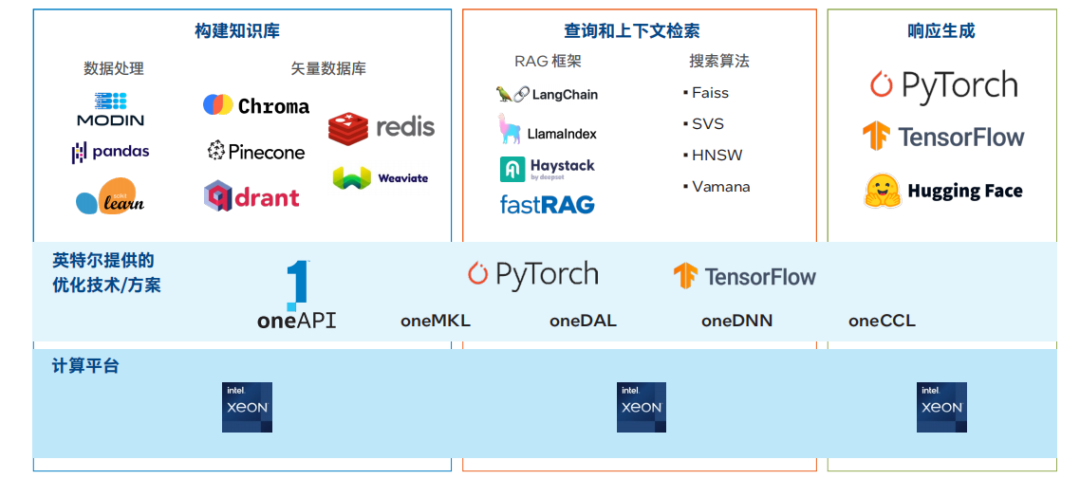
开发 RAG 应用通常会从集成 RAG 框架开始,例如 Haystack、LlamaIndex、LangChain 和英特尔研究院的fastRAG。这些框架可通过提供优化和集成关键的 AI 工具链来简化开发过程。目的是减少开发人员对大量低级别编程的需求。这种抽象使得开发人员能够利用增强的性能和针对其特定用例量身定制的解决方案,专注于高效构建 RAG 应用。

我们从知识库构建、查询和上下文检索以及响应生成这三个关键步骤来考量 RAG 工具链。通常,RAG 框架提供涵盖整个工具链的 API。不管是选择使用这些抽象,还是选择利用独立组件,都需要深思熟虑并从工程角度慎重考虑。
1、构建知识库+上下文检索:

• 集成框架:Haystack 和 LangChain 作为常见 RAG 框架,为矢量数据库和搜索算法提供了高级抽象,使得开发人员能够在基于 Python 的环境中管理复杂的过程。

• 矢量数据库技术:Pinecone、Redis 和 Chroma 是支持主流搜索算法的关键矢量数据库解决方案。英特尔研究院提供的可扩展矢量搜索 (Scalable Vector Search, SVS) 技术也很有发展前景,预计将在 2024 年初与各大矢量数据库集成。

• 嵌入和模型可访问性:通过 Hugging Face API 进行集成的嵌入模型往往可无缝整合到 RAG 框架中。这大大提升了纳入先进自然语言处理 (NLP)的简便性。

2、响应生成:

• 低级别优化:oneAPI 高性能库可以优化 PyTorch、TensorFlow 和 ONNX等主流 AI 框架,因此您可以使用熟悉的开源工具,因为它们已针对英特尔硬件进行了优化。

• 高级推理优化:英特尔 Extension for PyTorch 等扩展添加了高级量化推理技术,可助力提升了大语言模型的性能。

4、RAG应用与落地

RAG 管线的许多步骤需要耗费大量计算资源,而同时,终端用户又对低时延响应有着较高要求。此外,由于 RAG经常用于处理机密数据,因此整个管线的安全性都至关重要。

计算需求

一般来说,LLM 推理是 RAG 管线计算最密集的阶段,特别是在实时应用环境中。然而,创建初始知识库(处理数据和生成嵌入)对计算的需求同样可能很高(取决于数据的复杂性和体量)。英特尔在通用计算技术、AI 加速器和机密计算方面的进步为应对整个 RAG 管线的计算挑战提供了重要基石,同时还能提高数据隐私和安全性。

和大多数软件应用一样,RAG 也能从专为满足终端用户事务需求而量身定制的可扩展基础设施中受益。随着事务需求的增加,开发人员可能会因计算基础设施负载过重而面临时延增加,且基础设施还会因矢量数据库查询和推理计算而趋于饱和。因此,获得随时可用的计算资源来扩展系统和快速处理新增需求对企业至关重要。另外,实施关键优化以提升诸如嵌入生成、矢量搜索与推理等关键步骤的性能也非常重要。

数据隐私和安全性

• 安全 AI 处理:英特尔软件防护扩展(英特尔SGX)和英特尔(英特尔® TDX)在处理过程中在 CPU 内存中进行机密计算和数据加密,提高了数据安全性。这些技术对于处理敏感信息至关重要,有助于利用管线各部分的加密数据创建更安全的 RAG 应用。

对于需要在矢量嵌入生成、检索或推理过程中更安全地处理敏感数据的 RAG 应用来说,这是一个重要特性。

• 采取适当防护:在 RAG 应用中,防护涉及采取措施来管理 LLM在 RAG 系统内的行为。这包括监控模型的响应、帮助遵守指导原则和最佳实践,以及控制其输出来降低毒性、不公平偏见和隐私泄露的风险。在 RAG 应用中采取防护措施有助于 LLM 得到用户的信任和负责任的运用,同时符合系统的整体目标和要求。

开源优化

嵌入优化

• 量化嵌入模型:英特尔® 至强® 处理器可以利用量化嵌入模型来优化从文档中生成矢量嵌入的过程。例如,bge-small-en-v1.5-rag-int8-static 是一个使用英特尔 Neural Compressor 进行量化的 BAAI/BGE-smallen-v1.5 版本,与 Optimum-Intel 兼容。按照 Massive Text Embedding Benchmark (MTEB) 性能指标计算,使用量化模型进行检索和重排序任务时,浮点 (FP32) 和量化 INT8 版本之间的差异小于 2%,同时提高了吞吐量。

矢量搜索优化

• 针对 CPU 优化的工作负载:在英特尔® 至强® 处理器上,矢量搜索操作得到了高度优化,特别是在第三代及以后的处理器中引入了英特尔高级矢量扩展 512(英特尔AVX-512)之后。英特尔® AVX-512 利用融合乘加 (FMA) 指令,将乘法和加法合并为一个运算,从而增强了内积计算,这是矢量搜索中的一个基本运算。这一功能减少了计算所需的指令数量,显著提高了吞吐量和性能。

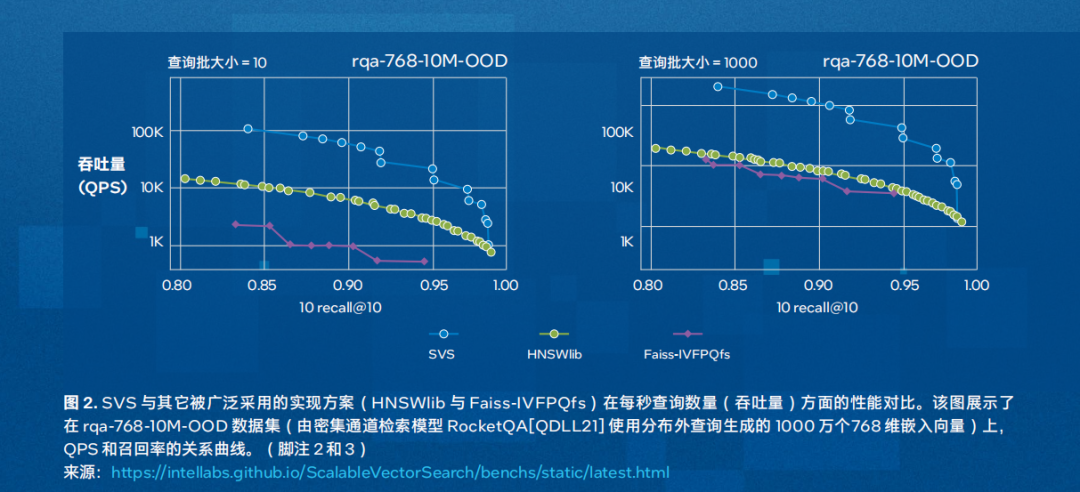
• 可扩展矢量搜索 (SVS):可扩展矢量搜索 (SVS) 技术提供快速的矢量搜索能力,可助力优化检索时间并提升整体系统性能。它通过使用局部自适应矢量量化 (LVQ) 来优化基于图形的相似度搜索,在保持准确性的同时尽可能降低内存带宽要求。其结果是显著减少了距离计算时延,并在吞吐量和内存要求方面获得了更好的表现。
推理优化

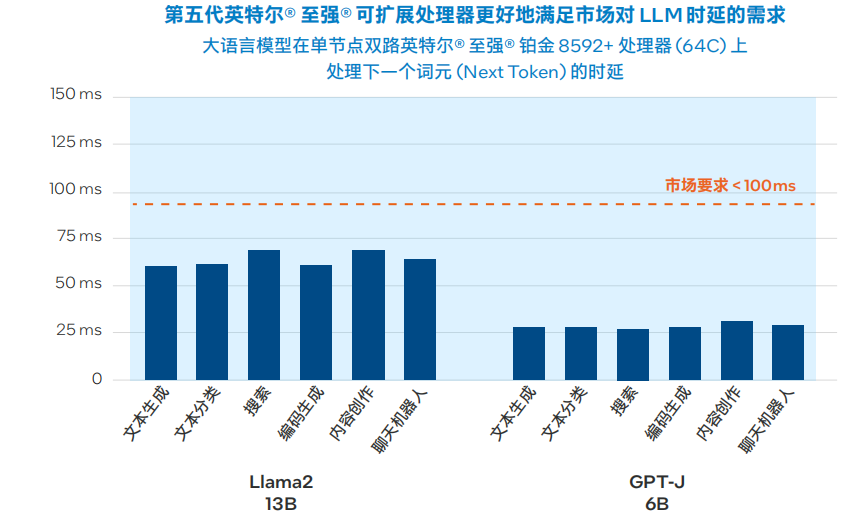
RAG 主要涉及推理运算,这一过程可由英特尔® 至强® 处理器通过先进的模型压缩技术提供支持。这些技术支持在较低精度(BF16 和 INT8)下进行运算,并且不会造成明显的性能损失。在本节中,我们将简要介绍各种针对推理的优化和机会。

• 英特尔® 高级矩阵扩展(AMX):第四代和第五代英特尔® 至强® 可扩展处理器内置英特尔AMX,能够提高矩阵运算的效率并优化内存管理。
• 先进的开源推理优化工具:英特尔贡献并扩展了主流深度学习框架,如PyTorch、TensorFlow、Hugging Face、DeepSpeed 等。对于 RAG工作流程,英特尔关注的是通过实施量化等模型压缩技术来优化 LLM 的机会。

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

在这里插入图片描述

为什么要学习大模型?

我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。

在这里插入图片描述

在这里插入图片描述

大模型入门到实战全套学习大礼包

1、大模型系统化学习路线

作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!

img


2、大模型学习书籍&文档

学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。

在这里插入图片描述

3、AI大模型最新行业报告

2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。

img

4、大模型项目实战&配套源码

学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。

img

5、大模型大厂面试真题

面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。

img

适用人群

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …
第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …
第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …
第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

https://img-blog.csdnimg.cn/img_convert/05840567e2912bcdcdda7b15cba33d93.jpeg

中颖单片机SH79F3213正弦波矢量的电动车小毛驴控制器量产资料 中颖单片机SH79F3213正弦波矢量的电动车小毛驴控制器量产资料 中颖单片机SH79F3213 制作的电动车小毛驴控制器量产资料,已量产十几万片,拿到手即可量产 1、提供原理图 2、提供PCB图 3、提供C语言源代码程序 4、提供清单 ... 阅读详情

相关推荐

HDMI2.1接口保护指南:从浪涌损坏案例看RK3588板子的ESD设计要点

本文深入探讨了HDMI2.1接口在RK3588板子上的ESD防护设计要点,通过真实案例分析了浪涌损坏的原因及解决方案。重点介绍了TMDS信号链路的四级防护体系、TVS管选型误区以及连接器与PCB的协同设计策略,帮助工程师有效避免静电放电导致的HDMI无输出故障。

weixin_29305337的博客 447

大模型RAG技术完全指南:从零到精通,解决幻觉问题,收藏必备!

本文详细介绍RAG(检索增强生成)技术,这是一种解决大模型"幻觉"问题的关键方案。RAG通过访问外部知识库检索相关信息,使大模型从"闭卷考试"变为"开卷考试"。

大模型教程的博客 1232

前沿数据解析 | 麻省理工-斯坦福-丰田研究中心电池数据集:AI驱动下的电池寿命早期预测

本文解析了麻省理工、斯坦福与丰田研究中心联合发布的电池数据集,展示了AI驱动下的电池寿命早期预测技术。通过分析124个商用锂离子电池的完整生命周期数据,研究团队仅用前100次循环数据即可准确预测电池报废时间,为电动汽车电池管理提供革命性解决方案。数据集包含LFP/石墨体系电池的详细测试记录,结合差分容量分析和梯度提升树模型,预测精度显著提升。

weixin_26950847的博客 529

RAG-Anything:让多模态「万物」皆可检索增强生成的开源利器,大模型入门到精通,收藏这篇就足够了!

RAG-Anything(简称 RAGA)由香港大学数据智能系统实验室(HKUDS)开源,定位为「首个面向任意模态的统一检索增强生成框架」。

2301_81888214的博客 1501

Verilog中generate for循环的5个实战技巧(附完整代码示例)

本文详细介绍了Verilog中generate for循环的5个高级实战技巧,包括参数化模块实例化、条件化生成、多维硬件结构实现等,并附有完整代码示例。这些技巧能显著提升FPGA开发效率,特别适合中级Verilog开发者学习应用。

weixin_28725949的博客 187

grafana使用方法

1、点击仪表盘2、新建仪表盘3、选择数据源4、选择查询的条件5、美化。

2403_87359664的博客 323

Java实习模拟面试之RAG检索增强生成:破解大模型知识瓶颈的利器

好的,面试官。什么是RAG?RAG,全称检索增强生成(Retrieval-Augmented Generation),是一种将信息检索(Retrieval)与文本生成(Generation)相结合的框架。它不依赖大模型自身的知识库,而是当用户提出问题时,先从一个外部、可更新的知识源中检索相关信息,再将这些信息作为上下文“喂”给大模型,最后由模型基于此上下文生成最终答案。简单来说,RAG让大模型从一个“背诵者”变成了一个“研究员+撰稿人”。核心思想:将“知识存储”和“知识应用”分离。

吾为热爱计科,致力于知识分享的践行者,此博客是我在这条道路上留下的足迹。 484

2026AI漫剧放心大胆做!小白也能轻松出片(附保姆级教程)

要是在2025,我大概率会劝他再等等,毕竟那时工具还没这么顺手。但到了2026年的今天,我的回答得很干脆:放心去做,绝对没问题。这一年多来,AI漫剧这块的变化真可谓翻天覆地。过去你想拍个像样的短片,哪怕再简陋,也得凑齐拍摄设备、找场地、找演员,后期剪辑更是折磨。但现在,时代变了,AI已经把创作的门槛踏平了。你不需要请演员,也不用操心灯光布景,更不用为剪辑特效烧钱。一个人,一台电脑,花几天时间就能做一部完整的AI漫剧。你只要有有想表达的故事,突发的灵感,剩下的,都能直接交给AI落地。

欢迎来到鸾姝淡月博客,专为程序员和编程爱好者打造的技术博客。我们分享编程语言趋势、开发工具、编程哲学、职业发展等,助你掌握新技术,优化技能,激发编程热情。 503

RAG技术完全指南:从零解决大模型幻觉,构建智能检索增强系统

RAG技术通过检索外部知识库增强大模型生成能力,有效解决"幻觉"问题。其核心包括知识嵌入、检索器和生成器三大组件。《大模型应用开发:RAG实战课》系统介绍RAG构建、优化、评估及复杂范式,提供完整技术栈与实战指导。书中通过生动对话形式讲解理论,配合代码示例,帮助初学者快速掌握RAG技术,提升大模型应用效能,是程序员必备的学习资源。

Trb201013的博客 353

MOS管的体二极管在LLC中的作用

MOSFET是一个三端器件(G、D、S),在N沟道MOSFET的结构中,源极和漏极之间的N型材料中自然形成了一个寄生的PN结,这个PN结就是体二极管(Body Diode),它是不可避免的器件结构。📌 对于N沟MOSFET:体二极管是从漏极 D 到源极 S 的正向导通二极管,方向为 D → S。MOS管的体二极管在LLC中并不是主功率通道,但却是实现软开关(ZVS)和能量过渡的关键“临时路径”。用得好,它是你的朋友;忽略它,电路就可能烧毁。

weixin_43199439的博客 699

PyTorch深度学习实战(6)——神经网络性能优化技术

神经网络性能优化技术是指通过改进神经网络的结构、参数初始化、正则化和训练过程等方面来提高其性能和泛化能力的方法。优化技术的选择和调试需要根据具体问题进行,通过不断实验和调整,找到最适合网络的优化策略。本节首先训练了一个简单的全连接网络,然后在此基础上介绍了简单有效的神经网络性能提升技巧。

盼小辉丶的博客 1万+

大模型RAG技术演进指南:从朴素智能到自主决策,程序员必备

文章详细介绍了检索增强生成(RAG)技术的四个演进阶段:从Naive RAG确立基本范式,到Advanced RAG引入精细化优化,再到Modular RAG追求架构灵活性,最终Agentic RAG实现自主决策与智能化。RAG技术从简单的"知识搬运工"逐步进化为能够进行复杂推理的"智能决策者",未来将向多模态、实时化和可信AI方向发展。

程序员鑫港的博客 931

【推荐100个unity插件】Animator 的替代品?—— Animancer Pro插件的使用介绍

Animancer与Unity Animator对比及使用指南 摘要: 本文对比了Animancer与Unity官方Animator的核心差异,分析了Animancer的优势特点。Animancer采用代码驱动模式,相比Animator的状态机系统更灵活高效,支持实时调试、动态混合和深度逻辑集成。文章详细介绍了Animancer的快速使用方法,包括动画播放、切换和触发机制,并区分了免费版与专业版的功能差异。适合需要高效动画开发、复杂交互逻辑的中小项目,为开发者提供了一种现代化的动画解决方案。

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 2434

提示压缩深度解析:为 RAG 系统瘦身增效的必备利器

提示压缩(Prompt Compression)是提示工程中一系列方法的总称,其核心目标是在尽可能保留原始提示中关键信息的前提下,缩短输入给 LLM 的文本长度。它的本质不是简单的“删减”,而是一种有策略的信息筛选与重组,旨在用更精炼的输入换取更高效的模型处理。可以将提示压缩视为在 RAG 流程中引入的一个中间处理层。这个“压缩器”接收来自检索模块的原始长文本,经过处理后,输出一个信息密度更高、体积更小的优化提示,再将其传递给主 LLM 进行最终生成。

✨ 欢迎来到【Seal ^_^ 的优快云博客】!✨ 385

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

计算机控制技术及应用

《计算机控制技术及应用》通过总结作者的科研成果和吸收国内外的先进理论、方法和技术,以计算机控制系统的网络化、开放化、智能化和集成化发展趋势为主线索,主要介绍计算机控制系统的基本概念和计算机控制系统的典型形式,计算机控制系统的数学描述与基本分析方法,以及数字PID控制器、最少拍控制系统、达林算法、状态变量设计法等设计方法及其各种改进算法。重点突出计算机控制系统输入输出通道接口的设计方法和典型控制系统的设计案例与实现方法等。

RAG 上下文增强 6 大利器:从语义分块到文档增强全解析

摘要:RAG架构中的上下文增强技术通过优化检索文档提升大模型输入质量。主要方法包括:(1)上下文块标题,为语义分块生成核心标题,解决LLM识别效率低的问题;(2)相关片段提取,基于Query语义精准筛选内容,避免冗余信息干扰;(3)上下文窗口增强,通过信息置顶、分块拼接等方式突破模型长度限制。这些技术显著提升了检索效率,降低了推理成本,并在金融、医疗等场景中实现了精准信息定位。配套代码示例展示了语义分块、标题生成和片段提取的具体实现方法。

干货批发市场 1000

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

AI 时代,你还在死记硬背?RAG 技术让你拥有“最强大脑”,大模型入门到精通,收藏这篇就足够了!

RAG 技术是 AI 时代的一把利器,它将彻底改变我们与 AI 的交互方式。如果你想在 AI 领域有所作为,那么学习 RAG 技术绝对是一个明智的选择!

DEVELOPERAA的博客 986

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

小白程序员必备:收藏这个RAG-SQL Router实战项目,轻松入门大模型开发!

在终端执行以下命令,启动Web界面,然后打开浏览器访问提示的地址(默认是http://localhost:8501)。✨ 测试建议:可以试试以下3类问题,验证系统是否能正确路由:\1. SQL类问题(查数据):“哪个城市人口最多?”、“有多少个欧洲城市?\2. RAG类问题(查文档):“文档里提到的政策要点是什么?”、“关于API使用的说明在哪里?\3. 混合类问题(同时查数据和文档):“东京的人口是多少?同时告诉我文档里关于东京的介绍。

2601_95334846的博客 599

大模型学习必备:AI核心概念深度解析,建议收藏反复阅读

RAG的英文全称叫做 Retrieval-Augmented Generation,翻译成中文叫做“检索增强生成”,源自于一篇论文可以简单的理解,把RAG当做是一个外挂,当大模型对一些知识不太懂的时候,它就会回答错误,所以我们需要提供一些方法帮助模型接触到那部分知识,RAG就是通过提供信息检索来补充离线模型缺失的那部分知识。LLM的RAG使用范式。

大模型研究中心 1195

收藏!GraphRAG:知识图谱赋能,让 AI 更智能的检索生成技术(小白 & 程序员入门指南)

本文专为AI小白和程序员群体打造,通俗解读GraphRAG核心技术——这是将知识图谱与传统RAG深度融合的创新方案。通过结构化知识与大语言模型(LLM)的协同,GraphRAG不仅解决了传统RAG的信息割裂问题,还能提供更精准、可解释、强推理的AI回答,是企业级AI应用落地的关键技术,更是开发者进阶大模型领域的必备知识点。GraphRAG不是传统RAG的替代者,而是大模型时代的"升级包"。它通过知识图谱为LLM注入"结构化思维",让AI从"能说话"进化到"会思考",是解决复杂场景AI应用落地的关键技术。

youmaob的博客 1104

构建实用RAG工具链:开发者必备技术栈深度解析

RAG系统构建指南:从工具链到实践 摘要:本文系统介绍了检索增强生成(RAG)技术栈的关键组件与实现方法。首先剖析了向量数据库(FAISS、Pinecone等)和嵌入模型(OpenAI、Cohere等)的选型策略,强调需根据延迟、预算等需求综合考量。在预处理环节,详细讲解了文档加载、分块处理的工程实践,指出合理分块对后续检索效果的影响。接着探讨了混合检索架构和重排序技术对提升精度的作用,以及提示工程在转换检索结果中的关键地位。最后,系统介绍了评估监控、部署优化等生产环节的最佳实践,包括缓存策略、速率限制等成

Q2024107的博客 684

RAG原理解析——入门必备

RAG 是一种“检索+生成”的混合技术,核心逻辑是:在生成回答前,先从外部知识库中检索与用户问题相关的信息,将这些信息作为“参考资料”传给模型,让模型基于参考资料生成回答。让模型“带着答案找问题”,而非“凭空猜测答案”。RAG 本质是“检索+生成”,核心价值是解决大模型知识过期和幻觉问题;完整流程:文档加载→分割→嵌入→向量存储→检索→生成,每一步都影响最终效果;

sinat_20277079的博客 727

AI 时代,你还在死记硬背?RAG 技术让你拥有“最强大脑”

今天,我就要为你揭秘一项 AI 领域的新兴技术——RAG(Retrieval-Augmented Generation,检索增强生成)!它将彻底改变你对 AI 的认知,让你拥有一个真正“博学多才”的 AI 助手!

DEVELOPERAA的博客 1165

RAG学习必备,论文+实战+经验全收录!

【RAG实战】Prompting vs. RAG vs. Finetuning: 如何选择LLM应用选择最佳方案。【RAG落地利器】向量数据库Milvus教程:如何实现MetaData检索过滤。【RAG论文】文档树:如何提升长上下文、非连续文档、跨文档主题时的检索效果。【RAG入门教程02】Langchian的Embedding介绍与使用。从零开始优化 RAG 流程的终极指南,解决检索增强生成的核心挑战。你的RAG系统真的达标了吗?【RAG论文】检索信息中的噪音是如何影响大模型生成的?

yanqianglifei的专栏 697

为什么个人需要部署一个本地RAG知识库?大模型入门到精通,收藏这篇就足够了!

对于许多个人用户而言,部署一个本地RAG(检索增强生成)知识库,不仅是提升效率的利器,更是迎接未来信息化挑战的必备工具。

pythonhy的博客 662

收藏备用!LLM四大核心技术拆解:从理论到落地,小白也能看懂的大模型实战指南

近期科技圈传来重磅消息:行业巨头英特尔宣布大规模裁员2万人,传统技术岗位持续萎缩的同时,另一番景象却在AI领域上演——AI相关技术岗正开启“疯狂扩招”模式!据行业招聘数据显示,具备3-5年大模型相关经验的开发者,在大厂就能拿到50K×20薪的高薪待遇,薪资差距肉眼可见!业内资深HR预判:不出1年,“具备AI项目实战经验”将正式成为技术岗投递的硬性门槛。在行业迭代加速的当下,“温水煮青蛙”式的等待只会让自己逐渐被淘汰,与其被动应对,不如主动出击,抢先掌握AI大模型核心原理+落地应用技术+项目实操经验。

大模型教程的博客 623

Dify 搭建私有的RAG知识库(实操篇)大模型入门到精通,收藏这篇就足够了!

还在为构建私有化AI应用犯愁吗?今天给大家介绍一款强大的开源利器——Dify。这款被称为’AI应用开发神器’的平台,正在悄悄改变着开发者构建AI应用的方式。

瓦罗兰特顶级C位的博客 1377
上一篇: 大语言模型驱动的智能体开发:从理论到实践的完整指南【强烈推荐】
下一篇: 【珍藏】大模型项目成功之道:完整研发流程,避开90%的坑
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值