NVIDIA 实现通义千问 Qwen3 的生产级应用集成和部署

Ollama 可以在 Windows 上运行了 阅读详情

img

阿里巴巴近期发布了其开源的混合推理大语言模型 (LLM) 通义千问 Qwen3,此次 Qwen3 开源模型系列包含两款混合专家模型 (MoE),235B-A22B(总参数 2,350 亿,激活参数 220 亿)和 30B-A3B,以及六款稠密 (Dense) 模型 0.6B、1.7B、4B、8B、14B、32B。

现在,开发者能够基于 NVIDIA GPU,使用 NVIDIA TensorRT-LLM、Ollama、SGLang、vLLM 等推理框架高效集成和部署 Qwen3 模型,从而实现极快的词元 (token) 生成,以及生产级别的应用研发。

本文提供使用 Qwen3 系列模型的最佳实践,我们会展示如何使用上述框架来部署模型实现高效推理。开发者可以根据他们的应用场景需求来选择合适的框架,例如高吞吐量、低延迟、或是 GPU 内存占用 (GPU footprint)。

Qwen3 模型

Qwen3 是中国首个混合推理模型,在 AIME、LiveCodeBench、ArenaHard、BFCL 等权威评测集上均获得出色的表现(信息来源于阿里巴巴官方微信公众号)。Qwen3 提供的系列开源稠密和 MoE 模型在推理、指令遵循、Agent 能力、多语言支持等方面均大幅增强,是全球领先的开源模型。

大语言模型的推理性能对于

实时、经济高效的生产级部署至关重要

LLM 生态系统快速演进,新模型和新技术不断更新迭代,需要一种高性能且灵活的解决方案来优化模型。

推理系统设计颇具挑战,要求也不断提升,这些挑战包括 LLM 推理计算预填充 (prefill) 和解码 (decode) 两个阶段对于计算能力和显存大小 / 带宽的需求差异,超大尺寸模型并行分布式推理,海量并发请求,输入输出长度高度动态请求等。

目前在推理引擎上有许多优化技术可用,包括高性能 kernel、低精度量化、Batch 调度、采样优化、KV 缓存 (KV cache) 优化等等,选择最适合自己应用场景的技术组合需要耗费开发者大量精力。

NVIDIA TensorRT-LLM 提供了最新的极致优化的计算 kernel、高性能 Attention 实现、多机多卡通信分布式支持、丰富的并行和量化策略等,从而在 NVIDIA GPU 上实现高效的 LLM 推理。此外,TensorRT-LLM 采用 PyTorch 的新架构还提供了直观、简洁且高效的模型推理配置 LLM API,从而能够兼顾极佳性能和灵活友好的工作流。

通过使用 TensorRT-LLM,开发者可以迅速上手先进的优化技术,其中包括定制的 Attention kernel、连续批处理 (in-flight batching)、分页 KV 缓存 (Paged KV cache)、量化 (FP8、FP4、INT4 AWQ、INT8 SmoothQuant)、投机采样等诸多技术。

使用 TensorRT-LLM

运行 Qwen3 的推理部署优化

下面以使用 Qwen3-4B 模型配置 PyTorch backend 为例,描述如何快捷进行基准测试以及服务化的工作。采用类似的步骤,也可以实现 Qwen3 其他 Dense 和 MoE 模型的推理部署优化。

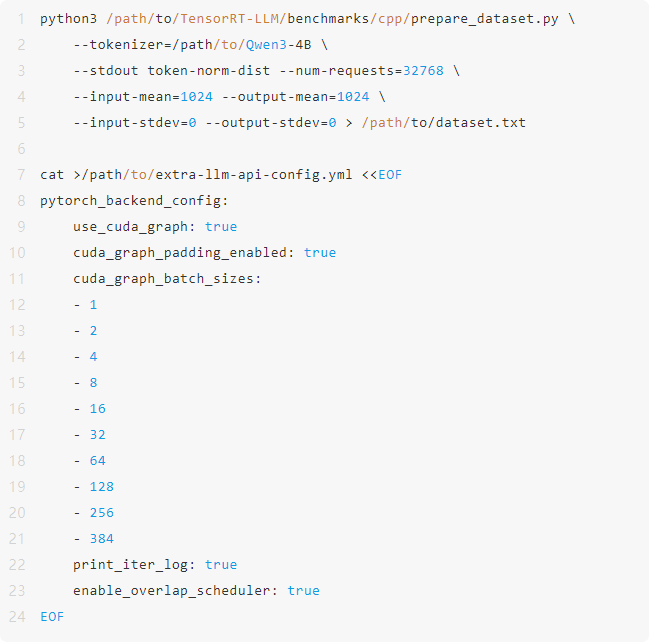
\1. 首先准备 benchmark 测试数据集合和 extra-llm-api-config.yml
配置文件:
在这里插入图片描述

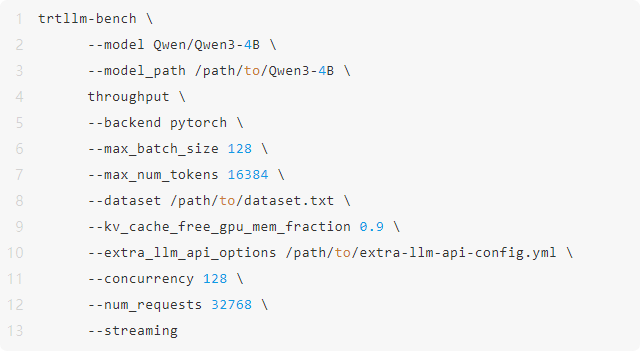
\2. 通过 trtllm-bench 运行 benchmark 指令:

在这里插入图片描述

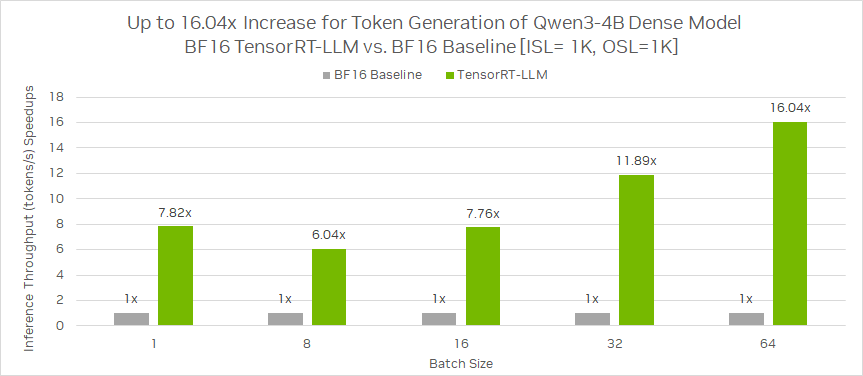
相同 GPU 环境配置下,基于 ISL = 1K,OSL = 1K,相较 BF16 基准,Qwen3-4B 稠密模型使用 TensorRT-LLM 在 BF16 的推理吞吐(每秒生成的 token 数)加速比最高可达 16.04 倍。
img

图 1:Qwen3-4B 稠密模型在 TensorRT-LLM BF16 与 BF16 基准的推理吞吐性能比较

该图片来源于 NVIDIA Blog: Integrate and Deploy Tongyi Qwen3 Models into Production Applications with NVIDIA,若您有任何疑问或需要使用该图片,请联系 NVIDIA

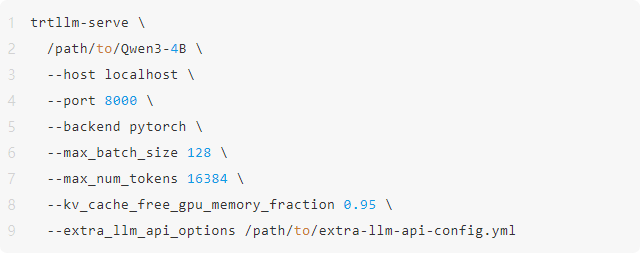
\3. 通过 trtllm-serve 运行 serve 指令:
在这里插入图片描述

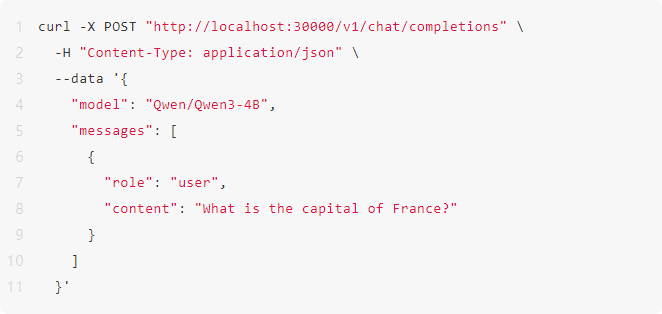
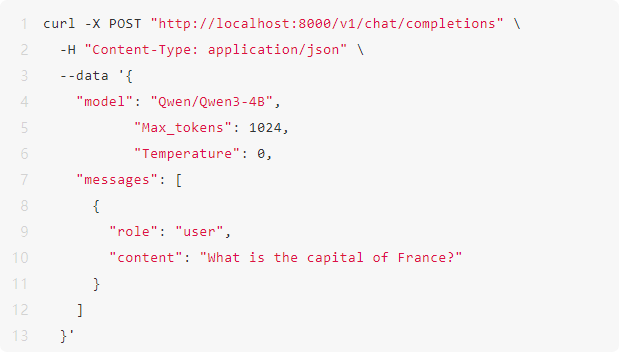
\4. 模型启动成功后,便可通过标准 OpenAI API 进行模型推理调用。
在这里插入图片描述

使用 Ollama,SGLang,

vLLM 框架运行 Qwen3-4B

除了 TensorRT-LLM,Qwen 模型也可以使用诸如 Ollama,SGLang,vLLM 等框架,通过简单几步部署到 NVIDIA GPU。Qwen3 提供了多种模型可以运行在终端和设备上,例如 NVIDIA Jeston 以及适用于 Windows 开发者的 NVIDIA RTX。

使用 Ollama 在本地运行 Qwen3-4B:

\1. 从以下网址下载和安装最新版本的 Ollama: ollama.com/download。

\2. 使用 ollama run 命令运行模型,此操作将加载并初始化模型用于后续与用户交互。

ollama run qwen3:4b

\3. 在用户提示词或系统消息中添加 /think(默认值)和 /no_think 可在模型的思考模式之间切换。运行 ollama run 命令后,可以直接在终端中使用以下的示例提示词,来测试思考模式:

"Write a python lambda function to add two numbers" - Thinking mode enabled
"Write a python lambda function to add two numbers /no_think" - Non-thinking mode

\4. 参考 ollama.com/library/qwen3 查看更多模型变量,这些变量基于 NVIDIA GPU 完成了优化。

使用 SGLang 运行 Qwen3-4B:

\1. 安装 SGLang 库

pip install "sglang[all]"

\2. 下载模型,在这个演示中,我们使用的是 Hugging Face 上的 huggingfaceCLI 命令提示符执行,请注意需要提供一个 API key 来下载模型。

huggingface-cli download --resume-download Qwen/Qwen3-4B --local-dir ./

\3. 加载和运行模型,请注意,根据不同的需求,可以传递额外的参数。更多详细信息可以参考相关文档。
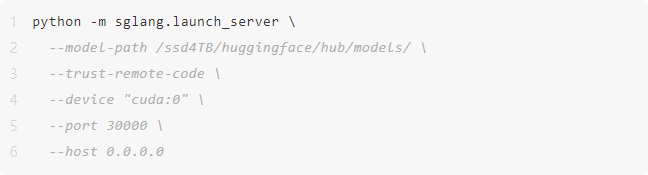
在这里插入图片描述

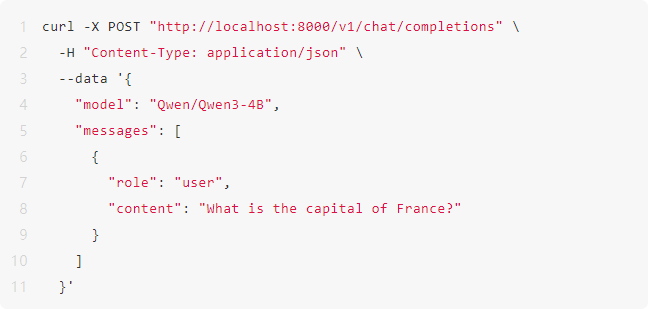
\4. 调用模型推理

在这里插入图片描述

使用 vLLM 运行 Qwen3-4B:

\1. 安装 vLLM 库

pip install vllm

\2. 通过 vllm serve 加载和运行模型,请注意,根据不同的需求,可以传递额外的参数。更多详细信息可以参考相关文档。
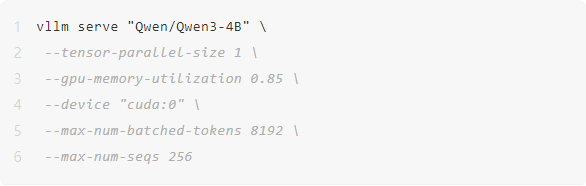
在这里插入图片描述

\3. 调用模型推理

在这里插入图片描述

总结

仅通过几行代码,开发者即可通过包括 TensorRT-LLM 在内的流行推理框架来使用最新的 Qwen 系列模型。

此外,对模型推理和部署框架的技术选型需要考虑到诸多关键因素,尤其是在把 AI 模型部署到生产环境中时,对性能、资源和成本的平衡。

如何零基础入门 / 学习AI大模型?

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高

那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

全套AGI大模型学习大纲+路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

read-normal-img

640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

在这里插入图片描述
在这里插入图片描述

在这里插入图片描述
在这里插入图片描述

👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

DeepSeek本地部署详细指南 通过上述步骤,你可以在本地成功部署DeepSeek模型,并通过Ollama或Open Web UI与模型进行交互。本地部署不仅能够保护数据隐私,还能根据需求灵活调整模型参数,满足不同场景下的使用需求。如果你在部署过程中遇到任何问题,可以在评论区留言,我们将一起解决。希望这篇教程能帮助你顺利部署DeepSeek模型,开启高效开发的新旅程! 阅读详情

相关推荐

LLM的MCP协议:初识MCP,搭建第一个MCP Server

MCP(Model Context Protocol),是一个开发的协议,标准化了应用程序如何为大模型提供上下文。MCP提供了一个标准的为LLM提供数据、工具的方式,使用MCP会更容易的构建Agent或者是基于LLM的复杂工作流。

Criss@陈磊 2万+

一文彻底整明白,基于Ollama工具的LLM大语言模型Web可视化对话机器人部署指南

在上一篇博文中,我们在本地部署了**Llama 3 8B**参数大模型,并用 Python 写了一个控制台对话客户端,基本能愉快的与 Llama 大模型对话聊天了。但控制台总归太技术化,体验不是很友好,我们希望能有个类似 ChatGPT 那样的 Web 聊天对话界面,本博文就安排起来……

老牛啊 1万+

NVIDIA 实现通义千问 Qwen3 的生产级应用集成和部署【2025年 5月 2日】

仅仅通过几行代码,开发者即可通过包括 TensorRT-LLM 在内的流行推理框架来使用最新的 Qwen 系列模型。此外,对模型推理和部署框架的技术选型需要考虑到诸多关键因素,尤其是在把 AI 模型部署到生产环境中时,对性能、资源和成本的平衡。

u013250861的博客 586

使用ollama在本地部署llama3-8b大模型

使用ollama在本地部署llama3-8b大模型

weixin_39945822的博客 1万+

ARKit面部动画实战:如何用blend shape让数字人表情更自然(附中文对照表)

本文深入探讨了如何利用ARKit的blend shape技术驱动数字人面部动画,以实现更自然生动的表情。文章提供了详细的blend shape中文对照表,并分享了实战技巧,包括构建复合表情动画序列、处理不对称性与微表情,以及性能优化策略,旨在帮助开发者高效提升数字人的表情表现力。

weixin_29292535的博客 326

游戏经济数值模型的搭建过程——以标准卡牌游戏为例

一、总体规划 1.玩家分类 首先我们按照下表对玩家进行分类 付费能力即为充值额度;充值行为比如购买月卡/购买钻石;消费行为比如用钻石抽卡 在这里我们假设玩家是理性的,即玩家会以追求更高的性价比为目标进行充值与消费(即小R会优先买首冲+月卡,而不是买一个无用的无属性皮肤) 不同类型玩家之间的差异,实际上就主要由这些行为的差异而决定。 注:早期游戏制作的时候,活跃程度也是区分玩家类型的一个重要依据。不过目前现在游戏中有各种手段抹平了不同活跃玩家的差异(体力限制,活跃时间长的收益递减)..

dudu3332的博客 4228

零基础小白也能轻松驾驭!通义千问Qwen3本地部署保姆级教程

今天给大家带来一篇超详细的教程,教你如何在自己的电脑上部署最新的通义千问Qwen3大模型。不需要任何编程基础,按照步骤来,你也能拥有一个私人AI助手!

瓦罗兰特顶级C位的博客 5085

告别地图偏移!手把手教你用MapOnline V1.2在ArcGIS里加载无偏谷歌影像和历史影像

本文详细介绍了如何使用MapOnline V1.2插件在ArcGIS中加载无偏谷歌影像和历史影像,解决GIS工程师长期面临的地图偏移问题。通过三步安装配置、无偏影像加载和时空分析功能,提升地理信息数据的精确度和工作效率,特别适用于城市规划、环境监测等场景。

weixin_29252171的博客 232

企业级AI部署实战:通义千问从概念验证到生产级应用完整指南

当企业技术决策者面临AI大模型选型时,最核心的挑战是什么?是模型性能与成本的平衡?是中文场景的适配性?还是从实验环境到生产系统的平滑迁移?通义千问(Qwen)作为阿里巴巴云开源的领先大语言模型,提供了从1.8B到72B参数的全系列解决方案,但真正的价值在于其为企业级部署量身打造的技术生态。 ## 场景挑战:企业AI部署的三大痛点 ### 痛点一:成本与性能的永恒博弈 企业部署大模型面临的首要挑

gitblog_00144的博客 1104

5种主流触觉传感器对比:GelSight、DIGIT、Taxim、GelSlim和TACTO怎么选?

本文深度对比了GelSight、DIGIT、Taxim、GelSlim和TACTO五种主流触觉传感器的技术原理与应用场景。针对机器人及VR项目的选型需求,文章从光学与电子传感的技术分野出发,分析了各传感器在分辨率、响应速度、集成难度和成本上的核心差异,并提供了从需求出发的实战选型决策框架,帮助开发者找到最适合的触觉解决方案。

weixin_29268637的博客 695

ArcGIS-裁剪遥感影像及dem图像

6、选择【工具箱】-【数据管理工具】-【栅格】-【裁剪】。在【输入栅格】里选择要裁剪的dem,在【输出范围】里选择刚创建的裁剪范围。选择一个输出路径,其他参数保存默认。2、起一个名称,要素类型选择【面】。点击【编辑】选择与要裁剪的dem一致的地理坐标系。1、创建需要裁剪区域的面层shp,右击选择【新建】-【shapefile】3、点击编辑器,选择开始编辑。4、选择【裁剪范围】,点击确定。5、画出想要裁剪的范围并保存。

siwenaiyou的博客 1万+

5个实战策略:通义千问开源AI模型高效部署与生产级应用指南

在当今快速发展的AI领域,开源AI模型部署已成为开发者构建智能应用的关键环节。通义千问作为阿里巴巴云推出的开源大语言模型系列,以其卓越的多语言理解能力和工具调用机制,为开发者提供了强大的技术基础设施。本指南将从技术架构深度解析到生产环境优化,全面探讨AI模型部署的最佳实践。 ## 项目定位与市场价值分析 通义千问系列模型覆盖从1.8B到72B的参数规模,形成完整的技术栈布局。在开源AI模型部署

gitblog_00065的博客 888

Google 人机验证(reCaptcha)无法显示解决方案

Google 人机验证无法显示解决方案第一步 安装插件Chrome/Edge 电脑版Firefox 电脑版第二步 配置插件原理参考文章 前言:为了防止机器人攻击,国外很多网站都使用了 Google reCaptcha 验证码。reCaptcha 对于国外用户非常的友好,但是… 对于国内用户就不怎么友好了。究其原因,则是国内网络全线屏蔽 Google 服务,导致 reCaptcha 完全加载不出来。这样,国内玩家就无法在对应的网站进行下一步操作了。本方案可以解决 reCaptcha 无法加载的问题。 适用

qq_40713201的博客 8万+

深度解析:基于NVIDIA GPU部署通义千问Qwen3大模型的全流程优化方案

阿里巴巴最新开源的通义千问Qwen3系列大语言模型(LLM)凭借混合专家(MoE)架构与稠密模型的双重配置,已成为国内生成式AI领域的重要突破。该系列包含235B-A22B(2350亿总参数/220亿激活参数)等MoE模型及0.6B至32B等稠密模型,在AIME、LiveCodeBench等国际权威评测中表现突出。本文将系统阐述如何利用NVIDIA GPU及配套推理框架,实现Qwen3模型的生产级

gitblog_00477的博客 1325

四足机器人机械结构设计:从腿型到驱动的全面解析

本文全面解析了四足机器人机械结构设计的核心要点。资深工程师老张深入探讨了并联腿与串联腿的选型策略、不同腿型布局对稳定性的影响,并详细对比了皮带轮与连杆驱动方式的优劣。文章结合实战经验,强调了足端设计、材料选择及整体结构轻量化等关键细节,为机器人开发者提供了从理论到实践的宝贵指导。

assembly8low的博客 633

手把手教你用Pytorch代码实现Transformer模型(超详细的代码解读)

本文整理了非常清楚的Transformer模型结构图,建议大家在看代码的时候能结合这个结构图来理解,这样理解起来会比较容易! 用Pytorch实现Transformer的完整代码

捡起一束光的博客 7万+

零基础小白也能轻松驾驭!通义千问Qwen3本地部署保姆级教程,大模型入门到精通,收藏这篇就足够了!

今天给大家带来一篇超详细的教程,教你如何在自己的电脑上部署最新的通义千问Qwen3大模型。不需要任何编程基础,按照步骤来,你也能拥有一个私人AI助手!

2401_82469710的博客 3124

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

通义千问开源大模型:7个核心技术突破与生产级部署实战指南

通义千问(Qwen)作为阿里巴巴云开源的大语言模型系列,在技术创新和应用实践方面展现出卓越表现。本文深入剖析其技术架构,提供从架构设计到生产部署的完整解决方案,帮助开发者和AI应用构建者掌握这一前沿技术。 ## 架构突破分析:重新定义大语言模型的能力边界 通义千问的技术架构在多个维度实现了突破性创新,特别是在工具调用、长上下文处理和量化优化方面表现突出。基于Transformer解码器结构,Q

gitblog_00496的博客 1013

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

通义千问Qwen:从架构创新到生产级部署的全栈大模型解决方案

在人工智能浪潮中,大型语言模型的部署门槛成为制约技术落地的关键瓶颈。阿里云开源的Qwen系列大语言模型,通过创新的架构设计、高效的压缩技术和完整的工程化方案,为技术决策者和工程团队提供了从理论到实践的全栈解决方案。本文将深入解析Qwen模型的核心技术创新、量化压缩策略以及企业级部署的最佳实践。 ## 大模型部署的硬件挑战与Qwen的应对策略 当前大语言模型的硬件需求已成为企业部署的主要障碍。传

gitblog_00722的博客 1251

VC中sqlite的使用

在VC中对sqlite的使用,实现数据库大批数据的快速插入,读取数据库中的数据在ListCtrl中显示

通义千问(Qwen)大语言模型架构深度解析与生产级部署优化指南

通义千问(Qwen)作为阿里巴巴云推出的开源大语言模型系列,凭借其卓越的多语言理解、代码生成和数学推理能力,已成为企业级AI应用的重要技术选型。本指南深入剖析Qwen的技术架构设计理念,提供从模型选择到生产部署的完整解决方案,重点分析其在32K长上下文处理、工具调用机制和量化优化方面的技术优势。 ## 核心技术架构深度解析 ### Transformer解码器架构优化 Qwen采用基于Tra

gitblog_00100的博客 905

企业级AI模型部署实战:通义千问32K上下文生产级应用完整指南

通义千问(Qwen)作为阿里巴巴云推出的开源大语言模型系列,凭借其卓越的多语言理解能力、32K超长上下文支持以及高效的量化优化技术,已成为企业级AI应用部署的首选方案。本技术白皮书深入解析Qwen的技术架构,提供从环境配置到生产级优化的完整解决方案,帮助企业技术团队快速实现高性能AI服务部署。 ## 技术概览:企业级AI模型架构设计 通义千问基于Transformer解码器架构,采用旋转位置编

gitblog_00636的博客 949

企业级AI部署实战:通义千问32K上下文模型生产级应用完整指南

通义千问(Qwen)作为阿里巴巴云推出的开源大语言模型系列,凭借其卓越的32K超长上下文支持、多语言理解能力和高效的量化优化技术,已成为企业级AI应用部署的首选方案。本指南将为您提供从环境配置到生产级优化的完整解决方案,帮助技术团队快速实现高性能AI服务部署。 ## 企业面临的AI部署挑战与通义千问解决方案 在当今数字化转型浪潮中,企业面临三大核心挑战:如何选择合适的大语言模型?如何平衡性能与

gitblog_00104的博客 1027

通义千问3-4B-Instruct保姆级教程:从零开始部署全能型AI助手

本文介绍了基于星图GPU平台自动化部署通义千问3-4B-Instruct-2507镜像的完整流程。该平台支持一键拉取并运行该高性能轻量级模型,适用于本地化AI助手、模型微调与AI应用开发等场景,尤其适合在资源受限设备上实现长文本处理与智能推理。

weixin_35706255的博客 1115

小白也能玩转大模型!通义千问2.5-7B-Instruct保姆级部署指南

本文介绍了基于星图GPU平台自动化部署通义千问2.5-7B-Instruct镜像的完整流程,结合vLLM与Open WebUI实现高效推理与可视化交互,适用于模型微调、AI应用开发等场景,助力开发者快速构建本地化大模型服务。

weixin_42571280的博客 1027
上一篇: 浙大开源《大模型基础》爆火!技术人速来围观!
下一篇: 如何使用 Qwen3 实现 Agentic RAG?
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值