


嘿,小伙伴们!今天给大家带来一个超实用的开源工具组合,能帮企业快速搭建本地知识库,提升内部信息管理效率。这个组合就是 Ollama + DeepSeek + Dify,接下来我详细说说怎么操作,保证小白也能轻松上手!
为啥要搭建本地知识库?
现在企业内部信息管理太难了,数据到处都是,检索效率低得可怜,还缺乏智能化支持。尤其是面对海量非结构化数据,企业很难快速提取有价值的信息,决策效率低得不行。要是能有个工具解决这些问题,那可太棒了!
一、工具介绍
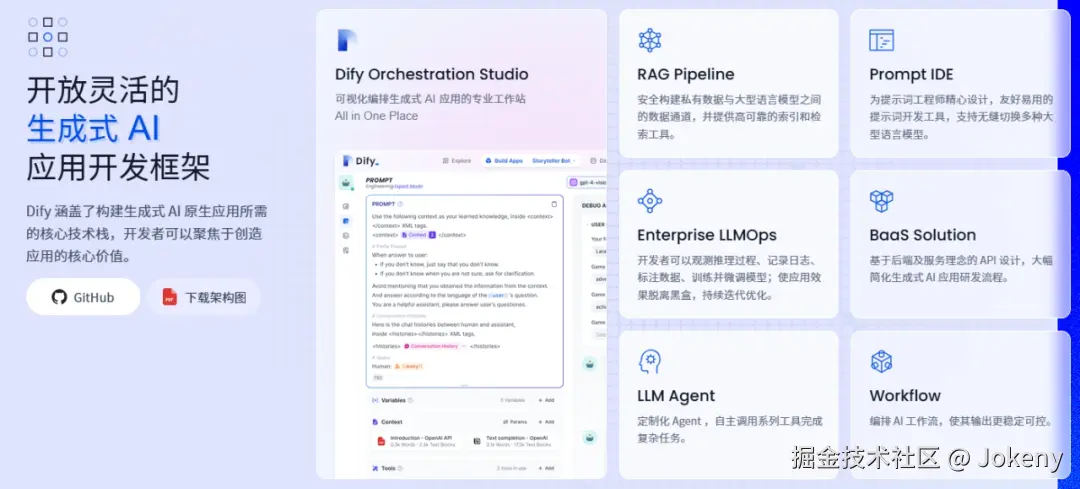
1. Dify:AI 应用开发平台
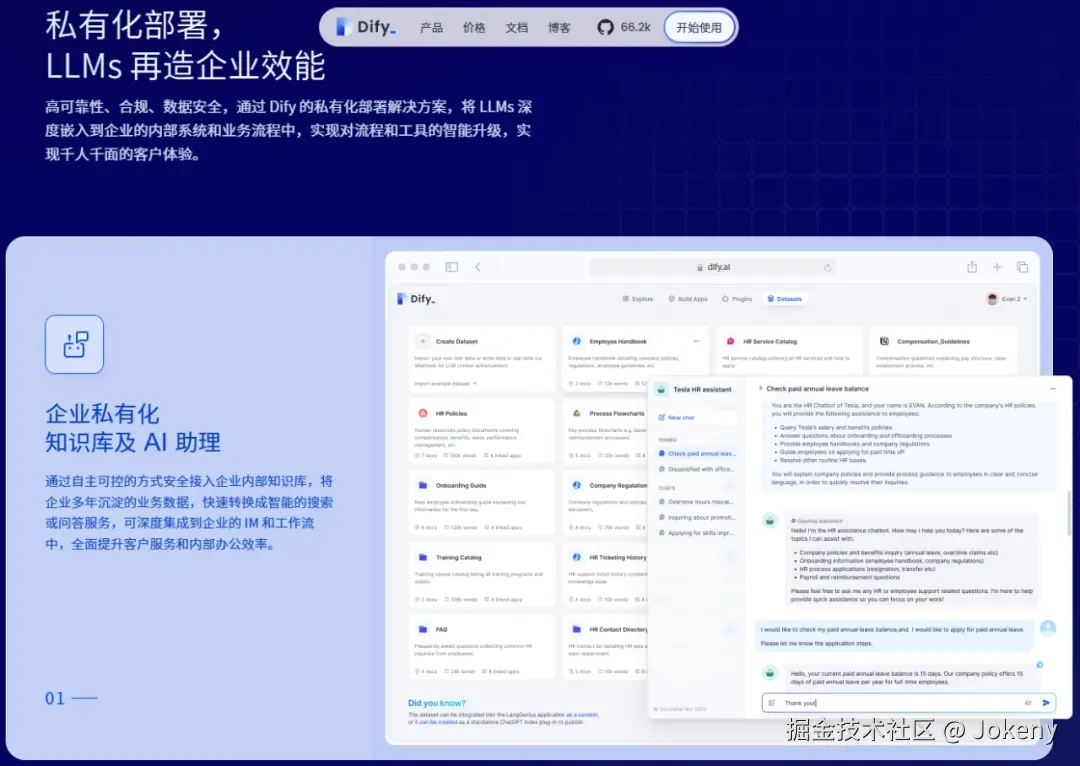
Dify 是一个开源的 LLM(大语言模型)应用开发平台,功能超强大。它支持自定义 AI 工作流,能实现复杂任务自动化;还有 RAG 管道,通过检索增强生成技术,让文档检索和问答超准;多种主流 LLM 模型都能集成管理,还提供丰富的日志和监控功能。Dify 的架构也很清晰,分为模型层、数据处理层、应用层和管理层,能满足各种需求。
2. DeepSeek:国产大模型的骄傲
DeepSeek 的 AI 大模型是国产之光,千亿参数规模下,API 调用成本低至 0.5 元/百万 tokens,中文基准测试得分高达 91.5%,推理效率还比传统架构提升了 5 倍。有了它,企业能轻松搭建本地知识库,提升信息管理效率。
3. Ollama:简化 LLM 本地部署
Ollama 是一个开源的本地化工具,专门用来简化大型语言模型的本地运行和部署。它能让用户在个人计算机或服务器上轻松运行多种开源语言大模型,比如 DeepSeek、qwen、Llama 等,完全不依赖云端服务,也不用复杂配置。
二、Dify 部署
1. 安装 Docker
Docker 是容器化部署工具,用于简化 Dify 的安装和运行环境配置。在 Windows 上安装 Docker Desktop 并启动服务即可完成准备工作。
访问官网:www.docker.com/
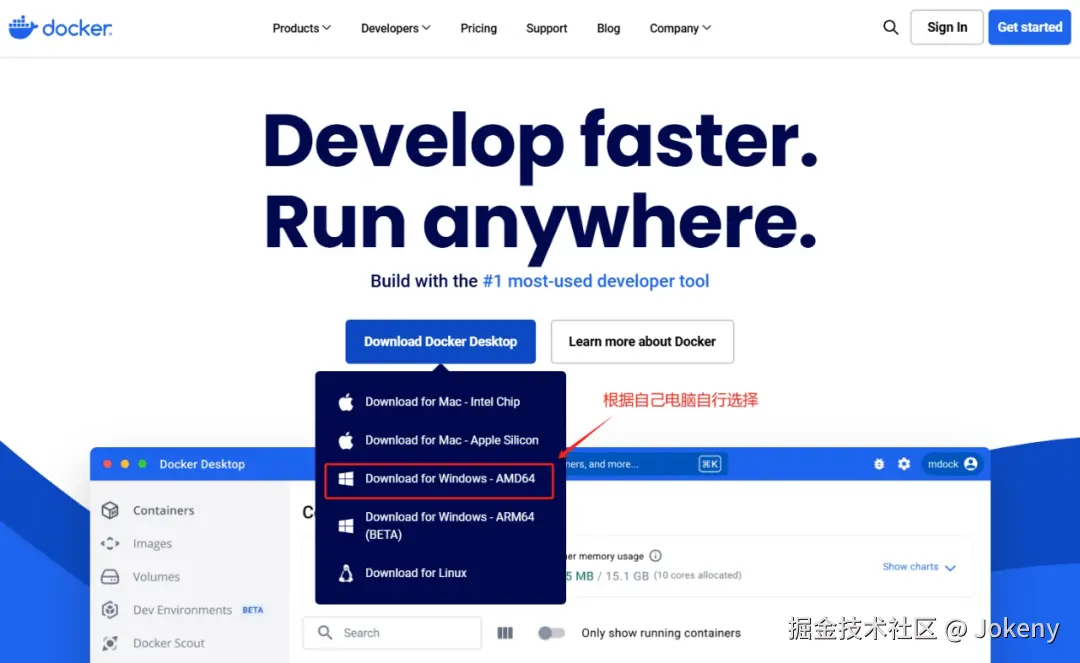
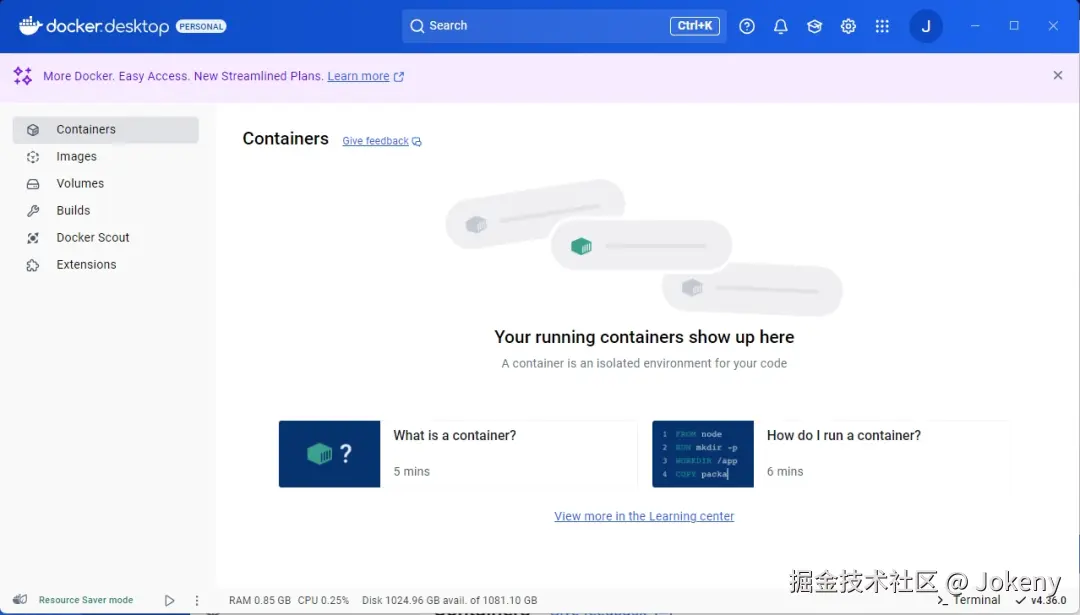
一路点击下一步安装即可,因为docker会用到hyper-v,如果电脑没开启hyper-v,可能会需要重启一次。安装完成后的界面如下图:
2. 安装 Dify 环境
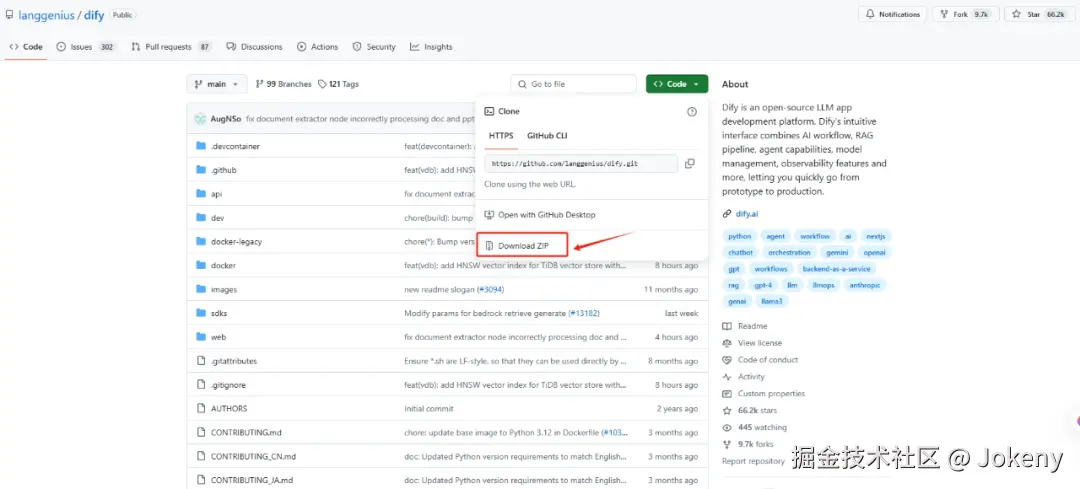
Github地址:github.com/langgenius/…
在浏览器中访问Github地址后,下载Dify项目压缩包,如下图:
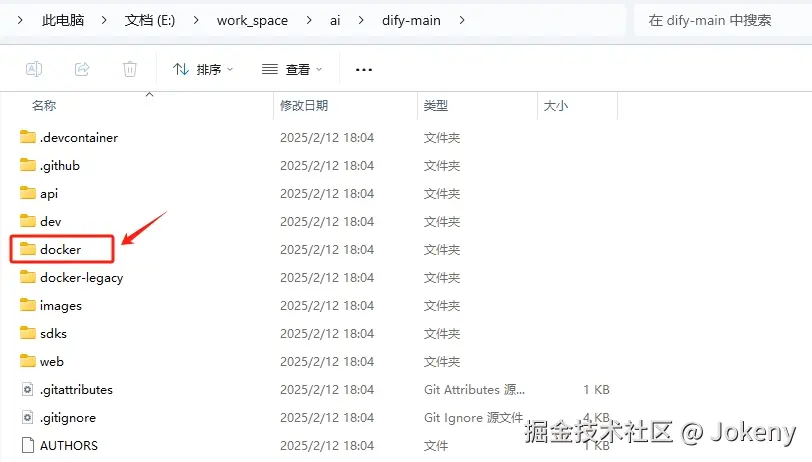
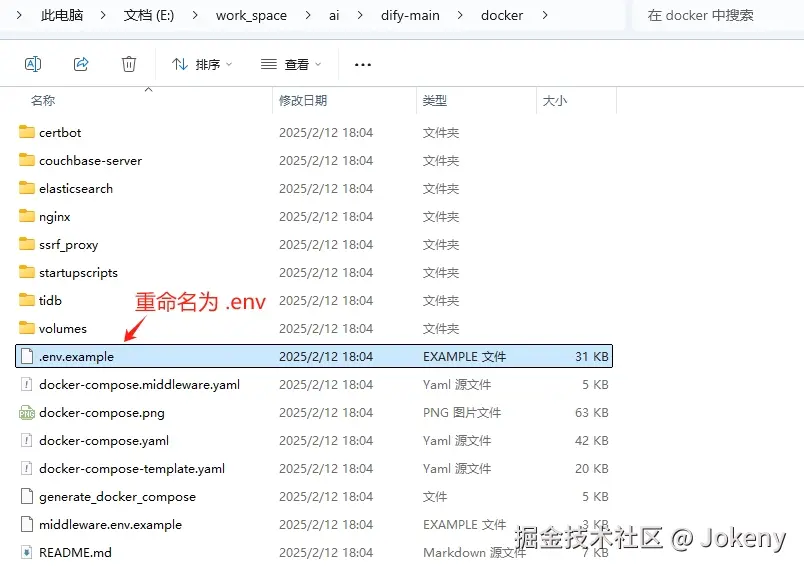
下载到本地后放入相应的磁盘目录解压,进入项目根目录找到docker文件夹,如下图:
然后将“.env.example”重命名为“.env”
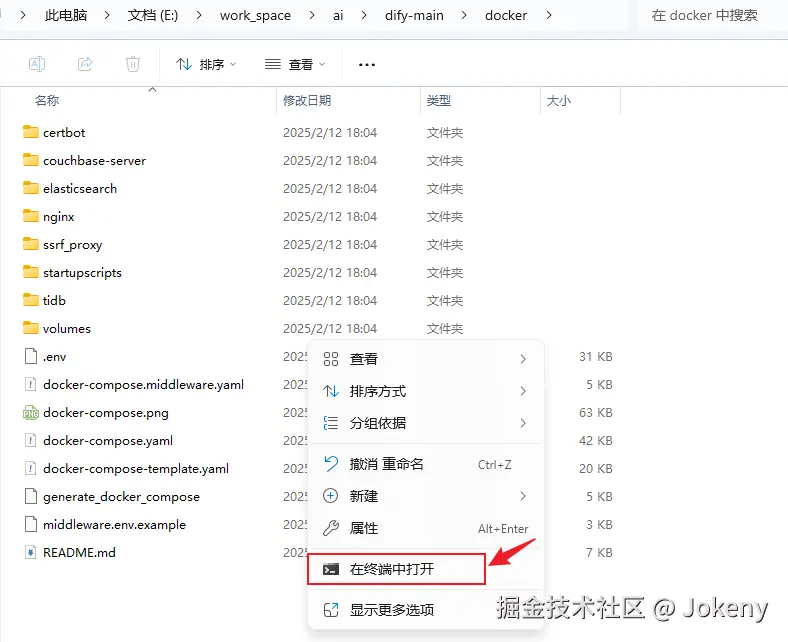
在该目录下单击鼠标右键,选择【在终端中打开】
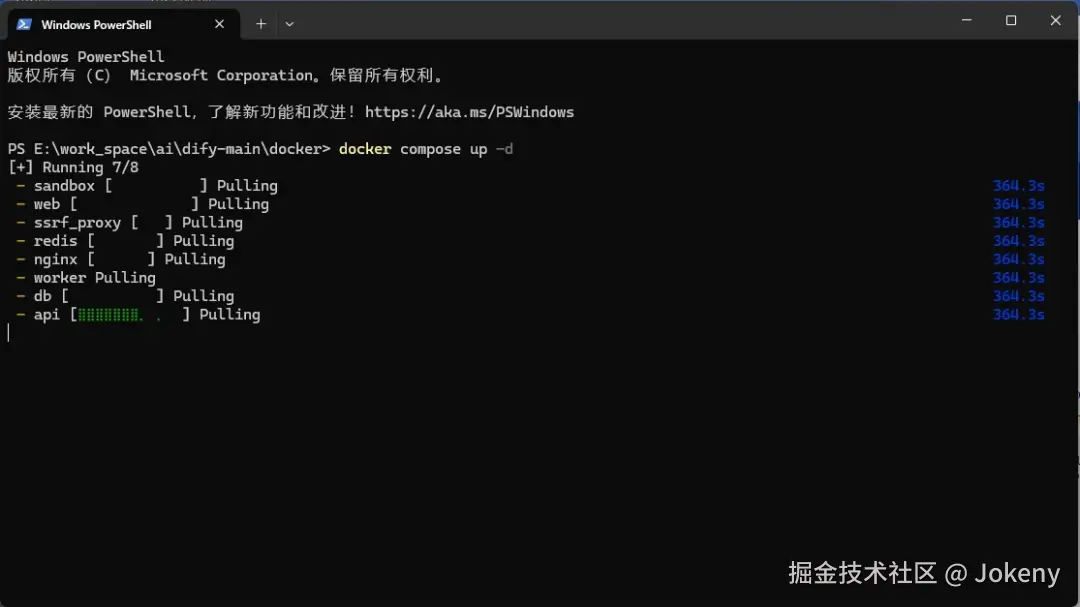
输入下面的命令运行docker环境
docker compose up -d
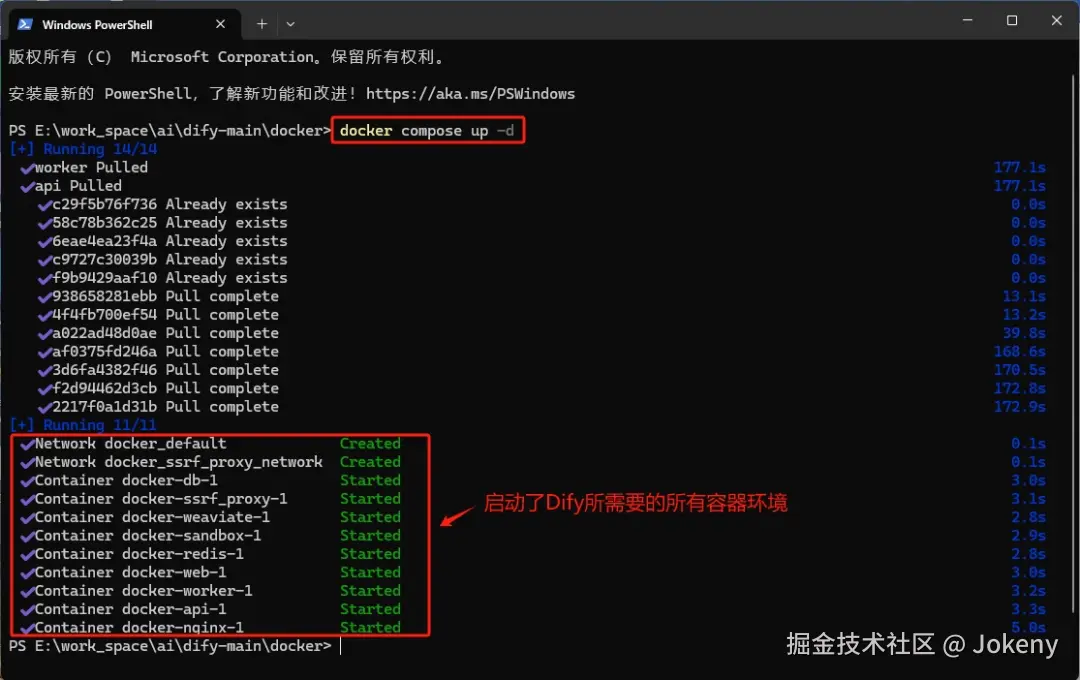
耐心等待,成功后的界面如下:
在此阶段可能会遇到下列失败的情况,可以尝试修改docker的镜像地址
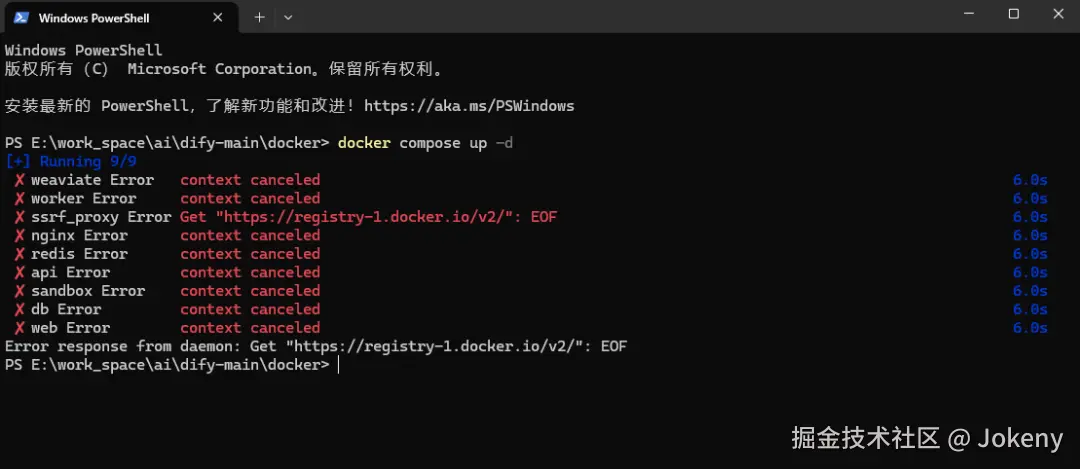
若遇到类似这种错误,进入docker主界面,点击右上角的设置按钮,修改镜像地址,如下图:
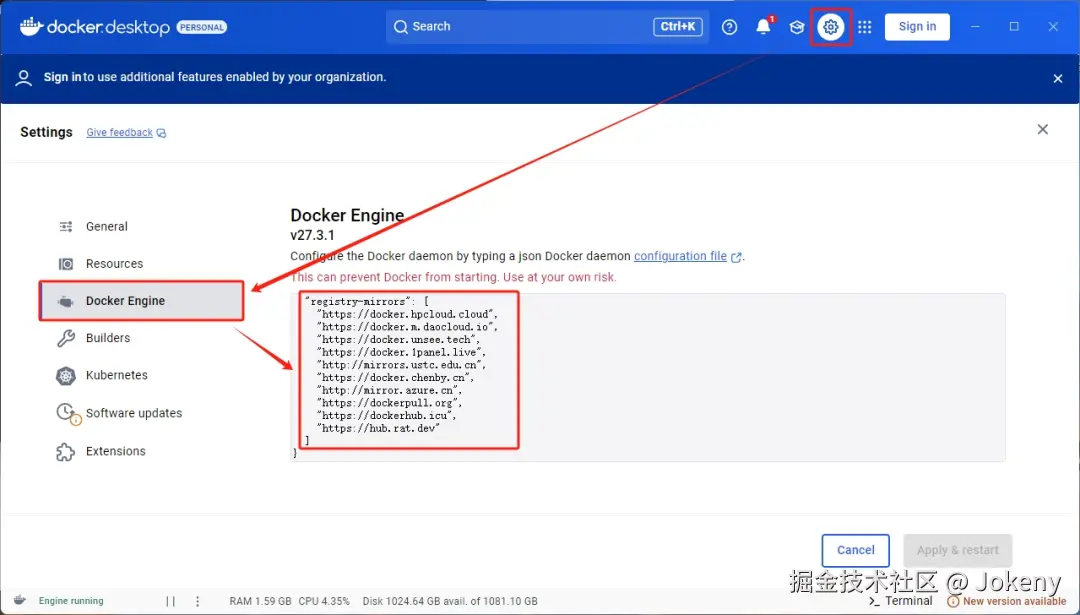
“registry-mirrors”为新增加的节点
{
  "builder": {
  "gc": {
    "defaultKeepStorage": "20GB",
    "enabled": true
    }
  },
  "experimental": false,
  "registry-mirrors": [
    "https://docker.hpcloud.cloud",
    "https://docker.m.daocloud.io",
    "https://docker.unsee.tech",
    "https://docker.1panel.live",
    "http://mirrors.ustc.edu.cn",
    "https://docker.chenby.cn",
    "http://mirror.azure.cn",
    "https://dockerpull.org",
    "https://dockerhub.icu",
    "https://hub.rat.dev"
  ]
}
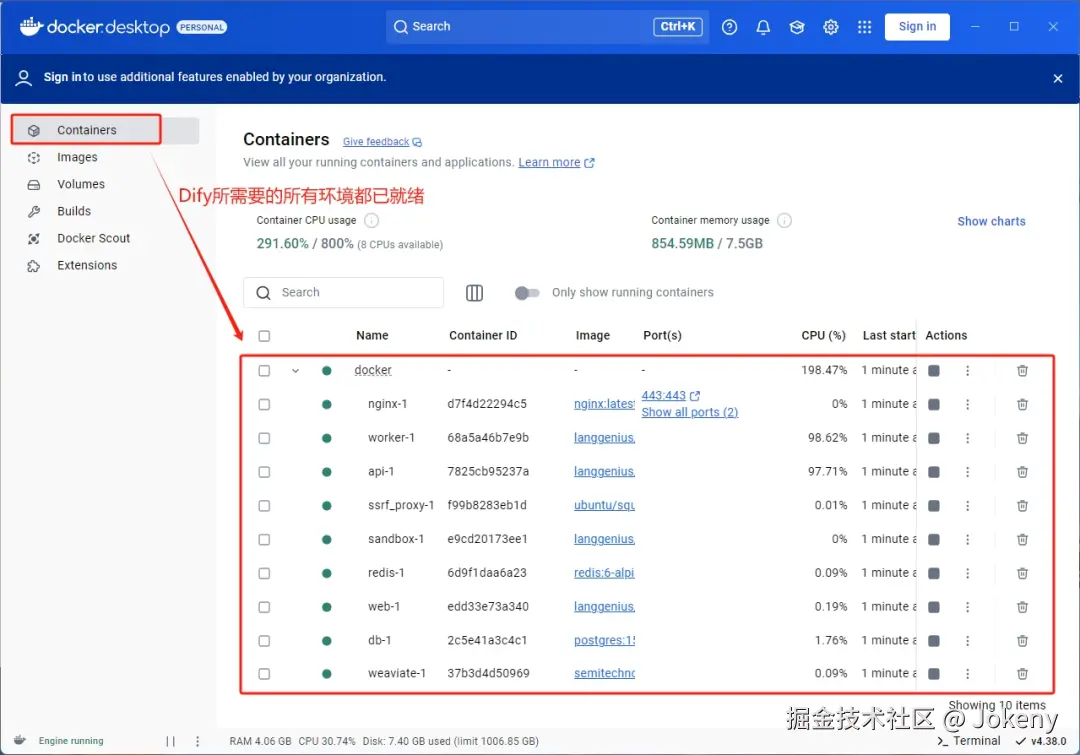
启动成功后回到docker桌面客户端,可看到所有dify所需要的环境都已经运行起来了,如下图:
3. 安装 Dify
在浏览器地址栏中输入“ http://localhost/install ”即可开始安装,如下图:
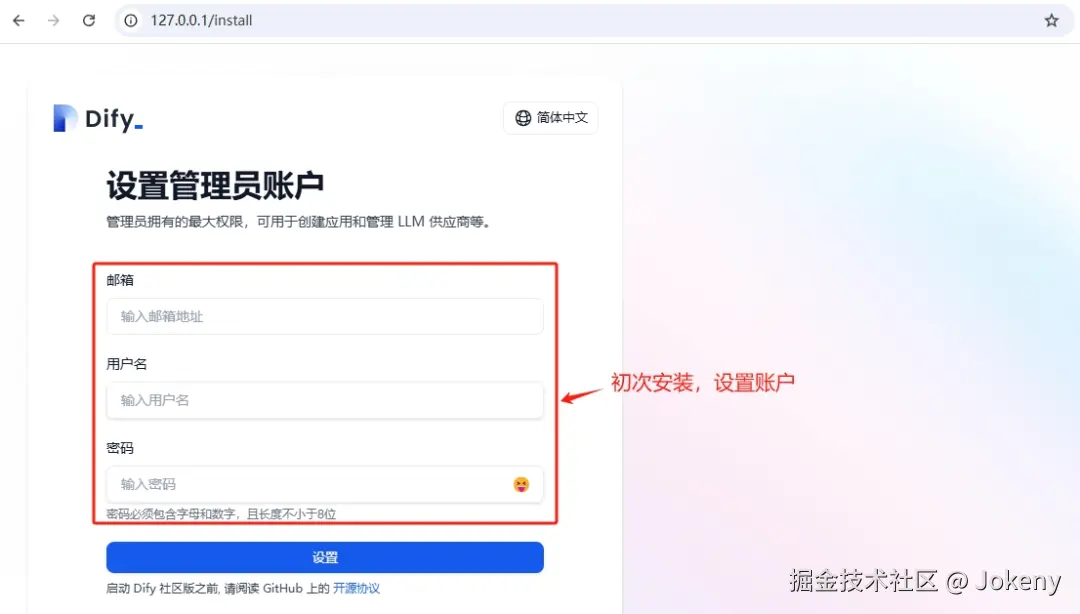
设置完账户后进行登录
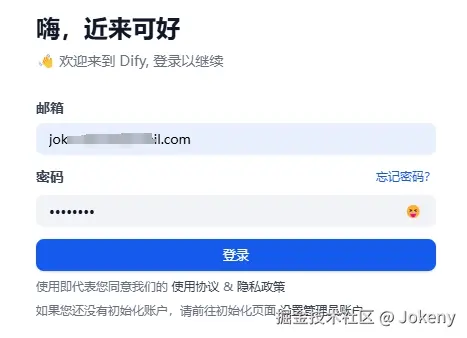
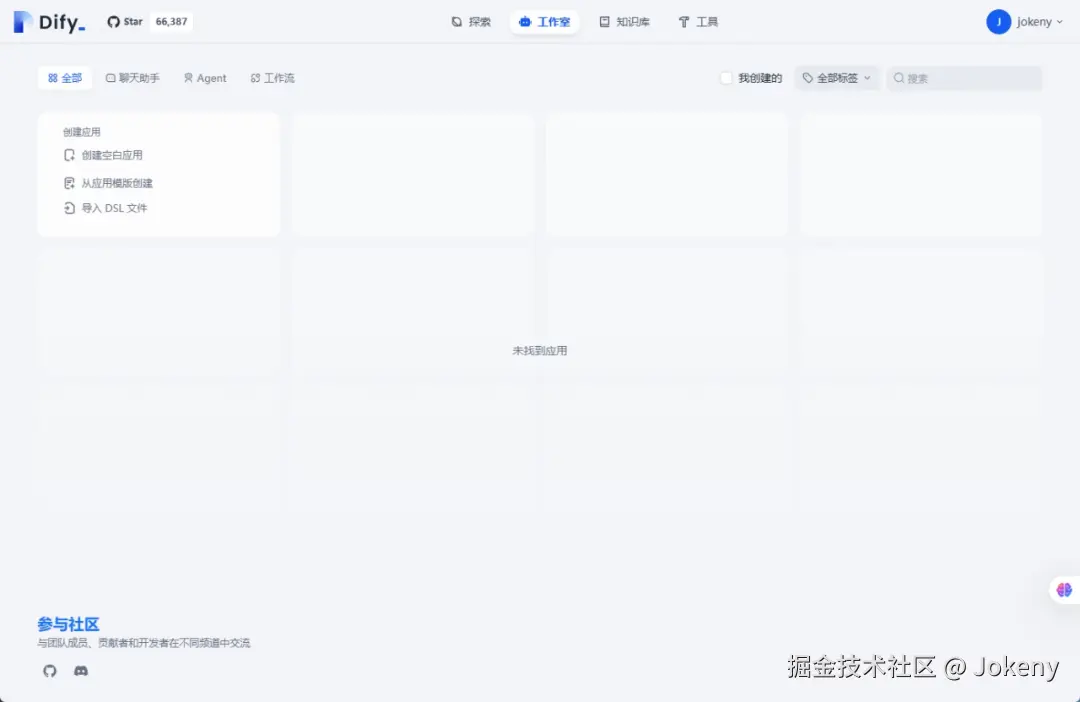
登录成功后进入Dify主页,如下图:
三、将本地大模型与 Dify 进行关联
因为Dify是通过Docker部署的,而Ollama是运行在本地电脑的,得让Dify能访问Ollama的服务。
1. 配置Dify
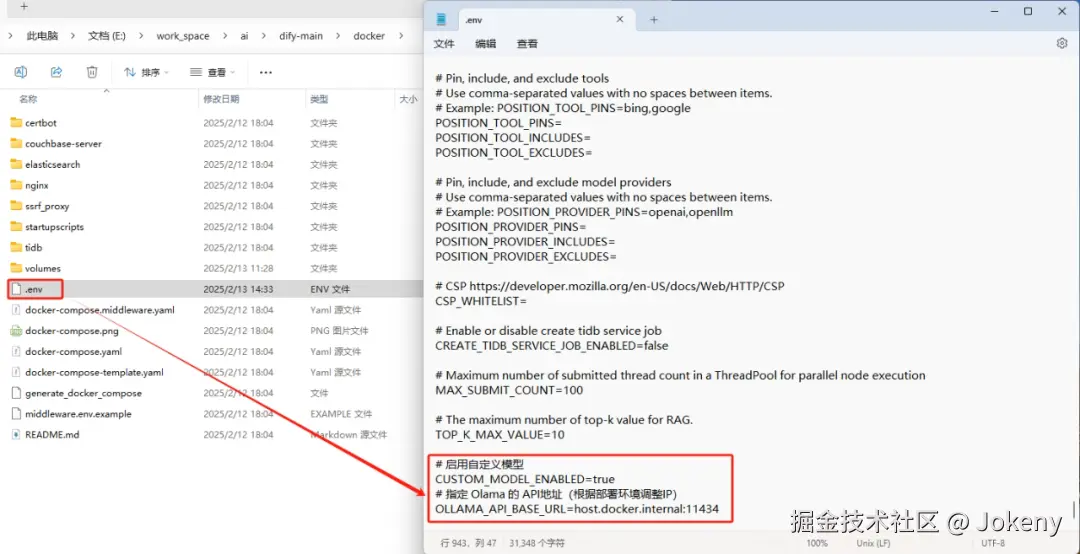
在Dify项目的docker文件夹里找到.env文件,在末尾填上配置:
# 启用自定义模型
CUSTOM_MODEL_ENABLED=true
# 指定 Olama 的 API地址(根据部署环境调整IP)
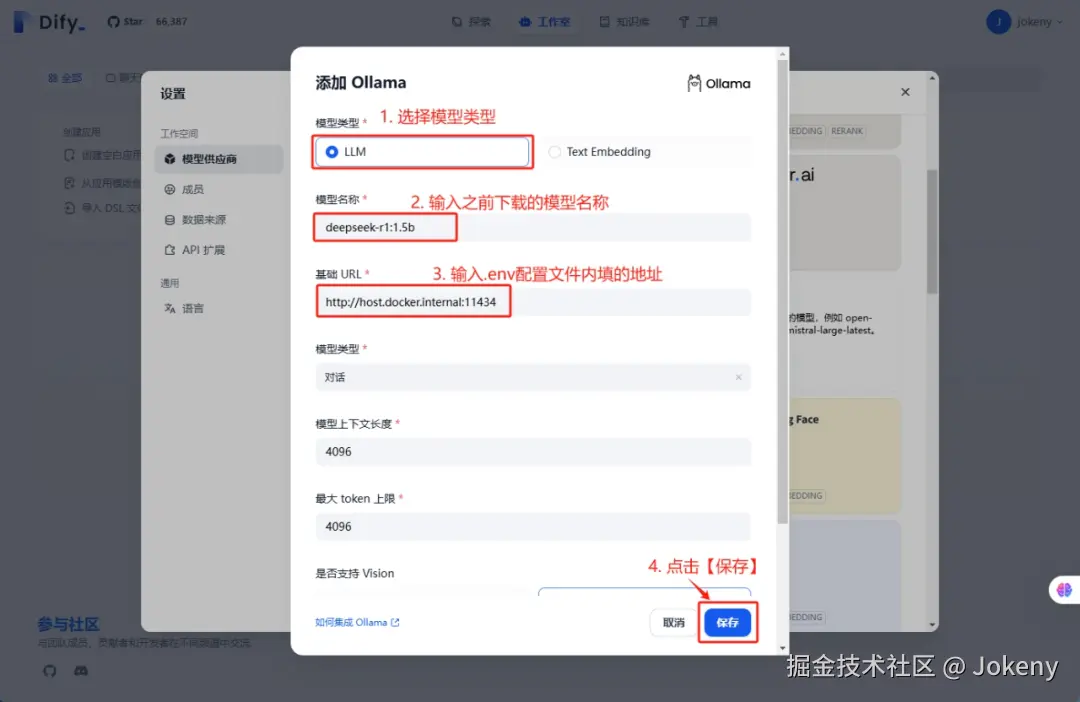
OLLAMA_API_BASE_URL=host.docker.internal:11434
2. 配置大模型
返回到Dify主界面,点击右上角用户名下的【设置】
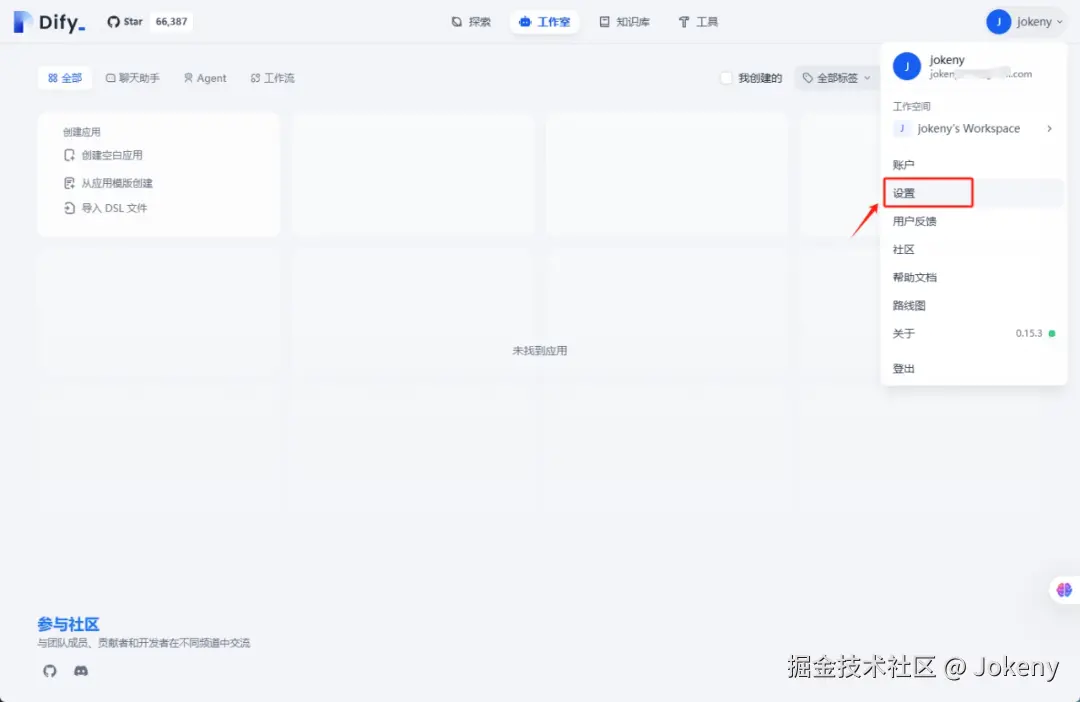
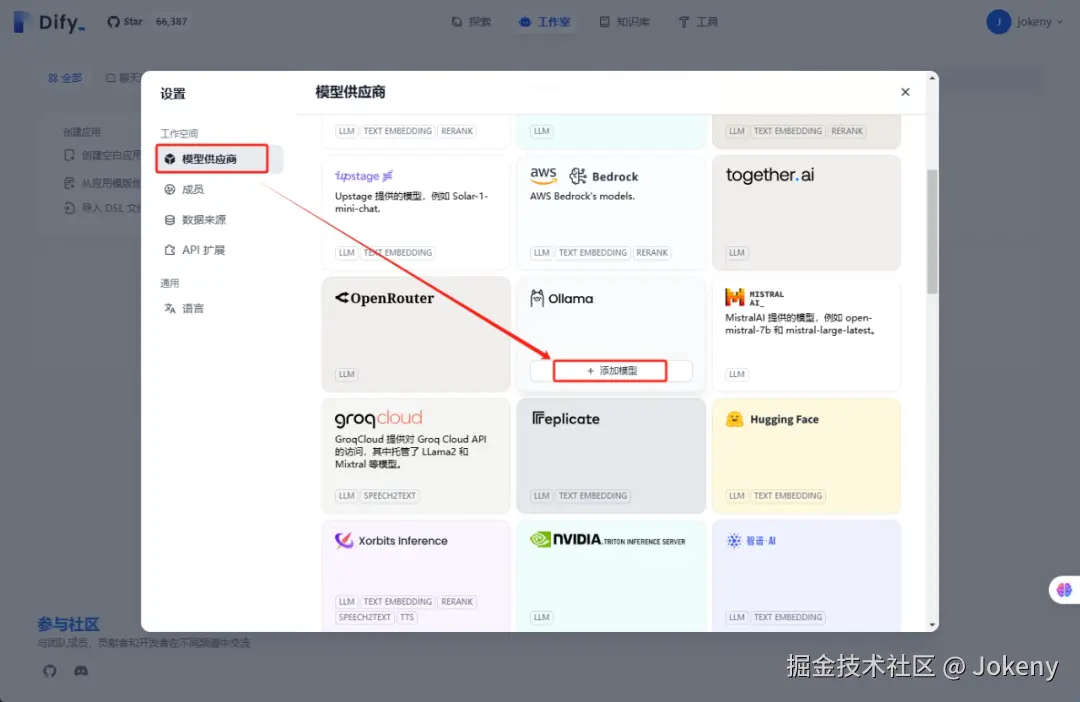
选择【模型供应商】,找到对应的 Ollama,点击【添加模型】
填写 DeepSeek 模型信息后点击【保存】
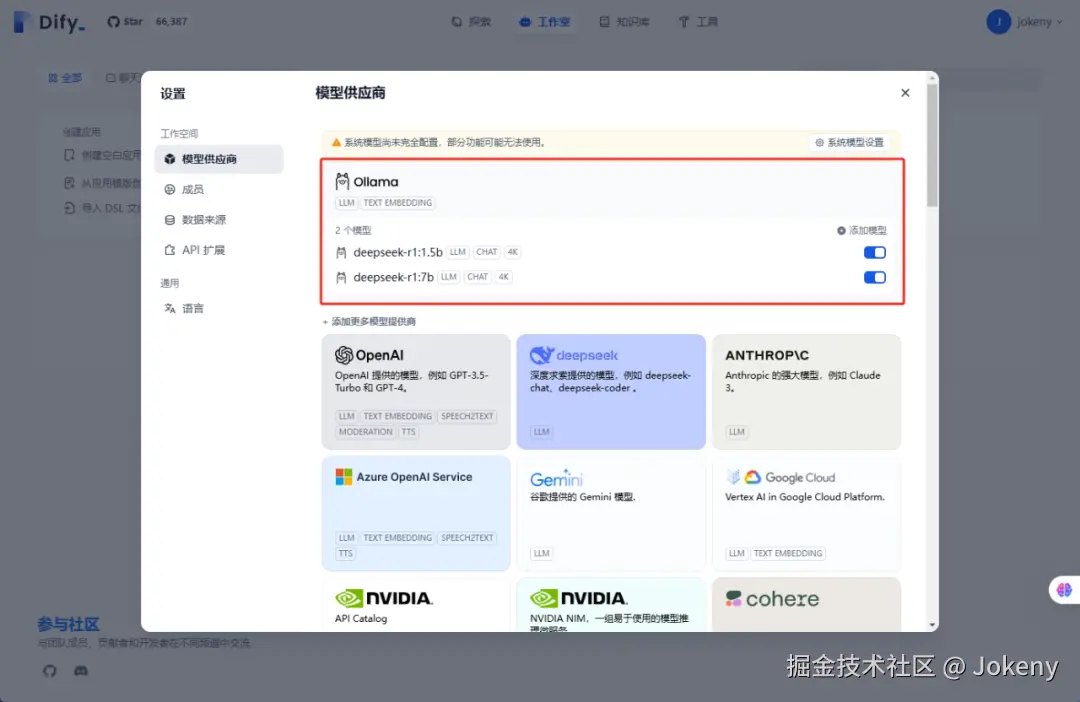
添加好模型后,接下来是设置系统模型,刷新网页。点击右上角用户名下的【设置】,选择【模型供应商】,点击右侧的【系统模型设置】
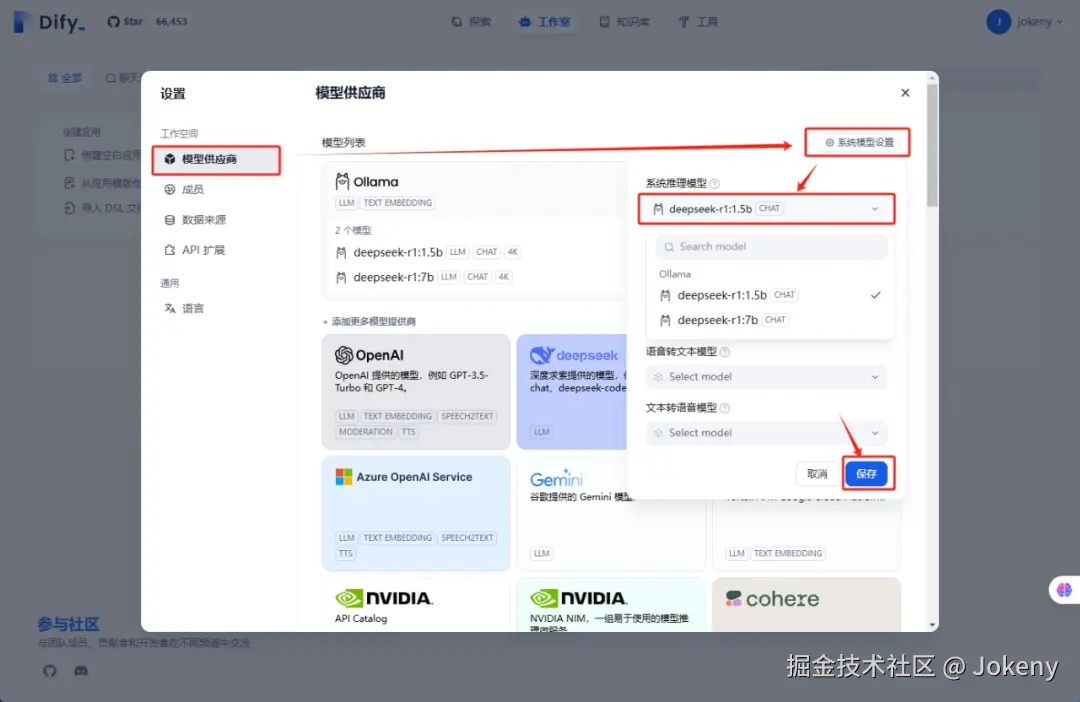
到此,Dify就与前面部署的本地大模型关联起来了。
四、创建应用
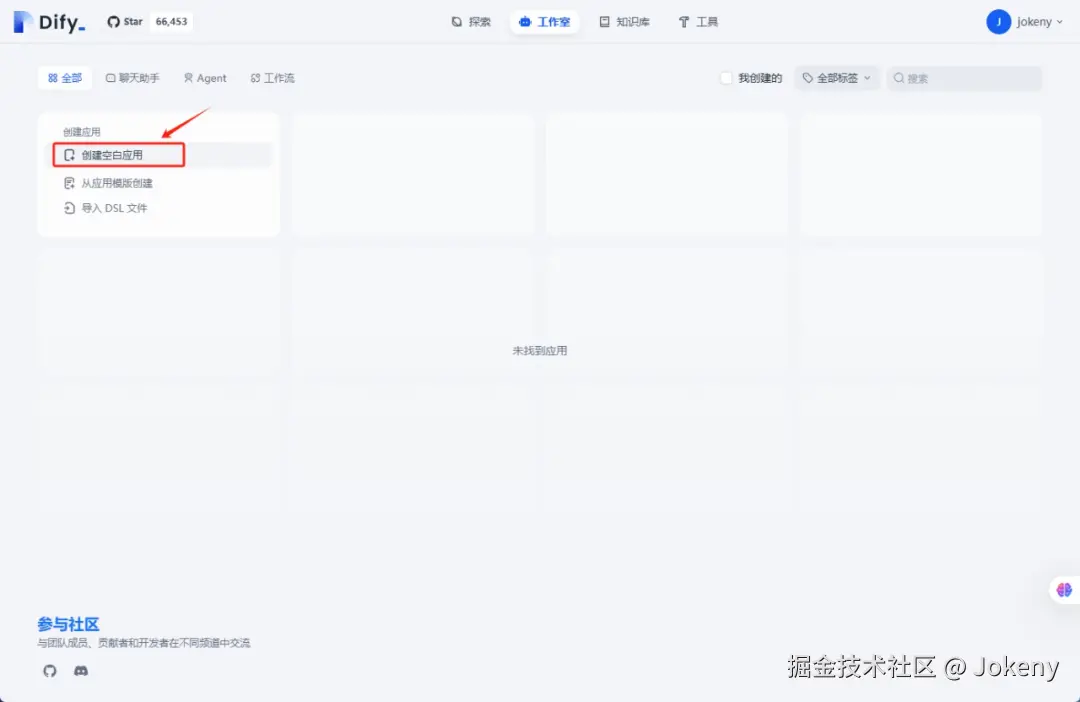
1. 创建空白应用
进入 Dify 主界面,点击【创建空白应用】,如下图:
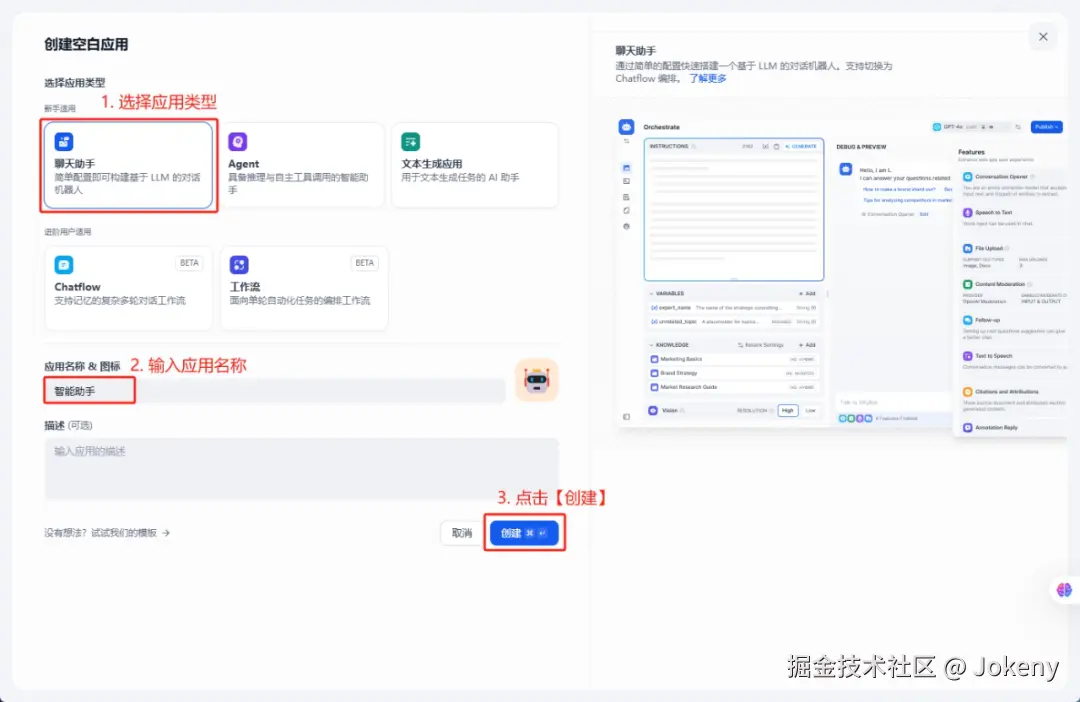
2. 应用配置
选择【聊天助手】,输入自定义应用名称和描述,点击【创建】
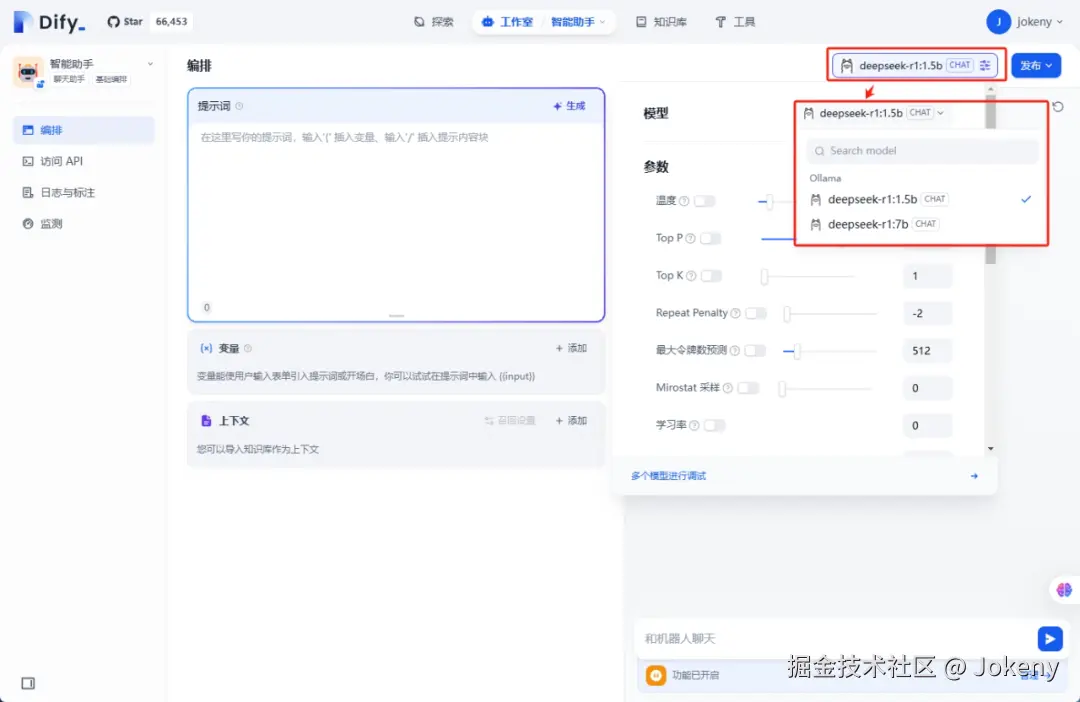
3. 配置大模型
右上角选择合适的模型(如 DeepSeek 或 Ollama),并配置相关参数
4. 测试
在下方对话框中输入“你是谁”,将会显示相应的输出内容,如下图:
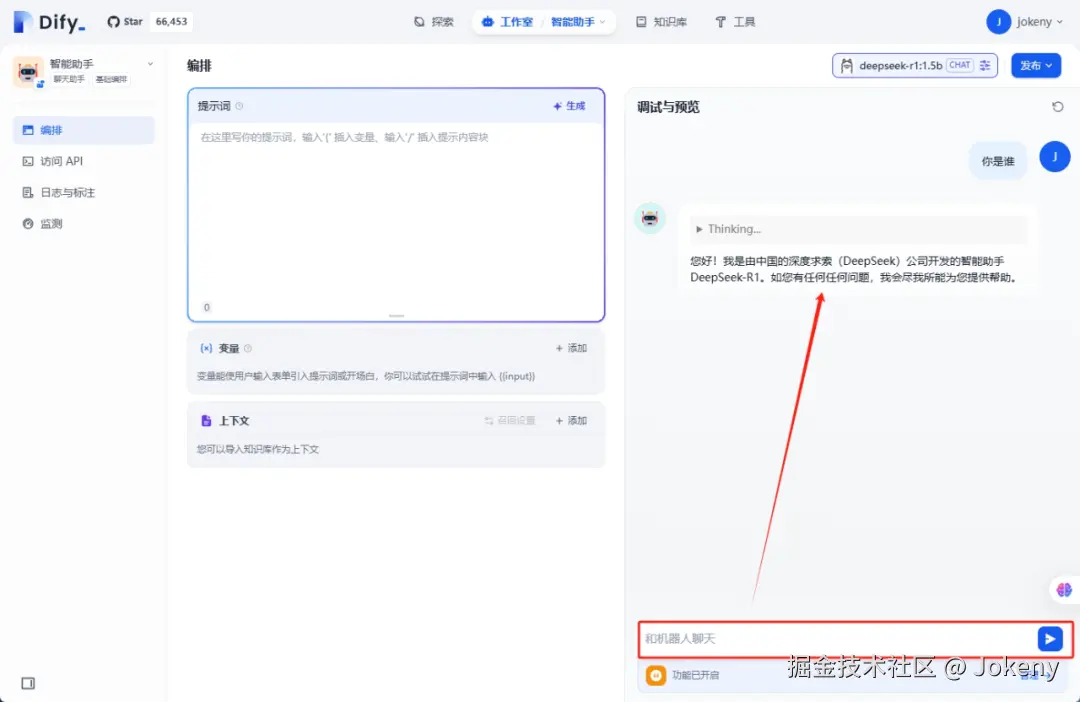
以上表明,Dify与本地部署的 DeepSeek 大模型已经连通了。
这时,你可能会问:“虽然它能回答问题,但能不能根据我自己的资料来回答呢?”别担心,这时候就需要用到本地知识库啦!通过将你的私有资料(比如文档、笔记等)上传到知识库,让 Dify 在回答问题时结合这些资料作为上下文,这样它就能给出更贴合你需求的答案了,就像一个真正了解你背景的智能助手一样。
五、创建本地知识库
1. 添加 Embedding 模型
Embedding模型可以把复杂的、高维的数据(比如文本、图像等)转换成低维的向量。这些向量虽然看起来只是数字,但它们能够很好地捕捉到数据的语义信息。比如,通过Embedding模型,我们可以把“猫”和“狗”这两个词转换成向量后,发现它们在向量空间中的距离比较近,因为它们在语义上是相似的,都是动物。
这种转换的作用可大了!首先,它可以用于文本分类,比如判断一篇文章是正面评价还是负面评价;还可以用于相似性搜索,比如在海量的文本中快速找到和用户问题最相关的答案;甚至在推荐系统中,通过Embedding模型把用户和商品的特征转换成向量,就能更精准地给用户推荐他们可能喜欢的东西。
在搭建知识库的时候,我们上传的资料(比如文档、文章等)需要先通过Embedding模型转换成向量,然后存入向量数据库。这样,当有人提问的时候,系统就能通过自然语言理解问题,然后在向量数据库中快速、准确地找到相关的资料,从而给出准确的回答。所以,提前把私有数据向量化入库,是为了让知识库在回答问题时更高效、更准确。
点击右上角用户名下的【设置】,选择【模型供应商】,点击右侧的【添加模型】,如下图:
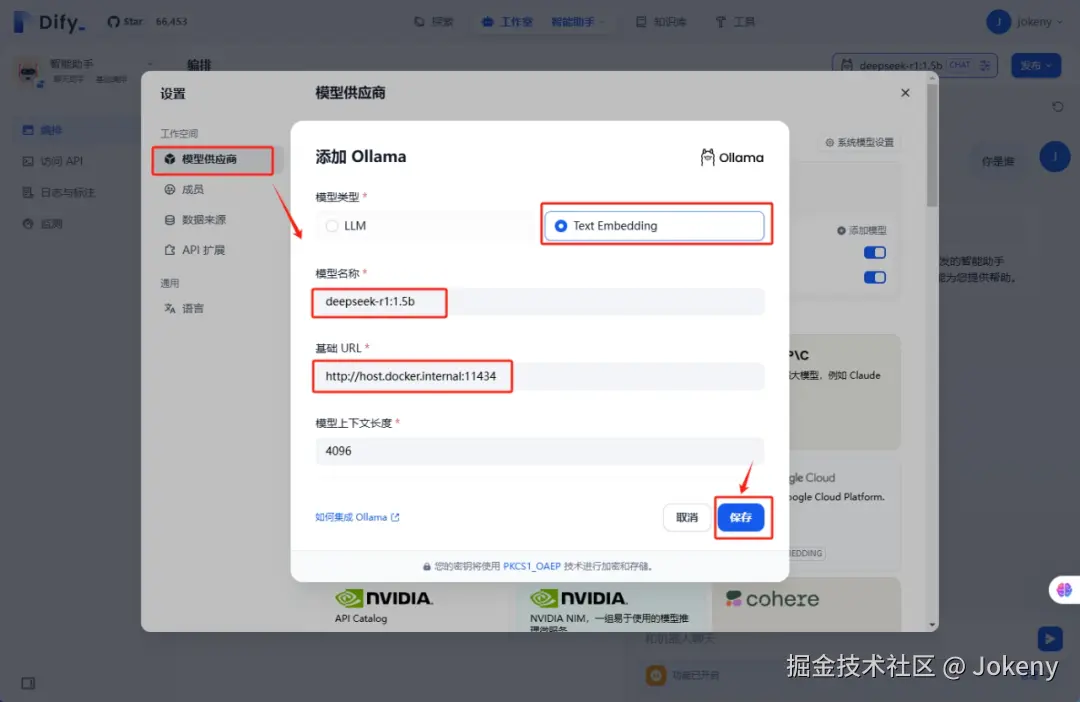
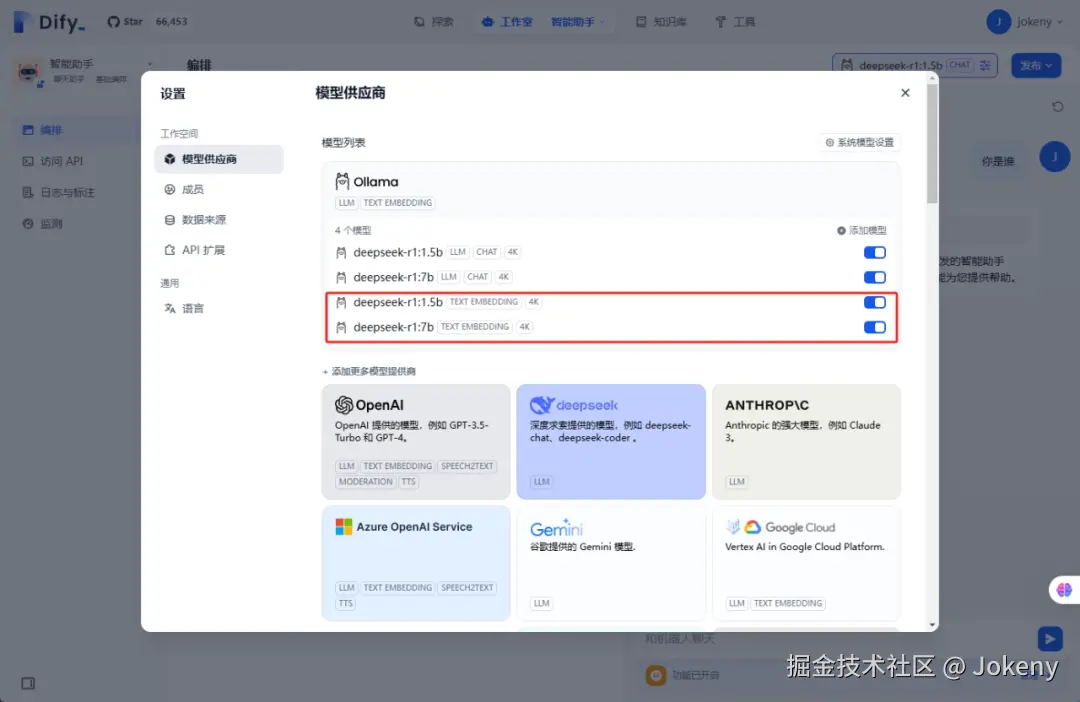
2. 创建知识库
返回 Dify 主界面,点击上方的【知识库】,点击【创建知识库】
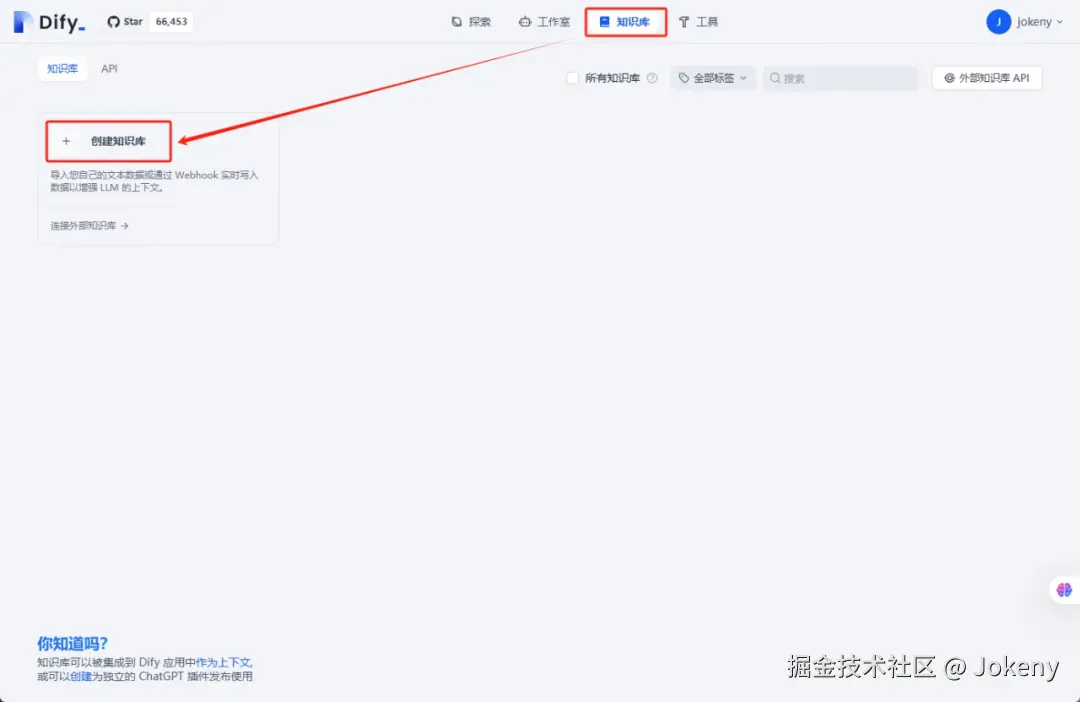
选择【导入已有文本】,上传资料(支持 TXT、PDF、Word、Excel 等格式,比如:可以上传一份企业内部的项目文档,或者个人的学习笔记)。
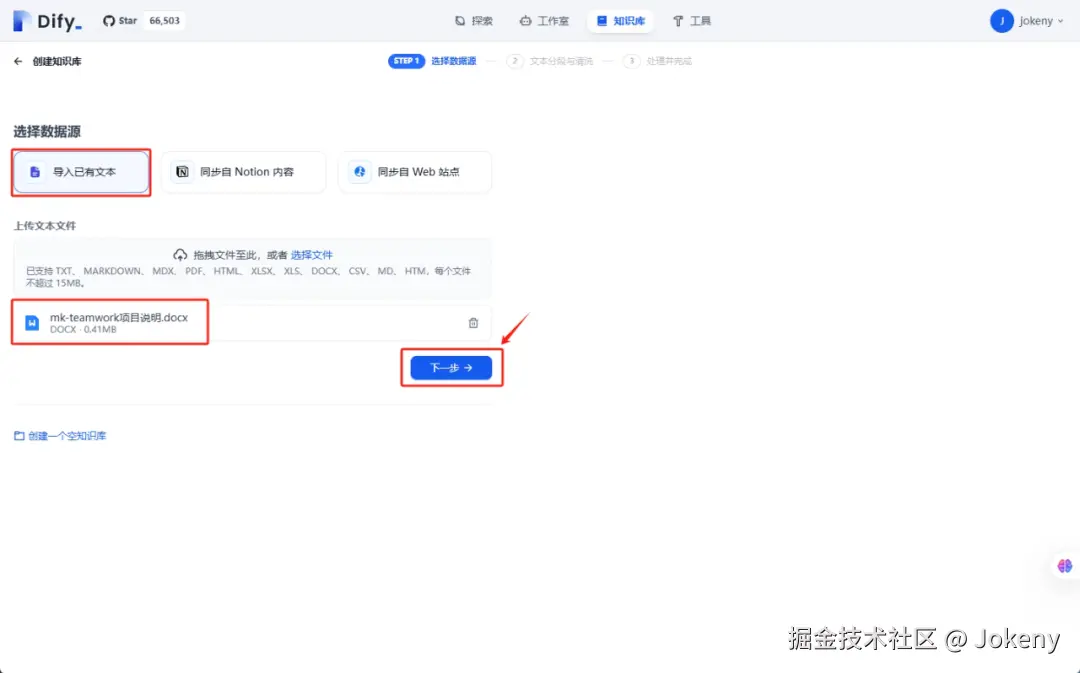
选择合适的模型,并配置相关参数后点击【保存并处理】
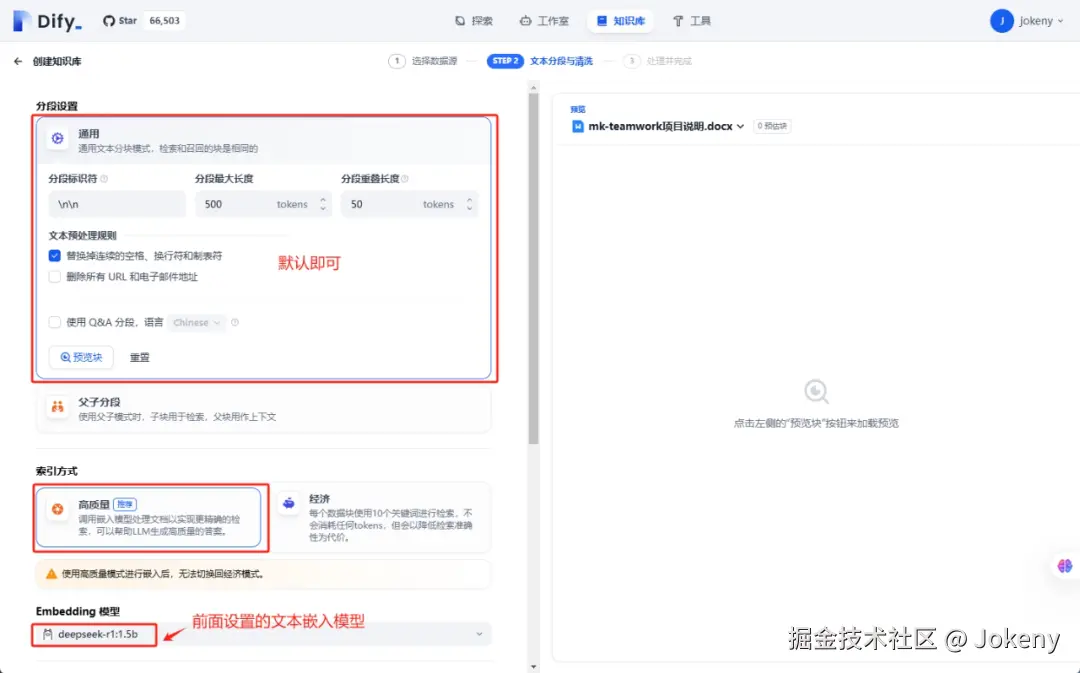
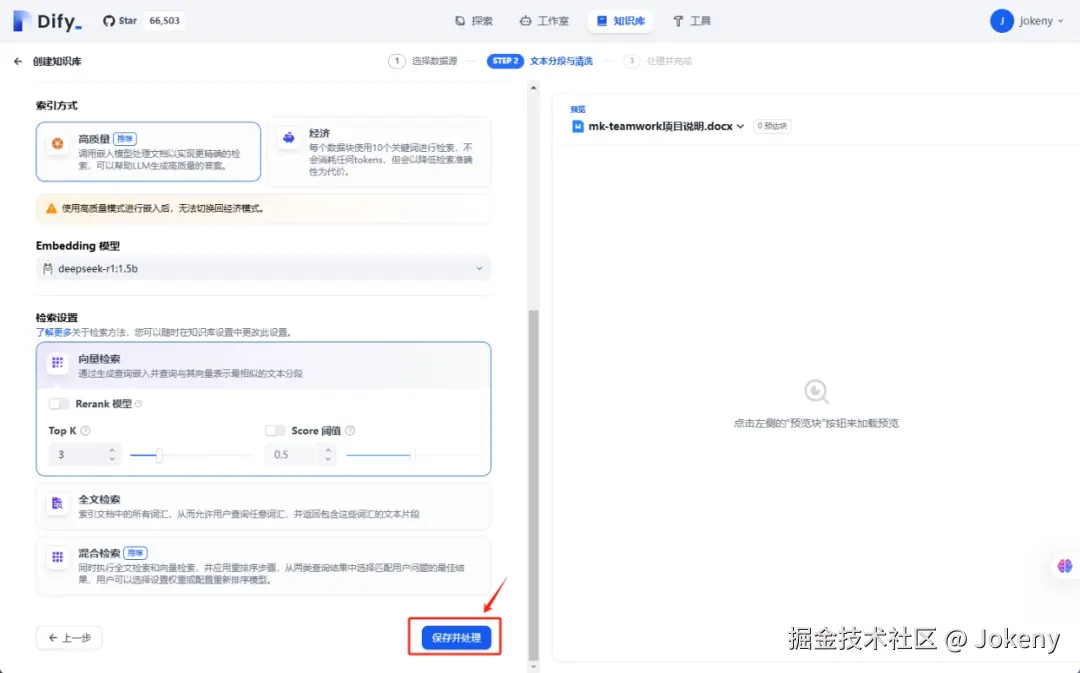
耐心等待,系统会自动对上传的文档进行解析和向量化处理。这个过程可能需要几分钟,具体时间取决于文档的大小和复杂程度。
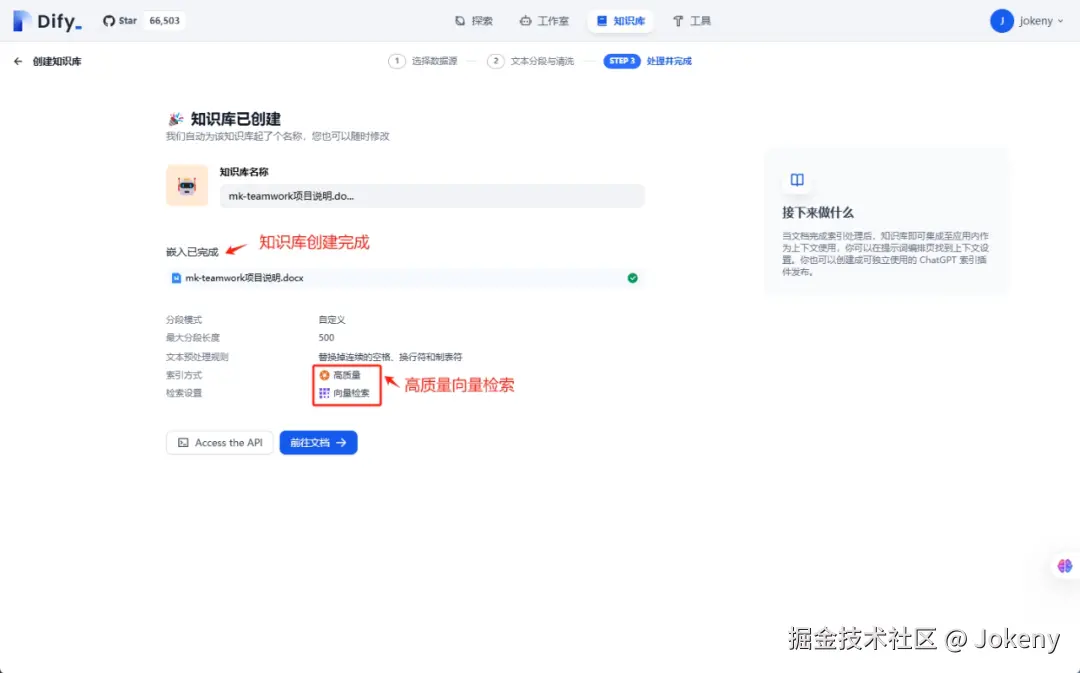
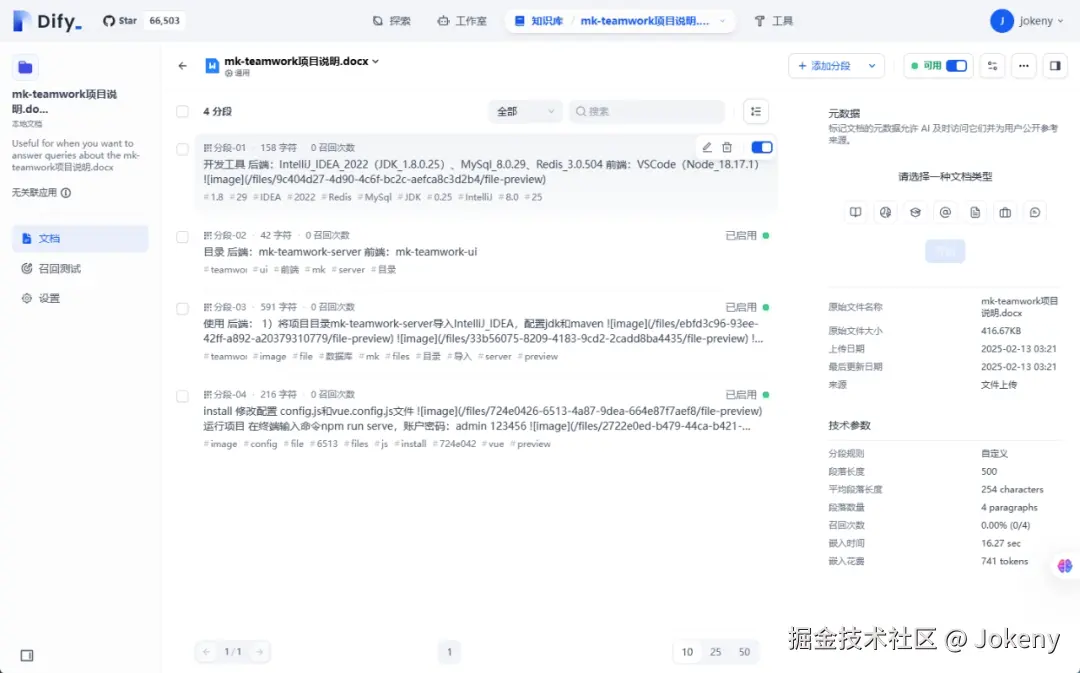
创建成功后我们可以点击【前往文档】按钮,查看分段信息,如下图:
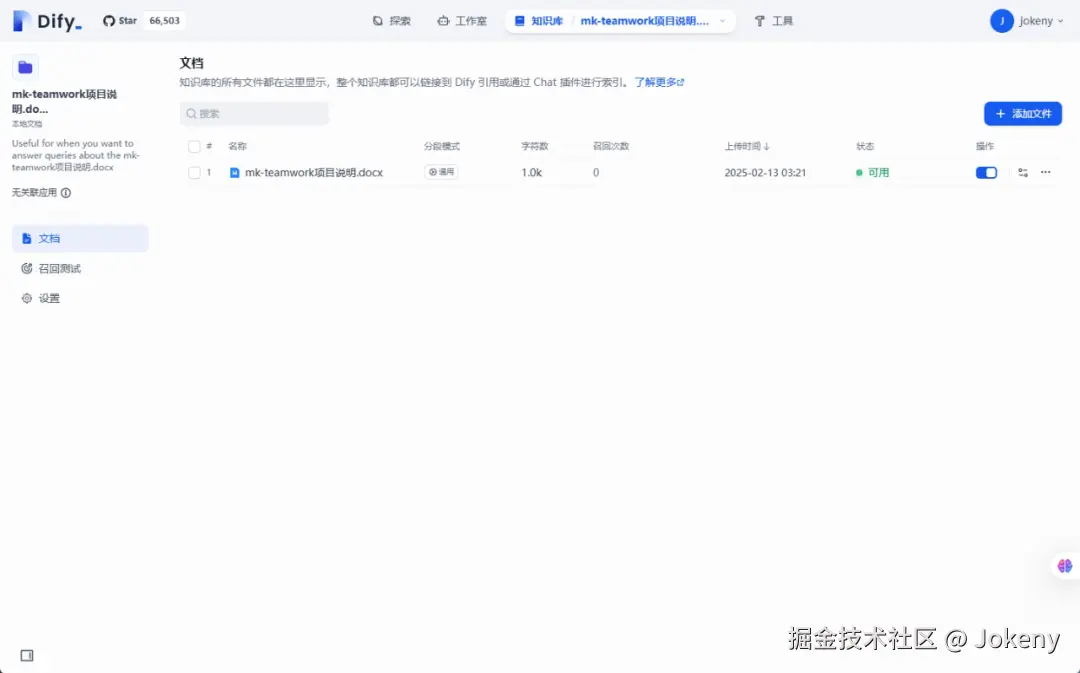
六、添加知识库为对话上下文
1. 应用内添加知识库
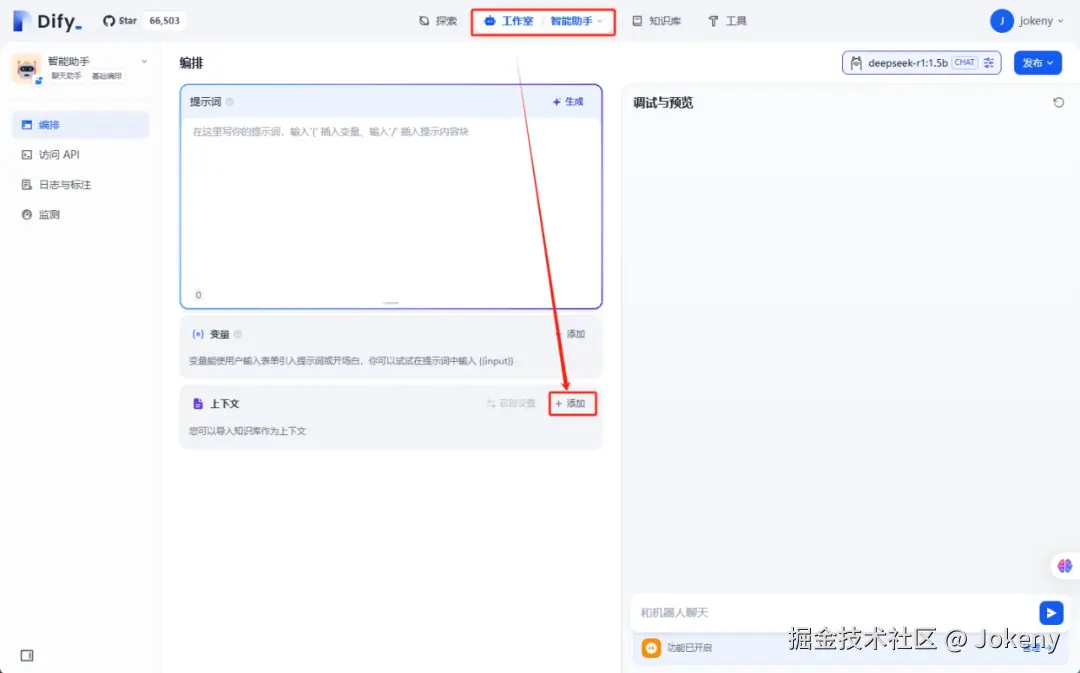
返回 Dify 主界面,回到刚才的应用聊天页面,添加知识库,如下图:
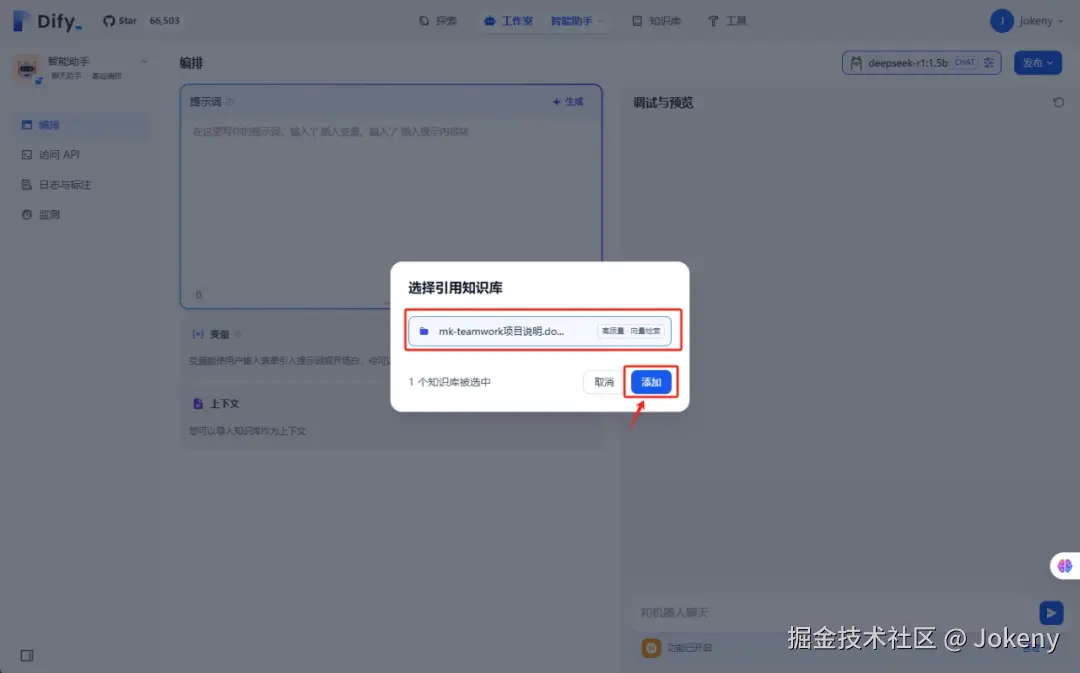
选择刚才创建的知识库作为对话上下文。保存当前应用设置后,就可以测试了。
2. 测试
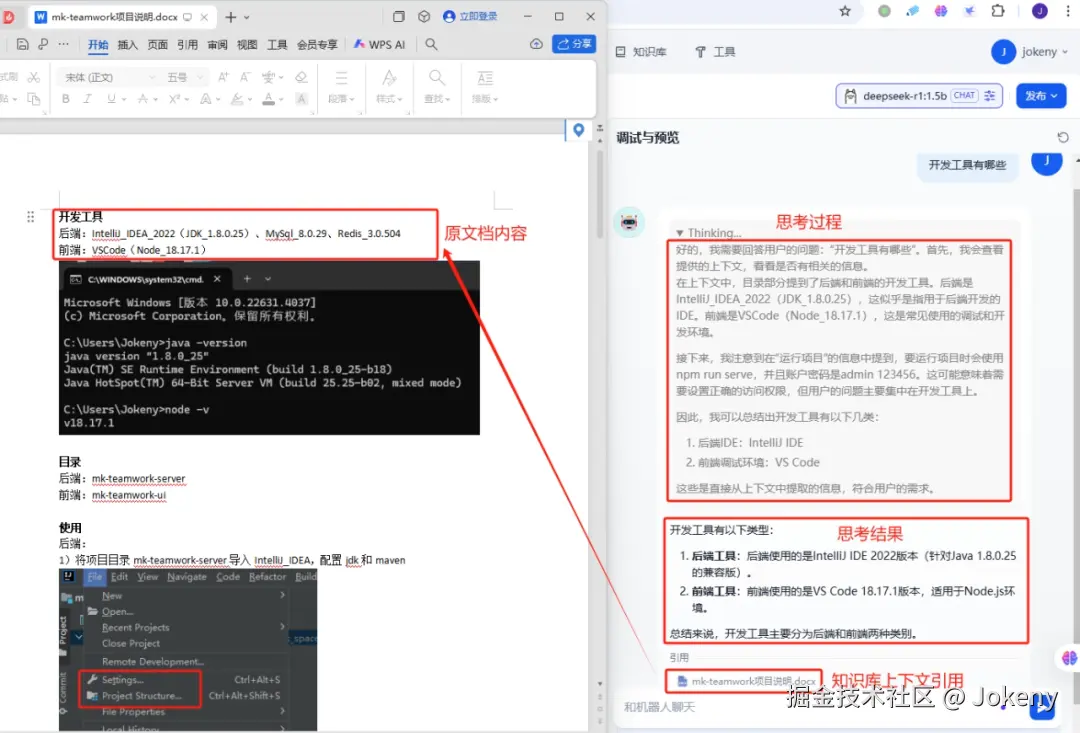
比如,你可以问:“开发工具有哪些”,系统会结合知识库的内容,给出详细的回答,如下图:
如果感觉回答的效果还不满意,可以对召回参数进行调整。
下面以不使用知识库作为上下文为例,对比其回答,如下图:
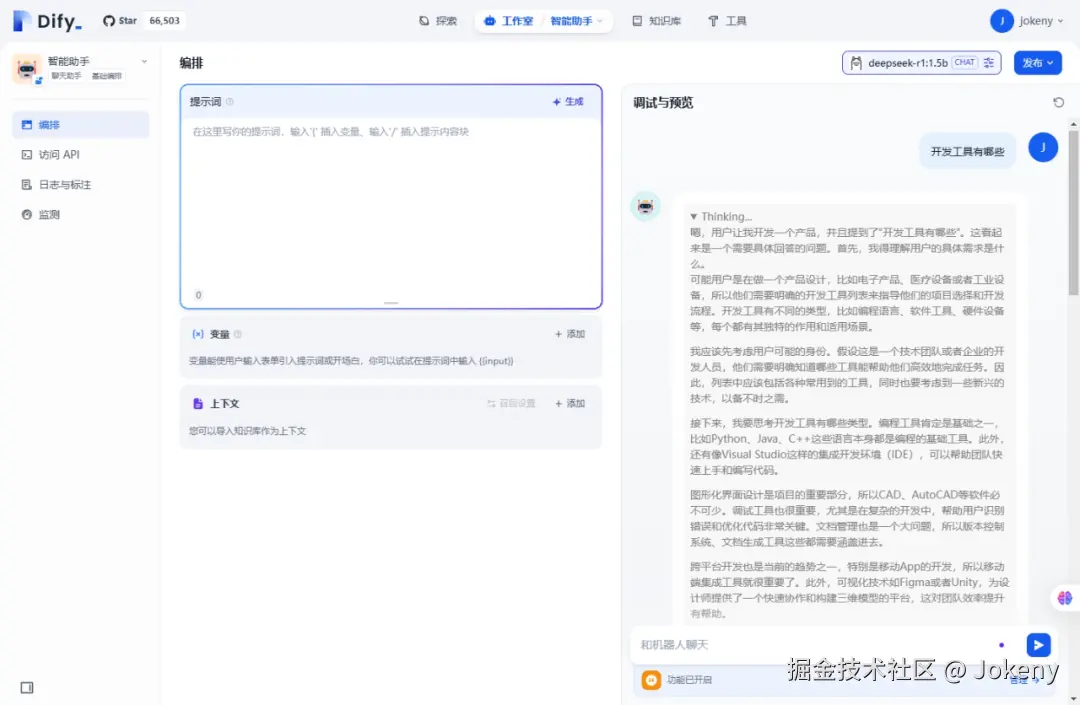
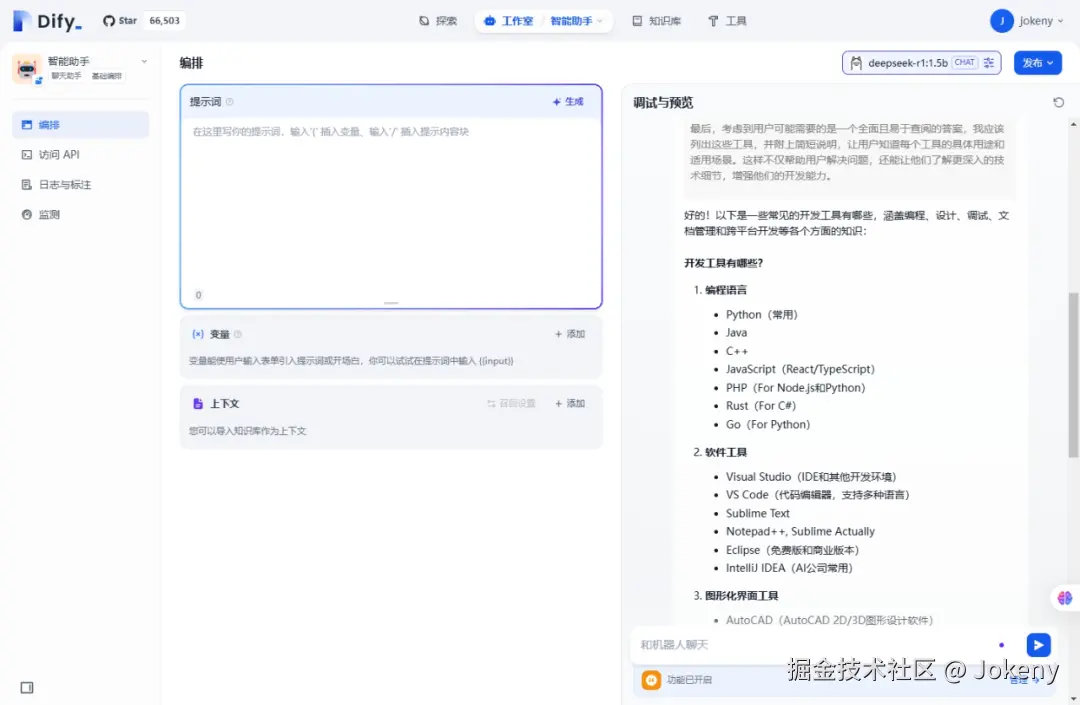
以上得出,DeepSeek的思考过程非常有特点,感觉就像有一个认真负责的人在仔细翻阅文档。它会把自己查找和分析的过程展示得很清楚,最后给出一个严谨的结论。如果你有一个专门的学术知识库,它不仅能帮你查找信息,还能进行推理、思考和总结,使用起来非常方便。
七、实际应用场景
1. 企业内部文档管理
企业可以把内部文档、项目资料等上传到知识库,员工在工作中遇到问题时,直接通过 Dify 提问,系统会基于知识库返回准确答案,大大提升工作效率。比如,一个员工想了解某个项目的进度,直接问:“这个项目目前的进度如何?”系统会从知识库中提取相关信息,给出详细的回答。
2. 智能客服
企业可以将常见问题和解决方案整理成文档,上传到知识库。当客户咨询时,智能客服系统通过 Dify 调用知识库,快速给出答案,提升客户满意度。比如,客户问:“这个产品的保修期是多久?”智能客服系统会从知识库中提取相关信息,给出准确的回答。
3. 个人知识管理
你也可以把自己的个人资料、过往文章、日记等上传到本地知识库,打造自己的私人助理。比如,你想回顾一下过去写的文章,直接问:“我之前写过哪些关于人工智能的文章?”系统会从知识库中提取相关信息,列出文章标题和主要内容。
八、结语
通过 Ollama + DeepSeek + Dify 这个组合,企业可以轻松搭建本地知识库,提升内部信息管理效率。无论是文档检索、问答系统还是自动化工作流,都能轻松搞定。而且,Dify 是完全开源的,遵循 Apache License 2.0 协议,大家可以放心使用。如果你也想提升企业信息管理效率,或者打造自己的私人助理,不妨试试这个组合,绝对能给你带来惊喜!
小伙伴们,赶紧动手试试吧!如果在搭建过程中遇到任何问题,欢迎随时留言交流,我们一起探讨解决方法!
如何零基础入门 / 学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 4128


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


