通过优化html的清洗来提高对网页RAG的效果

在 RAG(检索增强生成)系统中,处理 HTML、CSV、Excel、PDF 等不同格式的数据需要针对性的策略 在 RAG(检索增强生成)系统中,处理 HTML、CSV、Excel、PDF 等不同格式的数据需要针对性的策略,包括解析、清洗、分块等步骤。HTML 包含网页结构、文本、标签、样式等,核心是提取有价值的文本内容并保留语义结构。 阅读详情

html检索的提升:HtmlRAG

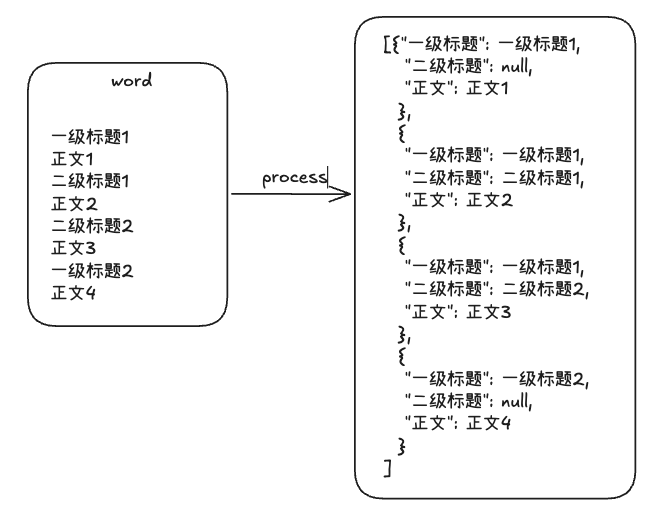
之前在现实的工作场景中也做过很多次RAG,不过那会我的做法大多数是对数据进行结构化,例如做成json或者yaml文件存放进数据库里面。比如我现在有一个Word文档需要处理,那我就会按照一级标题,二级标题,正文这些类别来归类,具体流程可以参照下图:
img

如果遇上文本较长的段落,我会写一个函数来分割整个文本,先将其分成句子级别,然后再将句子重新拼接,超过指定长度就重新拼接一个新的句子,最后再将分割组合完成之后的段落和各级标题再做对应。这种方式就是平时比较常见的文本分块。我这种方式有一种缺点,就是有丢失上下文信息的隐患,不过保持住了结构上的信息。

而今天要讲的这个是关于如何在RAG系统中使用HTML格式的知识,而不是传统的纯文本格式。作者认为HTML格式能够更好地保留结构和语义信息,从而提高生成的质量。这也验证了我之前一直提到过的,结构化数据很重要!这篇论文其实就是在讲怎么清洗html。

论文链接:https://arxiv.org/pdf/2411.02959

论文的核心思想

传统的RAG系统通过结合检索和生成模型,能够显著提高LLM的生成能力和答案质量。但是上下文长度限制和噪音过滤是限制RAG系统的两个问题。这篇论文提出的HtmlRAG方法通过使用HTML格式的知识,目的是保留更多的结构和语义信息,进一步提高RAG系统的性能。
img

  1. \1. HTML vs 纯文本:

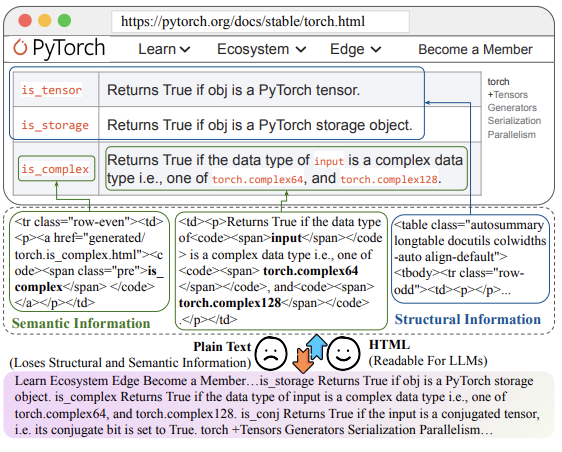
    • • 按照作者来讲,传统的RAG系统通常会将HTML文档转换成纯文本,然后再输入到LLM中。这个过程会丢失HTML中的结构和语义信息,比如标题、表格等。(不过这点我持保留意见,真的要把RAG系统搞好的公司不会直接把html信息暴力硬塞给模型,这样的结果就是会给模型带来干扰信息,初版的代码是一回事,要是后面版本还这样估计测试就能发现问题了。)

    • • 作者在论文里还提出怎么使用HTML格式的知识,因为HTML能够保留这些信息,而且现代的LLM在预训练阶段已经接触过HTML文档,所以它们有能力理解HTML。
      img

  2. \2. HTML的挑战:

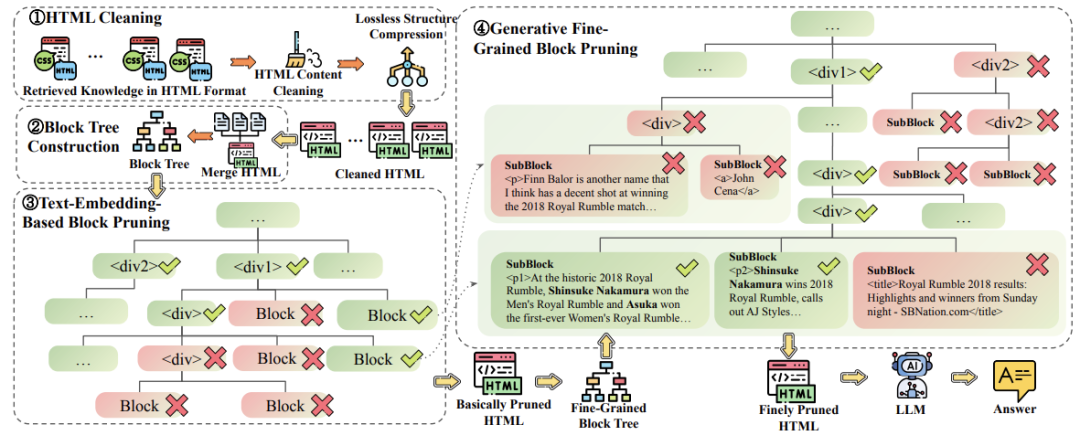
    • • 作者也提到,HTML文档通常包含大量的标签、JavaScript和CSS,这些内容会增加输入的token数量,并且带来噪音。为了解决这个问题,作者提出了HTML清洗、压缩和修剪策略,以减少HTML的长度,同时尽量保留有用的信息。

具体方法就是下面这般:

  1. \1. HTML清洗:

    • 去除CSS、JavaScript和注释。例如清除掉下面这些东西:


<style>
  body { font-family: Arial, sans-serif; }
</style>
<script>
  function example() { alert('Hello!'); }
</script>
<!-- 注释 -->
  1. • 清理冗长的HTML标签属性。例如,将以下内容:

     <div class="example" id="main" style="color: red;">
    
  2. 简化为:

     <div class="example" id="main">
    
  3. • 合并多层嵌套的标签,去除空标签。

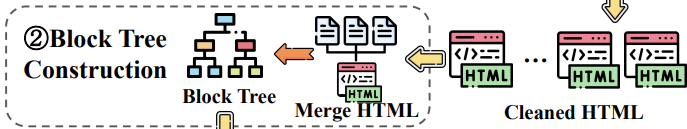
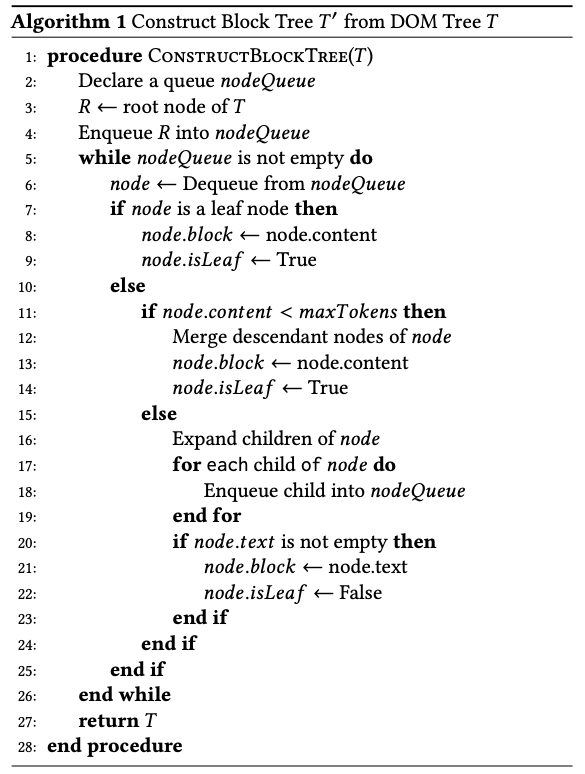
  4. \2. 块树构建:

    img

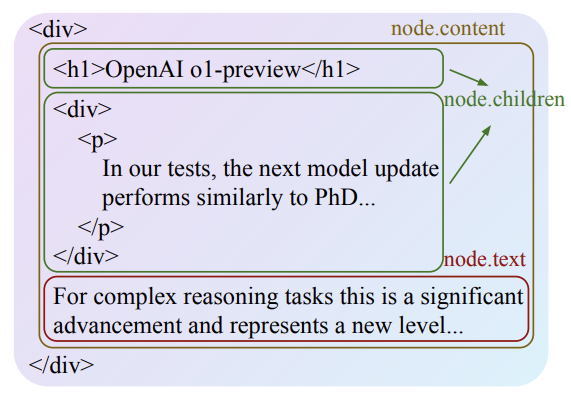
  5. • 将HTML文档通过Beautiful Soup解析成DOM树,然后构建一个块树,这些树包含了许多结构信息。块树的粒度可以调整,以适应不同的修剪需求。

  6. • 块树中的每个块是一个可以修剪的单位,块的大小由最大词数(maxWords)控制。

  7. 假设我们有以下HTML文档:

<!DOCTYPE html>
<html>
<body>
  <div>
    <h1>Title</h1>
    <p>This is a paragraph.</p>
    <p>This is another paragraph.</p>
  </div>
  <div>
    <h2>Subtitle</h2>
    <p>This is a subparagraph.</p>
  </div>
</body>
</html>
  1. 经过块树构建后,块树结构如下:
Block 1: <div><h1>Title</h1><p>This is a paragraph.</p><p>This is another paragraph.</p></div>
Block 2: <div><h2>Subtitle</h2><p>This is a subparagraph.</p></div>
  1. 整体构建流程如下:

    img

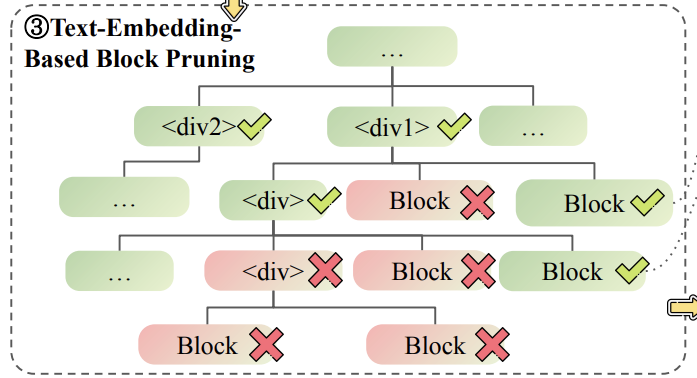
  2. \3. 基于嵌入的块修剪:

    img

  3. • 使用嵌入模型计算每个块与用户查询的相关性得分。

  4. • 贪心算法删除得分低的块,直到HTML文档的长度满足上下文窗口的要求。

  5. 仍然用上面的例子,由于在前面已经做了数据清洗,留下的信息中除了保留文档结构之外,还大大降低了上下文压力,清洗掉了绝大部分噪音。我们有以下的块树:

- Block 1: <div><h1>Title</h1><p>This is a paragraph.</p><p>This is another paragraph.</p></div>
- Block 2: <div><h2>Subtitle</h2><p>This is a subparagraph.</p></div>
  1. 用户查询为“Tell me about the title”。嵌入模型计算得分如下:

    • • Block 1: 0.9
    • • Block 2: 0.3
    • 贪心算法会删除Block 2,因为它的得分较低。
  2. \4. 基于生成模型的细粒度块修剪:

    • • 使用生成模型进一步修剪块树,生成模型能够处理更长的上下文,并且不局限于一次处理一个块。
    • • 生成模型计算每个块的得分,然后使用贪心算法删除得分低的块。
  3. img

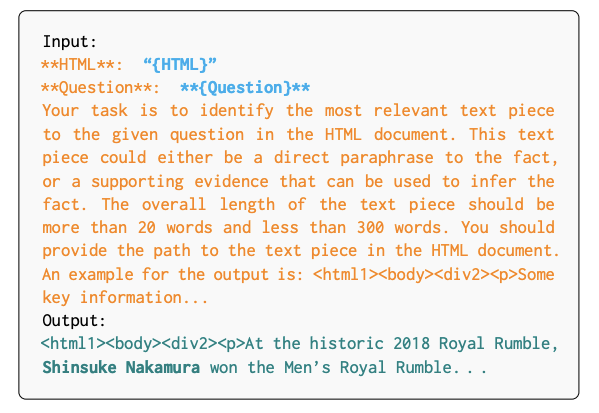
  4. 论文里也给出了这里用生成模型的提示词:

  5. img

实验结果

  • • 作者在六个QA数据集上进行了实验,结果显示使用HTML格式的知识比纯文本格式的知识效果更好。
  • • 他们还进行了消融实验,验证了每个组件(如块树构建、嵌入模型修剪、生成模型修剪)的有效性。

这篇论文提出的方法确实有道理,因为HTML格式能够保留更多的结构和语义信息,这对于理解复杂文档非常有帮助。不过,HTML清洗和修剪的过程可能会比较复杂(毕竟不同的页面有不同的结构是吧),所以需要精细的调整,得到一个通用的清洗过程才能达到最佳效果,这里不需要将所有噪音都精确地清洗掉,这是不现实的。

另外,虽然作者提到现代LLM在预训练阶段已经接触过HTML文档,但不同LLM的能力可能有所不同,所以这个方法的效果可能会因LLM的选择而有所差异。总的来说,这是一个有趣且有潜力的研究方向,值得进一步探索和优化。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

(17-3-02)检索增强生成(RAG):HTML标题文本分割器+CharacterTextSplitter文本分割器 上述代码的目的是使用 LangChain 中的文本分割器来处理一个网页(在这个例子中是斯坦福哲学百科中的哥德尔条目页面),将其内容分割成更小的、易于处理的块,并保留文档结构中的上下文信息。直接分割文本就是在不使用元数据的情况下,直接将文本传递给文本分割器进行分割,例如下面是一个使用CharacterTextSplitter直接分割文本的例子。(3)分割文本:调用 create_documents 方法,传入读取的文本内容 state_of_the_union,分割器会根据设置的参数将其分割成多个文本块。 阅读详情

相关推荐

可视化 RAG 数据 — EDA for Retrieval-Augmented Generation

LLM的推理过程缺乏透明度,使用户难以理解结论是如何得出的。为了应对这些挑战,已经开发了一种称为检索增强生成(RAG)的技术。RAG 向 LLM 的工作流添加了一个检索步骤,使其能够在响应查询时从其他来源(如您的私人文本文档)查询相关数据。

gongdiwudu的专栏 3126

RAG前沿再跟进:HtmlRAG、分块策略、GraphRAG-DRIFT及多样性生成

本文主要讲了4个问题,分别是关于RAG中的分块策略对比回顾、大模型生成策略,在大模型中增加输出多样性、RAG的chunk表示:HTML比纯文本更适合用于RAG系统中建模检索到的知识、GraphRAG微软版本更新0.4.0,引入DRIFT推理,都是围绕RAG来做的,可以对应到建库、召回以及生成等阶段,都是trick。当然,trick固然很多,但我们需要找到对应合适的场景来应用它们,各位可以多思考。

m0_59163425的博客 1259

从RRT到平滑轨迹:机械臂避障规划仿真全流程解析

本文详细解析了机械臂避障规划从RRT算法到平滑轨迹优化的全流程,包括MATLAB实现、碰撞检测工程实践及轨迹平滑优化技巧。通过RRT算法在关节空间的路径搜索与Minimum Jerk/Snap优化,实现机械臂在复杂环境中的高效安全运动,适用于工业自动化与机器人控制领域。

weixin_29051811的博客 294

HtmlRAG开源,RAG系统联网搜索能力起飞

AI大模型作为人工智能领域的重要技术突破,正成为推动各行各业创新和转型的关键力量。抓住AI大模型的风口,掌握AI大模型的知识和技能将变得越来越重要。学习AI大模型是一个系统的过程,需要从基础开始,逐步深入到更高级的技术。这里给大家精心整理了一份全面的AI大模型学习资源,包括:AI大模型全套学习路线图(从入门到实战)、精品AI大模型学习书籍手册、视频教程、实战学习、面试题等,资料免费分享!

star_nwe的博客 1283

因果推断--PSM的原理和应用(二)

上一篇介绍了DID,本文介绍和DID可一起搭配使用的一种因果推断方法PSM。在正式介绍PSM之前,先来简单回顾一下为什么需要因果推断以及如何做因果推断。我们都知道相关非因果,比起相关我们更希望知道两个事件之间的因果关系,有了确切的因果关系,才能知道对A如何操作才能引起B的变化。解决因果推断问题,目前主要有两种框架,Rubin虚拟事实模型和Pearl因果图模型。站在数据分析的角度上,Rubin虚拟事实模型更容易理解,其核心思想是寻找恰当的对照组。

baidu_26137595的博客 1万+

SARscape的DInSAR全流程-以西安市隋大兴唐长安城遗址为例

通过DInSAR对西安市隋大兴唐长安城遗址开展的年度周期性监测,发现成因是地质内部构造断裂带活动所导致的地面产生物理空间上的形变,而地面的沉降与抬升是直接影响城市发展与文化遗产保护最为常见的缓变型不可逆地质灾害。西安市地处汾渭断陷盆地中部,受临潼-长安断裂带影响,导致区域内构造活动较为强烈。由于早年西安市地表水资源匮乏,从上世纪50年代末开始大量开采地下水资源以满足城市人口不断扩张的需求,从而导致地下承压含水层水位急速下降,形成多个局部沉降中心(八里村、西工大、电子城等)。

2301_77687129的博客 5815

15种高级RAG技术:从预检索到生成全面提升RAG效果

随着检索增强生成(RAG)系统的快速发展,它为增强对话式 AI 和其他生成式 AI 应用提供了许多机会。本文的实验和研究突显了先进的 RAG 技术在以下方面的潜力:信息密度检索准确性用户响应质量如果正确实施,这些技术可以为企业带来更高的成本效益,并改善客户体验。但为了跟上快速涌现的最佳实践,软件工程师和数据科学家需要及时、可信赖的资源作为参考。

Python_cocola的博客 1856

Coppelia Sim (v-REP)仿真 机器人3D相机手眼标定与实时视觉追踪 (一)

先把这连个都添加到场景中,然后把kinect的depth相机拖到vision sensor中,把kinect的script也拖到vision sensor中,同时要注意修改深度相机的坐标,及修改script,删掉/rgb部分。由于需要导入到仿真场景中PDF文件不能直接导入,所以需要生成图下文件,使用windows自带的画图工具,生成以厘米为单位的图像格式,大小和标定板的设置大小一直。可以生成需要用的标定板的文件,设置标定板的大小,棋盘格的大小,等相关的参数,之后可以保存PDF文件。设置plane的大小。

hong3731的专栏 1753

15种高级RAG技术:从预检索到生成全面提升RAG效果,收藏这一篇就够了

随着检索增强生成(RAG)系统的快速发展,它为增强对话式 AI 和其他生成式 AI 应用提供了许多机会。本文的实验和研究突显了先进的 RAG 技术在以下方面的潜力:信息密度检索准确性用户响应质量如果正确实施,这些技术可以为企业带来更高的成本效益,并改善客户体验。但为了跟上快速涌现的最佳实践,软件工程师和数据科学家需要及时、可信赖的资源作为参考。

Python_0011的博客 1355

手把手教你用SlowFast训练自定义手势识别数据集(附FFmpeg抽帧技巧)

本文提供了一份基于SlowFast架构训练自定义手势识别数据集的完整实战指南。文章重点剖析了数据准备的核心挑战,详细讲解了利用FFmpeg进行高、低帧率抽帧的技巧,并介绍了构建半自动标注流水线、生成符合SlowFast要求的AVA格式数据集文件的具体方法。最后,针对手势识别场景,给出了关键的模型训练配置与调优建议,帮助开发者高效完成从数据到模型的全流程。

s1t2u3的博客 909

一文介绍Linux EAS

EAS只在系统负载不重时,即系统中每个CPU的利用率都低于其算力的80%时才被启用,而且选出的最节能CPU只有比线程当前运行的CPU节约能量大于6%时,线程才会迁移到该CPU运行。因此EAS为线程选择最节约能量的CPU来运行的前提条件是很苛刻的,针对重载场景(比如游戏),EAS的功能应该很少被使用起来,针对重载场景的功耗优化,这里可能是一个值得尝试的点。算力(capacity)是CPU调度中的一个基础概念,它反映的是一个CPU的计算能力,是个规格化的值,可以通过读取Android手机的文件节点。

youzhangjing_的博客 1234
上一篇: 前瞻&华为云:2024年中国AI大模型场景探索及产业应用调研报告(附下载)
下一篇: RAG效果不好怎么办?试试这八大解决方案(含代码)
冻感糕人~
博客等级 码龄3年 8926粉丝 2384原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值