人工智能基础——模型部分 模型介绍、模型训练和模型微调 !!

从零开始:AI模型训练入门概念 AI模型训练是指通过给定的数据集,让模型自动学习数据中的规律,从而使其具备处理实际问题的能力。训练过程中,模型会不断调整内部参数,以期在输入相似数据时给出正确的输出。 阅读详情

前言

本文将从**什么是模型?什么是模型训练?什么是模型微调?**三个问题,来展开介绍人工智能基础的模型部分。

img

模型族谱


一、什么是模型

模型是一个函数:将现实问题转化为数学问题(Encoder编码器),通过求解数学问题来得到现实世界的解决方案(Decoder解码器)。

img

,这个模型

img

是一个函数,它根据输入数据(可以是文本、图像、语音、视频等)和一组参数

img

(通常表示为权重)来预测输出

img

。这里的输入和权重都是以数学形式(如矩阵或张量)表示的。

**1. 输入数据:**在深度学习中,原始数据(如文字、图片等)需要被转换成模型可以处理的数学形式。这通常意味着将数据编码为数值矩阵或张量。例如,文本可能被转换为词嵌入(word embeddings)或词频矩阵(term-frequency matrices),而图像则可能被转换为像素值矩阵。

**2. 网络结构:**模型

img

的具体形式是由其网络结构决定的。在深度学习中,这通常是一个由多层神经元组成的神经网络。每一层都对输入数据进行某种转换,最终产生一个预测输出。

**3. 参数训练:**模型中的参数

img

是未知的,需要通过训练来确定。训练过程通常涉及优化算法,如梯度下降(gradient descent),用于最小化预测输出与实际标签之间的差异(即损失函数)。

**4. 输出类型:**根据任务的不同,模型的输出可以是多种形式的:

二分类问题:输出为0或1(例如,垃圾邮件检测)。 多分类问题:输出为一系列标签中的一个(例如,图像分类)。 回归问题:输出为一个连续数值(例如,房价预测)。 序列生成:输出为下一个词或字符的概率分布(例如,语言模型)。

**5. 模型应用:**一旦模型被训练好,它就可以用于对新数据进行预测。这些预测可以用于各种实际应用,如推荐系统、自动驾驶、语音识别等。

img

(Model)

神经网络:一种模仿生物神经网络(动物的中枢神经系统,特别是大脑)的结构和功能的数学模型或计算模型,用于对函数进行估计或近似。

  • 单个神经元模型:

**神经元是神经网络的基本单元。**每个神经元接收来自其他神经元的输入信号(或来自外部的数据),对这些信号进行加权求和,并通过一个激活函数来产生输出。

函数公式

img

描述了这一过程,其中

img

是输入信号,

img

是对应的权重,

img

表示对所有输入信号的加权求和,而

img

是激活函数。

img

单个神经元模型

  • 多个神经元模型:

神经网络是由多个神经元相互连接而成的复杂网络。

img

神经网络的每一层都会对其输入进行加权求和并通过激活函数得到输出,这些输出又会作为下一层的输入。

img

多个神经元模型(神经网络)

  • 激活函数:

激活函数是神经网络中非常重要的组成部分,它决定了神经元如何将其输入转换为输出。激活函数为神经网络引入了非线性特性,使其能够学习并逼近复杂的函数。

激活函数的选择取决于具体的应用和模型架构。不同的激活函数有不同的性质和优缺点,需要根据实际情况进行选择。

常见的激活函数包括:

  • Sigmoid函数:将输入映射到0和1之间,常用于二分类问题的输出层。
  • Tanh函数:将输入映射到-1和1之间,类似于Sigmoid但中心化在0。
  • ReLU(Rectified Linear Unit):对于非负输入直接输出该值,对于负输入输出0,是目前深度学习中最常用的激活函数之一。
  • Leaky ReLU:对ReLU的改进,允许负输入有一个小的正斜率。
  • Softmax函数:将多个神经元的输出映射为概率分布,常用于多分类问题的输出层。

img

激活函数

二、什么是模型训练

模型训练:模型训练的本质是一个求解最优化问题的过程。通过不断迭代优化,旨在找到一组最优参数,使得模型对于给定输入的预测输出与真实输出之间的差异最小化,这个差异通常通过损失函数来衡量。

img

  • 目标设定:

确定模型的目标,即希望模型学习到的任务,如分类、回归、聚类等。

根据任务选择或设计适当的损失函数,该函数能够量化模型预测与真实输出之间的差距。

  • 数据准备:

收集并准备数据集,该数据集包含多个输入-输出对(样本),用于训练模型。

数据集通常分为训练集、验证机和测试集,分别用于训练模型、调整超参数和评估模型性能。

  • 模型构建:

选择或设计模型架构,这可以是简单的线性模型、决策树,或是复杂的神经网络。

初始化模型参数,这些参数将在训练过程中被优化。

  • 迭代优化:

通过优化的方式调整模型参数,以最小化训练集上的损失函数。

在每次迭代中,计算损失函数关于模型参数的梯度,并使用优化算法(如梯度下降)更新参数。

通过验证集来监控模型的性能,防止过拟合,并调整超参数以获得更好的性能。

  • 评估与部署:

使用测试集评估训练好的模型的性能,确保其具有良好的泛化能力。

部署模型到生产环境,对新数据进行预测和推理。

img

模型训练

求解最优化问题:通过梯度下降等优化算法,迭代更新模型参数以最小化损失函数,其中反向传播是高效计算神经网络参数梯度的关键方法。

过程涉及定义损失函数、初始化模型参数、选择优化算法、迭代更新参数(通过梯度下降和反向传播)、调整学习率和其他超参数以及评估模型性能等步骤。

  • 定义损失函数:

首先我们需要根据具体任务(分类、回归等)定义一个损失函数,该函数能够量化模型预测与真实标签之间的差异。损失函数的选择取决于问题的性质和数据分布。

img

损失函数

  • 初始化模型参数:

接下来,我们需要初始化模型的参数。这些参数将在训练过程中通过优化算法进行更新,以最小化损失函数。

  • 选择优化算法:梯度下降

为了最小化损失函数,我们需要选择一个优化算法。最常用的优化算法之一是梯度下降(Gradient Descent)及其变种(如随机梯度下降SGD、小批量梯度下降Mini-batch Gradient Descent、Adam等)。

img

梯度下降

迭代更新参数:反向传播计算梯度

使用选定的优化算法,我们开始迭代地更新模型参数。在每次迭代中,我们计算损失函数关于模型参数的梯度,并按照梯度的相反方向更新参数。由于神经网络具有多层嵌套的结构,直接计算损失函数对所有参数的梯度非常困难,计算梯度通常通过反向传播(Backpropagation)来实现。它利用链式法则,从输出层开始逐层计算梯度,并将梯度信息反向传播到输入层。

img

反向传播

  • 调整学习率和其他超参数:

学习率是梯度下降中的一个重要超参数,它决定了参数更新的步长。过大的学习率可能导致训练不稳定,而过小的学习率可能导致收敛速度过慢。因此,需要适当地调整学习率以确保训练的稳定性和收敛速度。此外,还有其他超参数(如批量大小、正则化系数等)也需要进行调整以优化模型性能。

img

学习率

  • 评估模型性能:

在训练过程中或训练结束后,我们需要评估模型的性能。这通常通过使用验证集或测试集来计算模型的准确率、召回率、F1分数等指标来完成。根据评估结果,我们可以对模型进行调整以进一步提高性能。

三、什么是模型微调

**模型微调(Fine-tuning):**通过特定领域数据对预训练模型进行针对性优化,以提升其在特定任务上的性能。

img

模型微调(Fine-tuning)

  • 1. 微调的定义

大模型微调是利用特定领域的数据集对已预训练的大模型进一步训练的过程。它旨在优化模型在特定任务上的性能,使模型能够更好地适应和完成特定领域的任务。

  • 2. 微调的核心原因

**定制化功能:**微调的核心原因是赋予大模型更加定制化的功能。通用大模型虽然强大,但在特定领域可能表现不佳。通过微调,可以使模型更好地适应特定领域的需求和特征。

**领域知识学习:**通过引入特定领域的数据集进行微调,大模型可以学习该邻域的知识和语言模式。这有助于模型在特定任务上取得更好的性能。

  • 3. 微调的方式

**全量微调(Full Fine-Tuning):**全量微调利用特定任务数据调整预训练模型的所有参数,以充分适应新任务。它依赖大规模计算资源,但能有效利用预训练模型的通用特征。

**参数高效微调(Parameter-Efficient Fine-Tuning,PEFT):**PEFT旨在通过最小化微调参数数量和计算复杂度,实现高效的迁移学习。它仅更新模型中的部分参数,显著降低训练时间和成本,适用于计算资源有限的情况。

模型微调流程:在选定相关数据集和预训练模型的基础上,通过设置合适的超参数并对模型进行必要的调整,使用特定任务的数据对模型进行训练以优化其性能。

流程包含以下四个核心步骤:

  • 1. 数据准备:

选择与任务相关的数据集。

对数据进行预处理,包括清洗、分词、编码等。

img

微调开源数据集

  • 2. 选择基础模型:

选择一个预训练好的大语言模型,如LLaMA、ChatGLM、BERT、GPT-3等。

img

支持微调的模型

  • 3. 设置微调参数:

设定学习率、训练轮次(epochs)、批处理大小(batch size)等超参数。

根据需要设定其他超参数,如权重衰减、梯度剪切等。

  • 4. 微调流程:

加载预训练的模型和权重。

根据任务需求对模型进行必要的修改,如更改输出层。

选择合适的损失函数和优化器。

使用选定的数据集进行微调训练,包括前向传播、损失计算、反向传播和权重更新。

img

调的模型*

零基础如何高效学习大模型?

你是否懂 AI,是否具备利用大模型去开发应用能力,是否能够对大模型进行调优,将会是决定自己职业前景的重要参数。

为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和鲁为民博士系统梳理大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️
在这里插入图片描述

【大模型全套视频教程】

教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。

从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。

同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
在这里插入图片描述

深耕 AI 领域技术专家带你快速入门大模型

跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!
图片

【精选AI大模型权威PDF书籍/教程】

精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
在这里插入图片描述

【AI 大模型面试题 】

除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。

【大厂 AI 岗位面经分享(92份)】
图片

【AI 大模型面试真题(102 道)】

图片

【LLMs 面试真题(97 道)】

图片

【640套 AI 大模型行业研究报告】

在这里插入图片描述

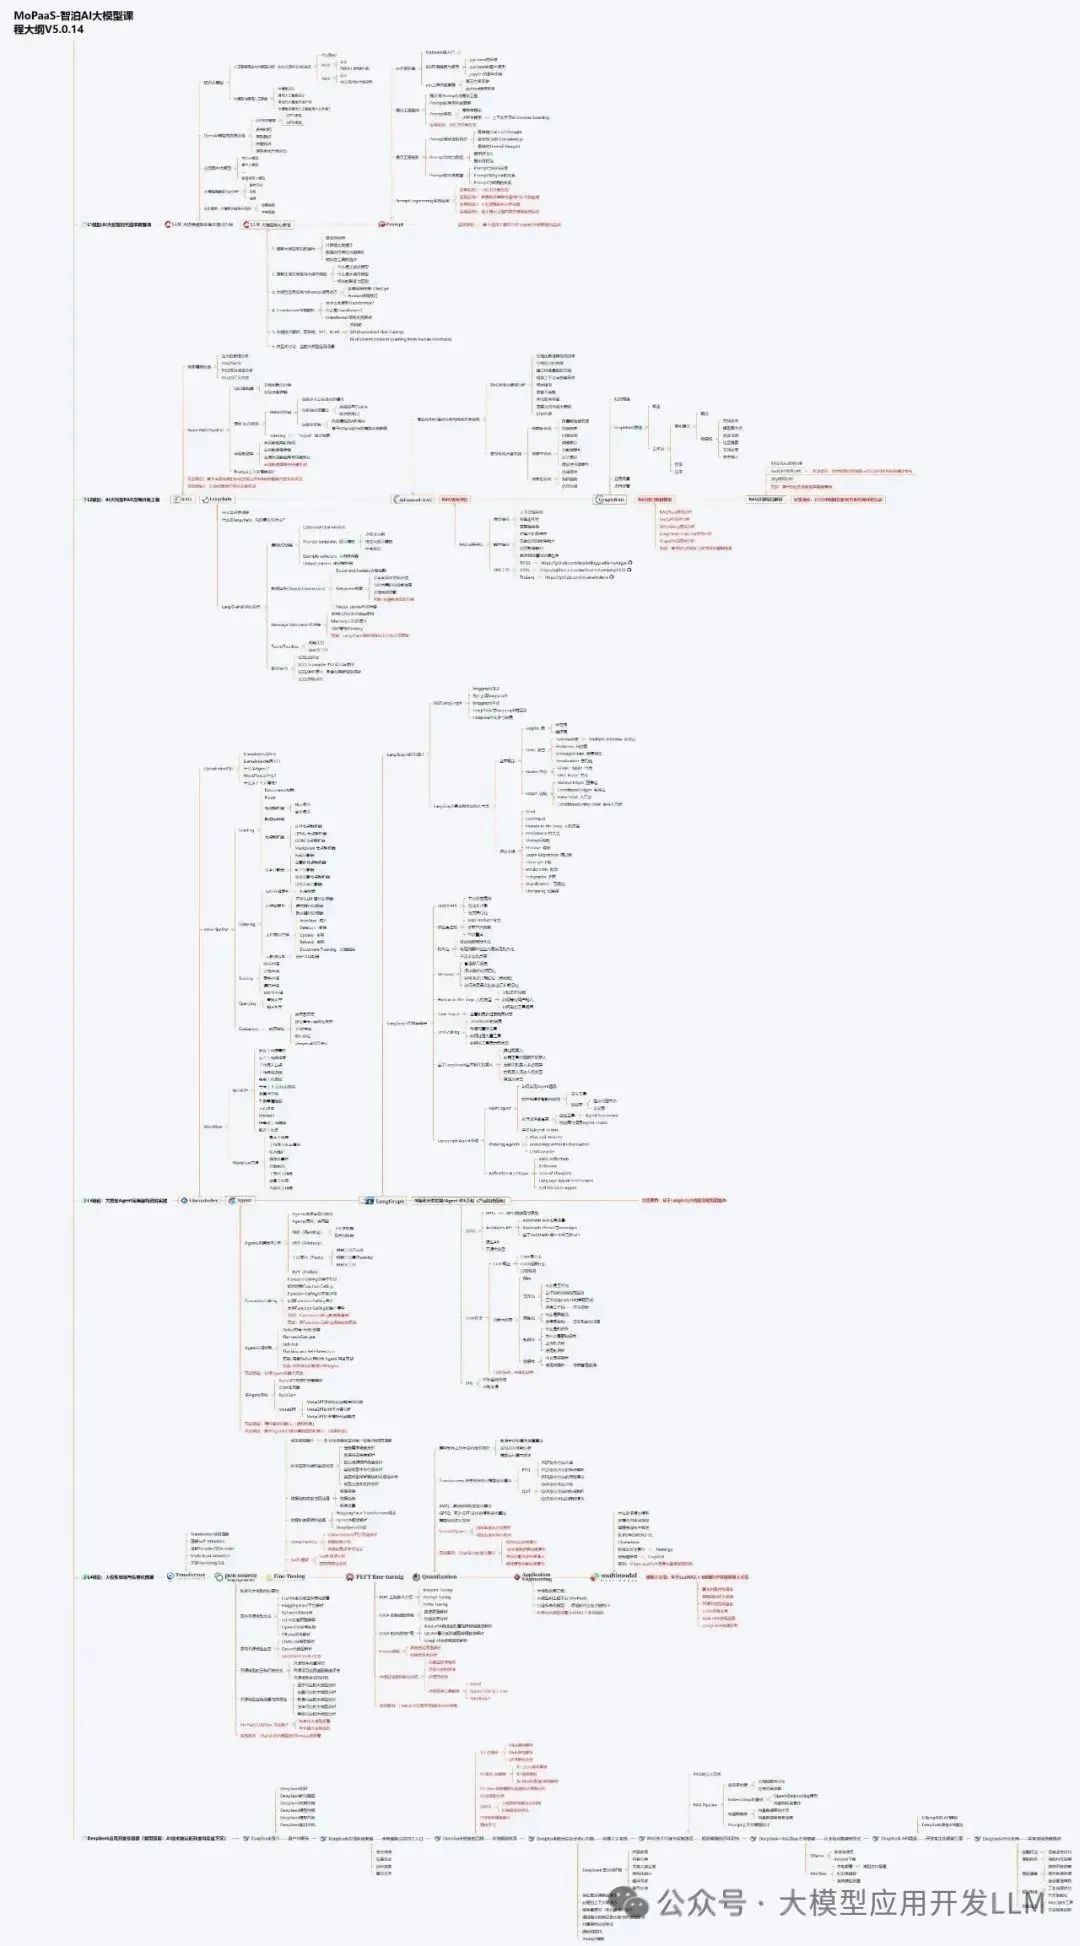
【AI大模型完整版学习路线图(2025版)】

明确学习方向,2025年 AI 要学什么,这一张图就够了!
img

👇👇点击下方卡片链接免费领取全部内容👇👇

在这里插入图片描述

抓住AI浪潮,重塑职业未来!

科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。

行业趋势洞察:

  • 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
  • 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
  • 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。

与其观望,不如行动!

面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
在这里插入图片描述

01 为什么分享这份学习资料?

当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。

因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!

我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。

*02 这份资料的价值在哪里?*

专业背书,系统构建:

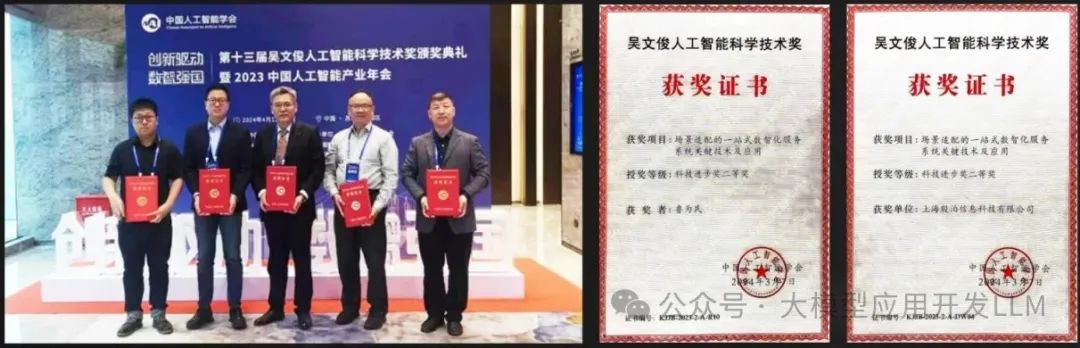
  • 本资料由我与鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:

    • 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
    • 拥有多项中美发明专利。
    • 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
  • 目前,我有幸与鲁博士共同进行人工智能相关研究。

在这里插入图片描述

内容实用,循序渐进:

  • 资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。

  • 包含丰富的视频教程与实战项目案例,强调动手实践能力。

  • 无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
    在这里插入图片描述在这里插入图片描述在这里插入图片描述

抓住机遇,开启你的AI学习之旅!

在这里插入图片描述

人工智能基础——模型部分:模型介绍、模型训练和模型微调 !! 本文将从什么是模型?什么是模型训练?什么是模型微调?三个问题,来展开介绍人工智能基础的模型部分。模型族谱将现实问题转化为数学问题(Encoder编码器),通过求解数学问题来得到现实世界的解决方案(Decoder解码器,这个模型是一个函数,它根据输入数据(可以是文本、图像、语音、视频等)和一组参数(通常表示为权重)来预测输出。这里的输入和权重都是以数学形式(如矩阵或张量)表示的。在深度学习中,原始数据(如文字、图片等)需要被转换成模型可以处理的数学形式。这通常意味着将数据编码为数值矩阵或张量。 阅读详情

相关推荐

详解大模型PPO、DPO的训练过程

AI因你而升温,记得加个星标哦!大家好,我是泰哥。距离上次写技术贴已经1年有余,这一年当中算法技术的发展可以说是日新月异。今天和大家聊聊大模型的训练的三个阶段,分别为有监督学习(SFT)、奖励模型训练(RW)与强化学习(PPO)阶段,我对以上的训练过程会加上一些自己的理解。GPT使用Transformer decoder部分作为语言模型的框架,并将decoder中的Multi-head Attention层删除,其结构和计算过程如上图。

Antai_ZHU的博客 1万+

训练模型的3种方法

公众号后台回复关键字:Pytorch,获取项目github地址。Pytorch没有官方的高阶API。一般通过nn.Module来构建模型并编写自定义训练循环。为了更加方便地训练模型,作者...

Python_Ai_Road的博客 1万+

在Ubuntu 18下安装SIMULIA Abaqus 2020

参考资料: https://github.com/imirzov/Install-Abaqus-2019-on-Ubuntu-18.04-LTS 安装环境: Ubuntu 18.4 LTS 软件版本: SIMULIA for Linux 2020 1 准备 安装光盘及破解文件 解压光盘至一目录,不能挂载,因为要修改文件内容 /home/sunwk/Downloads/abaqus2020 更改文件权限为最大 sudo chmod -R 777 abaqus2020/ * 复制libpng12

oak619的博客 1万+

大模型入门指南 - Training:小白也能看懂的“模型训练”全解析

Training(模型训练)本质是AI世界的‘科学烹饪实验’——以数据为食材原料,用超参数作配方比例,借验证集做品控质检,将‘玄学炼丹’的试错过程,淬炼成‘可复现的精密工程’。今天用最通俗的话,带你拆解模型训练(Training)全过程。

EnjoyEDU的博客 3060

NVIDIA DGX Spark (Ubuntu 24.04) 部署Isaac Sim与Isaac Lab:二进制安装与ROS2集成实战

本文详细介绍了在NVIDIA DGX Spark工作站(Ubuntu 24.04系统)上,通过预编译二进制包稳定部署Isaac Sim与Isaac Lab的完整实战流程。文章重点剖析了二进制安装相较于源码编译和pip安装的优势,有效规避了CUDA、PyTorch等关键组件的版本冲突陷阱,并逐步指导完成环境配置、Isaac Lab集成、Conda环境管理以及ROS2 Jazzy的集成,最终构建出完整的机器人仿真与强化学习开发平台。

kite3的博客 397

基于Simulink的直流电机双闭环调速系统抗扰动仿真与参数优化

本文详细介绍了基于Simulink的直流电机双闭环调速系统仿真与参数优化方法。通过构建转速外环与电流内环的仿真模型,阐述了利用工程设计法整定PI参数的核心步骤,并重点探讨了如何优化系统参数以增强其抗负载突变等扰动的能力,实现快速、平稳的调速性能。

weixin_29061997的博客 195

人工智能基础大模型部分:模型介绍、模型训练和模型微调 !!

本文将从什么是模型?什么是模型训练?什么是模型微调?三个问题,来展开介绍人工智能基础的模型部分。前排提示,文末有大模型AGI-优快云独家资料包哦!模型族谱模型是一个函数:将现实问题转化为数学问题(Encoder编码器),通过求解数学问题来得到现实世界的解决方案(Decoder解码器)。,这个模型是一个函数,它根据输入数据(可以是文本、图像、语音、视频等)和一组参数(通常表示为权重)来预测输出。这里的输入和权重都是以数学形式(如矩阵或张量)表示的。

xzp740813的博客 1808

一文读懂医疗大模型测评基准

面对市场上浩若星海的大模型,医院管理者如何采购适合自身场景的解决方案?如何选取好的模型作为基础进行课题研究?都是医院需要特别重视的问题。评测基准则benchmark是这些问题的重要解法,国内北京、上海、浙江已然开展了相关的标准化工作。

dz102的博客 1849

AI大模型微调之基础篇:模型微调概念以及微调框架,零基础小白收藏这一篇就够了!!

什么是模型微调? 定义:在预训练大模型(如GPT、BERT)的基础上,使用特定领域或任务的数据进行额外训练,使模型适应新任务。 类比:类似“博士生在通识教育(预训练)后,专攻某个研究方向(微调)”。

2401_85325557的博客 949

智能汽车竞赛摄像头处理(4)——摄像头循迹思路讲解

智能汽车竞赛摄像头处理(4)对摄像头循迹思路进行讲解。

weixin_62261692的博客 7063

MoveIt 运动学、运动规划、混合规划、move_group

混合规划是运动规划方法的一个术语,它将异构运动规划器结合起来,以产生更稳健或反应更快的解决方案。这种通用方法在导航领域已经非常成熟,并在导航2等流行项目中成功实施。MoveIt 的混合规划架构结合了一对全局规划器和局部规划器,它们以不同的规划速度和问题范围并行、并发运行。全局规划器的任务是解决全局运动规划问题,这与 “感知-规划-行动 ”应用中使用的规划器非常相似。所使用的规划器算法应该是完整的,因此假定其计算时间相对较慢。此外,全局规划器不要求实时安全,这意味着无法保证规划器在特定期限内找到解决方案。

机器人控制与仿真应用 2134

AI大模型如何“练成”?详解训练、微调与强化学习的基础逻辑,建议收藏!!

我们或多或少都听说LLM大模型是先“训练”出来,然后再用于“推理”,那怎么理解这个“训练”过程? 是不是经常听说行业性场景中要使用垂域大模型,比通用大模型效果会更好,然后都说垂域大模型是“微调”出来的,那么什么是“微调”?和上面说的“训练”是什么关系? 当你尝试去深入了解这些问题时,搜到的各种介绍是不是都有点深奥?看到预训练、后训练、监督微调、强化学习、低秩适应、奖励模型等一堆概念是不是有点懵逼?

Gaga246的博客 929

提示libfakeroot.so或libfakeroot-sysv.so出错处理方法

嵌入式Linux、Buildroot交叉编译出现fakeroot问题处理方法。

阿xin*的嵌入式AI 1447

【AI大模型】一文搞懂模型微调Fine-tuning,适合零基础小白收藏!!

本文将从微调的本质、微调的原理、微调的应用三个方面,带您一文搞懂模型微调 Fine-tuning 。Fine-tuning模型微调一、微调的本质**如何利用预训练模型?**两种流行方法是迁移学习和微调。迁移学习是一个更广泛的概念,它包括了多种利用预训练模型的方法,而微调是迁移学习中的一种具体实现方式。迁移学习和微调**迁移学习(Transfer Learning):**使用在大型数据集上预训练的模型作为起点,然后将其应用于新的、相关但可能较小或特定领域的数据集。Transfer Learning 迁移学习微

jennycisp的博客 775

新能源汽车整车控制器(VCU)深度全解:硬件原理、工作流程、接口设计与高压安全实战

整车控制器(VCU,Vehicle Control Unit)是新能源纯电动、混动汽车的核心决策大脑,相当于汽车的“中枢神经系统”。它不直接驱动电机,却统筹电机控制器(MCU)、电池管理系统(BMS)、充电机(OBC)、DC/DC、空调、热管理、底盘等全部部件,负责驾驶意图解析、动力输出控制、高压上下电管理、故障安全保护、能量优化等关键任务。VCU所有设计均围绕车规级环境适应性、功能安全(ISO 26262)、实时性、高压安全性四大核心目标,与通用控制器完全不同。

优快云-新能源汽车研发测试专业博主 2494

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

【AI大模型教程】微调之后还能做什么?看完这篇你就懂了!!收藏就对了!!

后训练(Post-Training)是指在预训练模型的基础上,针对特定的任务或数据集进行额外的训练。这个阶段通常涉及到微调(Fine-tuning)和对齐 (Alignment),即调整预训练模型的参数以适应新的任务。

2401_85325557的博客 804

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

AI大模型如何“练成”?一文详解训练、微调与强化学习的基础逻辑,建议收藏!!

我们或多或少都听说LLM大模型是先“训练”出来,然后再用于“推理”,那怎么理解这个“训练”过程? 是不是经常听说行业性场景中要使用垂域大模型,比通用大模型效果会更好,然后都说垂域大模型是“微调”出来的,那么什么是“微调”?和上面说的“训练”是什么关系? 当你尝试去深入了解这些问题时,搜到的各种介绍是不是都有点深奥?看到预训练、后训练、监督微调、强化学习、低秩适应、奖励模型等一堆概念是不是有点懵逼?

嘴巴吃糖了 816

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

一文讲清!预训练与微调,为什么需要预训练,什么是微调?零基础小白收藏这一篇就够了!!

大模型训练需先预训练获得通用能力,再通过微调强化特定能力。预训练通过大规模数据学习通用特征,可采用监督或无监督学习;微调则是对特定任务进行强化训练,使模型更"过拟合"。预训练好处包括加速训练、提高性能、解决数据不足、支持迁移学习和提高泛化能力。预训练是微调的前提,两者都无法突破模型架构的限制。

2401_85325557的博客 593

聊聊大模型微调训练全流程的思考

对于模型的微调,一开始我是想的太简单了,觉得只要按照基座官方模型文档调试即可;随着了解的深入与不断的学习,微调是个大工程而且对于领域模型来说,其训练流程:预训练 --> 监督微调 --> RHLF 中包含的事项与知识太多。

ytt0523_com的博客 959

一文说清楚什么是预训练(Pre-Training)、微调(Fine-Tuning),零基础小白建议收藏!!

预训练和微调是现代AI模型的核心技术,通过两者的结合,机器能够在处理复杂任务时表现得更为高效和精准。 预训练为模型提供了广泛的语言能力,而微调则确保了模型能够根据特定任务进行细化和优化。 近年来,人工智能(AI)在各个领域的突破性进展,尤其是在自然语言处理(NLP)方面,引起了广泛关注。 两项重要的技术方法——预训练和微调,成为了AI模型发展的基石。

2401_85325397的博客 1036

转行AI必学:Transformer架构+大模型微调,到底怎么工作的?(人话版)建议收藏!!

目前主流的微调方式就是LoRA低秩矩阵微调,训练速度非常快,节省资源,但训练结果很多时候是不稳定的,有一定玄学在里面,因为微调过程也是依赖模型的反向更新,有时候没有更新到相关知识点,就会导致出现模型幻觉,需要多次尝试,这个过程被趣称为:炼丹~

Gaga246的博客 708

【AI大模型】一文讲清是选择 Prompt 优化还是模型微调,零基础小白收藏这一篇就够了!!

在人工智能飞速发展的当下,大语言模型(LLM)已成为众多领域的关键技术支撑。无论是在智能客服、内容创作,还是数据分析等场景中,LLM 都展现出了强大的能力。但在实际应用中,如何让 LLM 更好地满足特定需求,成为了开发者和企业面临的重要问题。Prompt 优化和模型微调作为提升 LLM 性能的两种主要方式,各有优劣,选择合适的方法对于实现高效、精准的 AI 应用至关重要。

Android23333的博客 1111
上一篇: Spring Boot 3.x +MCP+ Ollama本地大模型实战:从零搭建支持工具调用的AI应用
下一篇: 0代码,教你三步搭建AI Agent
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值