


入门最好的方式是实操,这篇文章一共耗时 7 个小时,用大白话和实操的角度给大家分享一下, 0 基础入门微调大模型
 今天阿里开源了 QwQ-32B 推理模型,320 亿参数和 DeepSeek 6710亿参数几乎相同的效果,部署成本和微调成本越来越低,所以,在做应用开发的同时,掌握微调的技能也很重要。
这个文章,用大白话,面向纯小白,一步一步可实操,带你从 0 到1使用云算力(不受本地电脑配置限制)微调大模型。
学习目标:使用云算力、使用一站式微调框unsloth、下载部署Llama3模型、使用甄嬛剧本微调模型——Ai 甄嬛、了解微调的意义和概念
主要包含:
理论部分:
1、大白话讲讲什么是微调?
实操部分:
1、租用算力
2、安装依赖
3、下载训练数据集
4、加载 Llama3 模型
5、微调训练
6、保存并使用微调后的模型
理论部分
1、什么是微调
微调相当于是可以使用自己的私有数据,私人定制一个专属大模型,比如法律领域、医疗领域、政务场景等。
可以自定义模型回复的语气,个性和风格,你把大模型想象成一个小孩子,你想让他成为什么样,你就教他什么(训练语料数据集)。
"
官话:微调LLM可定制其行为,增强领域知识,并针对特定任务优化性能。通过在特定数据集上微调预训练模型,旨在更有效地执行特定任务。
实操部分
一、租用算力
云算力地址:https://www.autodl.com
第一步:打开网站——控制台——容器实例——租用新实例
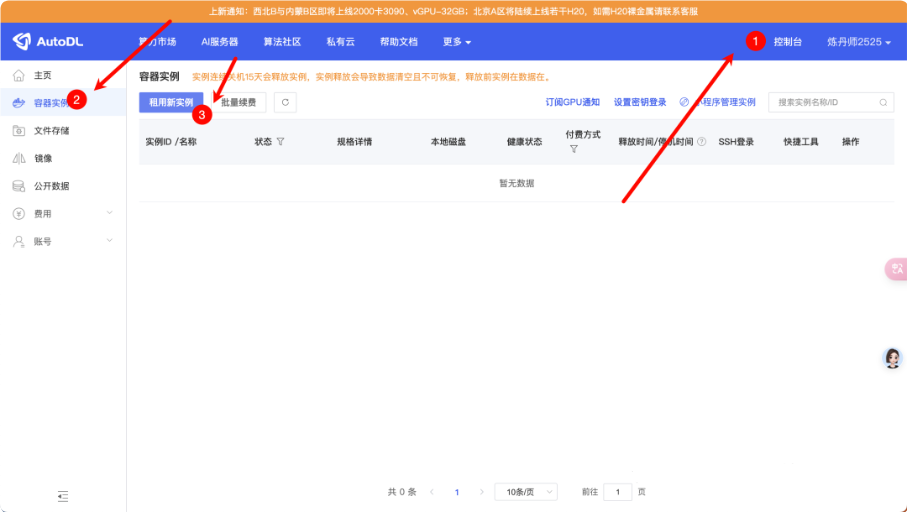
image.png
第二步:
分别选择: 1、按量计费 2、地区和 GPU 选择一个 ,4090显卡,有资源的即可(空闲 GPU>0 的) 3、磁盘选择不扩容(50G 即可) 4、镜像:选择CUDA 12.4 和 PyTorch 2.5*
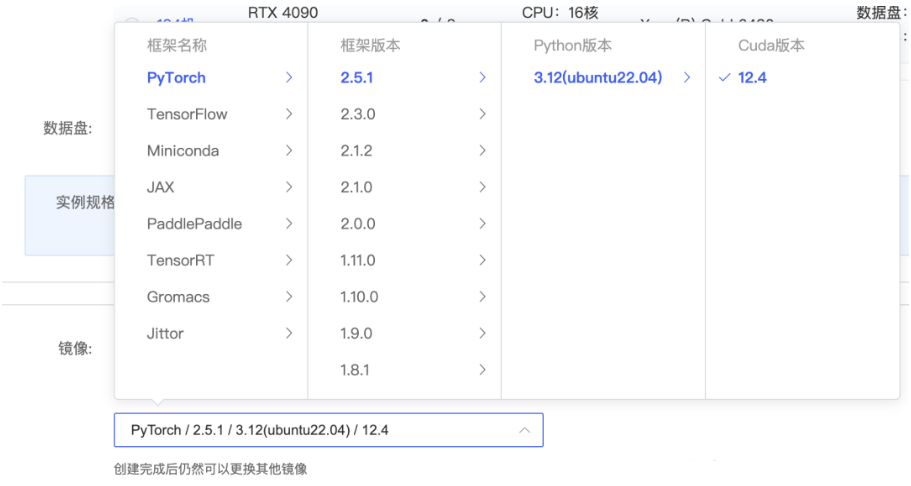
image.png
创建好了之后会进行跳转
点击jupyter进入开发界面
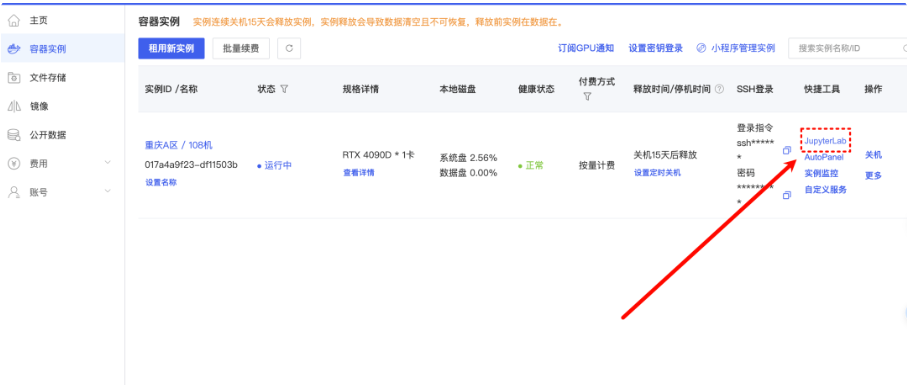
进入到下面的页面,就可以用云算力了。
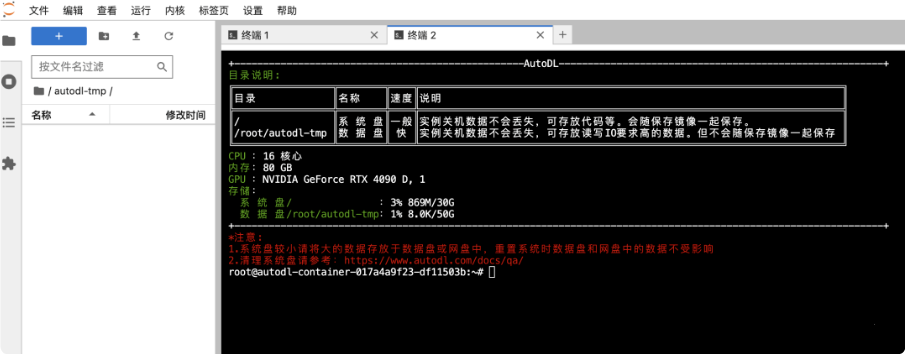
image.png
二、下载大模型
在终端命令行中执行以下代码:
1、安装unsloth微调框架
pip install "unsloth[cu124-torch250] @ git+https://github.com/unslothai/unsloth.git"
2、安装依赖 在命令行终端,执行命令如下:
pip install --upgrade pip
pip install modelscope
3.下载训练数据集
左边侧边栏,右键新建记事本,复制图片下方的代码,执行一下。
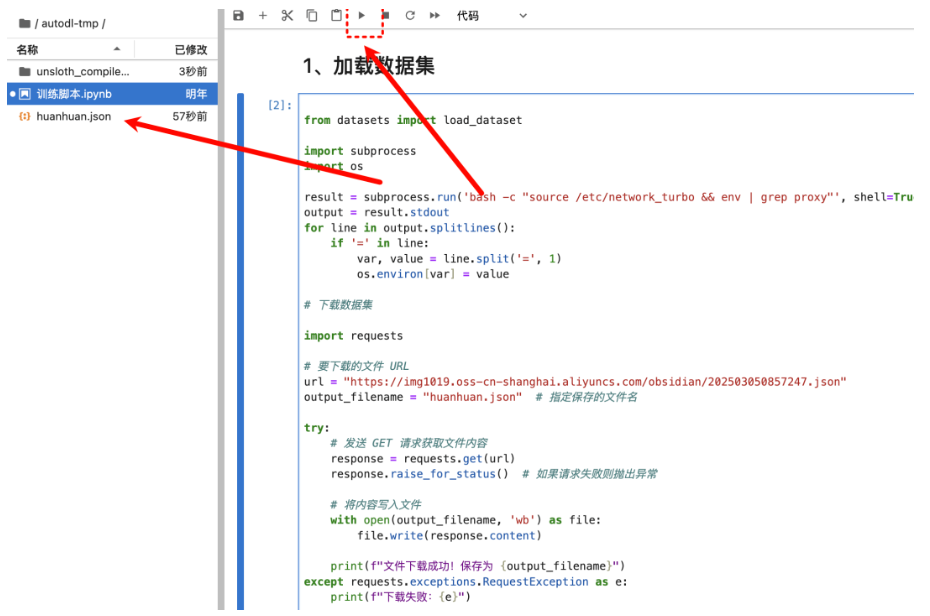
image.png
加载数据集:
from datasets import load_dataset

import subprocess
import os

result = subprocess.run('bash -c "source /etc/network_turbo && env | grep proxy"', shell=True, capture_output=True, text=True)
output = result.stdout
for line in output.splitlines():
    if'='in line:
        var, value = line.split('=', 1)
        os.environ[var] = value

# 下载数据集

import requests

# 要下载的文件 URL
url = "https://img1019.oss-cn-shanghai.aliyuncs.com/obsidian/202503050857247.json"
output_filename = "huanhuan.json"# 指定保存的文件名

try:
    # 发送 GET 请求获取文件内容
    response = requests.get(url)
    response.raise_for_status()  # 如果请求失败则抛出异常

    # 将内容写入文件
    with open(output_filename, 'wb') as file:
        file.write(response.content)

    print(f"文件下载成功!保存为 {output_filename}")
except requests.exceptions.RequestException as e:
    print(f"下载失败:{e}")

# 加载  数据集
dataset = load_dataset("json", data_files={"train": "./huanhuan.json"}, split="train")
4、然后下载完整的模型库
执行图片下方的代码
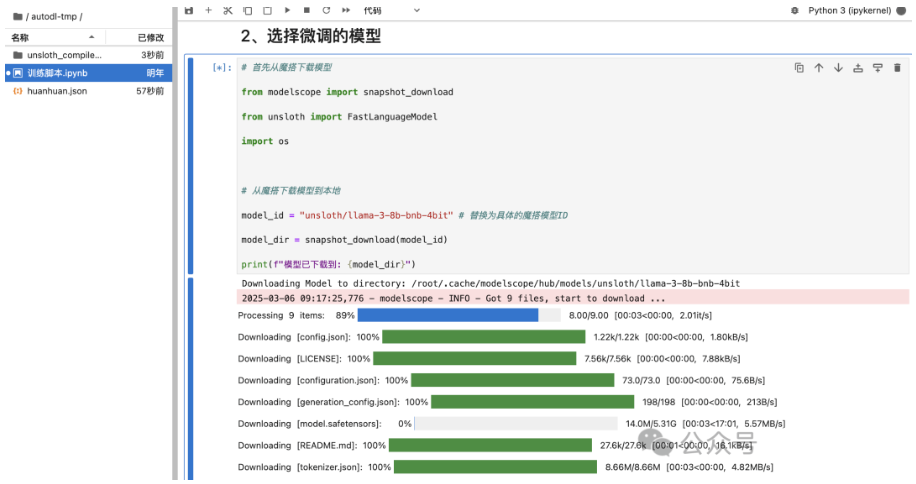
image.png
代码如下:
# 首先从魔搭下载模型

from modelscope import snapshot_download

from unsloth import FastLanguageModel

import os

# 从魔搭下载模型到本地

model_id = "unsloth/llama-3-8b-bnb-4bit"# 替换为具体的魔搭模型ID

model_dir = snapshot_download(model_id)

print(f"模型已下载到: {model_dir}")
大约需要 5-10 分钟
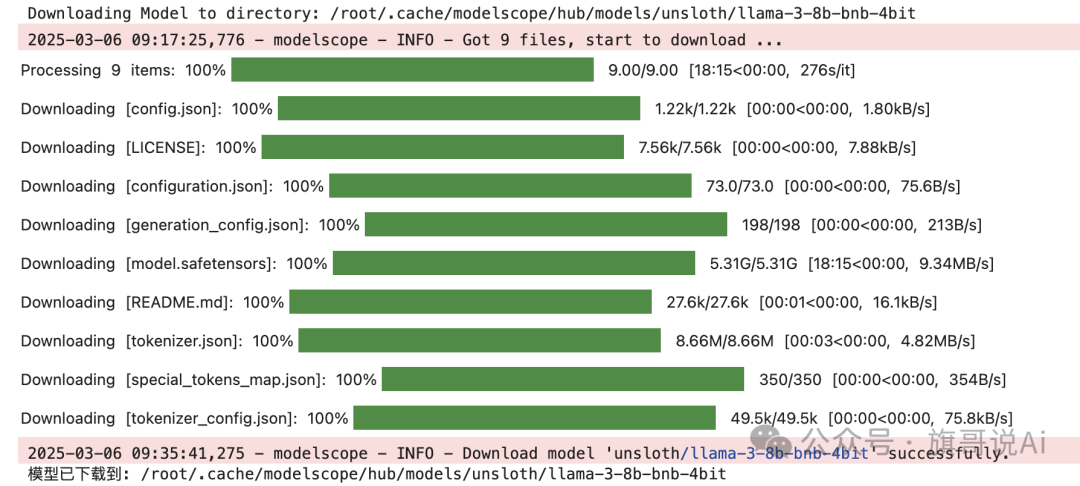 image.png
这几个都下载完成,就可以下一步了~
在代码文件中,新增代码块,一步一步执行下去就行了。
三、训练模型
1、加载模型
代码如下:
# 加载模型

load_in_4bit=True

# 然后使用Unsloth加载本地模型

model, tokenizer = FastLanguageModel.from_pretrained(

model_name=model_dir, # 使用下载到本地的模型路径

max_seq_length=2048, # 设置最大序列长度

load_in_4bit=True, # 使用4位量化以节省显存

dtype=None

)
2、配置微调参数
model = FastLanguageModel.get_peft_model(
    model,
    r=16,  # LoRA 的秩
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    lora_alpha=16,  # LoRA 的缩放因子
    lora_dropout=0,  # LoRA 的 dropout 概率
    bias="none",  # 是否使用偏置
    use_gradient_checkpointing="unsloth",  # 使用 Unsloth 的梯度检查点技术
    random_state = 3407,
    use_rslora = False,  # We support rank stabilized LoRA
    loftq_config = None, # And LoftQ
)
3、数据处理
alpaca_prompt = """Below is an instruction that describes a task, paired with an input that provides further context. Write a response that appropriately completes the request.

### Instruction:
{}

### Input:
{}

### Response:
{}"""

EOS_TOKEN = tokenizer.eos_token # Must add EOS_TOKEN
def formatting_prompts_func(examples):
    instructions = examples["instruction"]
    inputs       = examples["input"]
    outputs      = examples["output"]
    texts = []
    for instruction, input, output in zip(instructions, inputs, outputs):
        # Must add EOS_TOKEN, otherwise your generation will go on forever!
        text = alpaca_prompt.format(instruction, input, output) + EOS_TOKEN
        texts.append(text)
    return { "text" : texts, }
pass

dataset = dataset.map(formatting_prompts_func, batched = True,)
4、训练
from trl import SFTTrainer
from transformers import TrainingArguments
from unsloth import is_bfloat16_supported

# 创建微调训练器
trainer = SFTTrainer(
    model = model,
    tokenizer = tokenizer,
    train_dataset = dataset,
    dataset_text_field = "text",
    max_seq_length = 2048,
    dataset_num_proc = 2,
    packing = False, # Can make training 5x faster for short sequences.
    args = TrainingArguments(
        per_device_train_batch_size = 2,
        gradient_accumulation_steps = 4,
        warmup_steps = 5,
        max_steps = 160,
        learning_rate = 1e-4,
        fp16 = not is_bfloat16_supported(),
        bf16 = is_bfloat16_supported(),
        logging_steps = 10,
        optim = "adamw_8bit",
        weight_decay = 0.01,
        lr_scheduler_type = "linear",
        seed = 3407,
        output_dir = "outputs",
    ),
)

# 开始训练
trainer_stats = trainer.train()
看到下面的样子就是成功了~
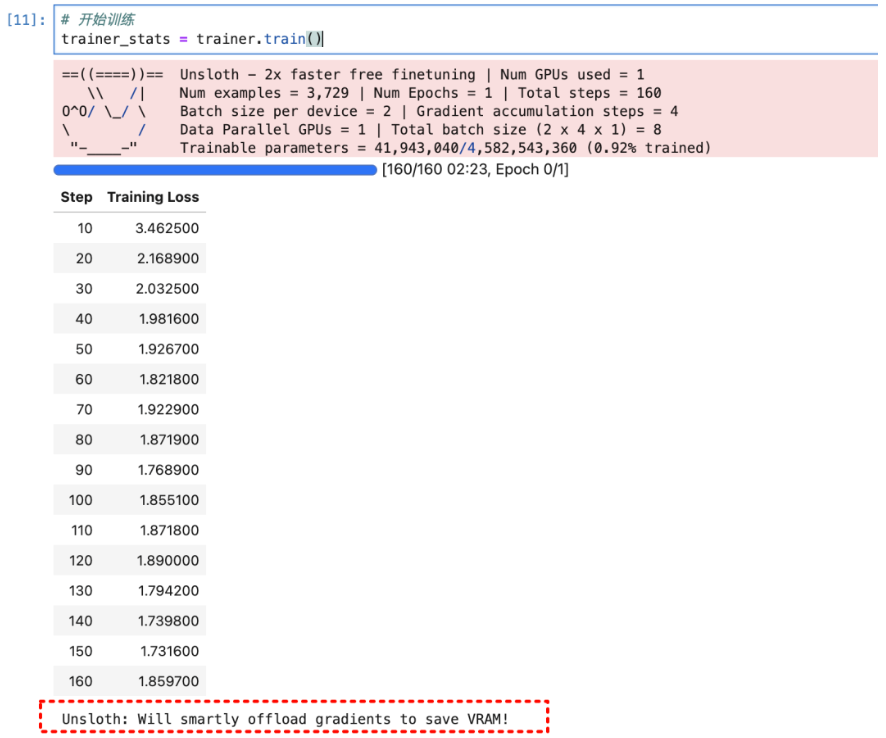
image.png
测试效果:
# alpaca_prompt = Copied from above
FastLanguageModel.for_inference(model) # Enable native 2x faster inference
inputs = tokenizer(
[
    alpaca_prompt.format(
        "你是谁?你父亲是谁?", # instruction
        "", # input
        "", # output - leave this blank for generation!
    )
], return_tensors = "pt").to("cuda")

outputs = model.generate(**inputs, max_new_tokens = 64, use_cache = True)
tokenizer.batch_decode(outputs)
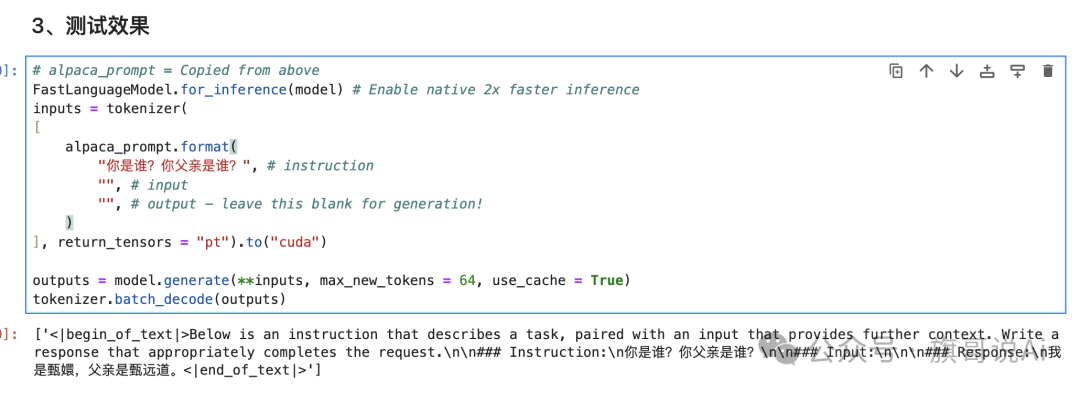 image.png
一、保存模型到本地
# 保存模型到本地
model.save_pretrained("lora_model")  # Local saving
tokenizer.save_pretrained("lora_model")
二、加载模型
prompt = "你是谁?你父亲是谁?"
system_prompt = "现在你要扮演皇帝身边的女人--甄嬛"
print("prompt: ", prompt)
print("system_prompt: ", system_prompt)

ifFalse:
    # I highly do NOT suggest - use Unsloth if possible
    from peft import AutoPeftModelForCausalLM
    from transformers import AutoTokenizer
    model = AutoPeftModelForCausalLM.from_pretrained(
        "lora_model", # YOUR MODEL YOU USED FOR TRAINING
        load_in_4bit = load_in_4bit,
    )
    tokenizer = AutoTokenizer.from_pretrained("lora_model")

inputs = tokenizer(
[
    alpaca_prompt.format(
        system_prompt, # instruction
        prompt, # input
        "", # output - leave this blank for generation!
    )
], return_tensors = "pt").to("cuda")

outputs = model.generate(**inputs, max_new_tokens = 64, use_cache = True)
tokenizer.batch_decode(outputs)
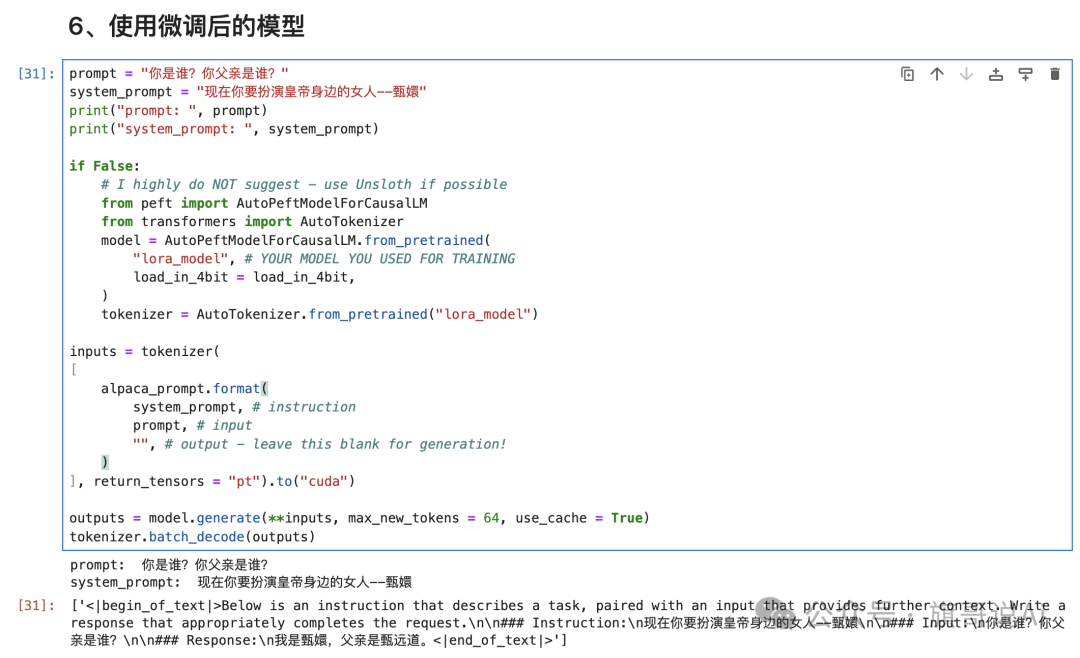 image.png
走到这里就算是完成了~
如何零基础入门 / 学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 297


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


