深度学习 Transformer 的自注意力机制掩码

智谱AI发布国产最强大模型GLM4,理解评测与数学能力仅次于Gemini Ultra和GPT-4,编程能力超过Gemini-pro,还有对标GPTs商店的GLMs 这是在智谱AI开发者大会上推出的新一代基座大语言模型,GLM4相比较此前最大的特点是三个变化:性能全面提升、上下文长度更长、支持更强的多模态能力。GLM4(GLM4)详细信息 | 名称、简介、使用方法,开源情况,商用授权信息 | 数据学习 (DataLearner) 阅读详情
AI摘要

博客介绍了深度学习Transformer自注意力机制中掩码的类型、应用及代码示例,还分享了AI大模型学习资源,包括全套AGI大模型学习路线、640套报告合集、经典PDF书籍和商业化落地方案,帮助读者学习AI大模型。

在这里插入图片描述

01引言

深度学习 Transformer 自注意力机制中的掩码(Mask)是一种关键技术,用于控制模型在处理序列数据时哪些位置的信息可以被相互关注。掩码在不同的上下文中有不同的应用,但总体目的是防止在处理序列的当前位置时“泄露”未来位置的信息或者忽略无关的位置。

02理解

常见的掩码类型:

1. 遮蔽未来的信息(Look-ahead Mask):

在自回归任务中,如语言模型或机器翻译,每个输出应该仅依赖于它之前的输出。因此,需要一个掩码来确保在计算当前输出时忽略所有未来的位置。

这种掩码通常是一个上三角矩阵,其中对角线及以下的元素为 True(表示掩蔽),对角线以上的元素为 False(表示不掩蔽)。

2. 填充掩码(Padding Mask):

在处理变长序列时,通常需要将序列填充到相同的长度。填充的位置对于模型来说是无关的,因此需要一个掩码来告诉模型忽略这些位置。

这种掩码通常基于一个二进制矩阵,其中填充位置为 True(表示掩蔽),非填充位置为 False。
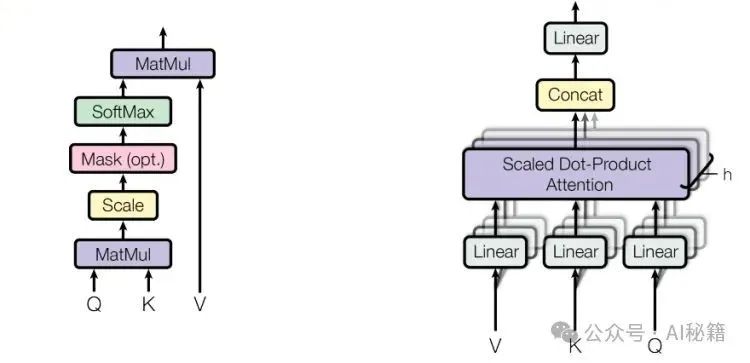
img

自注意力机制中的掩码应用:

在自注意力层中,掩码用于修改注意力分数,使得被掩码的位置的权重为零(或接近零),从而在计算注意力加权平均时忽略这些位置。具体步骤如下:
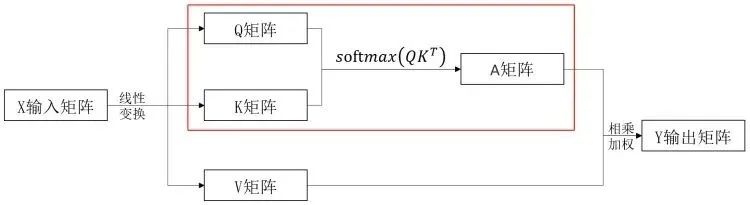
img

1. 计算注意力分数:

通常通过计算查询(Query)、键(Key)之间的点积,然后除以缩放因子(通常是键向量的维度的平方根)。
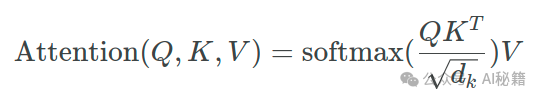
img

2. 应用掩码:

将掩码与注意力分数相乘。对于填充掩码,可以直接将 True 位置的分数设置为一个非常小的负数(如 -1e9),这样在应用 softmax 函数时,这些位置的权重将接近于零。

对于遮蔽未来的信息的掩码,同样可以将被掩码位置的分数设置为一个非常小的负数。

3. 计算注意力权重:

使用 softmax 函数对修改后的注意力分数进行归一化,得到注意力权重。

4. 计算加权平均:

使用注意力权重对值(Value)向量进行加权平均,得到最终的输出。

在这里插入图片描述

5. 例子

在这里插入图片描述

在代码段中,return subsequent_mask == 0 这个表达式用于生成一个布尔类型的张量,指定了哪些位置应该被掩蔽。

解释

subsequent_mask 是一个通过 torch.triu 创建的上三角矩阵,其中对角线和对角线以上的元素被设置为 1(因为 torch.triu 默认创建一个上三角矩阵,其中对角线及以上位置为 True,以下为 False)。在调用 .type(torch.uint8) 后,这些值被转换为 1(真)和 0(假)。

当执行 subsequent_mask == 0 时,此操作会逐一检查 subsequent_mask 中的每个元素是否等于 0:

  • 如果元素值为 0(即原来是 False),则表达式结果为 True。
  • 如果元素值为 1(即原来是 True),则表达式结果为 False。

因此,返回的张量将具有以下特性:

  • 对角线及以下的元素(原始掩码中的值为0的地方)在返回的张量中会变为 True,表示这些位置应该被掩蔽(即在注意力计算中忽略这些位置)。
  • 对角线以上的元素(原始掩码中的值为1的地方)在返回的张量中会变为 False,表示不需要掩蔽这些位置。

例子

假设 size=3,则 subsequent_mask 为:

  1 1 1  
  0 1 1  
  0 0 1

经过 subsequent_mask == 0 操作后,得到的张量为:

False  False  False
True   False  False
True   True   False

03代码

假设有一个简单的自注意力计算:

import torch
import torch.nn.functional as F

query = torch.tensor([[1, 2], [3, 4]], dtype=torch.float32)
key = torch.tensor([[5, 6], [7, 8]], dtype=torch.float32)
value = torch.tensor([[9, 10], [11, 12]], dtype=torch.float32)

# 计算点积
scores = torch.matmul(query, key.transpose(-2, -1)) / math.sqrt(query.size(-1))

# 创建一个遮蔽未来的掩码
mask = torch.triu(torch.ones_like(scores), diagonal=1) == 0

# 应用掩码
scores = scores.masked_fill(mask, float('-inf'))

# 计算注意力权重
attention = F.softmax(scores, dim=-1)

# 计算加权平均
output = torch.matmul(attention, value)

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

用ollama本地部署Lamma3.1 ollama create 自定义模型名字 -f Modelfile。让lamma3.1写一个贪吃蛇小游戏,一次run成功。例如:ollama run llama3.1。例如:ollama run llama3.1。 阅读详情

相关推荐

Windows 中 利用 ollama 来搭建 deepseek R1

近年来,大模型凭借其强大的语言理解和生成能力,在自然语言处理、计算机视觉等领域取得了突破性进展。从GPT系列到国内的,文心一言、[Qwen]、,大模型已成为推动人工智能发展的核心力量。ollama作为新兴的大模型搭建工具,以其开源、高效、易于部署的特点,在人工智能开发者社区中崭露头角,为大模型的搭建和应用提供了新的解决方案。在当今数字化浪潮中,人工智能的发展可谓日新月异,而大模型作为其核心驱动力,正重塑着各个行业的格局。

一个专注于机器学习基础与实战的技术博客,内容涵盖算法推导、模型实现、数学原理与代码实践。用通俗的语言解析复杂概念,记录学习过程中的思考与总结,适合机器学习爱好者和从业者参考。 2554

使用 Ollama 本地运行各种 LLM

今天看看另外一个产品Ollama。Ollama 的安装非常简单,只需从官网(https://ollama.com/download)下载后解压缩,并在 Terminal 中运行脚本即可完成环境设置。我尝试运行 Llama3,虽然在运行时占用了大量电脑资源,使得其他应用运行变慢,但整体体验尚可。Ollama 支持多种大型语言模型(https://ollama.com/library)。

python123456_的博客 1734

使用PyTorch实现多头自注意力机制的完整指南

我们通过继承`torch.nn.Module`来定义自己的模块。在类的初始化函数`__init__`中,我们需要定义几个关键参数:模型的嵌入维度(`d_model`)和注意力头的数量(`h`)。同时,我们假设每个头的维度(`d_k`)为`d_model // h`。通过上述步骤,我们使用PyTorch成功实现了一个完整的、功能强大的多头自注意力模块。这个模块是现代Transformer架构的核心组件,被广泛应用于BERT、GPT等前沿模型中。理解并能够手动实现这一机制,是深入掌握现代深度学习模型的关键。

qq_20243891的博客 351

AI大模型探索之路-基础篇5:GLM-4解锁国产大模型的全能智慧与创新应用

随着人工智能技术的飞速发展,大型预训练语言模型已成为推动行业进步的重要力量。它们在理解自然语言、生成文本、执行复杂任务等方面展现出惊人的能力。在此背景下,国产大模型GLM-4的问世,不仅展现了中国在AI领域的实力,也为国内外研究者和开发者提供了新的研究与应用平台。

寻道AI,探索AI无限可能! 8679

从零手撕Transformer:自注意力机制与PyTorch实现详解

理解 Transformer 的核心原理是进入现代大模型世界的钥匙。无论是想深入理解 ChatGPT、GPT-4 等大语言模型,还是想学习 Vision Transformer、Swin Transformer 等视觉模型,亦或是想自己动手实现一个简易的 Transformer,都绕不开对其基础架构和核心思想的透彻掌握。本文将从零开始,系统性地拆解 Transformer 的每一个组件,结合数学公式、代码示例和直观解释,让你不仅能“看懂”,更能“手撕”一个 Transformer。我们将从 RNN 的瓶颈讲

weixin_30642869的博客 493

Transformer架构图解:从自注意力机制到PyTorch最小实现

在深度学习领域,Transformer已取代RNN和CNN成为主流模型架构,支撑着GPT、BERT、ViT等众多先进模型。其核心创新在于用自注意力机制捕获序列内任意位置间的依赖关系,打破了循环网络的顺序计算限制,从而实现高度并行化训练和长程依赖建模。通过多头注意力机制,模型能够在不同子空间中学习丰富语义特征;而位置编码则为模型补充了必要的顺序信息。这一架构不仅在自然语言处理中取得突破,也被广泛应用于计算机视觉等多模态任务。理解Transformer的关键,是掌握注意力计算、多头机制、残差连接与层归一化等核心

weixin_30606461的博客 302

Transformer架构图解最强教程!

这差不多就是多头注意力的全部内容了。下面将所有内容放到一张图中,以便我们可以统一查看:现在让我们重新回顾一下前面的例子,看看在对示例句中的“it”进行编码时,不同的注意力头关注的位置分别在哪:当我们对it进行编码时,一个注意力头关注The animal,另一个注意力头关注tired。从某种意义上来说,模型对it的表示,融入了animal和tired的部分表达。的本质是:在参数总量保持不变的情况下,将同样的映射到原来的高维空间的不同子空间中进行Attention的计算,在最后一步再合并不同子空间中的。

2301_82275412的博客 1万+

【技术解析】华为智算中心:昇腾AI算力与无损网络如何驱动大模型训练

本文深入解析了华为智算中心如何通过昇腾AI算力与超融合以太无损网络的协同,驱动千亿参数大模型的高效训练。昇腾NPU提供专用计算引擎,而基于RoCE的无损网络则通过PFC、ECN等技术确保万卡集群间的高带宽、零丢包通信,实现算力利用率最大化,解决大规模AI训练的核心瓶颈。

weixin_29311017的博客 193

深度学习扩展

—把图片离散化为一排向量将图片拆为若干patch,每个patch可以看作一个字,再加上位置信息就可以输入到transformer中。ViT的核心是将图像视为一系列局部块的序列(类似自然语言中的单词),通过Transformer的全局自注意力机制捕捉图像中的长距离依赖关系。将输入图像(如224×224)分割为固定大小的非重叠块(例如16×16像素),每个块展平为向量。例如,224×224的图像会生成196个(14×14)块。

python0930233的博客 999

灵魂三问:因果推断

什么是因果推断?为什么研究因果推断?怎么进行因果推断研究?

ML OR 智能决策的博客 2902

AXI Memory Mapped To PCI Express IP 核设计实例

本文详细描述了AXI Memory Mapped To PCI Express(2.9) IP核的应用实例

u011565038的博客 2799

Transformer丨基础Transformer模型和代码详解

写到这里,关于Transformer比较重要的点基本都讲解完毕了。如果大家一路看过来,能够理解我的所言所语,我相信应该会有所收获的。本期内容还是侧重于对基础Transformer的讲解,未来我打算多去分享一些基于Transformer设计的网络模型以及实际应用。欢迎大家关注!图17 Transformer总结构图​。

python1234567_的博客 2238

全志 T527_Android13 编译 [ 避坑必看 ]

Swap 概念: Linux中Swap(即:交换分区),类似于Windows的虚拟内存,就是当内存不足的时候,把一部分硬盘空间虚拟成内存使用,从而解决内存容量不足的情况。它的功能就是在内存不够的情况下,操作系统先把内存中暂时不用的数据,存到硬盘的交换空间,腾出内存来让别的程序运行。当输入编译命令make -j16 的时候,会有如下提示,这是官方建议通过减少编译线程来解决编译时消耗内存过大的问题。Android 13 系统的编译流程,编译一共分为两部分:内核编译与 Android 编译。

公众号:嵌入式分享 2111

自注意力机制

Transformer的网络架构几乎统治了深度学习的所有应用领域。本模块讲授Transformer的网络结构,以及各种基于Transformer的预训练模型,包括BERT (Encoder-Only架构的代表模型)、T5 (Encoder-Decoder架构的代表模型)和GPT (Decoder-Only架构的代表模型)。

titanium的博客 245

计算机毕设项目十四:美团酒店评论情感分析完整数据代码-可直接运行

计算机毕设项目十四:美团酒店评论情感分析完整数据代码-可直接运行

693

Qt C++ 电子海图与作战叠加(Overlay)系统

lab_pos->setText(QString("坐标: X%1 Y%2").arg(p.x(),0,'f',0).arg(p.y(),0,'f',0));lab_distance->setText(QString("距离: %1 海里").arg(dist,0,'f',1));lab_bearing->setText(QString("方位: %1°").arg(bear,0,'f',1));// 绘制S-57海图基底。scene->addText("封锁线").setPos(450,180);

寒寒豆豆软件公司的博客 496

一文讲清楚大模型中8个关键词及原理:LLM、Transformer、GPT、Bert、预训练、微调、深度学习、Token

1. LLM(大语言模型):基于深度学习构建的超大规模语言模型,能理解、生成自然语言并执行复杂任务。2. Transformer:一种基于自注意力机制的深度学习架构,是当前主流大模型(如 GPT、BERT)的核心框架。3. GPT(生成式预训练 Transformer):基于 Transformer 的生成式预训练模型,擅长自然语言生成,如文本创作、对话交互。

Libra1313的博客 1269

贝叶斯核机回归估计混合物健康效应 【BKMR包】——实操篇

使用 ggplot2包绘制 h 的截面# 绘制总体风险摘要。

三分钟热度 5382

Transformer详解

Transformer是一种深度学习模型架构,专门为处理序列数据而设计,尤其是在自然语言处理(NLP)领域取得了革命性的成功。它在2017年由Google Brain团队在论文《Attention Is All You Need》中首次提出。完全摒弃了传统的循环神经网络(RNN)和卷积神经网络(CNN),仅依赖一种名为“自注意力(Self-Attention)”的机制来捕捉序列中各个元素之间的全局依赖关系。

qq_52604211的博客 872

【功能安全】【AutoSAR】程序流监控机制

目录 一、程序流执行的常见故障 二、程序流的监控机制 1、监控功能的实现 2、三种监督机制 a、生命监测机制 b、截止时间监测机制 c、逻辑程序流监测机制 一、程序流执行的常见故障 与程序流相关的故障,在ISO26262中第六章附录D中定义如下: — 执行阻塞; — 死锁; — 活锁; — 执行时间的不正确分配; — 软件要素间的不正确同步。 二、程序流的监控机制 1、监控功能的实现 AutoSAR中对程序流的监控功能的实现主要有“看门狗”栈(Watchdog Stack).

专注汽车软件开发、AutoSAR、车载以太网、SOA、EE架构。 4519

Statistics and Machine Learning Toolbox

Statistics and Machine Learning Toolbox(带书签),MATLAB统计学习工具

Transformer原理详解(图解完整版附代码)

论文名:Attention is all you need针对问题:RNN等序列模型不能并行运行,利用完全基于自注意力机制的自编码器去训练利用layer-normal:助于避免训练过程中的梯度消失问题,提高模型的稳定性。:对自注意力机制中 除以QKT除以dk ,以防止乘机过大,如下。注意力机制公式位置编码:由于 Transformer 不使用递归或卷积,它通过位置编码来加入序列中元素的位置信息。自注意力机制:它允许模型在处理序列的每个元素时同时考虑序列中的所有其他元素,从而捕捉元素之间的关系。

生活需要深度 7284

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

吴恩达深度学习专项-第五课-Week4编程作业

Coursera吴恩达教授深度学习第五课(序列模型)第四周编程作业,发出来完整代码供大家参考学习,不足之处请各位大佬多多指正。coding不易,给个点赞行不行^_^ Transformer Network Welcome to Week 4's assignment, the last assignment of Course 5 of the Deep Learning Specialization! And congratulations on making it to the last assi.

a1549351841的博客 5012

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

visio安装包

Microsoft Office Visio 是一款专业的制图软件。利用经过更新的形状、协作工具和数据链接图表,创建专业级图表以简化复杂的信息。

注意力机制(极简教程):Transformer核心

注意力机制→ 解决信息选择问题自注意力机制→ 实现全局信息交互多头自注意力→ 捕获多样化关系模式多头掩码注意力→ 适配生成任务约束每一步改进都针对前一阶段的具体问题,最终形成了Transformer架构的核心。这个演进过程不仅是技术的进步,更体现了对序列建模本质问题的深入理解。从最初的"关注重要信息",到最终的"在约束条件下进行多维度全局建模",注意力机制的演进为现代自然语言处理奠定了坚实基础。

Dark_Cultivation的博客 690

机器学习&&深度学习——transformer(机器翻译的再实现)

机器学习&&深度学习——transformer(机器翻译的再实现)

m0_52380556的博客 1821
上一篇: 用大模型优化大模型预训练数据,节省20倍计算量,实现显著性能提升!
下一篇: 所有测试人,下半年的新方向(大模型),赢麻了!!!
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值