


GPT vs LlaMA
GPT与LlaMA,作为大语言模型的两大巨擘,均基于Transformer架构却各有千秋。GPT系列以强大的生成能力著称,通过不断增大的参数规模引领复杂语言与推理任务的前沿;而Llama则以开源姿态,通过技术创新提升模型性能,预示着多模态扩展的未来,为AI生态的多样性和开放性贡献力量。
GPT vs LlaMA
一、GPT
什么是GPT?GPT模型,全称为Generative Pre-trained Transformer,是由OpenAI团队开发的一种基于深度学习的自然语言处理(NLP)模型。 该模型通过无监督学习的方式,对大规模文本进行学习和抽象概括,进而通过微调的方式用于各种特定的自然语言处理任务。
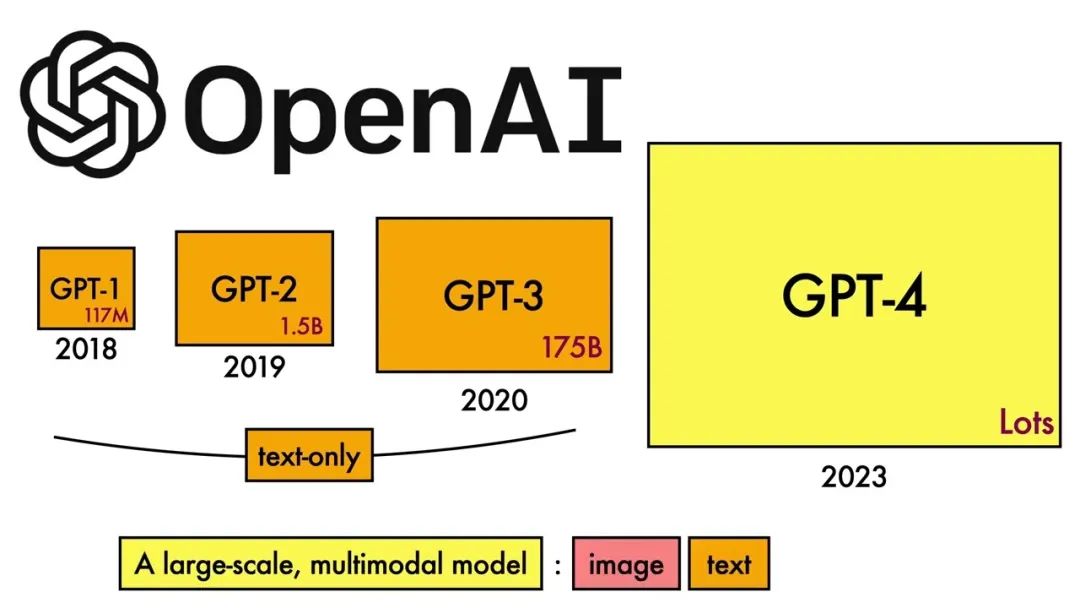
GPT的版本迭代:OpenAI GPT模型自发布以来,已经历了多个版本的迭代升级,每个版本都在前一版本的基础上进行了改进和优化。
GPT的版本迭代
- GPT-1:这是GPT系列的第一个版本,发布于2018年。**GPT-1具有1.17亿个参数,使用Transformer的Decoder结构作为基础,并采用了预训练的语言模型。**它在多项自然语言处理任务上取得了很好的表现,如文本生成、机器翻译和阅读理解等。
- GPT-2:GPT-2是GPT系列的第二个版本,发布于2019年。相比于GPT-1,GPT-2在模型规模和预训练数据上都有了显著的提升。**GPT-2的参数数量增加到了15亿,并使用了更多的预训练数据。**这些改进使得GPT-2在生成任务上表现出了更强的创造力和语言理解能力,能够生成更长、更连贯的文本。
- GPT-3:GPT-3是GPT系列的第三个版本,发布于2020年。**GPT-3具有惊人的1750亿个参数。**这一巨大的模型规模使得GPT-3能够处理更加复杂和多样的自然语言处理任务,包括文本生成、翻译、问答和文本分类等。GPT-3在预训练过程中使用了大量的互联网文本数据,进一步提升了其性能和泛化能力。
- GPT-4:GPT-4是GPT系列的第四个版本,发布于2023年3月。**GPT-4是一款具有广泛应用的大型、多模态模型。**与之前的版本不同,GPT-4是第一个能够同时接收文本和图像的多模态模型。它不仅可以接收文本输入,还能接收图像输入,并生成相应的文本输出。GPT-4在各种专业和学术基准测试中表现出色,显示出其强大的自然语言处理能力和多模态理解能力。

GPT的版本迭代
GPT2的架构:GPT-3及以后的版本采取了闭源的策略,模型的具体实现细节、训练数据、超参数配置等关键信息并未对外公开。
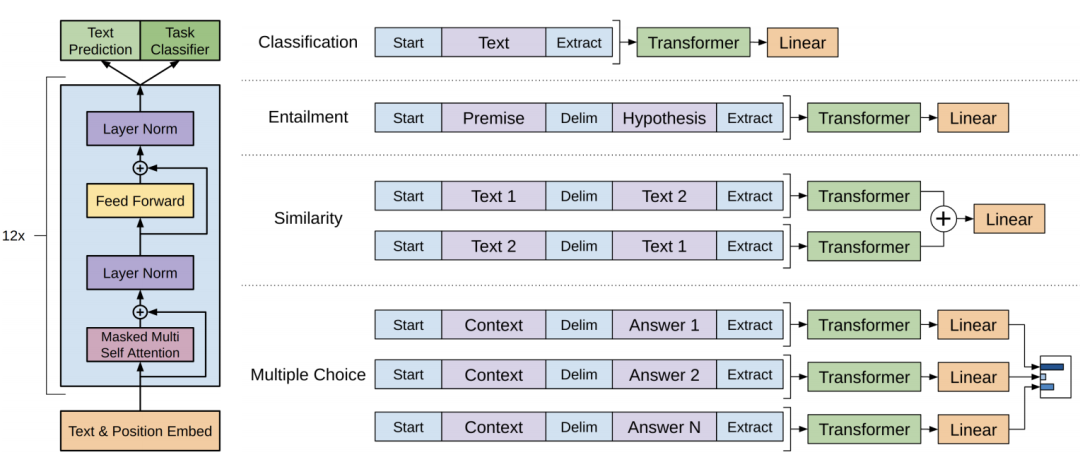
GPT-2的架构主要基于Transformer的解码器(Decoder)部分,并通过堆叠多个Decoder层、引入自注意力机制和位置编码、使用残差连接和层归一化等技术手段来构建模型。

GPT-2的架构
1. 堆叠Transformer的Decoder
- GPT-2沿用了Transformer的解码器部分,通过堆叠多个Decoder层来构建模型。每个Decoder层都包含了自注意力(Self-Attention)机制和位置编码(Position Encoding)等关键组件。
- GPT-2的堆叠层数可以根据具体需求进行调整,但通常包括多个(如12层)Decoder层,以提供足够的深度来捕捉文本中的复杂依赖关系。
2. 自注意力机制(Self-Attention)
- 自注意力机制是Transformer和GPT-2中的核心组件,它允许模型在处理文本时同时关注到文本中的其他部分。
- 在GPT-2中,自注意力机制通过计算输入序列中每个单词与其他单词之间的相关性来实现,从而帮助模型理解文本的全局上下文信息。
3. 位置编码(Position Encoding)
- 由于Transformer模型本身并不包含任何关于单词位置的信息,GPT-2引入了位置编码来弥补这一缺陷。
- 位置编码是一种将单词在序列中的位置信息嵌入到模型中的方法,它使得模型能够区分不同位置的单词并理解它们的顺序关系。
4. 残差连接(Residual Connections)和层归一化(Layer Normalization)
- GPT-2在Decoder层之间使用了残差连接和层归一化技术,以提高模型的训练稳定性和收敛速度。
- 残差连接允许模型在传递信息时保留前一层的部分输出,从而避免了深层网络中的梯度消失或梯度爆炸问题。
- 层归一化则通过对每一层的输入进行归一化处理,使得模型的每一层都能够在相似的尺度上工作,进一步提高了模型的稳定性和性能。
5. 输出层
- GPT-2的输出层通常包括一个线性层(Linear Layer)和一个Softmax层,用于将Decoder层的输出映射到词汇表上的概率分布。
- 通过这种方式,GPT-2可以根据输入的上文生成对应的下文单词,从而实现文本生成任务。

GPT-2的架构
二、LlaMA
什么是LlaMA?LLaMA的全称是Large Language Model Meta AI,直译为“大语言模型元AI”。由于“Llama”在西班牙语中意为“羊驼”,因此社区也将其昵称为羊驼系模型。
LLaMA于2023年2月由Meta AI发布,是该系列的初代模型。随后,Meta AI又相继推出了LLaMA2和LLaMA3等升级版本。
- 训练数据:LLaMA的训练数据来源于公开数据集,无任何定制数据集,确保了其工作的开源兼容性和可复现性。整个训练数据集在token化之后大约包含1.4T的token。随着版本的迭代,训练数据的规模不断增加,LLaMA3甚至基于超过15万亿个token的数据进行预训练。
- 模型规模:LLaMA提供了多种规模的版本,包括7B、13B、70B和405B(4050亿)等不同参数量的模型。这些模型可以根据具体的应用场景和计算资源进行选择。
- 性能优异:LLaMA在多个基准测试上表现出色,甚至能够媲美或超越一些参数量更大的模型。例如,具有130亿参数的LLaMA模型在大多数基准上可以胜过GPT-3(参数量达1750亿)。
LlaMA
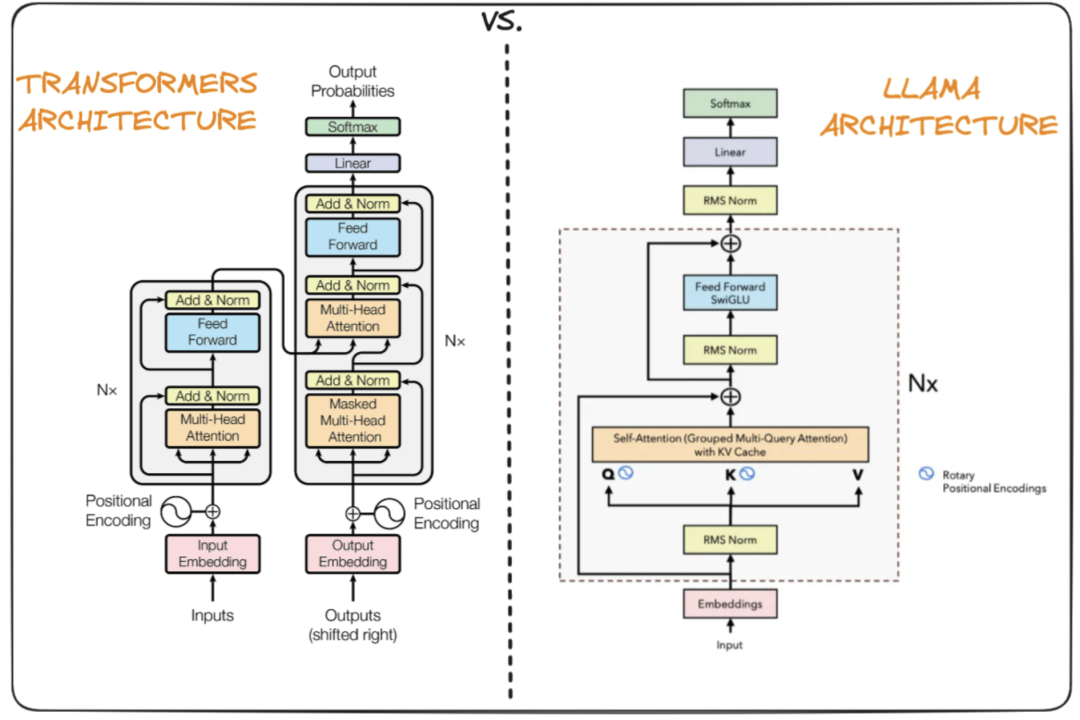
LlaMA的架构:LLaMA模型的整体架构与GPT-2等Transformer模型类似,但针对稳定性和性能进行了多项改进。它采用了前置层归一化(Pre-normalization)、RMSNorm归一化函数、SwiGLU激活函数以及旋转位置嵌入(RoPE)等关键技术。
LlaMA的架构
-
前置层归一化(Pre-normalization)
-
- 为了提升训练时的稳定性,LLaMA将归一化操作从Transformer子层的输出移到了输入。具体地,第一层归一化被设置在多头注意力层之前,第二层归一化被移动到全连接层之前。同时,残差连接的位置也调整到了多头注意力层与全连接层之后。这种设计有助于减少梯度消失或爆炸的问题,从而提高训练稳定性。
-
RMSNorm归一化函数
-
- LLaMA在归一化过程中使用了RMSNorm(Root Mean Square Layer Normalization),这是一种基于均方根(RMS)的归一化方法。RMSNorm不依赖于均值,而是通过计算特征向量的RMS值来进行归一化。这种方法在计算上更为简洁,且在某些情况下可以提供类似甚至更好的性能。在LLaMA中,RMSNorm还加入了可学习的缩放因子和偏移参数,以进一步提高模型的灵活性。
-
SwiGLU激活函数
-
- LLaMA使用了SwiGLU(Swish-Gated Linear Unit)激活函数,这是Shazeer在文献中提出的一种激活函数,并在PaLM等模型中得到了广泛应用。相较于传统的ReLU函数,SwiGLU在很多评测数据集上表现出了更好的性能。在LLaMA中,全连接层使用了带有SwiGLU激活函数的计算方式,这有助于提升模型的非线性处理能力。
-
旋转位置嵌入(RoPE)
-
- LLaMA没有使用传统的绝对位置编码(如BERT中的sin/cos位置编码),而是采用了旋转位置嵌入(RoPE)。RoPE借助了复数的思想,通过绝对位置编码的方式实现了相对位置编码的效果。这种方法能够更有效地捕捉序列中的位置信息,从而提升模型在处理序列数据时的性能。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 485


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


