大模型微调使GPT3成为了可以聊天发布指令的ChatGPT

GPT-1, GPT-2, GPT-3, GPT-3.5, GPT-4论文内容解读 阅读详情

你好,开始一种新的尝试,准备聊聊“大语言模型入门”。

字少总结版本

  • 聊天大模型在通用大模型的基础上加一层微调就实现人人能用的大模型。使得通用大模型的能力被更多人使用和了解。
  • 大模型微调(Fine-tuning)是指在已经训练好的大模型基础上,进一步在特定任务或数据集上进行训练,以便让模型在特定应用场景中表现得更好。
  • 大模型微调更适合业务场景和性能需求。

什么是大模型

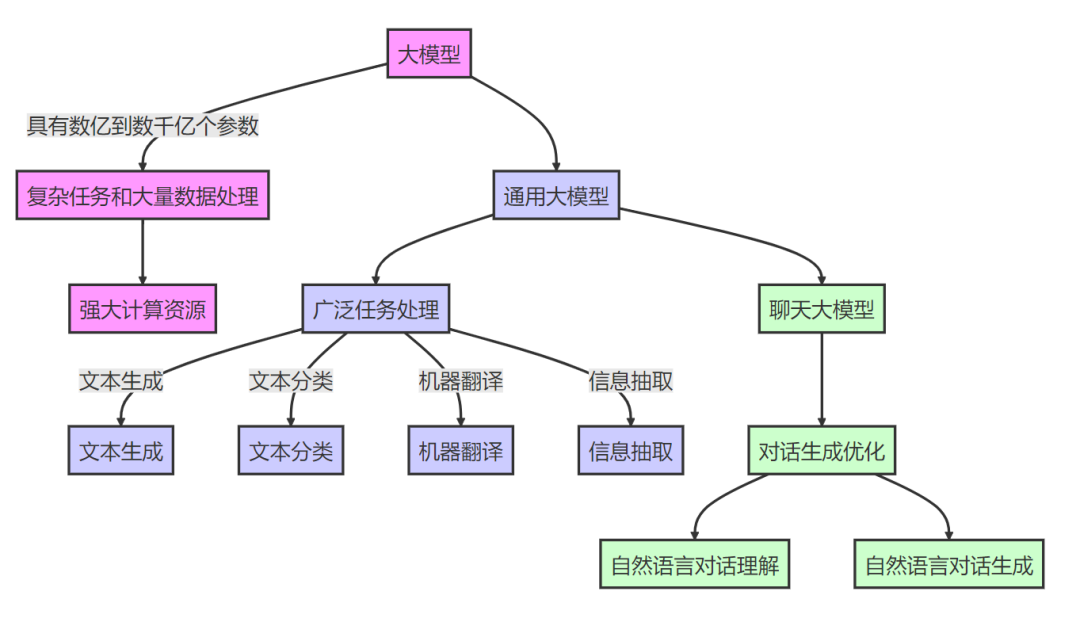
大模型的第一个特征就是具有数亿到数千亿个参数。这些模型可以处理复杂的任务和大量的数据,通常需要强大的计算资源来训练和运行。

这里必须得提一下通用大模型和聊天大模型的区别联系。

通用大模型是那些被设计为能够处理广泛任务的模型,不仅限于对话生成。例如,通用大模型可以用于文本生成、文本分类、机器翻译、信息抽取等多种任务。

聊天大模型是通用大模型的一个子集,专门设计用于生成自然对话。它们优化了对话生成的能力,致力于理解和生成自然语言对话,以便在聊天应用中提供自然且相关的回答。

聊天大模型在通用大模型的基础上加一层微调就实现人人能用的大模型。使得通用大模型的能力被更多人使用和了解。

这也是GPT3远没有ChatGPT流行的原因。
图片大模型微调

大模型微调具体做了什么

大模型微调(Fine-tuning)是指在已经训练好的大模型基础上,进一步在特定任务或数据集上进行训练,以便让模型在特定应用场景中表现得更好。

那么大模型微调具体会做哪些内容呢?

大模型微调的过程可以通过两个主要方面来理解:

将更多数据输入模型中:

  • 现象:微调允许你将比单次提示(prompt)可以容纳更多的数据输入到模型中。换句话说,微调过程中,模型不仅处理单个提示中的信息,还能学习和记住大量数据集中的模式和信息。
  • 解释:在微调阶段,你使用的训练数据集可能比单个提示大得多。模型在这个阶段不仅对每一个输入做出反应,还通过优化其参数来适应这些数据。这使得模型能够“记住”这些数据的模式和结构,而不仅仅是基于单次提示生成响应。通过这种方式,模型可以学习特定任务或领域的详细特征和知识。

让模型学习数据,而不仅仅是访问数据:

  • 现象:微调过程使得模型能够学习并内化数据中的模式,而不仅仅是在需要时从数据中获取信息。模型在微调过程中会调整其内部参数,使得在未来遇到类似的数据时,它能够更好地应用之前学到的知识。
  • 解释:与仅使用预训练模型处理单个提示不同,微调是一个学习过程。模型通过反复暴露于特定的数据集来调整其内部权重,从而在特定任务上表现更佳。这种学习过程不仅使模型能够在面对类似数据时产生合理的响应,还使得模型能够在没有明确提示的情况下应用所学知识。

大模型微调的过程不仅使模型能够处理更多的任务和数据,还提升了模型在特定领域的能力。它通过调整模型的参数,使得模型能够将训练数据中的模式和知识内化,从而在面对相关任务时表现得更加出色。这种方法不仅提高了模型的表现,还节省了计算资源,使得实际应用更为高效。
在这里插入图片描述

大模型微调的优点

  1. 提升性能:将通用的 GPT 模型微调用于法律领域,能够生成更准确的法律咨询建议。比如基于通义的法睿模型。
  2. 节省资源:在医疗影像诊断中,通过微调预训练的模型,比从头训练一个新模型更节省计算资源和时间。
  3. 适应性强:通过对特定语言的对话数据进行微调,使得模型能够更好地理解和生成该语言的自然对话。
  4. 减少数据需求:在电商推荐系统中,通过微调预训练模型,可以使用少量用户行为数据来提升推荐准确性。
  5. 个性化:在个性化广告中,微调模型可以根据用户的历史数据生成量身定制的广告内容。

大模型微调的一般流程

大模型微调的一般流程包括以下几个关键步骤:

定义目标任务:

  • 确定模型需要完成的具体任务或应用场景,例如文本分类、问答系统、翻译等。

准备数据:

  • 数据收集:收集与目标任务相关的数据集。数据可以是标注的文本、图像、语音等。
  • 数据预处理:对数据进行清洗、标注和格式化,以便输入到模型中进行训练。

选择预训练模型:

  • 选择一个已经在大规模数据集上预训练好的模型,如 GPT、BERT、ResNet 等,这些模型具有通用的知识和能力。

配置微调设置:

  • 设置超参数:如学习率、批量大小、训练周期等。
  • 选择损失函数和优化器:根据任务的具体需求选择合适的损失函数和优化算法。

微调模型:

  • 加载预训练模型:将选择的预训练模型加载到训练框架中。
  • 进行训练:使用准备好的数据集对预训练模型进行训练,调整模型的参数以适应特定任务。这个过程包括前向传播、计算损失、反向传播和优化参数等步骤。

评估和验证:

  • 模型评估:在验证集上评估模型的表现,检查模型在目标任务上的效果,如准确率、F1-score、损失值等。
  • 调优:根据评估结果调整模型参数和训练设置,进行必要的调整和再训练。

测试和部署:

  • 最终测试:在测试集上进行最后的测试,确认模型在实际使用中的表现。
  • 模型部署:将微调后的模型部署到实际应用环境中,例如集成到应用程序、服务或系统中。

监控和维护:

  • 监控模型表现:持续监控模型在实际应用中的表现,确保其稳定性和准确性。
  • 更新和维护:根据需要对模型进行进一步的更新和维护,以适应新的数据或任务变化。
    在这里插入图片描述

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

ChatGPT与GPT的区别与联系 和都是基于架构的语言模型,但它们有不同的侧重点和应用。下面我们来探讨一下它们的区别与联系。 阅读详情

相关推荐

ChatGPT模型的进化:从GPT-2到GPT-4

从GPT-2到GPT-4,ChatGPT模型的进化历程反映了生成式AI在自然语言处理领域的飞跃发展。GPT-2为生成式文本的出现奠定了基础,GPT-3大幅提升了模型的规模与应用场景,而GPT-4则在增强理解能力、处理多模态信息、对话流畅度等方面进一步优化。尽管取得了诸多突破,ChatGPT及其背后的生成式AI技术依然面临一些挑战,包括伦理性、准确性、可解释性等问题。随着技术的不断发展,未来的生成式AI模型可能会更加智能、灵活,并在更多实际应用场景中展现出巨大的潜力。

二进制的梦想 2113

NLP大模型微调原理

2. 论文《Training Compute-Optimal Large Language Models》研究发现最好的性能不是在最大的模型上,而是在用了更多token的模型上,因此作者认为一个较小的模型训练的时间更长,用的token更多,能达到一样的模型效果,并且在预测时较为便宜(cheaper)。GPT等大型语言模型基于Prompt的zero shot的学习范式有一个很大的问题是,预训练的模型完成的任务是后继文本的预测,这和具体任务的要求有一些偏离,生成的结果也不一定符合人的意图。

狮子座明仔知识集散场 8507

GPT3.5, InstructGPT和ChatGPT的关系

GPT-3.5 系列是一系列模型,从 2021 年第四季度开始就使用文本和代一起进行训练。

Harry的博客 1万+

一招鉴别真假ChatGPT,并简要介绍ChatGPT、GPT、GPT2和GPT3模型之间的区别和联系

一招鉴别真假ChatGPT,并简要介绍ChatGPT、GPT、GPT2和GPT3模型之间的区别和联系

叶子的博客 3万+

用Hugging Face预训练GPT微调ChatGPT

用Hugging Face预训练GPT微调ChatGPT 1. 背景介绍 1.1 问题的由来 随着人工智能技术的快速发展,自然语言处理(NLP)领域取得了突破性的进展。其中,以ChatGPT为代表的大型语言模型(LL

AI天才研究院 1172

ChatGPT与GPT3的区别与优势

ChatGPT与GPT-3的区别与优势 作者:禅与计算机程序设计艺术 / Zen and the Art of Computer Programming / TextGenWebUILLM ChatGPT与GPT-3的区别与优势

AI天才研究院 1498

ChatGPT技术原理解析:从RL之PPO算法、RLHF到GPT4、instructGPT

本篇ChatGPT笔记会全力做到,通俗易懂且循序渐进(尽最大努力让每一个初学者哪怕是文科生都能没有障碍的读懂每一字一句、每一个概念、每一个公式) 一方面,对于想了解ChatGPT背后原理和如何发展而来的,逐一阐述从GPT/GPT2/GPT3到强化学习、PPO算法,最后再到instructGPT、ChatGPT、SeqGAN 且本文之前,99%的文章都不会把PPO算法从头推到尾,本文会把PPO从零推到尾,按照“RL-策略梯度-重要性采样(重要性权重)-TRPO(增加信任区域和KL散度约束)-PPO”的顺序逐步

结构之法 算法之道 22万+

同济大学824复试全攻略:从笔试到面试的实战解析

本文详细解析同济大学824复试全流程,包括专业课笔试、外语听力与口语、专业外语笔试和专业综合面试的备考策略。重点分享数字信号处理、计算机网络等专业课的高效学习方法,以及专业外语速成和口语面试技巧,助力考生全面提升复试表现。

qq_27496129的博客 1055

NLP_GPT到ChatGPT

NLP_GPT到ChatGPT

weixin_42504788的博客 2232

Python实战:用nltk库5步搭建你的第一个n-gram文本生成器(附古诗生成案例)

本文详细介绍了如何使用Python的nltk库5步搭建n-gram文本生成器,并附有古诗生成案例。从环境准备、n-gram原理讲解到完整实现,逐步指导开发者掌握自然语言生成技术。特别针对中文古诗生成进行了优化,包括分词处理和韵律控制,帮助读者快速上手文本生成项目。

weixin_29090089的博客 202

2025年7月12日全国青少年信息素养大赛图形化(Scratch)编程小学低年级组复赛真题+答案解析

2025年7月12日全国青少年信息素养大赛图形化(Scratch)编程小学低年级组复赛真题+答案解析

伶俐角少儿编程 711

【AI大模型】ChatGPT模型原理介绍(上)

ChatGPT 是由人工智能研究实验室 OpenAI 在2022年11月30日发布的全新聊天机器人模型, 一款人工智能技术驱动的自然语言处理工具. 它能够通过学习和理解人类的语言来进行对话, 还能根据聊天的上下文进行互动, 真正像人类一样来聊天交流, 甚至能完成撰写邮件、视频脚本、文案、翻译、代码等任务.​​。

2301_76820214的博客 1万+

【制作100个unity游戏之30】使用unity实现一款2d俯视角RPG战斗游戏,主要使用InputSystem+有限状态机+A*寻路实现(完结,附带项目源码)

【制作100个unity游戏之30】使用unity实现一款2d俯视角RPG战斗游戏,主要使用InputSystem+有限状态机+A*寻路实现

向宇的博客,专注php/web全栈 unity游戏开发,欢迎大家评论纠错 4653

chatgpt模型详解系列--chatgpt、gpt4

2022年11月30日,OpenAI发布了一款强大的大模型ChatGPT,它在不到一周的时间内就吸引了100万注册用户,这标志着通用人工智能(AGI)的时代已经来临。接下来,我们将详细介绍ChatGPT的原理和应用。

xrp11的博客 1660

mjlab & MimicKit 宇树 G1 人形机器人强化学习训练部署

基于mjlab框架训练Unitree G1人形机器人执行双旋踢的示例。参考动作源自Jason Peng的MimicKit项目。数据转换脚本(MimicKit pkl → mjlab csv)完整训练结果与超参数预训练ONNX检查点用于部署实体硬件部署指南⚠️ 免责声明仅用于教育目的。对于因尝试复现此处展示结果而导致的财产损失或人身伤害,我们概不负责。操作硬件时请谨慎行事并保持良好判断力。

2506_90492529的博客 1700

SAP ABAP CO核心扩展-ZCKMLQS 多物料工厂的评估数量结构报表(CKMLQS)

CKMLQS 只能查看单一物料工厂的评估数量结构,SAP 没有提供多物料工厂的评估数量结构报表。这篇文章将实现 CO核心扩展-ZCKMLQS 多物料工厂的评估数量结构报表。

SAP李斌,本人承诺所有原创文章均不使用任何AI生成技术,请大家放心阅读。 1089

详细教程:自定义大模型之微调ChatGPT

Fine-tuning理论上很复杂,但是OpenAI把这个功能完善到任何一个人看了就能做出来的程度。我们先从原理入手,你看这张图,左边是Pre-trained LLM (预训练大模型模型),也就是像ChatGPT这样的模型;右边是Fine-tuned LLM (微调过的语言大模型),中间就是进行微调的过程,它需要我们提供一些「ChatGPT提供不了但是我们需要的东西」。比如说我们这个回答就是想微调一个『使用中国道家思想和语录进行回答的聊天机器人』

xiangxueerfei的博客 2932

YOLOv8高级应用实战:多目标跟踪+实例分割+小样本检测(工业/安防场景落地指南)

安防监控中,需要跟踪多个行人的运动轨迹,而不只是框出“这是行人”;工业质检时,要精确分割出零件的缺陷区域(像素级),而不是只给一个粗略的矩形框;罕见场景下(如特殊故障检测、稀有动物识别),只能收集到几十张样本,普通训练方法精度惨不忍睹。我在落地工业安防和质检项目时,把YOLOv8的高级功能摸了个遍,踩过“多目标跟踪遮挡丢帧”“实例分割边缘模糊”“小样本检测过拟合”等一系列坑,最终总结出这套可直接复用的实战方案。多目标跟踪(ByteTrack)、实例分割、小样本检测。

专注于Python爬虫开发,分享爬虫技巧、项目实战与反爬经验,使用Scrapy、BeautifulSoup等工具,解决数据抓取难题。 750

浅谈ChatGPT与GPT

本文简述ChatGPT与GPT的关系,以及GPT1到GPT4的算法的核心思想及区别(文章字数偏多,阅读时间较长,文笔有限,继续努力)GPT(Generative Pretrained Transformer)是由OpenAI公司开发的一种大型语言模型。GPT模型的核心是基于“变换器”(Transformer)架构,这种架构最初是在2017年由Vaswani等人提出的,主要用于处理自然语言处理(NLP)任务。GPT的工作原理主要包括两个阶段:预训练和微调。

2301_77727994的博客 1824

SIMATIC S7-1200, S7-1500 PID 控制[手册]

SIMATIC S7-1200, S7-1500 PID 控制[手册]

OV9734 DATASHEET,完整规格书

OV9734完整规格书,包括电气参数,尺寸规格,寄存器配置表等

GPT‑3.5:从语言模型迈向对话智能的过渡之作

在 GPT‑3 引发轰动之后,OpenAI 于 2022 年末至 2023 年初悄然推出 GPT‑3.5 系列模型。它并没有像 GPT‑3 或 GPT‑4 那样配有完整论文,但它是 ChatGPT(2022 年 11 月发布)背后的核心引擎,在多项任务中表现优异,为 GPT‑4 奠定了坚实基础。

和大家一起涨芝士 1256

Probability and Statistics - 4th edition

Probability and Statistics - 4th edition

【大模型微调实战】使用Peft技术与自己的数据集微调大模型

LLM是大型语言模型的缩写,是人工智能和机器学习领域的最新创新。2022年12月,随着ChatGPT的发布,这种强大的新型人工智能在网上疯传。对于那些足够开明的人来说,生活在人工智能的嗡嗡声和科技新闻周期之外,ChatGPT是一个在名为GPT-3的LLM上运行的聊天界面。最近的大模型就是Meta的llama2当然还有openai的GPT4,google的PaLM2.国内有清华的ChatGLM等等.

aqwca的博客 9218

最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版

Part-E1-SDIO-Specification-Ver4.00-Final-120220.pdf:最新的sdio 4.0 spec 协议标准 带书签 高清完整PDF版,包括SDIO 接口的外设,SDIO 接口官方协议等。

让ChatGPT介绍一下ChatGPT

申请新必应内测通过了,我在New Bing中使用下ChatGPT,让ChatGPT介绍一下ChatGPT

Java+GO+JS全栈工程师-鹤冲天的博客:编程辅导~商务合作~技术交流 9万+

【无标题】一文弄懂大模型、GPT、ChatGPT、AIGC等人工智能概念

在人工智能的快速发展中,大模型、GPT、ChatGPT和AIGC等术语频繁出现在各种报道中,这些概念不仅代表了AI领域的最新进展,也预示着未来技术发展的趋势。为了更好地理解这些概念及其相互之间的关系,本文将逐一进行解释。

2401_85373691的博客 1783

ChatGPT简单介绍:

ChatGPT简单认识

@初阶牛的博客 12万+
上一篇: 何时何地,你需要提示工程、函数调用、RAG还是微调大模型?
下一篇: 搭建大模型知识库流程,以及基于langchain实现大模型知识库案例
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


