行业大模型训练经验分享&落地思考_行业大模型训练

【项目实训】大规模模型训练:策略、挑战与最佳实践 在深度学习领域,大规模模型训练已成为提升模型性能的关键因素之一。随着数据量的增加和计算能力的提升,大型神经网络模型能够捕获更复杂的数据特征,提供更精确的预测。然而,训练这些大模型并非无难度,它涉及到多方面的技术挑战。本文将探讨进行大模型训练的有效策略、面临的主要挑战以及推荐的最佳实践。 阅读详情

大家好,行业大模型一直是大家关注的内容,恰逢我司也做了行业知识大模型,借此机会聊一聊行业大模型训练Trick以及行业大模型落地想法。

但有些并没有什么理论依据,全是自己的实验经验&结论,可能跟大家有所不同。

行业大模型训练Trick

一、行业技术标准文档或行业相关数据是行业模型Continue PreTrain的关键。

现有大模型在预训练过程中都会加入书籍、论文等数据,那么在行业预训练时这两种数据其实也是必不可少的,主要是因为这些数据的数据质量较高、行业强相关、知识覆盖率(密度)大,可以让模型更适应考试。当然不是说其他数据不是关键,比如行业相关网站内容、新闻内容都是重要数据,只不过个人看来,在行业上的重要性或者知识密度不如书籍和技术标准。

二、行业数据训练后,往往通用能力会有所下降,需要混合通用数据以缓解模型遗忘通用能力。

如果仅用行业数据进行模型训练,模型很容易出现灾难性遗忘现象,通常在行业训练过程中加入通用数据。那么这个比例多少比较合适呢?目前还没有一个准确的答案,BloombergGPT(从头预训练)预训练金融和通用数据比例基本上为1:1,ChatHome(继续预训练)发现行业:通用数据比例为1:5时最优。个人感觉应该跟行业数据量有关,当数据量没有那多时,一般数据比例在1:5到1:10之间是比较合适的。
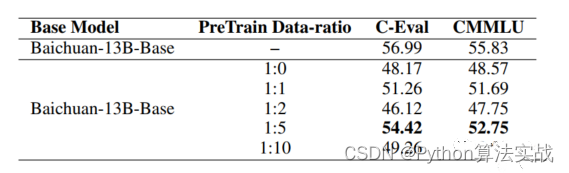
请添加图片描述

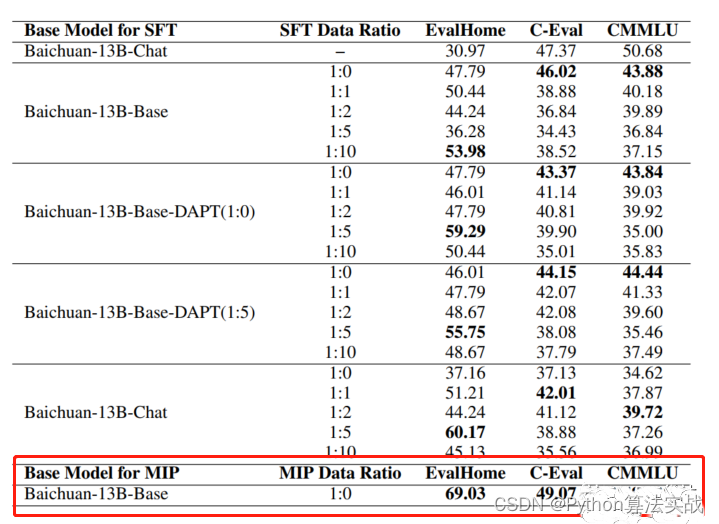
三、行业模型Continue PreTrain时可以同步加入SFT数据,即MIP,Multi-Task Instruction PreTraining。

预训练过程中,可以加下游SFT的数据,可以让模型在预训练过程中就学习到更多的知识。例如:T5、ExT5、Glm-130b等多任务学习在预训练阶段可能比微调更有帮助。并且ChatHome发现MIP效果在行业上评测集上绝群。
请添加图片描述

四、 仅用SFT做行业模型时,资源有限就用在Chat模型基础上训练,资源充足就在Base模型上训练。(资源=数据+显卡)

跟很多人讨论过一个问题,就是我们在SFT的时候是在Base模型上训练还是在Chat模型上训练。

其实很简单,如果你只有5k数据,建议你在Chat模型上进行微调;如果你有10w数据,建议你在Base模型上进行微调。因为你不知Chat模型在SFT时的数据质量如何,当自己有能力时,靠人不如靠己。

五、在Chat模型上进行SFT时,请一定遵循Chat模型原有的系统指令&数据输入格式。

如果你在Chat模型上进行SFT的时候,请跟Chat模型的输入格式一致,否则当你数据量不足时,可能会导致训练效果不明显。并且建议不采用全量参数训练,否则模型原始能力会遗忘较多。

六、行业评测集时必要内容,建议有两份,一份选择题形式自动评测、一份开放形式人工评测。

一定要有自己的行业数据集来验证模型效果,来选择最好的checkpoint。选择题形式可以自动评测,方便模型进行初筛;开放形式人工评测比较浪费时间,可以用作精筛,并且任务形式更贴近真实场景。

七、行业模型词表扩增是不是有必要的。

个人感觉,行业词表扩增真实解决的问题是解码效率的问题,给模型效果带来的提升可能不会有很大。(这里行业词表扩充是指在同语言模型上扩充词表,而不是英文模型的中文汉化)

八、所谓的行业大模型会更新的越来越快,越来越多。

由于很多人&公司并没有资源搞底座,因此需要在现有底座模型上进行增量预训练、微调等。而以目前各厂(ChatGLM、BaiChuan、Qwen、Llama)抢占开源社区占比的架势,感觉会有很多7B、13B级别模型开源。

请等待一言、ChatGPT开源小模型的一天,说不定GPT5出来的时候,Openai会开源个GPT3.5的小版本模型。

行业大模型落地的想法

一、常说通用模型的行业化可能是伪命题,那么行业大模型的通用化是否也是伪命题。

自训练模型开始,就一直再跟Leader Battle这个问题,行业大模型需不需要有通用化能力。就好比华为盘古大模型“只做事不作诗”的slogan,是不是训练的行业大模型可以解决固定的几个任务就可以了。

个人的一些拙见是,如果想快速的将行业大模型落地,最简单的是将系统中原有能力进行升级,即大模型在固定的某一个或某几个任务上的效果超过原有模型。

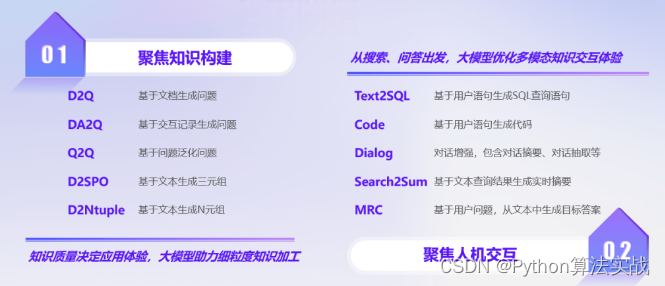
以Text2SQL任务举例,之前很多系统中的方法是通过抽取关键要素&拼接方式来解决,端到端解决的并不是很理想,那么现在完全可以用大模型SQL生成的能力来解决。在已有产品上做升级,是代价最小的落地方式。就拿我司做的来说,在解决某行业某场景SQL任务上效果可以达到90%+,同比现有开源模型&开放API高了不少。

当然还有很多其他任务可以升级,例如:D2QA、D2SPO、Searh2Sum等等等。在这里插入图片描述
二、行业大模型落地,任务场景要比模型能力更重要。

虽说在有产品上做升级,是代价最小的落地方式,但GPT4、AutoGPT已经把人们胃口调的很高,所有人都希望直接提出一个诉求,大模型直接解决。但这对现有行业模型是十分困难的,所以在哪些场景上来用大模型是很关键的,并且如何将模型进行包装,及时在模型能力不足的情况下,也可以让用户有一个很好的体验。

现在很多人的疑惑是,先不说有没有大模型,就算有了大模型都不知道在哪里使用,在私有行业都找不到一个Special场景。

所以最终大模型的落地,拼的不是模型效果本身,而是一整套行业解决方案,“Know How”成为了关键要素。

三、大多数企业最终落地的模型规格限制在了13B。

由于国情,大多数企业最终落地的方案应该是本地化部署,那么就会涉及硬件设备的问题。我并不觉的很有很多企业可以部署的起100B级别的模型,感觉真实部署限制在了10B级别。即使现在很多方法(例如:llama.cpp)可以对大模型进行加速,但100B级别的模型就算加速了,也是庞大资源消耗。

我之前说过“没有体验过33B模型的人,只会觉得13B就够”,更大的模型一定要搞,但不影响最后落地的是10B级别。

做大模型的心路历程

一开始ChatGPT刚刚爆火的时候,根本没想过我们也配做大模型。但当国内涌现出了许多中文大模型,并Alpaca模型证明70亿参数量的模型也有不错效果的时候,给了我很大的信心,当然也给很多人和很多企业更多的信心。

在中小企业做大模型,经常被质问的是“没有100张卡也可以做大模型”,我只想说需要看对“大”的定义,175B的模型确实没有资格触碰,但33B的模型还是可以玩耍的。真正追赶OpenAI是需要一批人,但模型落地还是需要另外一批人的。

赶上大模型是我们的幸运,可以在行业大模型上发声是我幸运。

总结

最后共勉:BERT时代况且还在用TextCNN,难道13B的模型就不叫大模型吗?

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

行业垂直大模型的训练与优化 1. 背景介绍 1.1 人工智能的崛起 随着计算机技术的飞速发展,人工智能已经成为了当今科技领域的热门话题。从自动驾驶汽车到智能家居,人工智能已经渗透到了我们生活的方方面面。在这个过程中,深度学习技术的出现为人工智能的发展提供了强大的动力。 1.2 深度 阅读详情

相关推荐

【β-Boltzmann探索策略】

𝜀是一个介于0和1之间的参数,用于控制探索和利用的比例。当𝜀较大时,智能体更倾向于探索;当𝜀较小时,智能体更倾向于利用已知信息。

m0_59385870的博客 1088

行业大模型训练经验分享&落地思考

最后共勉:BERT时代况且还在用TextCNN,难道13B的模型就不叫大模型吗?

2301_78285120的博客 1849

使用同一个时钟源clki,做两个二分频时钟,得到div2_clk1和div2_clk2,这两个时钟都能跟源时钟clki同步,但是div2_clk1和div2_clk2的相位可能是相同的,也可能是反相

比如,触发器1的初始Q为0,而触发器2的初始Q为1(这可能由于芯片制造工艺的微小差异、上电过程的随机性、或没有全局复位信号导致)。这句话的意思是:虽然div2_clk1和div2_clk2都是由同一个妈妈(clki)生出来的,频率也都是妈妈的一半,但它们“起步”的时刻可能不同。所以,上面那段话是在提醒你注意这种潜在的、由分频产生的时钟相位关系的不确定性,这在异步电路设计或时钟管理中是必须考虑的关键因素。结果:div2_clk1和div2_clk2的波形完全重合,它们的上升沿和下降沿都发生在同一时刻。

m0_49540263的博客 594

大模型系列|垂直大模型的几种训练策略(一)

垂直行业大模型的几种训练策略

素质云笔记 1万+

【C++】 详解 lower_bound 和 upper_bound 函数(看不懂来捶我!!!)

这两个函数是我在 LeetCode 上做题见到,看到不熟悉的函数 lower_bound 和 upper_bound让我感觉很难受,于是在C++ 官网去学习,例子就一个是最基础的,我看明白了。虽然是两个函数的接口就两个,但是有时候看别人使用的时候,里面参数还可以放不同的仿函数,我懵逼了。就去网上搜,但是大家讲解的都是它的第一个接口。我只能再把文档一遍一遍过,代码一遍遍的尝试,调试。最终通过查阅资料将其总结如下。

weixin_45031801的博客 9万+

sldd数据字典导出为excel

sldd导出为excel

zpfjf的博客 2240

深度学习大模型学习100tips

通过深入了解这些细节,并在实际项目中应用相关的知识,将能够更好地理解和利用大模型的潜力,不仅在学术研究中,也在工程实践中。通过不断探索新方法、参与项目和保持热情,并将其应用于各种领域,从自然语言处理到计算机视觉和自动驾驶。通过不断学习、实践和探索,可以不断提升自己在深度学习领域的技能和洞察力,同时也能为社会和行业带来创新和改进。从小规模的项目和模型开始,逐渐迭代和扩展到更大的模型,逐步积累经验,最终能够处理大模型和复杂任务。分享您的研究成果和代码,以获得反馈和建立声誉。

xw555666的博客 2万+

制造业与工业知识图谱应用

在全球数字化转型背景下,制造业面临创新周期缩短、质量管控精细化等挑战。知识图谱技术通过结构化表示工业知识,为智能制造提供关键技术支撑。工业知识图谱具有专业性强、多源异构数据融合、实时性要求高等特点,其构建流程涵盖本体设计、知识抽取与整合等环节。研究显示,知识图谱与大模型结合可提升工业场景的智能化水平,在设备故障诊断、供应链优化等领域具有显著应用价值。该技术有望成为制造业数字化转型的核心驱动力。

分享一些感兴趣的技术方面 1450

垂直行业大模型微调:法律AI训练心得与反思

法律AI大模型微调实践总结 核心摘要 本文系统分享了法律垂直领域大模型微调的全流程实践经验,主要包括: 数据获取与处理:法律文本具有结构化强、术语专业的特点,需经过严格清洗(去除HTML标签、统一标点、长度过滤)和专家标注(实体识别、法律要素提取)。 模型选型与优化:对比了LLaMA-2、ChatGLM-2等主流模型,最终选择ChatGLM-2-6B作为基座,采用LoRA+DeepSpeed ZeRO-2方案在单卡A100上实现高效微调。 技术实现:详细展示了基于PEFT的法律文本微调代码,包括数据预处理、

千淘万漉虽辛苦,吹尽狂沙始到金 2万+

LTE网络下的SMS收发(SMS Over SGs方案的详细流程)

关键词: IMS,SMS, LTE, MSC, MME, EPS,eNodeB, SMS Over SGs, SMS Over IMS 2G时代由于采用了比较复杂的CS/PS域架构,所以SMS(短信)作为上个世纪的产物,一直寄居在2G的CS域架构下。看看核心网的配置,其实SMS的收发还是比较复杂的。 介绍下面的信息之前你需要去百度一下这些关键词,这里我只说明比较重要的三个单元 MS 移动终端...

kevin的博客 2万+

戴尔G3/AWCC用户必看:揪出WMI Provider Host疯狂占用的元凶,附5.4.35旧版回退保姆级教程

本文针对戴尔G3/AWCC用户遇到的WMI Provider Host异常占用问题,提供了详细的诊断方法和解决方案。通过分析AWCC 5.5.14.0版本的资源占用问题,指导用户回退到稳定版AWCC 5.4.35,并附上保姆级教程和预防措施,帮助用户彻底解决系统卡顿问题。

weixin_30892037的博客 563

微调不是玄学:我在垂直领域训练行业大模型的完整流程

垂直领域大模型微调实战指南 摘要 本文详细介绍了垂直领域大模型的微调全流程,包括数据准备、模型选择、训练优化和评估部署等关键环节。文章强调数据质量的重要性,提供了数据清洗和格式化的实用代码示例,并比较了不同规模模型的特点。作者建议从Mistral 7B或Llama 3 8B等中等规模模型入手,分享了硬件配置建议和软件环境搭建要点。通过系统化的方法,帮助开发者将通用大模型转化为专业的行业解决方案。

千淘万漉虽辛苦,吹尽狂沙始到金 2万+

PP触发EWM产生PMR捡配

PP触发EWM产生PMR捡配 前言 PMR: Production Material Request 在流程订单/生产订单下达后,可以在EWM中产生PMR,在EWM中, PMR其实代表了ERP中的流程订单/生产订单。 You can use SAP EWM in conjunction with the following PP application components: • Production Orders • Process Orders • Repetitive Manufacturing •

ZevYang的博客 1920

我们公司落地大模型的路径、方法和坑

代码和断言将其操作化。对于更 “高级” 的漂移检测,考虑对输入/输出对的嵌入进行聚类以检测语义漂移,例如用户讨论话题的变化,这可能表明他们正在探索模型之前未接触过的领域。因此,如果没有好的检索(和排名),我们冒着用分心的内容淹没模型的风险,甚至可能将完全不相关的信息填充到上下文窗口中。对于那些在 ML 领域工作了很长时间的人来说,你可能会想到 “人机协同” 的概念,但没那么快:HITL 机器学习是一种建立在人类专家确保 ML 模型的行为符合预测的基础上的范式。虽然相关,但我们在这里提出的是更微妙的东西。

AI生成式技术曾小健 1481

廖雪峰Python教程[完整版]

廖雪峰的python教程整理的,已经排好版了,而且还是完整的,适合小白

Outlook Express 6 (OE6) for Win7/Win8/Win10

英文版 Outlook Express6.0, 兼容Win7/Win10/WinXP,解压就可用。

微软中国CTO韦青:亲身经历大模型落地的体会与思考

在大模型、AIGC 的冲击下,大多数人把目光聚焦在技术浪潮上,聚焦在那些“容易解决”的问题上,但实际上企业增长过程中还存在很多显而易见的、需要解决的、关键的问题,这些问题就像“看不见的大猩猩”一样存在于企业之中,这些问题很可能成为企业快速发展的“卡点”。微软中国 CTO 韦青在 2024 年 4 月举办的 QCon 北京发表的《看不见的大猩猩——智能时代的企业生存和发展之路》的主题演讲中,结合自身经验,聚焦企业内部这些被忽略的“大猩猩”,分享关键问题的解决之道。

m0_59235699的博客 1017

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

阿里通义实验室大模型方向三轮面试经历

【阿里通义实验室大模型方向三轮面试复盘】 面试聚焦大模型技术深度与工程实践,三轮考察侧重点明确:一面深入模型原理(Qwen架构、MoE设计、RLHF流程),结合Transformer编码实现等编程题;二面侧重训练推理优化(DeepSpeed、显存管理、精度选择),涉及LoRA、FlashAttention等关键技术;三面探讨行业趋势与个人见解,评估候选人的开放思考能力。整体难度较高,要求兼备原理理解、工程优化能力和行业视野,建议准备时覆盖模型结构、训练加速及前沿问题思考,并注重项目实践经验。

2401_85592132的博客 1664

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

2025秋招技术突围:基于RAG的大模型应用开发实践与深度思考

当ChatGPT成为基础能力,秋招竞争的焦点已转向如何将大模型落地于真实业务场景。本文展示的RAG系统开发全流程,体现了从架构设计、性能优化到风险控制的完整技术思维。建议同学们在项目中深入至少一个技术点(如向量索引优化或提示词注入防御),形成具有差异化的技术标签。真正的技术价值,永远诞生于理论与实践的交叉点。那些在需求泥沼中打磨出的解决方案,终将成为你简历上最硬的通货。技术栈参考:向量引擎:Faiss/Qdrant大模型:ChatGLM3/Qwen框架:LangChain/LLamaIndex。

x1ao_fe1的博客 861

收藏!大模型入行通关全攻略:从基础到大厂offer,小白&程序员必看

大模型赛道的技术迭代速度非常快,今天的新技术、新模型,可能明天就会被更优的方案迭代。所以,入行之后一定要保持持续学习的热情,多关注顶会论文(比如NeurIPS、ICML)、行业技术博客和大厂的技术动态。很多面试官在面试时都会问“最近有没有关注什么新模型、新技术”,本质上就是考察你对行业的敏感度和持续学习能力。希望这篇经过实战验证的攻略,能帮到正在努力冲刺大模型赛道的你。祝大家都能夯实技术基础,积累优质项目经验,最终拿到心仪的大厂offer!

xxue345678的博客 1187

AI+行业应用实践:金融、汽车、工业制造的落地路径

2026奇点智能技术大会AI+行业应用专题深度解读。拆解金融、汽车、工业制造三大行业的AI落地路径,涵盖行业大模型、垂直数据治理与既有系统集成,附真实案例与ROI测算方法。

2600_95884800的博客 30

必收藏|大模型就业&保研全攻略(小白/程序员入门必备)

这些模型通常由深度神经网络构建而成,拥有数十亿甚至数千亿个参数。大模型的设计目的是为了提高模型的表达能力和预测性能,能够处理更加复杂的任务和数据。大模型在各种领域都有广泛的应用,包括。

优快云_430422的博客 706

探究DeepSeek在医疗&医药领域的应用:超过20家公司的落地优势与场景

1、远低于主流模型的服务定价。DeepSeek-R1的API服务定价远低于主流o1类推理模型,降低了AI医疗应用的成本门槛2、深度思考模式下,表现出的优秀的逻辑推理能力3、开源模型,开发者可以进行模型的开发与训练4、国产血统带来的中文语义理解和文字生产能力5、支持私有化部署和轻量化压缩,降低医疗机构算力门槛,让低成本院内部署具有可行性。

2401_85375151的博客 1323

大模型落地全攻略:从技术实践到企业价值创造

摘要:大模型技术正加速从实验室走向产业应用,企业需构建四大核心能力:模型微调(领域适配)、提示词工程(零样本/少样本应用)、多模态交互(跨模态理解)和企业级部署(安全与成本平衡)。本文详细剖析了LoRA微调实践、CLEAR提示词设计原则、多模态系统架构及企业级解决方案,指出成功落地的关键在于技术选型与业务场景的深度融合。数据显示,2025年70%企业AI项目将基于大模型,但目前仅20%成功落地,建议企业采用四阶段实施路线图,平衡技术创新与业务价值,实现AI驱动的流程重构。

zzywxc787的博客 971

从零转型AI大模型:4个月速成路线与实战经验

深度学习作为人工智能的核心技术,通过神经网络模拟人脑处理信息的方式实现复杂任务。其核心原理包括反向传播算法和梯度下降优化,特别在Transformer架构出现后,大模型展现出强大的涌现能力。在工程实践中,PyTorch和Hugging Face生态成为主流工具链,支持从模型训练到部署的全流程。以智能客服为例,结合NLP技术和LLM微调,可快速构建领域对话系统。当前AI大模型领域存在显著人才缺口,掌握LoRA等参数高效微调方法能有效降低计算成本。通过系统学习机器学习基础和Transformer原理,配合Col

weixin_29080843的博客 47
上一篇: 拿到字节大模型算法岗 Offer,我要上岸了!
下一篇: 2024大学生转行,推荐一个好就业的方向——人工智能大模型
爱喝白开水a
博客等级 码龄3年 6793粉丝 763原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
