RAG检索总是搜不到?别卷Prompt了,手把手教你微调垂直领域Embedding模型(附源码)

大模型应用开发实战:从RAG到工程化部署的完整指南 大语言模型(LLM)作为当前人工智能领域的核心技术,其本质是基于海量数据训练的概率预测模型,通过模式识别与泛化实现智能交互。其核心原理在于Transformer架构对上下文信息的强大建模能力。这项技术的核心价值在于,它极大地降低了AI应用的门槛,使开发者能够通过API调用和框架集成,快速构建智能应用,而无需从零训练模型。在实际应用场景中,大模型常与检索增强生成(RAG)技术结合,用于构建企业级知识库问答、智能客服和内容生成等系统,以解决模型幻觉和知识更新问题。本文以金融大模型问答机器人为具体案例,深入剖析了 阅读详情

在过去的一段时间,我们在公众号里一起学习了 RAG的搭建、向量数据库的选型、甚至是 Rerank(重排)模型的使用。

但最近,很多做 政务、金融、医疗 等垂直领域的朋友在后台私信我同一个痛点:

“云枢,我的 RAG 系统搭好了,Prompt 也写出花儿了,上了 Rerank,但效果还是差点意思。

用户问‘人才购房补贴’,它搜出来全是‘人才公寓管理’或者‘购房落户政策’。关键词都沾边,但意思完全不对!大模型拿不到对的参考资料,只能在那一本正经地胡说八道。”

这就像你问路“去火车站怎么走”,它告诉你“火车站的炒面很好吃”。它懂了,但没完全懂。

问题出在哪?Embedding 模型(向量化模型)不懂你的“行业黑话”。

今天,不教大家怎么“调 Prompt”,我们来点硬核的——手把手教你微调一个专属的 Embedding 模型,从根源上解决“搜不准”的问题!


RAG 优化的“金字塔”:我们在哪一层?

在开始动手前,我们需要知道“模型微调”在 RAG 优化体系里的地位。RAG 的优化手段其实是一个金字塔:

•Level 1:Prompt 工程(最简单): 优化提问技巧,让大模型更好理解。•Level 2:切片策略 (Chunking): 把文档切得更科学,不切断语义。•Level 3:混合检索 (Hybrid Search): 向量检索 + 关键词检索 (BM25) 互补。•Level 4:重排 (Rerank): 在检索回来的结果里,用高精度模型再排一次序。•Level 5:Embedding 微调 (Fine-tuning)(最硬核): 直接改造模型的“大脑”,让它重新理解什么是“相似”,什么是“无关”。

如果前 4 层你都做过了,效果还是遇到瓶颈,那么微调 Embedding 就是你突破天花板的唯一路径。


技术选型:为什么不用“傻瓜式”工具?

市面上有很多微调工具,为什么我们要选择写代码?

•AutoTrain / LlamaIndex / ms-swift: 这些都是非常优秀的“开箱即用”工具(Wrapper)。它们像傻瓜相机,封装得很好,一行命令就能跑。但缺点是是个黑盒——你不知道它底层用了什么 Loss,不知道它是怎么处理数据的,一旦效果不好,你根本无从调试。•SentenceTransformers: 这是 PyTorch 生态下 Embedding 训练的事实标准,相当于摄影师手里的单反相机。 •透明: 你能看到每一行代码在干什么。 •强大: 完美支持 BGE、Jina 等主流模型。 •可控: 显存不够?调!负例不够?加!

云枢主张: 对于新手,第一次微调一定要用 SentenceTransformers 写一遍代码。只有理解了底层的“对比学习”原理,以后你才能驾驭那些自动化工具。


核心原理:大模型不懂“硬负例”

很多教程微调完效果不好,是因为忽略了**“硬负例”(Hard Negative)**。这是本篇文章最核心的概念,大家一定要懂。
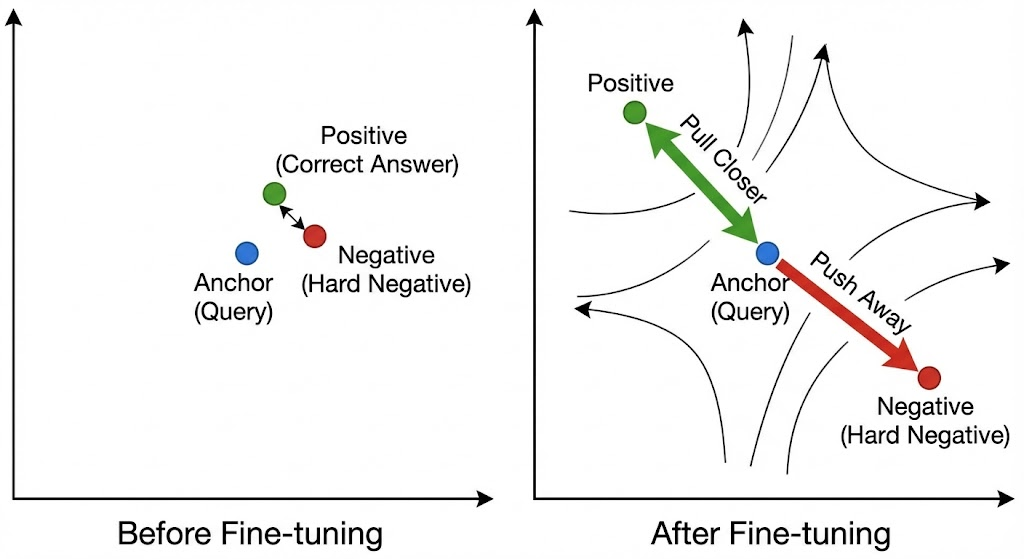
教模型认“苹果”,有两种教法:

1.普通教学(Easy Negative): 拿个汽车,告诉它“这不是苹果”。这太简单了,模型闭着眼都能分清,学不到东西。2.硬核教学(Hard Negative): 拿个绿色的皮球,告诉它“这也是圆的、绿的,但它不是苹果”。

在 Embedding 微调中:

•简单负例: 随机抽一篇不相关的文档。•**硬负例:****“看起来很像,关键词重合度很高,但语义完全错误”**的文档。

比如搜“购房补贴”,BM25可能会搜出“购房落户”或“租房补贴”。它们字面极像,最容易迷惑模型。我们就要把这些作为负例喂给模型,强迫它学会区分“落户”和“补贴”的细微差别。
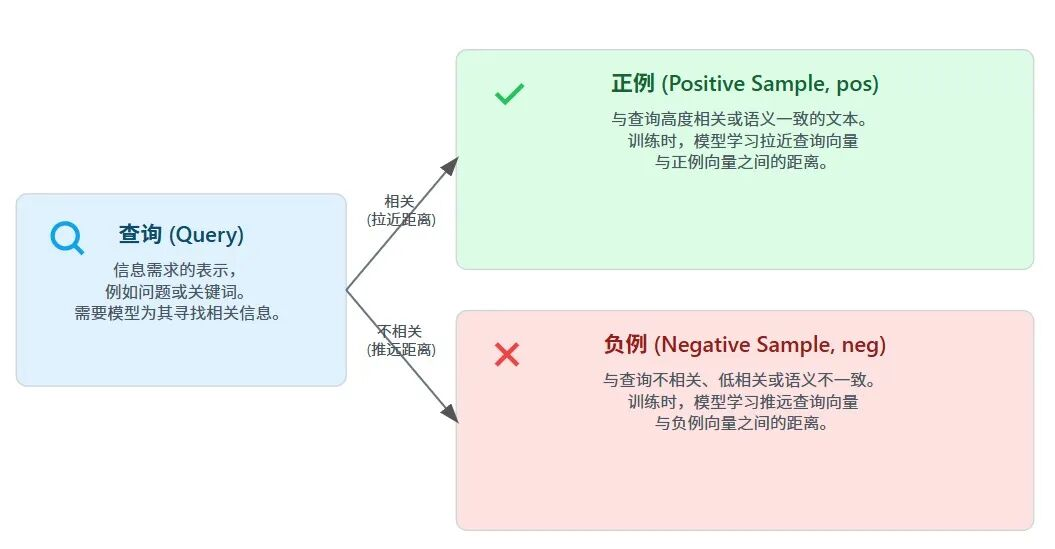
云枢的实战结论: 如果不加硬负例,微调效果可能只能提升 5%;加上硬负例,提升能达到 20%-30%!


实战环节:3090 单卡微调全流程

第一步:数据准备(LLM + BM25 自动挖掘)

我们做垂直领域,通常没有现成的训练数据。千万别人工标注! 那是上一代 AI 做的事。我们要用魔法打败魔法。

我为大家设计了一条自动化数据流水线:

1.出题人 (LLM): 让大模型阅读文档,生成问题。2.找茬人 (BM25): 用传统的关键词搜索 (BM25) 去库里搜这个问题。

•为什么要用 BM25? 因为 BM25 只看字面匹配,不看语义。它搜出来的错题,通常字面重合度极高(比如搜“补贴”出“罚款”)。这正是我们梦寐以求的“硬负例”!

(注:数据生成脚本较长,请在文末获取完整代码仓库,这里只展示核心逻辑)

def main():
# 1. 加载所有文件并切片
print("1. 正在扫描目录并加载数据...")
if not os.path.exists(INPUT_DIR):
print(f"目录不存在: {INPUT_DIR}")
return
corpus = load_data_from_dir(INPUT_DIR)
print(f"数据加载完成,共切分为 {len(corpus)} 个片段。")
if len(corpus) == 0:
print("未找到有效文本数据,请检查目录。")
return
# 2. 构建 BM25 索引(全局索引)
print("2. 正在构建 BM25 索引(用于硬负例挖掘)...")
# 对中文进行分词
tokenized_corpus = [list(jieba.cut(doc)) for doc in corpus]
bm25 = BM25Okapi(tokenized_corpus)
dataset = []
# 3. 开始循环生成
print("3. 开始生成问题并挖掘负例...")
# 限制处理数量用于测试,正式跑可以去掉 [:10]
for idx, doc_text in tqdm(enumerate(corpus), total=len(corpus), desc="Generating"):
# 生成正例 (Query)
queries = generate_queries(doc_text)
for query in queries:
# 挖掘负例 (Hard Negatives)
tokenized_query = list(jieba.cut(query))
scores = bm25.get_scores(tokenized_query)
top_n_indexes = sorted(range(len(scores)), key=lambda i: scores[i], reverse=True)[:BM25_TOP_K]
hard_negatives = []
for neg_idx in top_n_indexes:
# 排除掉原文片段自己
if neg_idx == idx or corpus[neg_idx] == doc_text:
continue
hard_negatives.append(corpus[neg_idx])
if len(hard_negatives) >= NEG_COUNT:
break
# 补齐负例
retry_count = 0
while len(hard_negatives) < NEG_COUNT and retry_count < 20:
random_neg = random.choice(corpus)
if random_neg != doc_text and random_neg not in hard_negatives:
hard_negatives.append(random_neg)
retry_count += 1
# 组装数据
data_item = {
"query": query,
"pos": [doc_text],
"neg": hard_negatives
}
dataset.append(data_item)
# 4. 保存文件
print(f"4. 正在保存数据到 {OUTPUT_FILE}...")
with open(OUTPUT_FILE, 'w', encoding='utf-8') as f:
for item in dataset:
f.write(json.dumps(item, ensure_ascii=False) + '\n')
print(f"任务完成!训练数据已生成。")

跑完这个脚本,你就得到了一份高质量的、带有“陷阱”的训练数据,格式如下:

{
"query": "高层次人才购房补贴标准是多少?",
"pos": ["给予A类人才最高300万元购房补贴..."],
"neg": [
"大学生租房补贴标准为每月...",  // 硬负例1:租房补贴
"人才购房落户需满足以下条件..."  // 硬负例2:购房落户
]
}

第二步:模型微调(解决显存爆炸)

数据有了,开始训练。这里演示使用的是单张 24G 显存的 3090,一跑代码就 OOM。 因为带了硬负例后,模型一次要处理 1(问) + 1(正) + 4(负) = 6 个句子!

为了让单卡能跑,云枢使用了**“单卡黄金配置”**,主要靠三招:

1.梯度检查点 (Gradient Checkpointing): 用算力换显存,必开。2.混合精度 (FP16): 显存占用减半。3.梯度累积: 既然显存小,我们就把 Batch Size 设小(比如 4),多跑几步再更新参数。
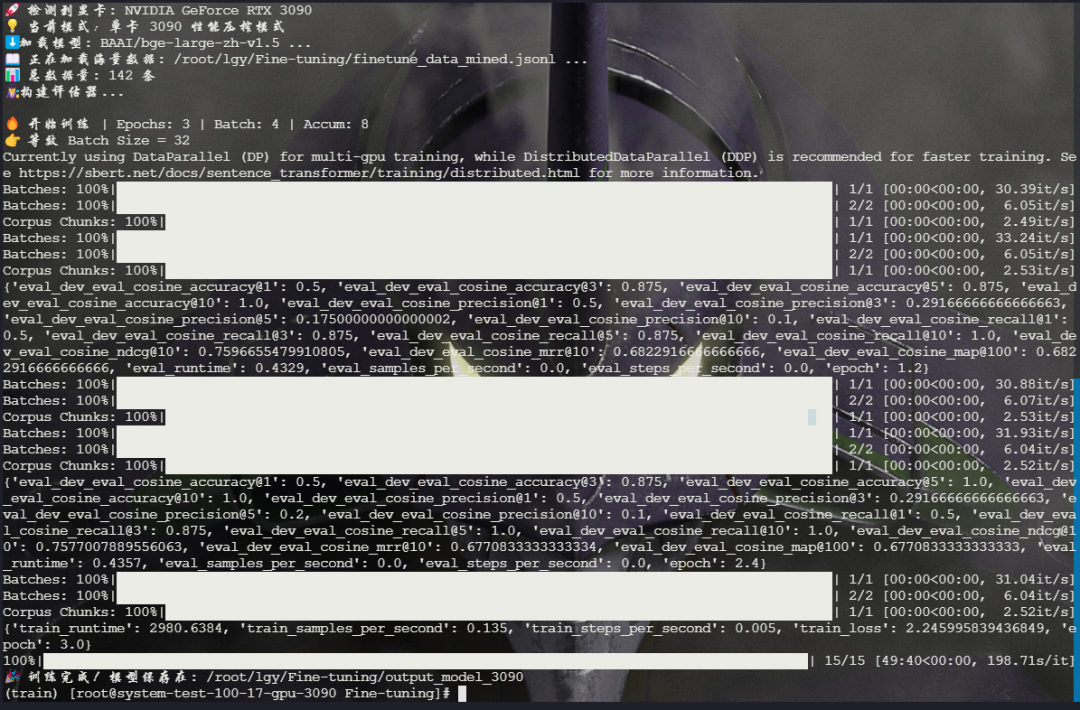
核心代码:

from sentence_transformers import SentenceTransformer, losses
from torch.utils.data import DataLoader
MODEL_NAME = "BAAI/bge-large-zh-v1.5" # 选个好点的中文基座
BATCH_SIZE = 4       # 3090 单卡建议 4-6
MAX_SEQ_LENGTH = 256 # 垂直领域 256 长度足够,非常省显存
def train():
# 加载模型
model = SentenceTransformer(MODEL_NAME)
model.max_seq_length = MAX_SEQ_LENGTH
# 开启梯度检查点,防 OOM 的关键!
model.gradient_checkpointing_enable()
# 准备数据
train_dataloader = DataLoader(train_examples, shuffle=True, batch_size=BATCH_SIZE)
# 定义损失函数:MultipleNegativesRankingLoss
# 会自动把 batch 内的其他数据也作为负例,极其高效
train_loss = losses.MultipleNegativesRankingLoss(model=model, scale=20.0)
# 4. 开始训练
model.fit(
train_objectives=[(train_dataloader, train_loss)],
epochs=3,
output_path="./output_model_final",
save_best_model=True,
use_amp=True  # 开启 FP16 混合精度
)
if __name__ == "__main__":
train()

第三步:效果验证

微调完,到底有没有用?我们写个对比脚本,让基座模型和微调模型同台竞技。

核心逻辑:

# 加载两个模型
base_model = SentenceTransformer("BAAI/bge-large-zh-v1.5")
ft_model = SentenceTransformer("./output_model_final")
# 计算 Query 与 正例/负例 的相似度
q_emb = model.encode(query)
p_emb = model.encode(pos_doc)
n_emb = model.encode(neg_doc)
print(f"正例得分: {util.cos_sim(q_emb, p_emb)}")
print(f"负例得分: {util.cos_sim(q_emb, n_emb)}")

**真实运行结果(政务场景):**Case 1:用户提问“高层次人才购房补贴”

模型正例得分 (购房补贴)负例得分 (购房落户/租房补贴)区分度 (正 - 负)评价
微调前0.910.890.02❌ 极差,几乎分不清,容易搜错
微调后0.820.350.47✅ 完美,一眼就能把干扰项踢开

解惑:为什么微调后正例得分变低了?

细心的朋友会发现:微调前正例是 0.91,微调后怎么变成 0.82 了?模型变傻了吗?

恰恰相反!这是模型变聪明的表现。

•基座模型像个近视眼,看谁都像好人,所以给分都虚高(0.91 vs 0.89)。•微调模型戴上了眼镜,看清了负例其实是“坏人”,把它狠狠推远(0.89 -> 0.35)。为了拉开这个距离,正例的绝对分数自然会回归理性(0.91 -> 0.82)。

记住:RAG 要的是排序(Ranking),只要区分度(Gap)拉大了,微调就是成功的!


总结

通过今天这篇文章,我们没有使用任何黑盒工具,而是从数据挖掘原理到代码落地,彻底跑通了 Embedding 微调。

你会发现,当你把“硬负例”喂给模型后,它仿佛瞬间开窍了,能精准识别那些曾经让它困惑的“行业黑话”。

**下一步做什么?**虽然代码微调很爽,但在大规模工程化场景下,我们可能需要更快捷的工具。下期文章,我将教大家使用 AutoTrain 、FlagEmbedding Runner、Llama Index、ms-swift 体验“一行命令”的多卡训练!


获取本文完整代码(包含数据生成脚本、防OOM训练脚本、对比评估脚本):请在公众号后台回复关键词:【微调实战】

如果内容对您有帮助,欢迎点赞、关注、转发,后期笔者会持续更新优质内容教程。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

后端转大模型应用开发:RAG、Agent、微调、向量库与LLM部署全攻略 大模型应用开发已成为后端技术演进的重要方向。其核心不在于模型本身的训练,而在于如何将LLM与业务系统高效结合——RAG通过引入外部知识库降低幻觉并支持知识更新;Agent让模型具备自主规划与工具调用能力;LoRA微调以少量参数适配领域行为;向量库则承担着文本向量化与相似度检索的关键职责;提示词工程是最低成本的效果优化手段。从企业知识库问答到客服机器人,这些技术共同构成大模型落地的完整链路。理解从文档解析、文本切块、向量检索到生成回答的全流程,掌握llama.cpp、FastAPI等本地部署工具,正是后端工程 阅读详情

相关推荐

基于RAG与本地大模型的配电领域私有知识库构建实战

在数字化转型浪潮中,如何高效管理和利用海量、多格式的非结构化文档(如PDF、Word)是众多企业面临的共同挑战。传统的关键词检索难以理解语义,而大语言模型(LLM)虽具备强大的理解和生成能力,但其通用性可能导致在垂直领域产生“幻觉”或知识滞后。检索增强生成(RAG)技术应运而生,它巧妙地将信息检索与LLM生成相结合,通过从专用向量数据库中实时检索最相关的知识片段来“增强”大模型的回答,从而确保答案的准确性、时效性并保护数据隐私。这项技术在知识密集、对准确性要求高的行业(如**配电运维**、法律、医疗)具有极

weixin_30764883的博客 319

RAG检索总是搜不到?别再死磕Prompt了!手把手教你微调Embedding模型,看这一篇就够了!

通过今天这篇文章,我们没有使用任何黑盒工具,而是从数据挖掘原理到代码落地,彻底跑通了 Embedding 微调。你会发现,当你把“硬负例”喂给模型后,它仿佛瞬间开窍了,能精准识别那些曾经让它困惑的“行业黑话”。**下一步做什么?**虽然代码微调很爽,但在大规模工程化场景下,我们可能需要更快捷的工具。下期文章,我将教大家使用AutoTrainms-swift体验“一行命令”的多卡训练!

weixin_58753619的博客 673

别再折腾虚拟机了!手把手教你用WSL2在Windows 11上安装Kali Linux(含汉化与图形界面)

本文详细介绍了如何在Windows 11上通过WSL2安装和配置Kali Linux,包括汉化与图形界面设置。通过WSL2,用户可以享受接近原生性能的Linux体验,同时保持与Windows系统的无缝集成,特别适合网络安全爱好者和开发者。文章还提供了常见问题解决和性能优化建议,帮助用户高效使用Kali工具集。

weixin_42525369的博客 322

RAG落地关键:微调Embedding模型提升垂直领域召回准确率

Embedding模型是RAG系统语义检索的核心基础,其本质是将文本映射到向量空间以支撑相似性匹配。通用Embedding模型(如bge、e5)在开放语料上训练,缺乏对行业术语、口语化查询和操作性知识关系的建模能力,导致语义漂移与召回偏差。通过对比学习(Contrastive Learning)进行轻量微调,可在不改动RAG架构前提下,精准校准向量空间的相对距离关系,显著提升故障现象描述、设备型号缩写等典型场景的语义匹配精度。该技术已广泛应用于法律、医疗、工业维修等垂直领域知识库,成为RAG从POC走向高可

weixin_33766168的博客 368

IDEA 2023最新破解教程:从安装到永久激活(附常见问题解决方案)

本文为Java开发者提供了一份详尽的IntelliJ IDEA 2023高效使用指南。内容涵盖从版本选择、安装配置到核心快捷键、项目依赖管理、高级调试测试以及插件生态的深度优化。旨在帮助用户在合法合规的前提下,充分发挥这款顶级IDE的潜力,显著提升Java开发效率与工作体验。

time3的博客 3368

广工计组f4b 8位12指令微程序CPU设计实验报告(内含可通过代码以及波形图)

实验目的:模型机是计算机的缩细模型,通过它可以理解计算机整机的结构和功能,理解CPU,存储器,中断控制器,接口的结构及实现逻辑和各部件之前的接口关系。本实验是设计一个8位模型计算机。:一条机器指令可以分解成一个微操作序列,这些微操作是计算机最基本的,不可再细分的操作。:在微程序控制的计算机中。将控制部件向执行部件发出的各种控制命令成为微命令,它是构成控制序列的最小单位。微命令和微操作是一一对应的。微命令是微操作的控制信号,微操作微命令的执行过程。2.:微指令是若干微命令的集合。

weixin_63692154的博客 4705

突破大模型认知边界:RAG (检索增强生成) 底层原理解析与全栈实战

RAG本质上是一个“开卷考试”系统。它将信息检索(Retrieval)与文本生成(Generation)巧妙结合。当用户提出问题时,系统不会直接让大模型凭借记忆去猜答案,而是先去企业私有的知识库中“翻书”,把找到的相关段落连同用户的问题一起丢给大模型,让大模型基于这些既定事实来组织语言作答。RAG 技术成功地在不可靠的生成式 AI 面前筑起了一道“基于事实”的防线,它让 LLM 从一个“容易吹牛的演说家”变成了一个“严谨的开卷考试学霸”。上手路径。

feizuiku0116的博客 2527

手把手实战:RK3588上YOLOv8模型从训练到部署全流程解析

本文详细解析了在RK3588开发板上部署YOLOv8目标检测模型的全流程。从模型训练、正确导出适配的ONNX格式,到使用RKNN-Toolkit2进行模型转换与量化,最后在板卡上完成部署与性能测试。文章提供了完整的代码示例和关键避坑指南,帮助开发者高效实现嵌入式AI应用落地。

weixin_28224217的博客 406

大模型应用岗面试八股核心解析:从Transformer到RAG与Agent落地

在人工智能技术快速迭代的背景下,大模型应用开发已成为热门方向。理解Transformer架构、Token与注意力机制等底层原理,掌握检索增强生成(RAG)的完整链路设计、Agent工具调用与Function Calling机制、LoRA微调选型、推理部署优化等核心技术,是进入该领域的关键。同时,金融等强监管行业对大模型应用的合规性、幻觉治理与数据安全提出了更高要求,相关实践也成为面试中的高频考察点。本文基于大量面经与工程实战,系统梳理大模型应用岗位面试中的核心八股与高频考点,剖析每个问题背后的考察动机、回答

aofan9566的博客 376

UVM(5)-TLM通信

TLM是一种基于事务 (transaction) 的通信方式,通常在高抽象级语言例如SystemC或者SV/UVM中作为模块之间的通讯方式。

2301_76431006的博客 2106

基于高频变压器的隔离式推挽栅极驱动电路

摘要:本文介绍了一种基于高频变压器的隔离式推挽栅极驱动电路,通过变压器实现电气隔离,为功率MOS管提供可靠驱动信号。电路包含输入侧PWM信号处理、变压器磁耦合隔离传输以及副边驱动逻辑等关键部分,利用电阻电容网络控制开关速度并防止误触发。该隔离驱动方案广泛应用于高压开关电源、新能源汽车电机控制器、光伏逆变器和工业变频器等需要高电压隔离及抗干扰能力的电力电子设备中,有效保障系统安全性和可靠性。

qq_37999850的博客 483

从 RAG 到 GraphRAG:智能检索增强演进实战指南

传统RAG只能做“一跳”——查到的文档片段里直接包含答案。问题:“有哪些西班牙的研究人员研究过乳腺癌的免疫治疗药物?研究人员 → 参与的临床试验 → 研究的药物 → 治疗的疾病 → 所在地点传统RAG做不到这种链条式的推理,因为信息分散在不同的文档里。GraphRAG可以在知识图谱上做多跳遍历,从“研究人员”节点出发,一路走到“疾病”节点。GraphRAG不是银弹,它有明确的适用边界。

weixin_46704937的博客 289

知识图谱-构建:知识图谱构建流程【本体构建、知识抽取(实体抽取、 关系抽取、属性抽取)、知识表示、知识融合、知识存储】

旅游领域的类是用来描述旅游的抽象化概念术语,是对众多旅游个体共性的概念化描述。术语是划分类的基础,根据构建领域本体的目标和具体需要,可以确定哪些术语能作为领域本体的类。在以上抽取的众多旅游领域术语中,有些是能直接作为类的,如旅游、人物、交通方式、景区等等,而有些则不能作为类,如票价、景区门票、联系方式等等,它们只是属性。“旅游”很明显是最顶层的类,是父类。然后,要确定旅游的子类,根据大众标签里体现的共性和《中国分类主题词表》确定了旅游领域的11个核心概念,即本体层次结构图数据属性(固有属性)...

u013250861的博客 4万+

RAG系统幻觉问题根治:领域大模型微调实战指南

大语言模型(LLM)在通用任务上表现出色,但其核心原理是基于海量通用语料训练的概率生成模型。当应用于金融、医疗、法律等专业领域时,模型可能因缺乏领域深度理解而产生“幻觉”,即生成看似合理但事实错误的答案。为解决此问题,检索增强生成(RAG)技术通过引入外部知识库来提供事实依据,然而,若生成模型无法精准利用检索到的上下文,问题依然存在。其技术价值在于,通过领域微调,可以显著提升模型对专业知识的忠实生成能力,降低幻觉率。在应用场景上,这尤其适用于构建高可靠性的智能客服、知识库问答和行业分析助手。本文聚焦于**领

weixin_30247781的博客 521

5、卡尔ibration中Denavit - Hartenberg与Hayati约定的转换

本文详细介绍了机器人运动学中Denavit-Hartenberg(DH)参数与Hayati参数的定义、适用场景及其相互转换方法。重点分析了两种参数在描述关节坐标系变换时的差异,特别是在处理平行或接近平行关节轴时的稳定性问题,并给出了从DH到Hayati及反向转换的具体数学公式与流程图。通过参数转换,可在不改变运动学模型的前提下提升建模精度与计算鲁棒性,适用于机器人标定与运动学分析等应用场景。

h0i1j2k3l的博客 121

Data-Structures-and-Algorithm-Analysis-in-Java.pdf

作者: Weiss, Mark A. 出版社: Addison Wesley Data Structures and Algorithm Analysis in Java is an “advanced algorithms” book that fits between traditional CS2 and Algorithms Analysis courses. In the old ACM Curriculum Guidelines, this course was known as CS7. This text is for readers who want to learn good programming and algorithm analysis skills simultaneously so that they can develop such programs with the maximum amo...

收藏!小白程序员轻松入门大模型:RAG技术提升回答准确性全攻略

本文系统讲解了通过RAG技术提升大模型回答准确性的关键步骤,涵盖数据预处理(清洗、向量化、元数据增强)、检索优化(多路召回、重排序、查询扩展)、生成控制(Prompt工程、模型微调)及后处理评估。同时介绍了Self-RAG框架、动态数据更新等高级技巧,为构建可靠RAG系统提供实用指导,助力程序员快速掌握大模型核心技术。

lsf147258369的博客 492

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

30天小白学透大模型:从入门到实战,附收藏版自学路径

2026年技术圈的分化愈发明显:降薪裁员潮持续蔓延,传统开发、测试等岗位大批缩水,不少从业者陷入职业焦虑;与之形成鲜明对比的是,AI大模型相关岗位迎来疯狂扩招,薪资逆势飙升150%,大厂更是直接开出70-100W年薪,疯抢具备实战能力的大模型人才,甚至放宽年龄限制,只求能快速落地技术、创造价值!1、窗口期红利,入门门槛友好:不同于成熟赛道的“内卷式招聘”,2026年大模型人才缺口巨大,简历只要达标(掌握基础AI应用+具备简单项目经验),年龄、学历均非硬性要求,小白可快速入门,转行程序员也能无缝衔接;

m0_48891301的博客 260

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

大模型时代来临!小白程序员如何免费收藏高薪技能,抢占职业先机?

2026年技术圈的分化愈发明显:降薪裁员潮持续蔓延,传统开发、测试等岗位大批缩水,不少从业者陷入职业焦虑;与之形成鲜明对比的是,AI大模型相关岗位迎来疯狂扩招,薪资逆势飙升150%,大厂更是直接开出70-100W年薪,疯抢具备实战能力的大模型人才,甚至放宽年龄限制,只求能快速落地技术、创造价值!1、窗口期红利,入门门槛友好:不同于成熟赛道的“内卷式招聘”,2026年大模型人才缺口巨大,简历只要达标(掌握基础AI应用+具备简单项目经验),年龄、学历均非硬性要求,小白可快速入门,转行程序员也能无缝衔接;

m0_48891301的博客 273

大模型技术入门指南:小白程序员必备,收藏学习轻松掌握AI未来!

随着国家“人工智能+”行动的推进,大模型技术正从通用能力探索转向行业价值兑现的新阶段。文章介绍了AI大模型的技术特点、产业链构成、市场规模以及国内外发展现状,强调中国AI大模型正加速迭代,与海外差距持续缩窄。此外,文章还探讨了行业大模型走向垂直专精的趋势,分析了当前行业大模型发展的五大核心特征和未来五大趋势,指出行业大模型将成为赋能实体经济高质量发展的关键引擎。

大模型研究中心 460

AI Agent招聘市场理性回归:开发者如何构建工程化与垂直领域竞争力

AI Agent(智能体)作为能够感知环境、进行自主决策与执行的软件实体,其核心原理在于整合规划、工具调用、记忆与多步推理能力,以实现复杂任务自动化。这一技术正从概念验证迈向生产落地,其工程化价值体现在构建稳定、可靠且可维护的系统,以应对大模型幻觉、高昂成本与系统集成等挑战。当前,Agent技术的应用场景正聚焦于搜索、客服、内容生成等具体业务领域,通过RAG(检索增强生成)、长程规划等关键技术解决垂直行业痛点。面对市场从狂热到理性的调整,开发者需深化AI工程化能力,掌握向量数据库、模型微调及高可用系统设计,

weixin_34216107的博客 392

大模型机遇与挑战:从支付宝解散团队看Agent时代的前端转型之路(收藏)

2026年技术圈的分化愈发明显:降薪裁员潮持续蔓延,传统开发、测试等岗位大批缩水,不少从业者陷入职业焦虑;与之形成鲜明对比的是,AI大模型相关岗位迎来疯狂扩招,薪资逆势飙升150%,大厂更是直接开出70-100W年薪,疯抢具备实战能力的大模型人才,甚至放宽年龄限制,只求能快速落地技术、创造价值!1、窗口期红利,入门门槛友好:不同于成熟赛道的“内卷式招聘”,2026年大模型人才缺口巨大,简历只要达标(掌握基础AI应用+具备简单项目经验),年龄、学历均非硬性要求,小白可快速入门,转行程序员也能无缝衔接;

m0_48891301的博客 341

基于Transformer与PostgreSQL的向量检索实战:从原理到应用

向量嵌入(Embedding)作为现代机器学习中的核心概念,是将文本、图像等高维数据映射为低维稠密向量的关键技术。其原理通常基于Transformer架构的自注意力机制,能够捕捉数据的深层语义信息。这项技术的核心价值在于,它使得计算机能够理解并比较非结构化数据的语义相似性,从而为智能搜索、推荐系统、问答机器人等应用场景提供了基础。在实际工程中,如何高效存储和检索这些向量成为关键挑战。PostgreSQL结合pgvector扩展,提供了成熟的关系型数据库向量解决方案,支持近似最近邻搜索,有效解决了海量向量数据

424

Embedding实战指南:从原理到部署的NLP物理接口详解

Embedding是自然语言处理中将离散符号映射为稠密向量的核心机制,其本质是低秩矩阵分解驱动的语义坐标系构建过程。它不仅决定词义相似性计算的准确性,更直接影响RAG检索质量、长文本建模能力与多模态对齐效果。在工程实践中,embedding层的设计选择——如位置编码类型(绝对vs旋转)、tokenizer空格处理逻辑、padding向量初始化方式——会直接引发梯度爆炸、向量空间错位或显存溢出等典型故障。本文聚焦真实项目中的embedding全链路问题,涵盖Hugging Face tokenizer陷阱、R

weixin_33682790的博客 349

从零构建AI应用:提示词、RAG与Agent实战指南

大模型技术正从实验性Demo走向大规模生产落地,如何将模型能力封装成稳定、低成本的业务应用,成为开发者关注的核心议题。本文从工程视角切入,系统探讨AI应用开发中的基础概念与关键技术:提示词工程通过结构化指令降低输出不确定性,RAG借助外部知识库解决私有数据问答需求,Agent则以Function Calling机制驱动模型调用外部工具完成复杂任务。这些技术相互补充,共同构成了现代AI应用的基础架构。在应用场景中,无论是企业内部知识库问答、自动化业务助手,还是智能客服系统,均依赖上述能力组合。文章进一步给出完

weixin_34357436的博客 484

LLM增强搜索:RAG+Agent协同实现语义理解与可信问答

搜索技术正从关键词匹配迈向意图驱动的语义理解阶段。其核心原理在于融合大语言模型(LLM)的深度推理能力、检索增强生成(RAG)的事实锚定机制,以及智能体(Agent)的任务规划能力,形成可解释、可追溯、支持多轮上下文的新型信息获取范式。该技术显著提升专业场景下的答案准确性与决策可信度,广泛应用于法律合规查询、医疗文献分析、企业知识管理及工业故障诊断等对事实性与可验证性要求严苛的领域。本文聚焦LLM-enhanced search落地实践,深入解析RAG数据治理与Agent任务编排两大关键热词的工程实现路径。

402
上一篇: LangChain 入门,从构建第一个智能体开始
下一篇: Langchain-Chatchat大语言模型本地知识库的踩坑、部署、使用
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
