大模型微调工具 XTuner 指令微调实战复杂吗?这里有门道……

XTuner 微调个人小助手认知实战 ​ 本次实践是在InternStudio平台上,运用XTuner工具来微调InterLM2-Chat-1.8B模型,实现模型身份认证问题的解决。具体来说,如下图,让模型在回答自身身份问题的时候,加入你想要的信息。 ​ 阅读详情

一、XTuner简介

XTuner 是由上海 AI 实验室的 InternLM 团队推出的一款轻量化大模型微调工具库,支持大语言模型和多模态图文模型的预训练及轻量级微调。以下是其特点:

高效:仅需 8GB 显存即可微调 7B 模型,支持多节点跨设备微调 70B + 大模型。通过自动分发 FlashAttention、Triton kernels 等高性能算子加速训练,兼容 DeepSpeed,能轻松应用 ZeRO 优化策略提升训练效率。

灵活:兼容 InternLM、Llama 2、ChatGLM,QWen,DeepSeek 等多种主流大语言模型和 LLaVA 多模态图文模型,支持预训练与微调。数据管道设计灵活,兼容任意数据格式,支持 QLoRA、LoRA 及全量参数微调等多种算法。

全能:支持增量预训练、指令微调与 Agent 微调,提供丰富的开源对话模板便于与模型交互。训练所得模型可无缝接入部署工具库 LMDeploy、评测工具库 OpenCompass 及 VLMEvalKit,实现从训练到部署的全流程支持。

官网文档:

https://xtuner.readthedocs.io/zh-cn/latest/index.html

github地址:

https://github.com/InternLM/xtuner

二、安装

我们推荐用户参照官方的最佳实践安装 XTuner。 推荐使用 Python-3.10 的 conda 虚拟环境安装 XTuner。

步骤 1. 使用 conda 先构建一个 Python-3.10 的虚拟环境

conda create --name xtuner-env python=3.10 -y
conda activate xtuner-env

步骤 2. 安装 XTuner

一般来说,我们都需要调整数据集、配置文件和训练模型,所以需要下载源码安装

git clone https://github.com/InternLM/xtuner.git
cd xtuner
pip install -e '.[deepspeed]'

步骤3.验证是否安装成功

为了验证 XTuner 是否安装正确,我们将使用命令打印配置文件。

打印配置文件: 在命令行中使用 xtuner list-cfg 验证是否能打印配置文件列表。

xtuner list-cfg

三、XTuner数据集

大语言模型 Supervised Finetune(SFT)旨在通过有监督的微调来提高预训练模型在特定任务上的性能。为支持尽可能多的下游任务,XTuner 支持了增量预训练、单轮对话、多轮对话三种数据集格式。

  • 增量预训练数据集用于提升模型在特定领域或任务的能力。
  • 单轮对话和多轮对话数据集则经常用于指令微调(instruction tuning)阶段,以提升模型回复特定指令的能力。

为了统一增量预训练、单轮对话和多轮对话三种数据集格式,我们将数据集格式设置为以下形式:

[{
"conversation":[
{
"system": "xxx",
"input": "xxx",
"output": "xxx"
}
]
},
{
"conversation":[
{
"system": "xxx",
"input": "xxx",
"output": "xxx"
},
{
"input": "xxx",
"output": "xxx"
}
]
}]

四、XTuner配置文件

1、查看XTuner支持哪些大模型

看源码就可以看到XTuner支持哪些大模型了。目录路径:xtuner/xtuner/configs
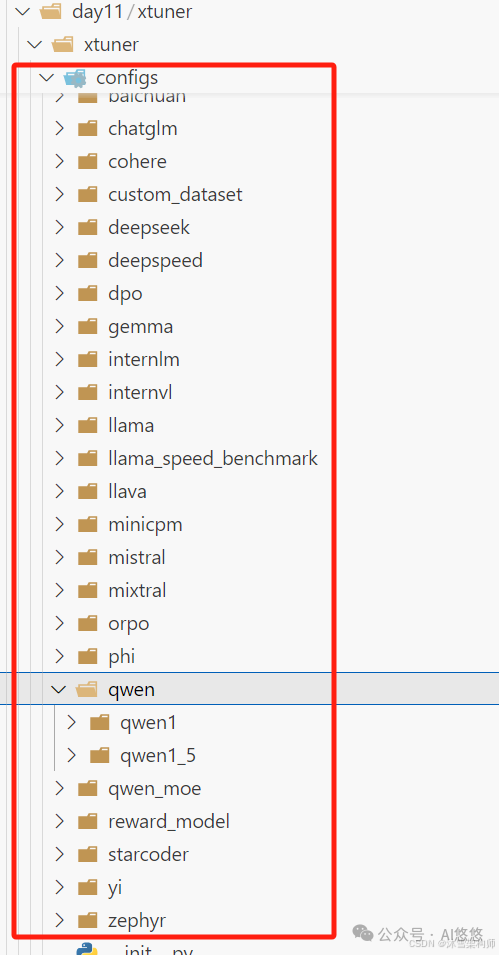
从上图可以看到XTuner支持了很多大模型,若没有列出,则表明不支持。XTuner支持目前主流的大模型,比如qwen,llama,deepseek,chatglm等。

2、查看XTuner对大模型微调的配置文件

拿qwen1.5-1.8b模型来说,XTuner对该模型微调的配置文件是:xtuner/xtuner/configs/qwen/qwen1_5/qwen1_5_1_8b_chat/qwen1_5_1_8b_chat_qlora_alpaca_e3.py 。
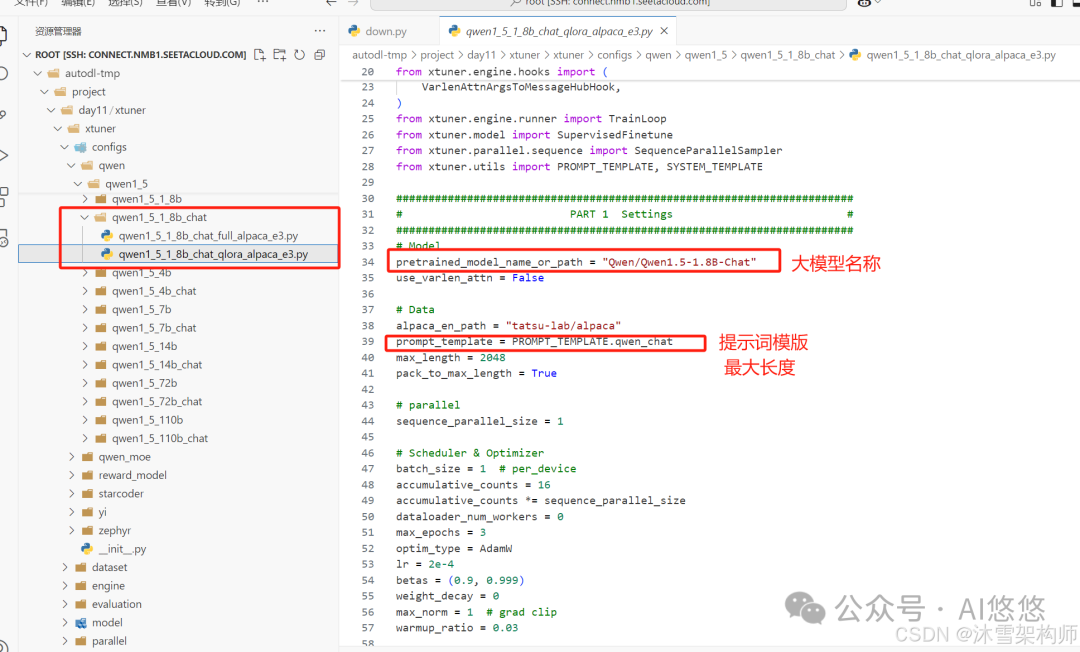
常用的参数有:

(1)大模型名称:pretrained_model_name_or_path

(2)提示词模版:prompt_template

(3)数据集最大长度:max_length

(4)是否检查他的最大长度:pack_to_max_length

(5)优化器相关配置:

# Scheduler & Optimizer
batch_size = 1  # per_device
accumulative_counts = 16
accumulative_counts *= sequence_parallel_size
dataloader_num_workers = 0
max_epochs = 3
optim_type = AdamW
lr = 2e-4
betas = (0.9, 0.999)
weight_decay = 0
max_norm = 1  # grad clip
warmup_ratio = 0.03

batch_size:批处理大小,超参数,需要根据你服务器的配置,尝试运行几次,找到资源利用率最高的数值。

max_epochs:最大训练轮数,至少300。

(6)保存的相关配置:

# Save
save_steps = 500
save_total_limit = 2  # Maximum checkpoints to keep (-1 means unlimited)
save_steps:保存间隔,500个 ;save_total_limit:最大保存 checkpoint 个数,-1 表示无限制

(7)验证测试:

# Evaluate the generation performance during the training
evaluation_freq = 500
SYSTEM = SYSTEM_TEMPLATE.alpaca
evaluation_inputs = ["请给我介绍五个上海的景点", "Please tell me five scenic spots in Shanghai"]

evaluation_freq: 验证对话效果频率,与保存间隔保持一致即可。

evaluation_inputs:验证对话效果时测试问题。一般是从数据集中找一些有代表性的input数据。

(8)LoRA 配置

model = dict(   # 构建 model
type=SupervisedFinetune,   # 指令跟随微调
use_varlen_attn=use_varlen_attn,
llm=dict( # LLM
type=AutoModelForCausalLM.from_pretrained,
pretrained_model_name_or_path=pretrained_model_name_or_path,
trust_remote_code=True,
torch_dtype=torch.float16,
quantization_config=dict(  # 量化配置
type=BitsAndBytesConfig,
load_in_4bit=True,
load_in_8bit=False,
llm_int8_threshold=6.0,
llm_int8_has_fp16_weight=False,
bnb_4bit_compute_dtype=torch.float16,
bnb_4bit_use_double_quant=True,
bnb_4bit_quant_type="nf4",
),
),
lora=dict(   # LoRA 配置
type=LoraConfig,
r=64,
lora_alpha=16,
lora_dropout=0.1,
bias="none",
task_type="CAUSAL_LM",
),
)

load_in_4bit=True:默认是4位的QLoRA微调,若需要8位的QLoRA,则 load_in_4bit=False并且load_in_8bit=True。

若不需要启动QLoRA则需要注释掉:

-       quantization_config=dict(
-           type=BitsAndBytesConfig,
-           load_in_4bit=True,
-           load_in_8bit=False,
-           llm_int8_threshold=6.0,
-           llm_int8_has_fp16_weight=False,
-           bnb_4bit_compute_dtype=torch.float16,
-           bnb_4bit_use_double_quant=True,
-           bnb_4bit_quant_type='nf4')

五、XTuner指令微调实战

1、下载大模型

我们拿Qwen1.5-1.8B-Chat来做测试,从魔塔社区下载模型的代码:

#模型下载
from modelscope import snapshot_download
model_dir = snapshot_download('Qwen/Qwen1.5-1.8B-Chat',cache_dir="/root/autodl-tmp/llm")

保存到路径:/root/autodl-tmp/llm下。

2、制作数据集

将我们制作好的数据集传到服务器上,我们一般放 XTuner源码data目录里(没有则创建该目录)。

3、复制配置文件

一般我们会保留XTuner的原始配置文件,将配置文件复制一份放其根目录下。比如将xtuner/xtuner/configs/qwen/qwen1_5/qwen1_5_1_8b_chat/qwen1_5_1_8b_chat_qlora_alpaca_e3.py复制到xtuner根目录。
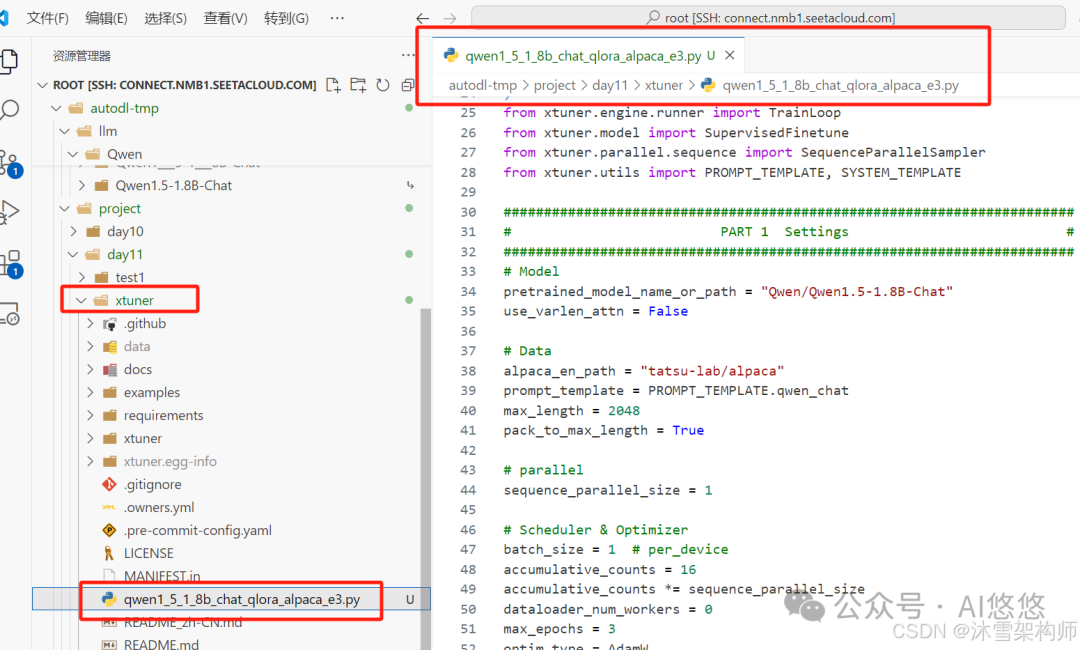
该配置虽然是qwen1.5版本,其实也可以用作qwen2.5 。

4、修改配置文件

PART 1中

### PART 1中
#预训练模型存放的位置
pretrained_model_name_or_path = "/root/autodl-tmp/llm/Qwen/Qwen1.5-1.8B-Chat"
#微调数据存放的位置
#alpaca_en_path = "tatsu-lab/alpaca"
data_files = '/root/autodl-tmp/project/day11/xtuner/data/target_data.json'#基座模型路径
# 训练中最大的文本长度
max_length = 512
# 每一批训练样本的大小
batch_size = 10
#最大训练轮数
max_epochs = 1000
#验证数据
evaluation_inputs = ["只剩一个心脏了还能活吗?", "爸爸再婚,我是不是就有了个新娘?","马上要上游泳课了,昨天洗的泳裤还没干,怎么办"]

PART 2中

lora=dict(
type=LoraConfig,
r=64,
lora_alpha=128,  # 修改这个值,这个值一般是r的2倍
lora_dropout=0.1,
bias="none",
task_type="CAUSAL_LM",
),

PART 3中

dataset=dict(type=load_dataset, path="json",data_files=data_files)
dataset_map_fn=None

我们的数据集是一个json文件,所以path改为json,data_files指定json文件绝对路径的标量。并且将dataset_map_fn设置为None。

5、执行微调训练指令

在当前目录下,输入以下命令启动微调脚本。

xtuner train  qwen1_5_1_8b_chat_qlora_alpaca_e3.py

6、训练过程确认

执行微调训练指令成功后,将 xtuner/work_dirs/ 目录下看到执行的内容。
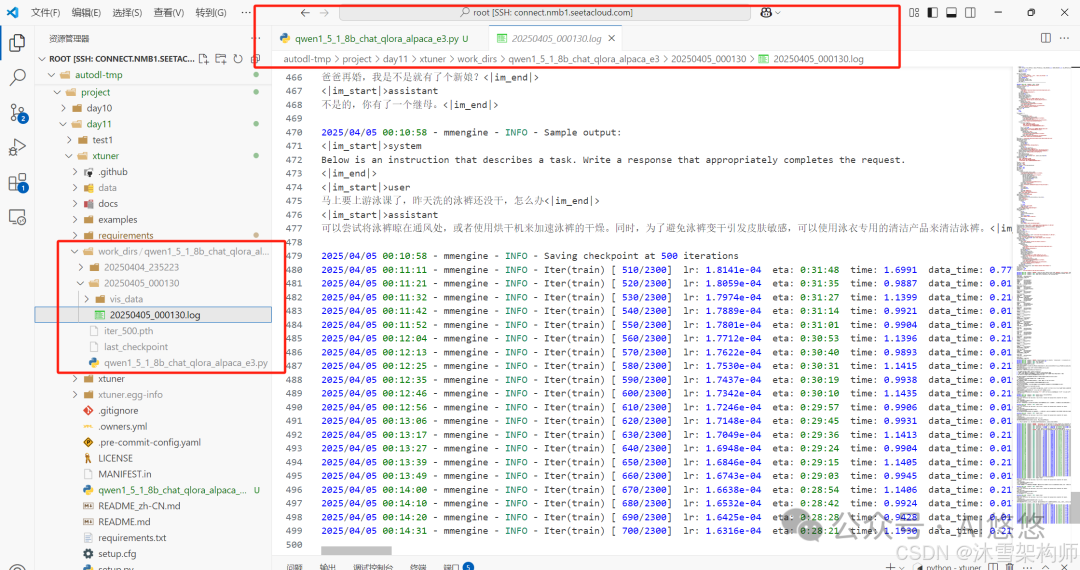

下一篇我们将对微调后的模型进行模型转换和合并等重要实战操作。

想入门 AI 大模型却找不到清晰方向?备考大厂 AI 岗还在四处搜集零散资料?别再浪费时间啦!2025 年 AI 大模型全套学习资料已整理完毕,从学习路线到面试真题,从工具教程到行业报告,一站式覆盖你的所有需求,现在全部免费分享!

👇👇扫码免费领取全部内容👇👇

​

一、学习必备:100+本大模型电子书+26 份行业报告 + 600+ 套技术PPT,帮你看透 AI 趋势

想了解大模型的行业动态、商业落地案例?大模型电子书?这份资料帮你站在 “行业高度” 学 AI:

1. 100+本大模型方向电子书

在这里插入图片描述

2. 26 份行业研究报告:覆盖多领域实践与趋势

报告包含阿里、DeepSeek 等权威机构发布的核心内容,涵盖:

  • 职业趋势:《AI + 职业趋势报告》《中国 AI 人才粮仓模型解析》;
  • 商业落地:《生成式 AI 商业落地白皮书》《AI Agent 应用落地技术白皮书》;
  • 领域细分:《AGI 在金融领域的应用报告》《AI GC 实践案例集》;
  • 行业监测:《2024 年中国大模型季度监测报告》《2025 年中国技术市场发展趋势》。

3. 600+套技术大会 PPT:听行业大咖讲实战

PPT 整理自 2024-2025 年热门技术大会,包含百度、腾讯、字节等企业的一线实践:

在这里插入图片描述

  • 安全方向:《端侧大模型的安全建设》《大模型驱动安全升级(腾讯代码安全实践)》;
  • 产品与创新:《大模型产品如何创新与创收》《AI 时代的新范式:构建 AI 产品》;
  • 多模态与 Agent:《Step-Video 开源模型(视频生成进展)》《Agentic RAG 的现在与未来》;
  • 工程落地:《从原型到生产:AgentOps 加速字节 AI 应用落地》《智能代码助手 CodeFuse 的架构设计》。

二、求职必看:大厂 AI 岗面试 “弹药库”,300 + 真题 + 107 道面经直接抱走

想冲字节、腾讯、阿里、蔚来等大厂 AI 岗?这份面试资料帮你提前 “押题”,拒绝临场慌!

1. 107 道大厂面经:覆盖 Prompt、RAG、大模型应用工程师等热门岗位

面经整理自 2021-2025 年真实面试场景,包含 TPlink、字节、腾讯、蔚来、虾皮、中兴、科大讯飞、京东等企业的高频考题,每道题都附带思路解析:

2. 102 道 AI 大模型真题:直击大模型核心考点

针对大模型专属考题,从概念到实践全面覆盖,帮你理清底层逻辑:

3. 97 道 LLMs 真题:聚焦大型语言模型高频问题

专门拆解 LLMs 的核心痛点与解决方案,比如让很多人头疼的 “复读机问题”:


三、路线必明: AI 大模型学习路线图,1 张图理清核心内容

刚接触 AI 大模型,不知道该从哪学起?这份「AI大模型 学习路线图」直接帮你划重点,不用再盲目摸索!

在这里插入图片描述

路线图涵盖 5 大核心板块,从基础到进阶层层递进:一步步带你从入门到进阶,从理论到实战。

img

L1阶段:启航篇丨极速破界AI新时代

L1阶段:了解大模型的基础知识,以及大模型在各个行业的应用和分析,学习理解大模型的核心原理、关键技术以及大模型应用场景。

img

L2阶段:攻坚篇丨RAG开发实战工坊

L2阶段:AI大模型RAG应用开发工程,主要学习RAG检索增强生成:包括Naive RAG、Advanced-RAG以及RAG性能评估,还有GraphRAG在内的多个RAG热门项目的分析。

img

L3阶段:跃迁篇丨Agent智能体架构设计

L3阶段:大模型Agent应用架构进阶实现,主要学习LangChain、 LIamaIndex框架,也会学习到AutoGPT、 MetaGPT等多Agent系统,打造Agent智能体。

img

L4阶段:精进篇丨模型微调与私有化部署

L4阶段:大模型的微调和私有化部署,更加深入的探讨Transformer架构,学习大模型的微调技术,利用DeepSpeed、Lamam Factory等工具快速进行模型微调,并通过Ollama、vLLM等推理部署框架,实现模型的快速部署。

img

L5阶段:专题集丨特训篇 【录播课】

img
四、资料领取:全套内容免费抱走,学 AI 不用再找第二份

不管你是 0 基础想入门 AI 大模型,还是有基础想冲刺大厂、了解行业趋势,这份资料都能满足你!
现在只需按照提示操作,就能免费领取:

👇👇扫码免费领取全部内容👇👇

​

2025 年想抓住 AI 大模型的风口?别犹豫,这份免费资料就是你的 “起跑线”!

XTuner 微调个人小助手认知任务 微调完成后,我们可以再次运行 xtuner_streamlit_demo.py 脚本来观察微调后的对话效果,不过在运行之前,我们需要将脚本中的模型路径修改为微调后的模型的路径。模型转换的本质其实就是将原本使用 Pytorch 训练出来的模型权重文件转换为目前通用的 HuggingFace 格式文件,那么我们可以通过以下命令来实现一键转换。对于全量微调的模型(full)其实是不需要进行整合这一步的,因为全量微调修改的是原模型的权重而非微调一个新的 Adapter ,因此是不需要进行模型整合的。 阅读详情

相关推荐

大模型微调终极方案:LoRA、QLoRA原理详解与LLaMA-Factory、Xtuner实战对比

微调(Fine-tuning)是深度学习中一种利用预训练模型进行特定任务优化的方法,旨在提升模型在特定任务上的性能。微调步骤包括加载预训练模型、修改模型结构、设置优化器和损失函数、训练模型及评估性能。微调场景涵盖修改模型输出层、自我认知及对话风格等。微调方法主要分为增量微调、局部微调和全量微调,各方法在参数调整范围、显存需求、训练速度及效果等方面有所不同。微调技术如LoRA和QLoRA通过引入低秩矩阵和量化技术,减少参数数量和计算成本,适用于资源有限或内存要求苛刻的场景。微调框架如LLaMA-Factory

冷不丁 2262

XTuner 低成本微调实战

本文介绍了xtuner的入门和上手教程,包括理论和实战两部分,本文重点在理论部分。在理论部分,详细介绍了微调框架xtuner以及微调的工作流程。

George_han的博客 2783

当LightGBM推理遇上GPU:3种替代方案性能对比(含ONNX实战代码)

本文针对LightGBM官方不支持GPU推理的性能瓶颈,深度评测了RAPIDS cuML、ONNX Runtime GPU和Triton Inference Server三种GPU加速推理替代方案。通过详尽的性能对比和实战代码,为高并发、低延迟的在线预测场景提供了清晰的选型指南,帮助工程师打破推理性能枷锁,实现显著的吞吐量提升。

salt9的博客 813

【InternLM】XTuner微调LLM

LLM大模型的参数量以B(10亿)为单位,动辄迁百亿、千亿。如何在已经训练好的、性能优异的底座模型基础上,通过微调的方式,来实现对模型的性能优化、知识注入、领域迁移和风格对齐等调整,是一件非常有使用场景的工作。Xtuner是上海人工智能实验室推出的用于LLM微调的一站式工具,其:1)模型方面:支持InternLM、Qwen、Baichuan、ChatGLM等国内主流开源大模型,以及Llama、Mixtral和Gemma等国外优秀开源大模型;

guofei_fly的博客 2356

农业杂草检测——棉花杂草数据集

然后将本层13×13的特征图谱经过×2上采样扩充到26×26,并与上层中26×26的特征图谱拼接,得到新的26×26的特征图谱,在该特征尺度上进行第二次预测,此时得到的特征图谱是相对输入图像16倍下采样,具有中尺度感受野,适合检测中等尺度对象;通过目标检测,能够及时清除杂草,减少病虫害的滋生和传播,保障棉花的健康生长,并有助于降低生产成本。对于地膜覆盖的棉田,由于膜内耕作层土温高、底墒好,杂草出苗早而集中,一般覆膜后5 - 7天杂草陆续出土,在墒情好的情况下,15天左右即形成出土高峰。

qq_38220914的博客 1247

matlab电偶极子源码,电偶极子的MATLAB场模拟

电偶极子周围电场电势分布的MATLAB三维模拟Matlab可以用于模拟四维场的效果,本文以电偶极子的电场和电势场为例展示MATLAB在该方面领域的应用。摘要电偶极子由一个正电荷和一个负电荷组成,其电场和空间电势分布与单电荷相比具有一些重要的特性。本文将给出电场和电势场的近似表达式。这两个量的精确表达式是复杂的,不太常用,因此 MATLAB 被采用来操作精确值和绘制三维分布的远区域, 近区域和一侧区...

weixin_35135480的博客 3150

Xtuner 大模型训练入门小记:从配置到微调

大模型虽强,但让它适配特定场景总需额外“调教”——传统微调对算力和技术要求之高,常让人望而却步。​Xtuner 的诞生,正是为了解决这一痛点。它用极简的配置文件和自动化流程,将数据清洗、训练优化等复杂步骤“藏”在背后。无论你是想快速验证一个模型能力,还是为业务定制专属AI助手,只需几行命令,即可在有限资源下轻松启动训练。本文抛开冗长理论,专注“最小可行步骤”,助你30分钟内跑通第一个微调实验。Xtuner官方文档。

lucassu的博客 2632

无需UMAT:基于Abaqus内置模型实现形状记忆聚合物结构的热-力耦合仿真

本文详细介绍了如何利用Abaqus内置模型实现形状记忆聚合物(SMP)的热-力耦合仿真,无需编写复杂的UMAT子程序。通过广义Maxwell模型和Neo-Hookean模型的组合应用,结合完整的热-力耦合分析流程,帮助工程师高效模拟SMP的形状记忆行为。文章还提供了工程应用案例和常见问题解决方案,为相关领域的研究和设计提供实用指导。

weixin_34005090的博客 117

书生·浦语大模型——XTuner大模型单卡微调实战

增量预训练微调:让基座模型学习到一些新知识,如某个垂类领域的常识指令跟随微调:让模型学会对话模板,根据人类指令进行对话。

Yogffee的博客 1656

环境仿真软件:MIKE 21_(9).MIKE21水生植物模块介绍

MIKE21支持多种水生植物的模拟,用户需要在配置文件中定义植物种类及其特性。</</</</</</</</</假设我们需要定义一种新的水生植物“水葫芦”(Water Hyacinth),并将其特性写入配置文件。# 创建XML根元素# 定义新的植物种类# 生成XML文件假设我们需要分析仿真的水流速度变化,并绘制水流速度随时间变化的图。# 读取NetCDF文件# 获取水流速度数据# 获取时间数据# 绘制水流速度随时间变化的图plt.xlabel('时间 (天)')

kkchenjj的博客 727

Modbus协议学习第一篇之基础概念

因工作需要而接触Modbus,正在恶补知识,利用博客的方式来加深理解和记忆,同时希望同行大佬能一起交流。

hzf978742221的博客 881

XTuner 大模型单卡低成本微调实战

LLM的下游应用任务中,增量预训练和指令跟随是经常会用到的两种微调模式适配多种生态多种微调算法:多种微调策略与算法,覆盖各类SFT场景适配多种开源生态:支持加载HuggingFace、ModelScope模型或数据集自动优化加速:开发者无需关注复杂的显存优化与计算加速细节适配多种硬件训练方案覆盖NVIDIA20系以上所有显卡最低只需8GB显存即可微调7B模型。

qq_42866033的博客 1055

Centos 7 Linux 安装 JDK 8:下载、安装、配置环境变量、验证

本文详细介绍了在 CentOS 7 系统上手动安装 JDK 8 的完整流程,包括环境准备、JDK 安装包下载与上传、解压安装、配置全局环境变量,以及最终的验证步骤。适用于使用 VMware 虚拟机、云服务器或物理机的 CentOS 7 用户,操作清晰、步骤完整,帮助开发者快速搭建 Java 开发环境。

寒水馨 · 轻量级技术文档 · hanshuixin.org 2584

【书生大模型实战营(暑假场)】基础任务四 XTuner微调个人小助手认知

在我们的输入的这个命令中,我们的 CONFIG 对应的是上面搜索到的 internlm2_chat_1_8b_qlora_alpaca_e3 ,而 SAVE_PATH 则是当前目录 .。:指定了用于训练的模型和分词器的具体类型及其配置,包括预训练模型的路径和是否启用特定功能(如可变长度注意力),这是模型训练的核心组成部分。全量微调的模型(full fine-tuning)直接修改原模型的权重,并没有微调一个新的 Adapter,不需要进行模型整合的。三个路径即可实现快速的模型合并。

Tongcheng_98的博客 1413

RK3588高速接口实战-PCIE

摘要: RK3588的PCIe接口支持PCIe 3.0x4和PCIe 2.1x1/x2,具备Root Complex和Endpoint模式,适用于NVMe SSD、5G模块等高速设备。硬件设计需注意85Ω/100Ω阻抗匹配、220nF AC耦合电容及100MHz参考时钟。设备树需配置控制器节点、PHY模式和IOMMU映射(RC模式用iommu-map,EP模式用iommus)。调试时可通过lspci检查链路状态,dmesg查看训练日志,perf分析性能。常见问题包括设备识别失败(检查复位时序、PHY配置)、

weiyvyy的博客 505

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

笔记--XTuner大模型单卡低成本微调实战

直接加载 Adapter 模型对话,可以看到机器人的名字变成了 ‘Open Assistant’4 bit 量化加载,与直接加载 Adapter 模型对话效果差不多。注意最好还是多训练几个轮次,否则很可能因为训练不充分导致,输出错误。如微调前:机器人只知道自己是一个“AI Assistant”基于 InternLM-chat-7B 模型,用 MedQA 数据集进行微调,将其往医学问答领域对齐。数据集格式如下:之后,使用格式化数据集,使用划分训练集和测试集。

donotpython的博客 1259

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

XTuner 微调实践 | 书生大模型

在 XTuner 中提供了一键合并的命令 xtuner convert merge,在使用前我们需要准备好三个路径,包括原模型的路径、训练好的 Adapter 层的(模型格式转换后的)路径以及最终保存的路径。对于 LoRA 或者 QLoRA 微调出来的模型其实并不是一个完整的模型,而是一个额外的层(Adapter),训练完的这个层最终还是要与原模型进行合并才能被正常的使用。脚本来观察微调后的对话效果,不过在运行之前,我们需要将脚本中的模型路径修改为微调后的模型的路径。表示合并后的模型最终的保存路径。

qq_45931691的博客 1221

老版QQ原生表情gif动态

这是老版的QQ表情,不过全是动态的的,Windows照片查看器是不会动的,可以右击用浏览器打开查看,再说一遍是老版的,只是分享给宁愿用老版也要动态的人。

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

书生大模型实战营闯关 - 基础岛 - XTuner 微调大模型个人小助手认知

使用 Xtuner 微调个人小助手认知。通过微调,我们可以让大模型学识到垂直领域的专业知识,让大模型成为一个垂类大模型。在往期的实战营当中,通过微调已经诞生出了很多优秀的项目。那么在本次的实战营当中,也希望大家能够开发出更多的优秀的作品。接下来,我将通过三个部分来完成本节课的内容。首先,我们来介绍一下闯关任务。接下来,我们简单的介绍一下 Xtuner。最后,我们亲自动手实战,来完成小助手的微调。先来看一下闯关任务。

nachtmusik的博客 1150

InternLM: 基础岛 - XTuner 微调

LoRA(Low-Rank Adaptation)是一种使用低精度权重对大型预训练语言模型进行微调的技术,它的核心思想是在不改变原有模型权重的情况下,通过添加少量新参数来进行微调。这种方法降低了模型的存储需求,也降低了计算成本,实现了对大模型的快速适应,同时保持了模型性能。然而,由于使用了低精度权重,LoRA 的一个潜在的缺点是在微调过程中可能会丢失一些原始模型的高阶特征信息,因此可能会降低模型的准确性。QLoRA(Quantized LoRA)微调技术是对 LoRA 的一种改进,它通过引入高精度权重和。

dilvx的博客 1663

[书生浦语] 大模型实战:XTuner 微调 LLM : 1.8B

在本节中主要就是带领着大家跑通了 XTuner 的一个完整流程,通过了解数据集和模型的使用方法、配置文件的制作和训练以及最后的转换及整合。那在后面假如我们也有想要微调出自己的一个模型,我们也可以尝试使用同样流程和方法进行进一步的实践!

mycomin的博客 1488

[书生·浦语大模型实战营]——XTuner 大模型单卡低成本微调

在未经过微调的pretrained LLM中,模型只会尽量去拟合你的输入,也就是说模型并没有意识到你在提问,因此需要微调来修正。1.安装2.挑选配置模板3.一键训练Config的命名规则4.模型对话Float 16模型对话或4bit模型对话加载Adapter模型对话5.工具类模型对话XTuner还支持工具类模型的对话。

qq_41776136的博客 1259

XTuner 微调个人小助手 第四课实战

1.XTuner简介傻瓜化:以配置文件的形式封装了大部分微调场景,0基础的非专业人员也能一键开始微调轻量化:对于7B参数的LLM,微调所需最小显存为8G:消费级显卡、colab多生态支持:XTuner支持HuggingFace和ModelScope的模型和数据集,提供了丰富的模型资源和数据集。硬件适配:支持NVIDIA 20系以上显卡,最低8GB显存即可运行,极大降低了硬件门槛。多种微调算法:包括LoRA、QLoRA等,可以根据具体需求选择最适合的微调算法。显存和计算优化。

weixin_62638966的博客 2240

Xtuner:大模型微调快速上手

XTuner是由上海人工智能实验室开发的大语言模型微调工具库,具有轻量易用、配置驱动、高效灵活等特点。它支持多种微调算法(如LoRA、QLoRA)和主流大模型,通过简单的命令行操作和配置文件即可完成微调流程。XTuner集成FlashAttention等优化技术,与LMDeploy、OpenCompass形成完整解决方案。用户可通过内置配置快速上手,如使用QLoRA微调InternLM2-1.8B模型,只需准备数据、选择配置、启动训练、合并权重四步。XTuner简化了大模型微调流程,是开发者快速实现模型定制

m0_57280180的博客 906
上一篇: 让 Agent 说“机器能懂的话”——LlamaIndex 构建 Agent 的结构化输出策略
下一篇: 从零开始:手把手教你微调Embedding模型,让检索效果提升10倍
AI_小站
博客等级 码龄3年 6255粉丝 1153原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值
