


本地大模型部署和基于RAG方案的私有知识库搭建
01
背景与目的
在人工智能领域,大语言模型如GPT系列、BERT等,以其强大的语言生成与理解能力,正在深刻改变着我们的工作与生活方式[1]。这些模型通过海量数据训练而成,能够执行从文本生成、问答系统到代码编写等多种任务。然而,由于这些模型往往部署于云端,这不禁引发人们对隐私保护、数据安全的担忧[2]。企业与研究机构开始寻求在本地环境部署大模型的方法[3],同时构建专属的私有知识库,以实现更高程度的控制和灵活性。
本地大模型部署与私有知识库的搭建旨在解决这一难题,为个体用户和企业提供一种既能利用先进AI技术,又能确保数据安全、合规使用的解决方案。通过在本地环境部署大模型,并构建专属的知识库,个体用户和企业能够在保护核心数据资产的同时,定制化地提升工作效率和加快数字化转型的步伐。
02
基本概念
01
RAG方案
全称检索增强生成(Retrieval-Augmented Generation),RAG模型通过在生成答案时检索外部信息(如个人笔记或特定数据集),来提供更加丰富和准确的响应。它的基本原理可以用下图来表示:
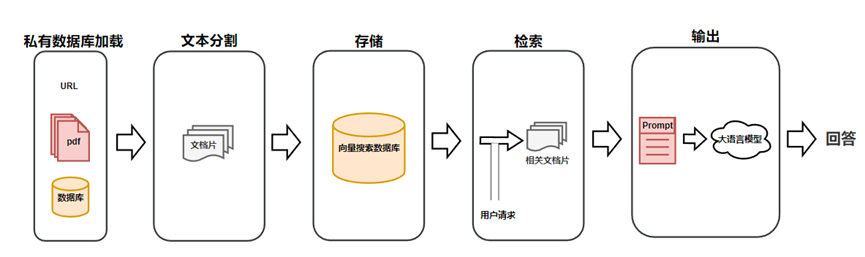
RAG基本原理
下面介绍RAG处理流程,分为向量搜索数据库制作环节和检索环节。
在向量搜索数据库制作环节中,首先从多种来源加载文档,如网页链接URL,PDF文档,数据库等,然后通过文本分割器将文档切分为指定大小的文档片,文档片会由文本嵌入模型转换为数值向量,存储到向量搜索数据库中。
在检索环节中,用户的请求会由文本嵌入模型转换为数值向量,并在向量搜索数据库中检索相似度超过阈值的数值向量,从而提取相关的文档片。相关文档片和用户请求将一并优化成Prompt,最后输入至大模型中推理获得回答。
02
私有知识库
个人可以建立并维护自己的知识库,其中可能包括个人学习材料、项目文档等,这些数据将直接支持RAG模型的检索和生成过程。
03
向量搜索数据库
为了支持快速检索,私有数据库通过文本分割切分成指定大小的块,然后进行向量转换,从而存储到向量搜索数据库。
03
本地部署大模型与RAG方案的优势
保护隐私
本地部署最显著的优势之一是增强数据隐私保护。个人用户处理敏感信息,如个人日记、财务记录或健康数据时,本地模型确保这些数据不离开用户的个人设备,不经过外部服务器,从而避免潜在的数据泄露和滥用风险。这使得需要处理高度敏感信息的用户既能享受大模型带来的便利,也能很好地保护个人敏感数据,不必担心隐私问题。
高度定制
与云服务的标准化模型相比,本地部署的RAG模型提供了更高程度的定制选项。用户可以建立和维护自己的私有知识库,还可以根据个人的具体需求调整模型的参数。例如,一个程序员可能会调整模型以更好地理解编程语言的语境,或者一个作家可能希望模型生成特定风格的文本。这种定制能力让用户能够优化模型的输出,以符合用户的特定需求和偏好。
成本效益
本地部署的模型可以避免持续的云服务订阅费用,用户无需支付额外的数据存储或处理费用,可以自由使用模型而无须担心超出预算。除此之外,相比于纯粹的大语言模型,RAG可以通过检索外部知识来“借用”信息,而不是全部依赖于内在存储,这在一定程度上减轻了对大模型训练数据量的需求,降低了资源消耗和成本。
离线可用性
相比于依赖云服务的大语言模型,本地部署的模型无需持续的网络连接即可运行。即使在网络连接不稳定或完全断开,用户也能继续使用AI模型进行数据处理和决策支持。此外,离线运行减少了因云服务故障而导致的数据丢失和服务中断的风险。
回答准确且透明
RAG模型通过结合检索和生成的方法,能够在回答问题时引入外部的、事实性的信息,这有助于生成更精确、信息量更丰富的文本。另外由于回答是基于检索到的具体文档或知识片段,RAG生成的答案往往更容易追溯来源,提高了模型决策的透明度和可解释性。
持续学习与更新
知识库的内容可以持续更新和扩充,使得RAG系统能够随着时间吸收新的信息,保持其回答的时效性和准确性。
04
流畅运行推荐配置
一般情况下,模型参数量越大,对机器要求越高。7B大模型推荐运行内存为16GB;13B大模型推荐运行内存为32GB;70B大模型推荐运行内存为64GB。7B或以下的大模型适合个人用户使用。
05
基本操作步骤
操作步骤主要分为本地大模型的部署与私有数据库的搭建。
01
向量搜索数据库
本地大模型的部署视频讲解如下。
以下视频来源于
人工智能伦理Tis
,时长02:09
配置模型应用环境
操作演示以LM Studio[4]为例。LM Studio是一款为个人用户和开发者设计的桌面应用程序,允许在本地机器上运行开源的大型语言模型(LLMs)。首先在官网下载对应架构的安装程序。
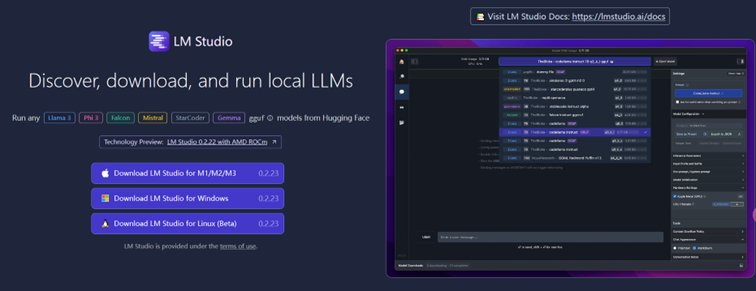
LM Studio官网
安装完成后页面如下。
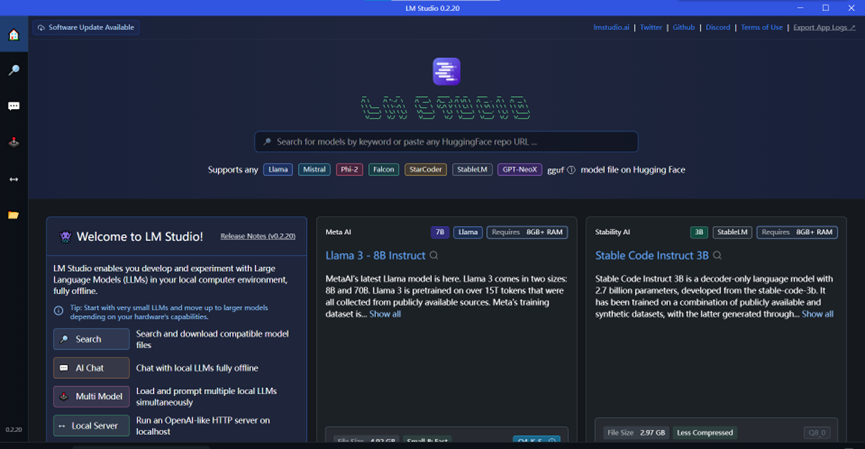
LM Studio界面
点击侧栏的搜索按钮,在输入框搜索心仪的模型,这选择模型时需要考虑模型参数量大小,模型参数量越大则模型推理时所需的CPU内存或GPU显存越大,对于16G内存的主机来说一般选择7B左右参数量的模型即可,这里以阿里云自研的开源模型通义千问qwen1_5-7b-chat-q8_0.gguf为例,点击下载,将自动下载对应的模型参数。
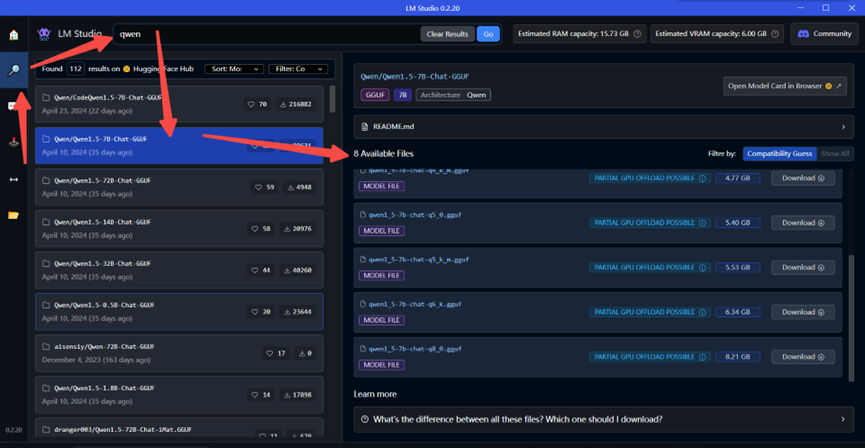
下载模型操作
本地模型测试
下载好模型参数后,可以在LM Studio进行简单的问答测试。侧栏点击AI Chat按钮,新建会话窗口,并选择载入的模型,即可开启AI对话模式。
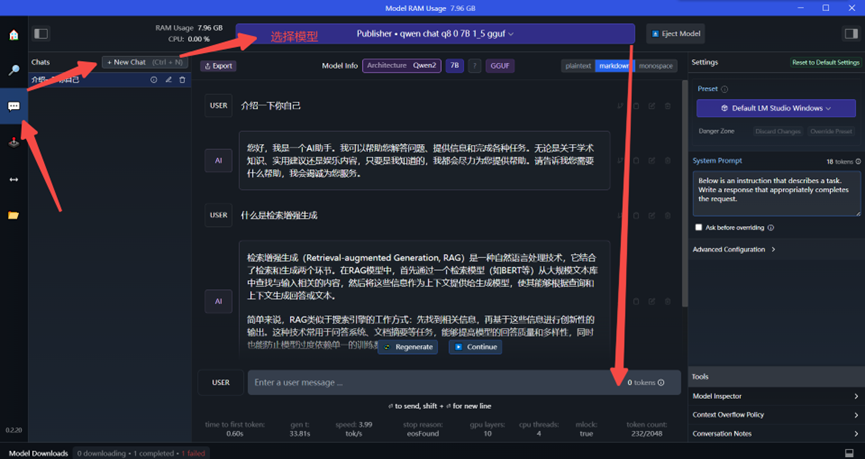
本地模型测试
API接口搭建
搭建API接口用于为后续连接私有数据库做准备。点击侧栏Local Server按钮,设置好配置后启动接口服务,并选择心仪的文本嵌入模型。
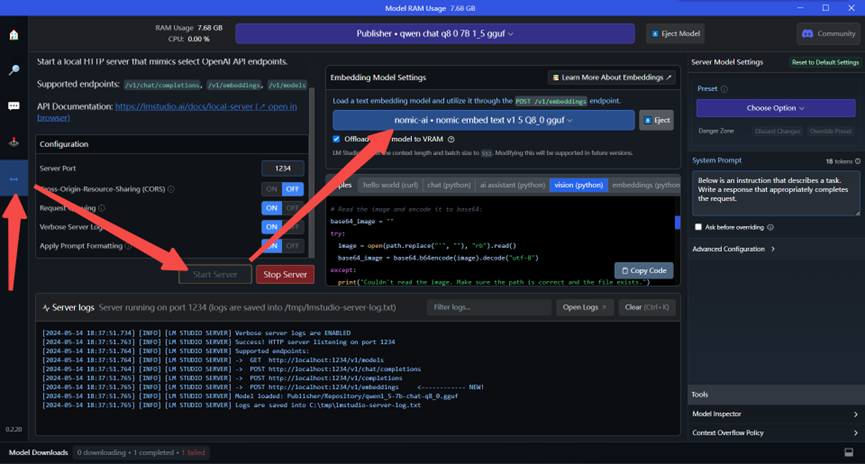
开启模型接口
更多地,可以在右侧配置模型,例如预设系统Prompt以优化模型的输出,调整模型加载的GPU数量等。
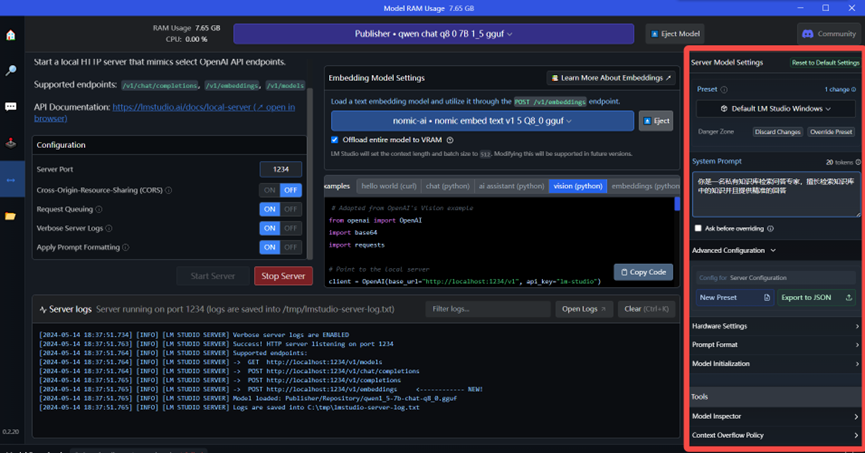
模型配置操作
02
私有数据库的搭建
私有数据库搭建视频讲解如下。
以下视频来源于
人工智能伦理Tis
,时长03:09
配置应用环境
私有数据库的搭建需要使用Anything LLM。Anything LLM 是一个开源多功能平台,可以将各种文档转换为数据,供语言模型使用。首先在官网下载对应架构的安装程序。
AnythingLLM官网
安装完成后界面如下:
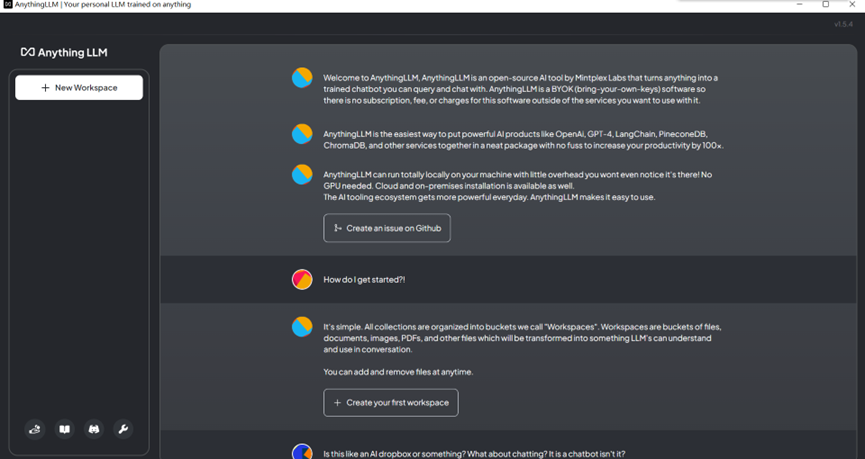
AnythingLLM界面
配置模型
进入设置界面,提供LLM的应用选择LM Studio,并填写相应的接口地址。
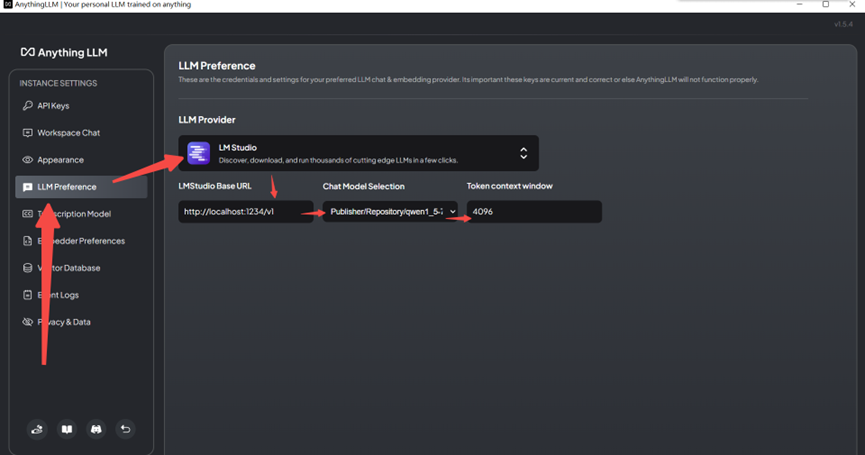
配置本地模型
配置文本嵌入模型
同上,文本嵌入模型提供的应用选择LM Studio,并填写相应的接口地址。
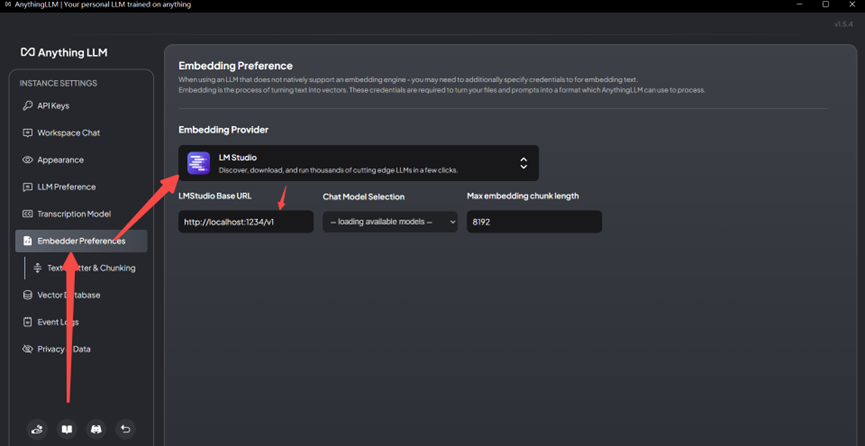
配置文本嵌入模型
创建工作区
回到主页,点击按钮并输入工作区名,创建工作区。
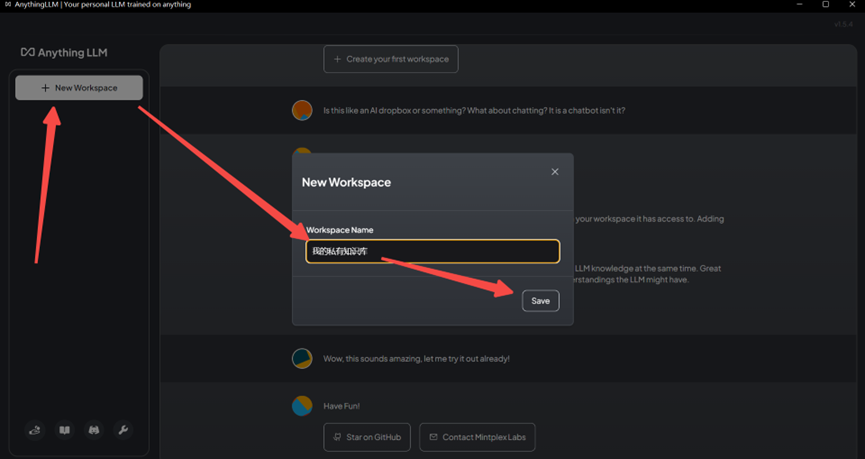
创建工作区
构建向量搜索数据库
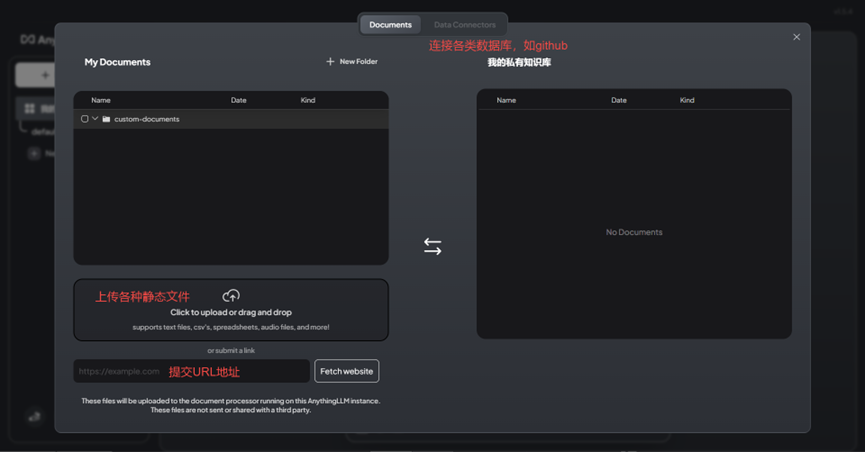
点击upload a document按钮,进入下图的页面,上传自己的知识库。上传文件类型可以是静态文件文档,也可以是网页链接地址,甚至是自己的代码仓库,youtube视频等。
构建向量搜索数据库
上传文件后等待文件解析,随后点击Save Embed按钮即可自动构建向量搜索数据库。
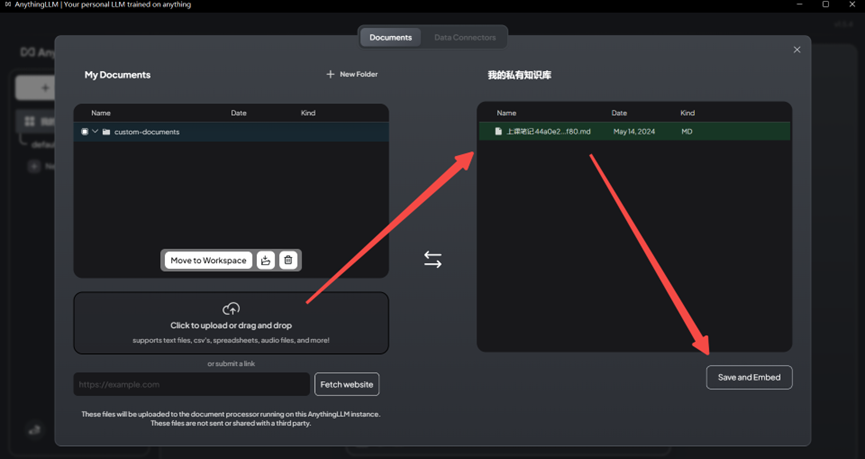
上传知识库文件
构建向量搜索数据库
配置完成后可以开始测试问答。如图所示,可见已成功配置本地大模型和私有数据库的连接。
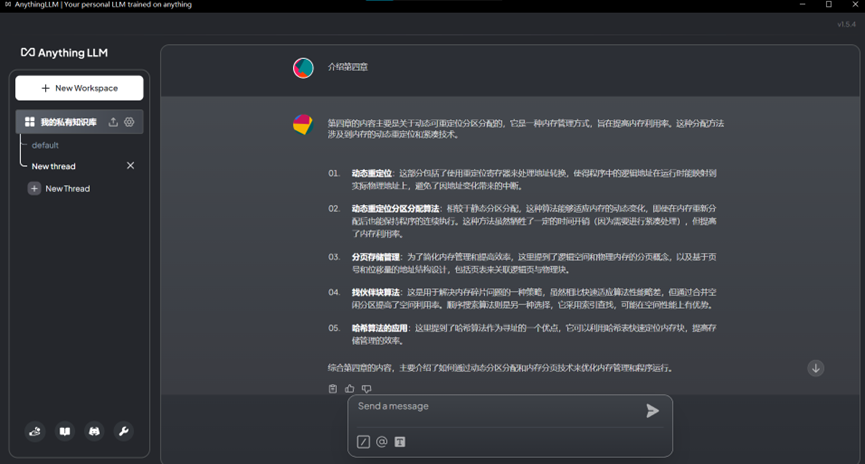
测试问答
应用也会在回答结束后标出引用的内容。
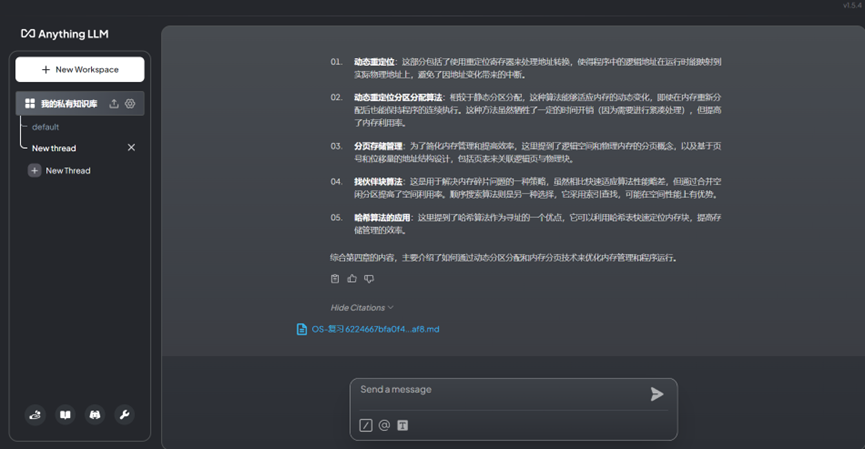
问答引用显示
总结
以上就是本地大模型部署和基于RAG方案的私有知识库搭建的基本操作。除此之外,还有更多丰富有趣的功能等待探索。如今大模型遍布各行各业、各个领域,基于RAG方案的私有知识库技术也逐渐发展,成为提升个人工作效率与创造潜能的新风尚。本地部署模型意味着用户能在自己的设备上享受即时响应的智能辅助,无需依赖云端,既保护了个人数据隐私,又确保了操作的低延迟与高可靠性。结合RAG方案的私有知识库,则让每位用户能够构建专属自己的知识宇宙。这种个性化的智能加持,使个人在信息洪流中不再迷失,更加聚焦于提升自我,无论是学术研究、创意写作还是日常学习,都能带来前所未有的知识运用与创新效率。
如何学习AI大模型?
作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

二、640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

三、AI大模型经典PDF籍
随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

四、AI大模型商业化落地方案

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 1417


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


