多模态大模型中,融合后如何知道最终结果受哪种模态影响更大?

可解释性机器学习_Feature Importance、Permutation Importance、SHAP 本文讲的都是建模后的可解释性方法。建模之前可解释性方法或者使用本身具备可解释性的模型都不在本文范围内~ 哪些特征在模型看到是最重要的? 关于某一条记录的预测,每一个特征是如何影响到最终的预测结果的? 从大量的记录整体来考虑,每一个特征如何影响模型的预测的? 为什么这些解释信息是有价值的 调试模型用 指导工程师做特征工程 指导数据采集的方向 指导人们做决策 建立模型和人之间的信任 本文主要讲三种方法: 特征重要性(Feature Importance) Permutation Importance SHAP 阅读详情

本篇介绍多模态大模型中如何基于最终结果分析各模态的影响。

具身智能被众多大佬看好,通往AGI的路最终肯定需要多个模态的大模型互相融合。多个模态配合好也是有可能去构建一个模拟现实的世界模型的。

最近一直在研究和尝试多模态大模型在一些VQA领域的前瞻研究和实际落地部署问题,遇到一个值得思考的问题:如果当预测结果出问题的时候,怎么去溯源是哪个模态的数据出的问题呢?这个方向感觉探索的足够深入是可以发论文的。

由于基于注意力机制去溯源的方法在大模型时代成本极高,因此最后还是需要考虑建模后的可解释性方法,目前主要是找到一些比较经典的可解释性机器学习方法,大家有更好的思路也可以提一提啊~

下面是一个快捷目录。

\1. 可解释性机器学习分类

\2. 推荐方法

一、可解释性机器学习分类

1. 内置 or 建模后

  • 内置可解释性:将可解释模块嵌入到模型中,比如说线性模型的权重、决策树的树结构。
  • 建模后可解释性:在模型训练结束后使用解释技术去解释模型。

2. 特定于模型 or 模型无关

  • 特定于模型的解释:意味着必须将解释方法应用到特定的模型体系结构中
  • 模型无关:解释方法与所用模型无关联,应用范围广

3. 全局解释 or 局部解释

  • 全局解释:解释模型的全局行为
  • 局部解释:在单条数据或者说单个实例上的解释

二、推荐方法

主要推荐两个方法:Permutation Importance 和 SHAP;另外还介绍了一下类似于LIME (Local Interpretable Model-agnostic Explanations) 的思路,大家还可以基于这个思路去延伸~

1. Permutation Importance

前提:在model训练完成后,才可以计算

思想:

基于“置换检验”的思想对特征重要性进行检测。简单来说,就是打乱某种模态的数据,保持其余特征不动,看其对预测精度的影响有多大。

计算步骤:

1)用多模态数据训练一个MLLM。(也可以直接用开源的)

2)验证集预测得到得分。

3)验证集的某个单模态数据进行随机打乱,比如把文本给打乱,预测得到得分。

4)将上述得分做差即可得到该模态对预测的影响。

5)同理可以在3)中把另一个模态的数据随机打乱进行验证,最后比较即可。

2. SHAP (SHapley Additive exPlanation)

前提:在model训练完成后计算

思想:

计算特征对模型输出的边际贡献,再从全局和局部两个层面对“黑盒模型”进行解释。

SHAP构建一个加性的解释模型,所有的特征都视为“贡献者”:

对于每个预测样本,模型都产生一个预测值,SHAP value就是该样本中每个特征所分配到的数值。

具体来说,计算一个特征加入到模型时的边际贡献,然后考虑到该特征在所有的特征序列的情况下不同的边际贡献,取均值,即某该特征的SHAP baseline value,包括Kernel Shap,Deep Shap和Tree Shap。

这也是目前可解释机器学习在风控、金融中最实用的一个方法。

3. 类似于LIME (Local Interpretable Model-agnostic Explanations) 的思路

之所以说“类似于”是因为LIME暂时无法实现对图像的解释,但这个思路本身是值得借鉴的。

前提:在model训练完成后计算

思路:

使用训练的局部代理模型来对单个样本进行解释。

假设对于需要解释的黑盒模型,取关注的实例样本,在其附近进行扰动生成新的样本点,并得到黑盒模型的预测值,使用新的数据集训练可解释的模型(如线性回归、决策树),得到对黑盒模型良好的局部近似。
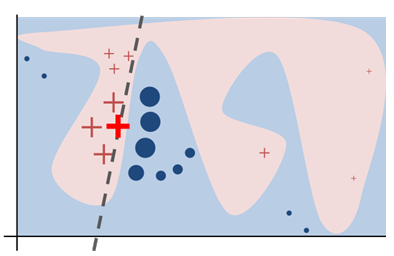
图片

实现步骤

1)如上图是一个非线性的复杂模型,蓝/粉背景的交界为决策函数;

2)选取关注的样本点,如图粗线的红色十字叉为关注的样本点X;

3)定义一个相似度计算方式,以及要选取的K个特征来解释;

4)在该样本点周围进行扰动采样(细线的红色十字叉),按照它们到X的距离赋予样本权重;

5)用原模型对这些样本进行预测,并训练一个线性模型(虚线)在X的附近对原模型近似。

这样就可以使用可解释性的模型对复杂模型进行局部解释。

上述方向只是一些示例和思路,具体一些实现可以看看参考文献。

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

多模态大模型(MLLM) 多模态大模型 (Multimodal Large Language Model),顾名思义,就是能够处理和理解多种类型信息的大模型。与传统的单模态模型(只处理文本、图像或音频等单一类型信息)不同,多模态模型能够融合文本、图像、音频、视频等多种模态数据,并进行综合理解和推理,最终实现更强大的能力。但是,我可以提供一些简化的代码示例,以展示多模态模型的基本概念和实现思路。训练多模态大模型是一个复杂的过程,需要考虑多个方面,包括数据准备、模型选择、训练策略等。著作权归作者所有,转载或内容合作请联系作者。 阅读详情

相关推荐

多模态大模型-CLIP

我们探究了能否将自然语言处理(NLP)中与任务无关的网络规模预训练的成功经验迁移至其他领域。研究发现,采用该模式后,计算机视觉领域也出现了类似的现象,同时我们还探讨了这一研究方向所带来的社会影响。为优化训练目标,CLIP 模型在预训练过程中学习执行多种任务,而后可通过自然语言提示利用这种任务学习能力,实现对众多现有数据集的零样本迁移。在足够的规模下,尽管该方法仍有很大的改进空间,但其性能已可与特定任务的监督模型相媲美。

3734

SHAP多模态数据解释:文本-图像融合模型归因

在当今人工智能领域,多模态数据融合已成为趋势。然而,随着模型复杂度的提升,理解模型决策过程变得愈发困难。SHAP(SHapley Additive exPlanations)作为一种强大的模型解释工具,能够为多模态数据解释提供有力支持。本文将重点介绍如何利用SHAP对文本-图像融合模型进行归因分析,帮助读者深入理解模型决策背后的原因。 ## SHAP多模态解释基础 SHAP基于贡献分析理论中的...

gitblog_00971的博客 401

多模态最新进展!单模态增益多模态学习,解决多模态和单模态学习目标梯度冲突问题

具有针对性的单模态学习目标的多模态学习方法在缓解多模态学习不平衡问题方面表现出了卓越的功效。然而,。为了很好地减少这些冲突,作者观察了多模态损失和单模态损失之间的差异,其中更容易学习的多模态损失的梯度幅度和协方差都小于单模态损失。利用这一特性,文中分析了多模态场景下的 Pareto 积分,并提出了 MMPareto 算法,该算法可以确保最终梯度的方向对所有学习目标都是通用的,并增强幅度以提高泛化能力,从而提供单模态辅助。

2401_85377976的博客 1489

Permutation Importance重要性

Permutation Importance 对模型的特征没有偏见,也不局限于特定的模型类别,适用性较广

→★佐佑思维★← 1711

多模态语义通信文献阅读:多模态语义通信研究综述

多模态语义通信

一去不复返的通信er 3317

解读模型可解释性的新境界:LIME与SHAP方法

本章深入探讨了LIME和SHAP这两种用于解释复杂模型预测的方法。LIME通过选择K个特征并使用最小二乘优化来解释局部行为,而SHAP方法提供了一个统一的解释框架,强调局部准确性、缺失性和一致性。两种方法在模型可解释性方面均有所建树,但各有其适用场景和局限性。

weixin_29940495的博客 715

在多模态模型训练时,如何合适地融合单模态损失

多模态训练时候导致的单模态缺损,需要同时考虑单模态损失

机器学习杂货铺1号店 5152

AVL-Excite新手必看:5步搞定发动机阀系系统建模(附B站视频教程)

本文为AVL-Excite新手提供发动机阀系系统建模的5步详细指南,涵盖软件环境搭建、基本结构建立、关键参数设置、仿真分析及常见问题排查。通过清晰的步骤说明和实用技巧,帮助工程师快速掌握建模方法,并附有精选B站视频教程链接,便于实践学习。

weixin_29305313的博客 509

多模态大模型中,多模态融合后怎样知道最终结果受哪种模态影响更大?

本篇介绍多模态大模型中如何基于最终结果分析各模态的影响。具身智能被众多大佬看好,通往AGI的路最终肯定需要多个模态的大模型互相融合。多个模态配合好也是有可能去构建一个模拟现实的世界模型的。最近一直在研究和尝试多模态大模型在一些VQA领域的前瞻研究和实际落地部署问题,遇到一个值得思考的问题:如果当预测结果出问题的时候,怎么去溯源是哪个模态的数据出的问题呢?这个方向感觉探索的足够深入是可以发论文的。

m0_59163425的博客 972

pyinstaller+scrapy打包出现错误:OSError: could not get source code

错误如下: Traceback (most recent call last): File "scrapy\utils\defer.py", line 55, in mustbe_deferred File "scrapy\core\spidermw.py", line 60, in process_spider_input File "scrapy\core\scraper.py", line 152, in call_spider File "scrapy\utils\misc.py

kin的博客 1759

告别卡顿!在RK3588上优化Gstreamer推拉流与RKNN推理的完整Pipeline实战

本文详细介绍了在RK3588平台上优化Gstreamer推拉流与RKNN推理的全链路Pipeline实战。通过解码环节参数调优、RKNN线程管理、内存预分配策略以及编码输出优化,实现60FPS流畅处理与亚秒级延迟。特别针对实时视频分析场景,提供了从rtspsrc到appsink的毫秒级优化方案,助力开发者构建零卡顿的智能视觉系统。

weixin_30698527的博客 484

多模态融合-初步学习

多模态融合的初步学习

weixin_42371645的博客 4057

oscp备考,oscp系列——Djinn3靶场:ssti漏洞,pkexec提权

oscp备考,oscp系列——Djinn3靶场:ssti漏洞,pkexec提权难度简单偏上对于低权限shell获取涉及:ssti漏洞对于提权:pkexec提权。

2202_75361164的博客 633

论文笔记:信息融合的门控多模态单元(GMU)含pytorch实现

论文笔记:信息融合的门控多模态单元(GMU)

zly_Always_be的博客 5956

matlab snr矩阵计算公式_基于MATLAB和Adams的悬置系统解耦计算方法对比

一、概述动力总成悬置系统主要有两个作用:一是固定和支撑动力总成,限制动力总成在各种工况下的位移量,防止与其它部件碰撞;二是隔振作用,将动力总成的振动尽可能少的传递到车身。悬置系统隔振性能的核心就是解决刚体模态的频率分配和振动耦合问题,简言之就是关注动力总成的刚体模态和解耦率。动力总成悬置系统的刚体模态频率和能量解耦分析,行业内的主流计算方法分两种:一是用MATLAB编程进行分析计算,二是...

weixin_33416900的博客 1449

生成模型实战 | 基于Transformer生成音乐

本文介绍了基于Transformer架构的音乐生成方法,将音乐视为一系列事件序列进行处理。与将音乐表示为多维图像的MuseGAN不同,该方法使用类似GPT的仅解码器模型,基于先前事件预测下一个音乐事件。模型使用MIDI格式的钢琴音乐数据,通过分词处理将音符转换为note-on、note-off、time-shift和velocity四种事件类型,共388个独特词元,映射为索引序列后输入网络。训练完成后,可通过调整温度参数控制生成音乐的新颖性,从而创作出风格类似训练数据且连贯逼真的音乐作品。

盼小辉丶的博客 5851

多模态融合技术现实世界中的挑战与研究进展

多模态融合技术的核心在于将来自不同感官渠道的信息结合起来,以期获得超越单一模态的理解和认知。例如,在自动驾驶车辆中,视觉系统可能受到光线变化的影响,而雷达和激光雷达(LiDAR)数据可以提供补充,帮助车辆在复杂环境中稳定导航。在医学诊断中,结合影像数据和病人的遗传信息可以提高疾病预测的准确性。

人工智能讲师分享前沿技术 4522

QCC305x-QCC304x系列开发教程之应用程序子系统详解 嵌入式

本文对QCC305x-QCC304x系列芯片的应用程序子系统进行了详细解析,并给出了一个LED闪烁的示例代码。嵌入式系统的开发既需要理论知识的支持,也需要实践经验的积累,希望本文能够为读者在QCC305x-QCC304x系列芯片的开发中提供一些有益的指导。QCC305x-QCC304x系列芯片提供了丰富的外设接口,包括UART、SPI、I2C等,开发者可以根据需求选择适合的接口进行数据传输和控制。QCC305x-QCC304x系列芯片的应用程序子系统是整个嵌入式系统的核心部分,负责管理和执行各种应用程序。

CodeMaven的博客 225

低质多模态数据融合,多家机构联合出了篇综述论文

幸运的是,由于多模态数据模态之间的互补性和信息的冗余性,在多模态融合过程中,联合多个模态的信息进行去噪已被证明是行之有效的策略。尽管在传统的多模态融合任务中,不确定性感知的动态融合方法的优越性已经从实验和理论上得到了证明,但是,在SOTA的多模态模型(不限于融合模型,如CLIP/BLIP等)中,动态性的思想还具有较大挖掘和应用潜力。为了充分刻画低质量多模态数据的性质及处理方法,该文章对目前的低质量多模态融合领域的机器学习方法进行了总结,系统回顾了该领域的发展过程,并进一步展望了需进一步研究的问题。

Angelina_Jolie的博客 1847

1分钟吃透一篇文献,借助AI辅助各部分精读,效率提升10倍(附AI提示词)

你现在是一名【研究领域】的资深博士,非常擅长阅读与分析长篇论文,那么接下来我会给你上传一篇论文,请你按照我的要求辅助我阅读。

qq_64378896的博客 641

汉书HE8,好用的汇编代码编写工具

汉书HE8,好用的汇编代码编写工具早期编写汇编代码所用功能强大

2025 多模态大模型的 10 大趋势!

2025年,多模态智能体将不再局限于单一模态的感知与交互,而是能够融合图像、文本、语音等多种信息,实现更自然、更高效的人机协作。

6681

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

多模态概述&多模态综述

多模态技术是一种涉及多种类型数据(如文本、图像、音频、视频等)的数据处理和理解技术。它通过整合这些不同类型的数据,模拟人类的多感官感知,以实现更全面和深入的信息处理。这项技术在多个领域都有应用,包括但不限于自动驾驶、情感分析、图像描述生成、视觉问答等。多模态数据融合是这一技术的核心,它可以通过数据级融合、特征级融合或决策级融合来实现。随着深度学习的发展,基于神经网络的方法在多模态融合中也变得越来越重要。

qq_55923034的博客 1273

怀旧版电脑GBC模拟器

再现原版GBC掌机的界面,电脑运行连游戏界面都一样大小,很怀旧,很真实,(英文版)强烈推荐,很小的文件,很难才找到的。

IEM模型,地表粗糙度模拟

利用微波反演土壤水分时候,利用IEM模型可以实现对随机地表的模拟

什么是多模态大模型?多模态大模型入门指南,看这一篇就够了!

多模态大型语言模型(Multimodal Large Language Models,MLLM)的诞生,依托于大型语言模型(Large Language Models,LLM)与大型视觉模型(Large Vision Models,LVM)领域的持续突破。随着LLM在语言理解及推理能力上的逐步强化,指令微调、上下文学习和思维链工具的应用愈发普遍。不过,即便LLM在处理语言任务时表现优异,但其在感知与理解图像等视觉信息方面仍存在显著不足。与之同步的是,LVM在图像分割、目标检测等视觉任务中已取得显著进展,通过

AI大模型的博客 1611

视觉与语言多模态架构的融合趋势:从双塔到统一Transformer

视觉-语言多模态模型的架构演进在2026年呈现出三条清晰的技术路线。第一条是"双塔架构"——使用独立的视觉编码器和文本编码器分别处理图像和文本,然后通过对比学习或跨模态注意力进行融合。OpenAI的CLIP及其后续变体(SigLIP、EVA-CLIP)代表了这条路线的极致。双塔架构的优势在于模态独立性:视觉和文本编码器可以独立训练和独立使用,跨模态检索只需要在嵌入空间中进行最近邻搜索。第二条是"编码器-解码器架构"——使用视觉编码器提取图像特征,然后将这些特征作为"软提示"输入到文本解码器中生成语言输出。

lady_mumu的博客 6661
上一篇: 搭建 Embedding 向量数据库,手把手教你创造自己的私人智能助理
下一篇: 今年读过最绝的一本书!几乎把ChatGPT讲透了——<ChatGPT 从⼊⻔到精通>
AI_小站
博客等级 码龄3年 6255粉丝 1152原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


