


以下是针对腾讯技术方向(网络编程如Reactor模型、分布式系统/微服务)的10道高频面试题及参考答案,涵盖原理、设计和实战场景:
一:网络编程与Reactor模型
1:Reactor模型的核心原理是什么?如何实现高并发?
【参考答案】:
【核心原理】:Reactor基于事件驱动,使用I/O多路复用(如epoll)监听多个文件描述符的事件(如读/写),通过事件分发器(Dispatcher)将事件分发给对应的事件处理器(Handler)。
【高并发实现】:单线程Reactor适合轻计算场景,多线程Reactor(主从 Reactor)将I/O和计算分离,主线程处理连接,子线程处理业务逻辑。
2:Reactor与Proactor的区别?实际项目中如何选择?
【参考答案】:
Reactor:同步I/O,需用户线程处理数据读写(如epoll_wait + read/write)。
Proactor:异步I/O,由操作系统完成读写,通过回调通知用户(如Windows IOCP)。
【选择依据】:Linux下多用Reactor(配合epoll),高性能服务器优先Reactor;Windows或需要极致性能的场景可选Proactor。
3:如何用epoll实现一个Reactor模型?
【参考答案】:
【步骤】:
\1. 创建epoll实例(epoll_create);
\2. 注册监听socket的EPOLLIN事件;
\3. 主循环调用epoll_wait等待事件;
\4. 根据事件类型分发给AcceptHandler(新连接)或ReadHandler(数据读取)。
【优化点】:使用ET(边缘触发)模式减少事件触发次数,配合非阻塞I/O。
4:解释epoll的LT(水平触发) ET(边缘触发)模式的区别 ?
【参考答案】:
LT:只要文件描述符处于就绪状态,会重复通知,直到数据处理完。
ET:仅在状态变化时通知一次,需一次性处理完数据(避免饥饿)。
【使用场景】:LT适合简单场景,ET需配合非阻塞I/O和循环读取,适合高性能服务器。
二:分布式系统与微服务
5:微服务架构下如何实现服务发现?
【参考答案】:
【核心机制】:
客户端发现:客户端查询服务注册中心(如Consul、Nacos)获取服务实例地址。
服务端发现:通过负载均衡器(如Nginx、Kubernetes Service)转发请求。
【腾讯方案】:可结合Tars框架(内置服务注册与发现)。
6:分布式系统如何保证数据一致性?
【参考答案】:
强一致性:使用分布式事务协议(如2PC、TCC),但性能低。
最终一致性:通过消息队列(如RocketMQ)异步补偿,或使用版本号/向量时钟。
【腾讯场景】:金融场景用TCC,高并发场景用最终一致性+对账机制。
7:CAP定理在微服务设计中的取舍?
【参考答案】:
【CAP】:一致性(C)、可用性(A)、分区容错性(P)三者不可兼得。
【取舍】:
CP:牺牲可用性(如ZooKeeper),适合支付系统。
AP:牺牲一致性(如Eureka),适合社交业务。
【腾讯实践】:根据业务需求选择,如微信支付选CP,朋友圈选AP。
8:如何设计一个高可用的RPC框架?
【参考答案】:
【核心组件】:服务注册中心、负载均衡、熔断降级、序列化协议、传输层(如 TCP/HTTP2)。
【腾讯优化点】:
使用长连接 + 心跳检测保活。
支持多种负载均衡策略(如一致性哈希、加权轮询)。
集成熔断器(如Hystrix思想)防止雪崩。
三:综合设计题
9:设计一个支持百万并发的即时通讯系统(类似微信)
【参考答案】:
【架构分层】:
1:接入层:使用Reactor模型(主从多线程)处理TCP长连接。
2:逻辑层:消息路由、群聊分发、存储消息(如Kafka异步落盘)。
3:存储层:Redis缓存在线状态,MySQL持久化消息(分库分表)。
【腾讯技术栈】:可参考微信的AsyncLog日志系统、自研协议优化带宽。
10:如何实现分布式锁?对比Redis和ZooKeeper的方案
【参考答案】:
【Redis方案】:
使用SET key value NX PX 3000(原子操作+超时)。
缺点:非强一致(主从切换可能丢锁)。
【ZooKeeper 方案】:
创建临时有序节点,最小节点获得锁,监听前序节点释放。
优点:强一致;缺点:性能较低。
【腾讯选择】:高并发Redis(配合RedLock),强一致选ZooKeeper。
【附:腾讯面试加分点】
1:熟悉内部技术栈:如TARS(RPC 框架)、TDMQ(消息队列)、CKV(分布式存储)。
2:性能优化经验:通过火焰图分析CPU瓶颈,内存池减少碎片。
3:业务场景结合:举例说明如何为微信/QQ设计低延迟、高可靠系统。
建议在回答时结合项目经验,突出对高并发、分布式、微服务的理解,并准备手写代码(如Reactor核心逻辑或一致性哈希算法)。
以下是针对阿里巴巴中间件开发(RPC、消息队列)和高并发场景的10 道高频面试题及参考答案,涵盖设计原理、实战场景和优化策略:
一:中间件开发(RPC、消息队列)
1:RPC框架的核心组件是什么?如何设计一个高性能RPC框架?
【参考答案】:
【核心组件】:
1:传输层:基于TCP或HTTP/2实现高效通信(如Netty)。
2:序列化:支持Protobuf、Hessian等高性能协议。
3:服务治理:负载均衡、熔断降级、服务发现(如Nacos)。
【高性能设计】:
使用长连接 + 连接池减少握手开销。
异步非阻塞 I/O(如Netty的EventLoop)。
阿里实践:参考HSF(阿里云分布式服务框架)的线程模型和异步调用链。
2:Dubbo 的 SPI 机制与 Java SPI 有何区别?
【参考答案】:
Java SPI:通过META-INF/services文件加载实现类,不支持按需加载。
Dubbo SPI:
支持扩展点自适应(@Adaptive注解)。
支持扩展点自动包装(Wrapper类)。
文件路径为META-INF/dubbo,性能更高(缓存加载结果)。
3:消息队列如何保证消息不丢失?
【参考答案】:
生产者端:开启事务或Confirm机制(如RocketMQ的SYNC_MASTER模式)。
Broker端:同步刷盘(SYNC_FLUSH) + 多副本(主从同步)。
消费者端:手动提交Offset,确保业务处理完成后再Ack。
阿里实践:RocketMQ的 “同步双写” + 定时巡检补偿。
4:RocketMQ 的存储模型和 Kafka 有何区别?
【参考答案】:
【RocketMQ】:
CommitLog顺序写:所有消息顺序写入一个文件,通过ConsumeQueue索引提高消费速度。
Tag 过滤:支持消息Tag过滤,减少服务端压力。
【Kafka】:
Partition分片:每个Topic分为多个Partition,支持水平扩展。
消费组:支持消费者组内负载均衡。
阿里选择:RocketMQ适合高可靠、顺序消息场景(如金融交易)。
二、高并发场景
5:如何设计一个支撑双十一大促的秒杀系统?
【参考答案】:
【分层削峰】:
1:前端限流:按钮置灰 + 验证码 + 请求随机丢弃。
2:网关层:令牌桶限流 + 请求排队(如Sentinel)。
3:服务层:缓存库存(Redis Lua扣减) + 异步下单(MQ消峰)。
4:数据层:数据库分库分表 + 热点数据单独优化。
【阿里实践】:Lua脚本保证原子性,库存预扣减 + 异步支付回调。
6:分布式事务的最终一致性如何实现?
【参考答案】:
【方案】:
1:本地消息表:业务与消息表绑定,定时任务补偿。
2:MQ事务消息:RocketMQ的事务消息机制(Half Message + Check回查)。
3:Seata框架:AT模式基于全局锁实现两阶段提交。
【阿里实践】:电商下单场景使用RocketMQ事务消息 + 对账系统兜底。
7:如何实现热点数据的动态负载均衡?
【参考答案】:
【识别热点】:实时监控QPS/CPU,或通过分布式追踪(如鹰眼)定位。
【负载策略】:
一致性哈希:避免数据倾斜。
分桶隔离:将热点数据拆分到独立集群(如Redis分片)。
【阿里方案】:Tair的 “热点Key探测” + 本地缓存(如AutoCache)。
8:解释熔断与降级的区别,如何实现?
【参考答案】:
熔断:服务不可用时快速失败(如Circuit Breaker模式),防止雪崩。
降级:牺牲非核心功能(如关闭推荐服务),保障核心链路。
【实现】:
Sentinel:通过QPS/响应时间阈值触发熔断降级。
Hystrix:线程池隔离 + Fallback机制。
三:综合设计与优化
9:如何设计一个高吞吐量的消息队列?
【参考答案】:
【存储优化】:
顺序写CommitLog + 页缓存(MMAP)减少磁盘I/O。
零拷贝技术(sendfile或mmap)提升网络传输效率。
【架构设计】:
Broker集群分片(Topic多Partition)。
生产者和消费者批量发送/拉取消息。
【阿里优化】:RocketMQ的 “异步刷盘” + 堆外内存减少GC。
10:如何解决分布式系统中的时钟不一致问题?
【参考答案】:
逻辑时钟:使用版本号(Version)或向量时钟(Vector Clock)代替物理时间。
全局唯一ID:雪花算法(Snowflake)或Leaf服务生成有序ID。
【阿里方案】:基于TSDB(时间序列数据库)的TSO(Timestamp Oracle)服务。
【附:阿里面试加分点】
1:熟悉内部技术栈:HSF(RPC)、RocketMQ、Sentinel(限流)、Seata(分布式事务)。
2:性能调优经验:通过Arthas诊断性能瓶颈,JVM参数优化(如G1垃圾回收)。
3:业务场景结合:举例说明如何为双十一设计高可用架构,或解决消息积压问题。
建议在回答时结合开源框架(如Dubbo、RocketMQ)源码分析,并准备手写代码(如实现一个简单的RPC调用或线程安全队列)。
以下是针对字节跳动技术方向(算法与数据结构、系统设计如推荐系统)的10道高频C++面试题及参考答案,涵盖代码实现、性能优化和架构设计:
一:算法与数据结构(C++ 实现)
1:合并区间
问题:合并所有重叠区间(例如输入[[1,3],[2,6],[8,10]],输出[[1,6],[8,10]])。
【参考答案】:
#include <vector>
#include <algorithm>
using namespace std;
vector<vector<int>> merge(vector<vector<int>>& intervals) {
    if (intervals.empty()) return {};
    sort(intervals.begin(), intervals.end(), [](const vector<int>& a, const vector<int>& b) {
        return a[0] < b[0];
    });
    vector<vector<int>> merged;
    merged.push_back(intervals[0]);
    for (int i = 1; i < intervals.size(); ++i) {
        if (intervals[i][0] <= merged.back()[1]) {
            merged.back()[1] = max(merged.back()[1], intervals[i][1]);
        } else {
            merged.push_back(intervals[i]);
        }
    }
    return merged;
}
关键点:排序后贪心合并,时间复杂度O(n log n)。
2:接雨水
问题:计算柱子排列能接的雨水量(例如输入[0,1,0,2,1,0,1,3],输出6)。
【参考答案】:
#include <vector>
using namespace std;
int trap(vector<int>& height) {
    int left = 0, right = height.size() - 1;
    int left_max = 0, right_max = 0, water = 0;
    while (left <= right) {
        if (height[left] <= height[right]) {
            if (height[left] > left_max) left_max = height[left];
            else water += left_max - height[left];
            left++;
        } else {
            if (height[right] > right_max) right_max = height[right];
            else water += right_max - height[right];
            right--;
        }
    }
    return water;
}
关键点:双指针向中间逼近,时间复杂度O(n)。
3:二叉树的右视图
问题:返回二叉树从右侧看到的节点值(例如输入二叉树层序遍历 [1,2,3,null,5,null,4],输出[1,3,4])。
【参考答案】:
#include <vector>
#include <queue>
using namespace std;
struct TreeNode {
    int val;
    TreeNode *left;
    TreeNode *right;
    TreeNode(int x) : val(x), left(nullptr), right(nullptr) {}
};
vector<int> rightSideView(TreeNode* root) {
    vector<int> result;
    if (!root) return result;
    queue<TreeNode*> q;
    q.push(root);
    while (!q.empty()) {
        int level_size = q.size();
        for (int i = 0; i < level_size; ++i) {
            TreeNode* node = q.front();
            q.pop();
            if (i == level_size - 1) result.push_back(node->val);
            if (node->left) q.push(node->left);
            if (node->right) q.push(node->right);
        }
    }
    return result;
}
关键点:层序遍历记录每层最后一个节点,时间复杂度O(n)。
4:链表排序(O(n log n) 时间)
问题:对链表进行排序,要求时间复杂度O(n log n),空间复杂度O(1)。【参考答案】:
struct ListNode {
    int val;
    ListNode *next;
    ListNode(int x) : val(x), next(nullptr) {}
};
class Solution {
public:
    ListNode* sortList(ListNode* head) {
        if (!head || !head->next) return head;
        ListNode *slow = head, *fast = head->next;
        while (fast && fast->next) {
           slow = slow->next;
           fast = fast->next->next;
        }
        ListNode *mid = slow->next;
        slow->next = nullptr;
        ListNode *left = sortList(head);
        ListNode *right = sortList(mid);
        return merge(left, right);
    }
private:
    ListNode* merge(ListNode* l1, ListNode* l2) {
        ListNode dummy(0);
        ListNode *tail = &dummy;
        while (l1 && l2) {
            if (l1->val < l2->val) {
                tail->next = l1;
                l1 = l1->next;
            } else {
                tail->next = l2;
                l2 = l2->next;
            }
            tail = tail->next;
        }
        tail->next = l1 ? l1 : l2;
        return dummy.next;
    }
};
关键点:归并排序 + 快慢指针找中点,时间复杂度O(n log n)。
二:系统设计(C++ 相关)
5:设计一个推荐系统的实时特征处理模块
问题:如何用C++实现高并发的实时特征计算?
【参考答案】:
【架构设计】:
1:数据分片:使用哈希分片(如一致性哈希)将用户请求分发到不同工作节点。
2:内存存储:利用unordered_map或Redis缓存用户历史行为(如最近 100 次点击)。
3:多线程处理:每个节点启动线程池(如C++11的std::thread + 任务队列),异步计算特征。
【优化点】:
使用无锁数据结构(如boost::lockfree::queue)减少线程竞争。
通过SIMD指令加速向量计算(如用户兴趣向量聚合)。
6:设计一个高性能的推荐模型推理服务
问题:如何用C++部署深度学习模型(如TensorFlow/PyTorch)实现低延迟推理?
【参考答案】:
【核心步骤】:
1:模型优化:将模型转换为ONNX或TensorRT格式,进行量化/剪枝。
2:异步批处理:使用线程池将多个请求合并为Batch推理(减少GPU空闲)。
3:内存管理:通过内存池(如boost::pool)复用输入/输出张量内存。
【性能指标】:
单机QPS 10万+(依赖GPU型号和模型复杂度)。
延迟< 10ms(使用CUDA流和异步数据传输)。
7:如何实现分布式推荐系统的在线学习?
问题:用 C++ 设计一个支持在线更新模型的系统。
【参考答案】:
【架构设计】:
1:参数服务器:使用C++实现参数服务器集群(如gRPC通信),存储模型权重。
2:实时更新:通过Boost.Asio异步处理用户反馈数据,增量更新模型。
3:一致性保证:使用版本号控制参数更新,避免读写冲突。
【挑战】:
处理稀疏特征的高效更新(如哈希表 + 锁分段)。
容错机制(如Checkpoint定期保存模型状态)。
8:设计一个支持千万级用户的实时排行榜
问题:如何用C++实现高效的用户分数更新和排名查询?
【参考答案】:
【数据结构】:
使用跳表(std::set或自定义实现)维护有序分数,插入/查询复杂度O(log n)。
哈希表(std::unordered_map)记录用户当前分数和位置。
【分布式扩展】:
按用户ID分片到多个节点,每个节点维护局部排行榜。
定期合并全局Top K(如每10秒聚合一次)。
三:综合设计题
9:设计一个短视频推荐系统(类似抖音)
问题:如何设计推荐系统的核心组件?
【参考答案】:
【核心模块】:
1:召回层:多路召回(协同过滤、内容匹配、实时热点),使用C++实现高效向量检索(如Faiss库)。
2:排序层:深度模型(如DNN)预估点击率,C++部署模型推理服务。
3:策略层:多样性控制(去重同类视频)、冷启动策略(新用户兴趣探索)。
【性能优化】:
使用内存数据库(如Redis)缓存用户画像和视频特征。
批处理与流式计算结合(如Flink + C++插件处理实时日志)。
10:实现一个线程安全的内存缓存池?
问题:用C++设计一个高性能对象池(如连接池、内存池)。
【参考答案】:
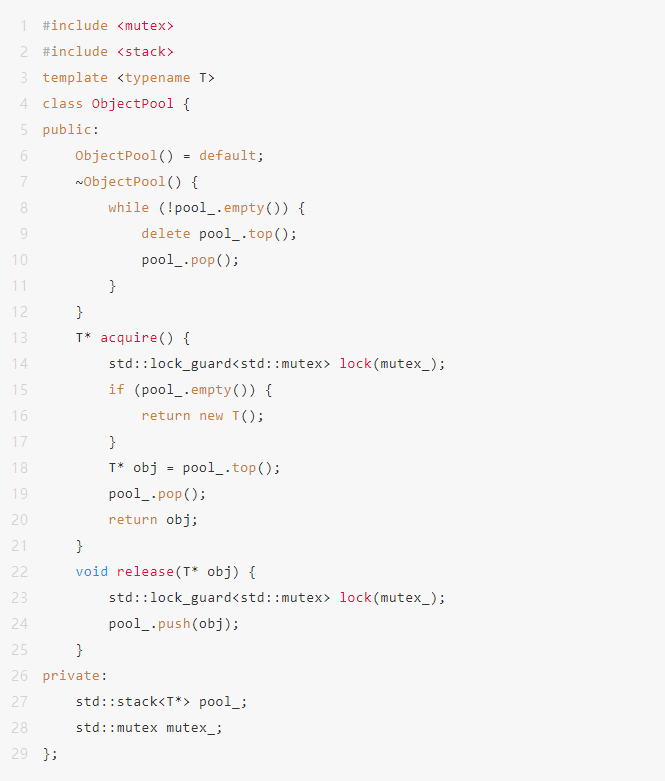
关键点:通过互斥锁保证线程安全,避免频繁new/delete开销。
【附:字节跳动面试加分点】
1:代码规范:使用RAII管理资源(如std::unique_ptr)、避免裸指针。
2:性能优化:熟悉CPU缓存友好设计、SIMD指令、无锁编程。
3:系统设计:结合业务场景(如抖音推荐、头条新闻流)分析技术选型。
建议在回答时结合C++特性(如移动语义、智能指针)展示代码质量,并准备手写代码(如实现红黑树或线程池)。
如何学习AI大模型?
大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。
不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!
想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。
但是LLM相关的内容很多,现在网上的老课程老教材关于LLM又太少。所以现在小白入门就只能靠自学,学习成本和门槛很高
那么我作为一名热心肠的互联网老兵,我意识到有很多经验和知识值得分享给大家,希望可以帮助到更多学习大模型的人!至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。
这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】

👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈
全套AGI大模型学习大纲+路线
AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

640套AI大模型报告合集
这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。


👉学会后的收获:👈
• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;
• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;
• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;
• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。
👉 福利来袭优快云大礼包:《2025最全AI大模型学习资源包》免费分享,安全可点 👈

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。
 1万+


 扫一扫


 被折叠的 条评论
为什么被折叠?
 到【灌水乐园】发言


