DeepSeek-R1微调指南

价格屠夫DeepSeek!这次开卷本地私有化部署;海辛大佬手把手叫你用ComfyUI;一份精彩的深度学习历史回顾;Devv创始人真诚复盘 | ShowMeAI日报 日报关键词:🉑DeepSeek开卷本地私有化部署;🉑上海交大 LLM 课程完结;🉑海辛录制的ComfyUI基础视频教程;🉑Devv AI搜索引擎创始人复盘;GenAI设计模式全面指南;🉑深度学习历史回顾… 点击阅读全文 阅读详情
AI摘要

本文提供DeepSeek-R1微调指南,介绍了在消费级GPU上使用LoRA和Unsloth进行微调的方法,包括了解模型、设置环境、加载模型、准备数据集等步骤。还提及了微调的原因、常见挑战及克服方法,最后给出大模型学习资料和路线。

DeepSeek-R1微调指南

在这篇博文中,我们将逐步指导你在消费级 GPU 上使用 LoRA(低秩自适应)和 Unsloth 对 DeepSeek-R1 进行微调。

关于LangChat

LangChat 是Java生态下企业级AIGC项目解决方案,集成RBAC和AIGC大模型能力,帮助企业快速定制AI知识库、企业AI机器人。

支持的AI大模型: Gitee AI / 阿里通义 / 百度千帆 / DeepSeek / 抖音豆包 / 智谱清言 / 零一万物 / 讯飞星火 / OpenAI / Gemini / Ollama / Azure / Claude 等大模型。

  • 官网地址:http://langchat.cn/

开源地址:

  • Gitee:https://gitee.com/langchat/langchat
  • Github:https://github.com/tycoding/langchat

微调DeepSeek-R1

微调像 DeepSeek-R1 这样的大型 AI 模型可能需要大量资源,但使用正确的工具,可以在消费级硬件上进行有效训练。让我们探索如何使用 LoRA(低秩自适应)和 Unsloth 优化 DeepSeek-R1 微调,从而实现更快、更具成本效益的训练。

DeepSeek 的最新 R1 模型正在设定推理性能的新基准,可与专有模型相媲美,同时保持开源。 DeepSeek-R1 的精简版本在 Llama 3 和 Qwen 2.5 上进行了训练,现在已针对使用 Unsloth(一种专为高效模型自适应而设计的框架)进行微调进行了高度优化。⚙

在这篇博文中,我们将逐步指导你在消费级 GPU 上使用 LoRA(低秩自适应)和 Unsloth 对 DeepSeek-R1 进行微调。

1、了解 DeepSeek-R1

DeepSeek-R1 是由 DeepSeek 开发的开源推理模型。它在需要逻辑推理、数学问题解决和实时决策的任务中表现出色。与传统 LLM 不同,DeepSeek-R1 的推理过程透明,适合……

1.1 为什么需要微调?

微调是将 DeepSeek-R1 等通用语言模型适应特定任务、行业或数据集的关键步骤。

微调之所以重要,原因如下:

  • 领域特定知识:预训练模型是在大量通用知识库上进行训练的。微调允许针对医疗保健、金融或法律分析等特定领域进行专业化。
  • 提高准确性:自定义数据集可帮助模型理解小众术语、结构和措辞,从而获得更准确的响应。
  • 任务适应:微调使模型能够更高效地执行聊天机器人交互、文档摘要或问答等任务。
  • 减少偏差:根据特定数据集调整模型权重有助于减轻原始训练数据中可能存在的偏差。

通过微调 DeepSeek-R1,开发人员可以根据其特定用例对其进行定制,从而提高其有效性和可靠性。

1.2 微调中的常见挑战及其克服方法

微调大规模 AI 模型面临多项挑战。以下是一些最常见的挑战及其解决方案:

a) 计算限制

  • 挑战:微调 LLM 需要具有大量 VRAM 和内存资源的高端 GPU。
  • 解决方案:使用 LoRA 和 4 位量化来减少计算负荷。将某些进程卸载到 CPU 或基于云的服务(如 Google Colab 或 AWS)也会有所帮助。

b) 在小型数据集上过度拟合

  • 挑战:在小型数据集上进行训练可能会导致模型记住响应,而不是很好地进行泛化。
  • 解决方案:使用数据增强技术和正则化方法(如 dropout 或 early stopping)来防止过度拟合。

c) 训练时间长

  • 挑战:微调可能需要几天或几周的时间,具体取决于硬件和数据集大小。
  • 解决方案:利用梯度检查点和低秩自适应 (LoRA) 来加快训练速度,同时保持效率。

d) 灾难性遗忘

  • 挑战:微调后的模型可能会忘记预训练阶段的一般知识。
  • 解决方案:使用包含特定领域数据和一般知识数据的混合数据集来保持整体模型准确性。

e) 微调模型中的偏差

  • 挑战:微调模型可以继承数据集中存在的偏差。
  • 解决方案:整理多样化且无偏差的数据集,应用去偏差技术并使用公平性指标评估模型。

有效应对这些挑战可确保稳健高效的微调过程。

2、设置环境

微调大型语言模型 (LLM) 需要大量计算资源。以下是推荐的配置:
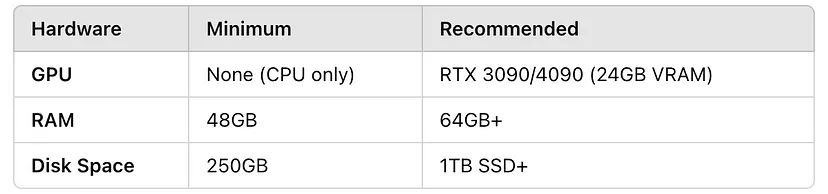
imgimg

确保你拥有 Python 3.8+ 并安装必要的依赖项:

pip install unsloth torch transformers datasets accelerate bitsandbytes

3、加载预训练模型和 Tokenizer

使用 Unsloth,我们可以高效地以 4 位量化加载模型以减少内存使用量:

from unsloth import FastLanguageModel

model_name = "unsloth/DeepSeek-R1-Distill-Llama-8B-unsloth-bnb-4bit"
max_seq_length = 2048
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name=model_name,
    max_seq_length=max_seq_length,
    load_in_4bit=True,
)

4、准备数据集

微调需要结构化的输入输出对。让我们假设一个用于遵循指令任务的数据集:

{"instruction": "What is the capital of France?", "output": "The capital of France is Paris."}
{"instruction": "Solve: 2 + 2", "output": "The answer is 4."}

使用 Hugging Face 的数据集库加载数据集:

from datasets import load_dataset

dataset = load_dataset("json", data_files={"train": "train_data.jsonl", "test": "test_data.jsonl"})

使用聊天式提示模板格式化数据集:

prompt_template = """Below is an instruction that describes a task. Write a response that appropriately completes the request.

### Instruction:
{instruction}
### Response:
"""
def preprocess_function(examples):
    inputs = [prompt_template.format(instruction=inst) for inst in examples["instruction"]]
    model_inputs = tokenizer(inputs, max_length=max_seq_length, truncation=True)
    return model_inputs
tokenized_dataset = dataset.map(preprocess_function, batched=True)

5、应用 LoRA 进行高效微调

LoRA 允许通过仅训练模型的特定部分进行微调,从而显著减少内存使用量:

model = FastLanguageModel.get_peft_model(
    model,
    r=16,  # LoRA rank
    target_modules=["q_proj", "v_proj"],  # Fine-tune key attention layers
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    use_gradient_checkpointing=True,
)

训练模型。配置训练参数。初始化并开始训练:

from transformers import Trainer

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=tokenized_dataset["train"],
    eval_dataset=tokenized_dataset["test"],
    tokenizer=tokenizer,
)
trainer.train()

6、评估和保存模型

训练后,评估并保存微调后的模型:

# Evaluate the model
eval_results = trainer.evaluate()
print(f"Perplexity: {eval_results['perplexity']}")

# Save the model and tokenizer
model.save_pretrained("./finetuned_deepseek_r1")
tokenizer.save_pretrained("./finetuned_deepseek_r1")

7、部署模型进行推理

微调后,使用模型进行推理。本地部署llama.cpp,运行:

./llama.cpp/llama-cli \
   --model unsloth/DeepSeek-R1-Distill-Llama-8B-GGUF/DeepSeek-R1-Distill-Llama-8B-Q4_K_M.gguf \
   --cache-type-k q8_0 \
   --threads 16 \
   --prompt '<|User|>What is 1+1?<|Assistant|>' \
   --n-gpu-layers 20 \
   -no-cnv

8、结束语

通过利用 LoRA 和 Unsloth,我们成功地在消费级 GPU 上微调了 DeepSeek-R1,显著降低了内存和计算要求。这使得更快、更易于访问的 AI 模型训练成为可能,而无需昂贵的硬件。

DeepSeek无疑是2025开年AI圈的一匹黑马,在一众AI大模型中,DeepSeek以低价高性能的优势脱颖而出。DeepSeek的上线实现了AI界的又一大突破,各大科技巨头都火速出手,争先抢占DeepSeek大模型的流量风口。

DeepSeek的爆火,远不止于此。它是一场属于每个人的科技革命,一次打破界限的机会,一次让普通人也能逆袭契机。

DeepSeek的优点

read-normal-img

掌握DeepSeek对于转行大模型领域的人来说是一个很大的优势,目前懂得大模型技术方面的人才很稀缺,而DeepSeek就是一个突破口。现在越来越多的人才都想往大模型方向转行,对于想要转行创业,提升自我的人来说是一个不可多得的机会。

那么应该如何学习大模型

大模型时代,火爆出圈的LLM大模型让程序员们开始重新评估自己的本领。 “AI会取代那些行业?”“谁的饭碗又将不保了?”等问题热议不断。

不如成为「掌握AI工具的技术人」,毕竟AI时代,谁先尝试,谁就能占得先机!

想正式转到一些新兴的 AI 行业,不仅需要系统的学习AI大模型。同时也要跟已有的技能结合,辅助编程提效,或上手实操应用,增加自己的职场竞争力。

大模型岗位需求越来越大,但是相关岗位人才难求,薪资持续走高,AI运营薪资平均值约18457元,AI工程师薪资平均值约37336元,大模型算法薪资平均值约39607元。

read-normal-img

掌握大模型技术你还能拥有更多可能性:

• 成为一名全栈大模型工程师,包括Prompt,LangChain,LoRA等技术开发、运营、产品等方向全栈工程;

• 能够拥有模型二次训练和微调能力,带领大家完成智能对话、文生图等热门应用;

• 薪资上浮10%-20%,覆盖更多高薪岗位,这是一个高需求、高待遇的热门方向和领域;

• 更优质的项目可以为未来创新创业提供基石。

可能大家都想学习AI大模型技术,也想通过这项技能真正达到升职加薪,就业或是副业的目的,但是不知道该如何开始学习,因为网上的资料太多太杂乱了,如果不能系统的学习就相当于是白学。为了让大家少走弯路,少碰壁,这里我直接把都打包整理好,希望能够真正帮助到大家。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】在这里插入图片描述

👉AI大模型学习路线汇总👈

大模型学习路线图,整体分为7个大的阶段:(全套教程文末领取哈)

read-normal-img

第一阶段: 从大模型系统设计入手,讲解大模型的主要方法;

第二阶段: 在通过大模型提示词工程从Prompts角度入手更好发挥模型的作用;

第三阶段: 大模型平台应用开发借助阿里云PAI平台构建电商领域虚拟试衣系统;
第四阶段: 大模型知识库应用开发以LangChain框架为例,构建物流行业咨询智能问答系统;
第五阶段: 大模型微调开发借助以大健康、新零售、新媒体领域构建适合当前领域大模型;
第六阶段: 以SD多模态大模型为主,搭建了文生图小程序案例;
第七阶段: 以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

👉大模型实战案例👈
光学理论是没用的,要学会跟着一起做,要动手实操,才能将自己的所学运用到实际当中去,这时候可以搞点实战案例来学习。

read-normal-img

👉大模型视频和PDF合集👈
观看零基础学习书籍和视频,看书籍和视频学习是最快捷也是最有效果的方式,跟着视频中老师的思路,从基础到深入,还是很容易入门的。

read-normal-img

read-normal-img

👉学会后的收获:👈

• 基于大模型全栈工程实现(前端、后端、产品经理、设计、数据分析等),通过这门课可获得不同能力;

• 能够利用大模型解决相关实际项目需求: 大数据时代,越来越多的企业和机构需要处理海量数据,利用大模型技术可以更好地处理这些数据,提高数据分析和决策的准确性。因此,掌握大模型应用开发技能,可以让程序员更好地应对实际项目需求;

• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。

read-normal-img

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】在这里插入图片描述

DeepSeek本地部署详细指南 通过上述步骤,你可以在本地成功部署DeepSeek模型,并通过Ollama或Open Web UI与模型进行交互。本地部署不仅能够保护数据隐私,还能根据需求灵活调整模型参数,满足不同场景下的使用需求。如果你在部署过程中遇到任何问题,可以在评论区留言,我们将一起解决。希望这篇教程能帮助你顺利部署DeepSeek模型,开启高效开发的新旅程! 阅读详情

相关推荐

DeepSeek R1本地化部署与联网功能实战指南:从零搭建智能对话系统

在人工智能技术快速发展的今天,如何将先进的对话模型DeepSeek R1部署到本地环境并赋予其联网能力,成为许多开发者和企业关注的重点。本文将深入讲解完整的本地化部署流程,并通过实例代码演示如何为模型添加实时网络访问功能。

理论都是虚的,代码才是王道。 7万+

一文教你如何本地部署玩转DeepSeek-V3,免费体验100度算力包跑通!

只需三步,免费体验100度算⼒包就能完成DeepSeek-V3的私有化部署!

weixin_46880696的博客 9万+

DeepSeek掘金——DeepSeek-R1微调指南

在这篇博文中,我们将逐步指导你在消费级 GPU 上使用 LoRA(低秩自适应)和 Unsloth 对 DeepSeek-R1 进行微调。微调像 DeepSeek-R1 这样的大型 AI 模型可能需要大量资源,但使用正确的工具,可以在消费级硬件上进行有效训练。让我们探索如何使用 LoRA(低秩自适应)和 Unsloth 优化 DeepSeek-R1 微调,从而实现更快、更具成本效益的训练。DeepSeek 的最新 R1 模型正在设定推理性能的新基准,可与专有模型相媲美,同时保持开源。

4070

DeepSeek本地部署,保姆级教程,带你打造最强AI

配置后,Ollama 服务将能在当前网络(如家庭 Wifi)中提供服务。你可以使用其他设备上的 Chatbox 客户端连接到此服务。可能需要在防火墙中允许 Ollama 服务的端口(默认为 11434),具体取决于你的操作系统和网络环境。为避免安全风险,请不要将 Ollama 服务暴露在公共网络中。家庭 Wifi 网络是一个相对安全的环境。Ollama 服务的 IP 地址是你电脑在当前网络中的地址,通常形式如下。

运维&陈同学的博客 23万+

大模型系列——DeepSeek-R1微调指南

在这篇博文中,我们将逐步指导你在消费级 GPU 上使用 LoRA(低秩自适应)和 Unsloth 对 DeepSeek-R1 进行微调。微调像 DeepSeek-R1 这样的大型 AI 模型可能需要大量资源,但使用正确的工具,可以在消费级硬件上进行有效训练。让我们探索如何使用 LoRA(低秩自适应)和 Unsloth 优化 DeepSeek-R1 微调,从而实现更快、更具成本效益的训练。DeepSeek 的最新 R1 模型正在设定推理性能的新基准,可与专有模型相媲美,同时保持开源。

2401_84052244的博客 566

【报错】sqli-labs靶场搭建出现“Unable to connect to the database: security”

搭建sqli-labs靶场时,“Unable to connect to the database: security”报错解决

九芒星的博客 2991

Unsloth 实战:DeepSeek-R1 模型高效微调指南(下篇)

下篇(本文)以实战微调为主,介绍预训练、全量微调、LoRA微调。

举世誉之而不加劝,举世非之而不加沮,定乎内外之分,辩乎荣辱之境,斯已矣。 1679

无限维李代数局部与2-局部1/2-导子:从概念到Witt代数实例解析

在抽象代数与数学物理中,李代数是描述对称性的基本结构,而导子则是刻画其微分性质的核心算子。从经典的导子概念出发,通过引入“局部”与“分数阶”两个关键推广,形成了局部导子、2-局部导子以及1/2-导子等重要研究方向。这些推广不仅深化了对无限维李代数(如Witt代数、Virasoro代数)复杂结构的理解,其研究方法和结论也为共形场论、可积系统等物理理论提供了数学基础。本文聚焦于无限维李代数上局部与2-局部1/2-导子的系统研究,通过拆解核心概念、剖析典型代数结构,并以Witt代数为实例,详细演示了从全局1/2-

weixin_34072296的博客 392

【DeepSeek-R1背后的技术】系列五:DeepSeek-R1微调指南

微调像 DeepSeek-R1 这样的大型 AI 模型可能需要大量资源,但如果我们能使用正确的工具,依然可以在消费级硬件上进行有效的训练。下面我们来探索如何使用 LoRA(低秩自适应)和 Unsloth 优化 DeepSeek-R1 微调,从而实现更快、更低成本的训练。 在这篇博文中,我们将在消费级 GPU 上使用 LoRA(低秩自适应)和 Unsloth 对 DeepSeek-R1 进行微调。

https://github.com/Donvink,专注于计算机视觉、目标检测、目标跟踪等方向 3957

7.91版本unidbg调用方式

【代码】xhs最新7.91版本unidbg调用方式。

Codeooo 博客 1107

【BUG已解决】ImportError: cannot import name ‘OpenAI‘ from ‘openai‘ 解决方案

的核心是版本不匹配用确认当前版本如果是 0.x 版本 →升级到 1.x升级后代码语法要同步改为团队协作项目务必在中锁定版本号,避免"我这能跑,你那不能跑"的问题对接国产模型时,只需替换base_url参数,SDK 调用方式完全一致。

一键难忘的博客 1万+

LLM漫谈| DeepSeek R1 微调指南

在本文中,我们将深入探讨使用 Python 微调 DeepSeek R1模型的过程。一、先决条件:unsloth:可以使 Llama-3、Mistral、Phi-4 和 Gemma 等大型语言模型的微调速度提高了 2 倍,使用的内存减少70%,关键是准确性没有降低!torch:使用 PyTorch 进行深度学习的基本构建块,它提供了一个强大的张量库,类似于 NumPy,但它具有 GPU 加速的额外优势,这在使用 LLMs的时候,非常关键。

2401_85343303的博客 1569

[yolov5/yolov8修改]替换yolov5/yolov8中的主干网络为EfficientNetv2

针对yolov5和yolov8的主干网络进行替换。

PLH19990227的博客 4147

DeepSeek-R1本地微调指南(unsloth)

可能会遇到transformers版本问题,如果遇到请更新版本到4.50.1。本文下载的是:DeepSeek-R1-Distill-Llama-8B。(3)打开对应的jupyter文件,执行即可。如果是在远程服务器上配置,请按照一下配置。(3)更新transformers。(5)Wandb(可以不安装)(1)新建一个文件夹,如DS。(2)从魔搭上下载预训练模型。(2)添加jupyter环境。(4)jupyter文件内容。参考官方文档完成配置即可。(1)打开jupyter。

2301_77617206的博客 1076

第076篇:大涡模拟进阶

大涡模拟(Large Eddy Simulation, LES)是介于直接数值模拟(DNS)和雷诺平均方法(RANS)之间的重要湍流模拟方法。本文深入介绍动态Smagorinsky模型、尺度相似模型、WALE模型和隐式LES等高级亚格子模型。通过Python实现槽道湍流和圆柱绕流的LES求解器,详细展示近壁面处理、动态系数计算和亚格子应力建模技术。大涡模拟,亚格子模型,动态模型,Smagorinsky,WALE模型,尺度相似模型,近壁面处理,槽道湍流LES的核心思想是对Navier-Stokes方程进行空间

2401_87715305的博客 736

HotSpot G1 GC 的分区记账、SATB 并发标记与停顿目标调优解析

线上GC毛刺该调停顿目标、加大新生代还是换收集器?本文从HotSpot G1的设计出发,梳理分区与巨型对象、卡表与记忆集、写屏障与细化线程、停顿预测、SATB并发标记、自适应IHOP、混合回收规则及Full GC兜底,并注明JDK8至JDK27的版本差异。文中在JDK8与JDK17上实测:停顿目标从200ms降到20ms,伊甸区缩小四成、P99下降但仍超目标;巨型对象会反复触发又撤销并发标记;JDK17并行Full GC平均停顿约为JDK8的三成。最后给出日志解读、参数清单、调优流程与选型。

曾经“等你生日那天”都遥远得像未来,如今却可欢愉的挥手说“下个十年见” 170万+

Unsloth 实战:DeepSeek-R1 模型高效微调指南(上篇)

本文以基础环境搭建为主,介绍了 Unsloth 框架、基座模型下载、导入基座模型、数据集下载/加载/清洗、SwanLab 平台账号注册。

举世誉之而不加劝,举世非之而不加沮,定乎内外之分,辩乎荣辱之境,斯已矣。 929

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

DeepSeek-R1 医疗诊断大模型微调指南(附教程)

🏥 DeepSeek-R1 医疗诊断大模型微调指南

huang9604的博客 1313

ET2012新版免狗免安装绿色软件

ET2012新版免狗免安祖昂绿色软件。,新界面,新视觉,

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

【限时免费】 释放DeepSeek-R1-Distill-Llama-8B的全部潜力:一份基于的微调指南

释放DeepSeek-R1-Distill-Llama-8B的全部潜力:一份基于的微调指南 【免费下载链接】DeepSeek-R1-Distill-Llama-8B 项目地址: https://gitcode.com/openM...

gitblog_02458的博客 448

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

DeepSeek-R1大模型在MS-Swift框架下的部署与微调实践全指南

作为幻方量化深度求索团队研发的推理模型,DeepSeek-R1在数学、代码和自然语言推理等复杂任务上表现出色,其开源特性与MS-Swift的灵活微调能力相结合,为各行业开发者提供了强大的AI工具链。未来,随着技术的不断进步和开源生态的完善,DeepSeek-R1与MS-Swift的结合应用将有更广阔的发展空间。:DeepSeek-R1已具备强大的文本推理能力,未来可结合MS-Swift的多模态支持,扩展到图像、视频和音频等模态的推理任务。:在保持推理质量的同时,通过优化算法和硬件配置提升推理速度。

weixin_45422672的博客 1296

DeepSeek-R1-0528模型微调指南:定制化AI助手的实现

DeepSeek-R1-0528作为DeepSeek R1系列的重要升级版本,在推理深度和推理能力方面实现了显著突破。该模型通过增加计算资源和后训练算法优化,在数学、编程和通用逻辑推理任务上表现出色,整体性能接近行业领先模型。对于希望构建定制化AI助手的开发者和研究者而言,DeepSeek-R1-0528提供了一个强大的基础模型。 ### 模型核心特性概览 | 特性 | 规格 | 优势 | |...

gitblog_00019的博客 1170

DeepSeek-R1微调指南,非常详细收藏我这一篇就够!

• 能够完成时下热门大模型垂直领域模型训练能力,提高程序员的编码能力: 大模型应用开发需要掌握机器学习算法、深度学习框架等技术,这些技术的掌握可以提高程序员的编码能力和分析能力,让程序员更加熟练地编写高质量的代码。• 基于大模型和企业数据AI应用开发,实现大模型理论、掌握GPU算力、硬件、LangChain开发框架和项目实战技能, 学会Fine-tuning垂直训练大模型(数据准备、数据蒸馏、大模型部署)一站式掌握;以大模型平台应用与开发为主,通过星火大模型,文心大模型等成熟大模型构建大模型行业应用。

2401_85343303的博客 2114

LLM漫谈(十)| DeepSeek R1 微调指南

在本文中,我们将深入探讨使用 Python 微调 DeepSeek R1模型的过程。

wshzd的博客 1354
上一篇: 干货分享!关于Zero-RL的调参经验
下一篇: 这是我见过最强的AI大模型教程书籍!熬夜也要看完!
AI大模型_学习君
博客等级 码龄3年 6137粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值