三步完成Llama3.2在算力魔方的INT4量化和部署|开发者实战

Optimum详解 Optimum 是 Hugging Face 提供的 Transformers 和 Diffusers 的扩展库,旨在帮助用户在目标硬件上以最高效率训练和运行模型,同时保持易于使用的特性。 阅读详情

2024年9月25日,Meta又发布了Llama3.2:一个多语言大型语言模型(LLMs)的集合,其中包括:

  • 大语言模型: 1B和3B参数版本,仅接收多种语言文本输入。
  • 多模态模型: 11B和90B参数版本,既能接收文本输入又能接收图像输入。

图片

本文将介绍使用OpenVINO™ 2024.4在算力魔方上部署Llama-3.2-1B-Instruct模型。

1.1

Llama 3.2简介

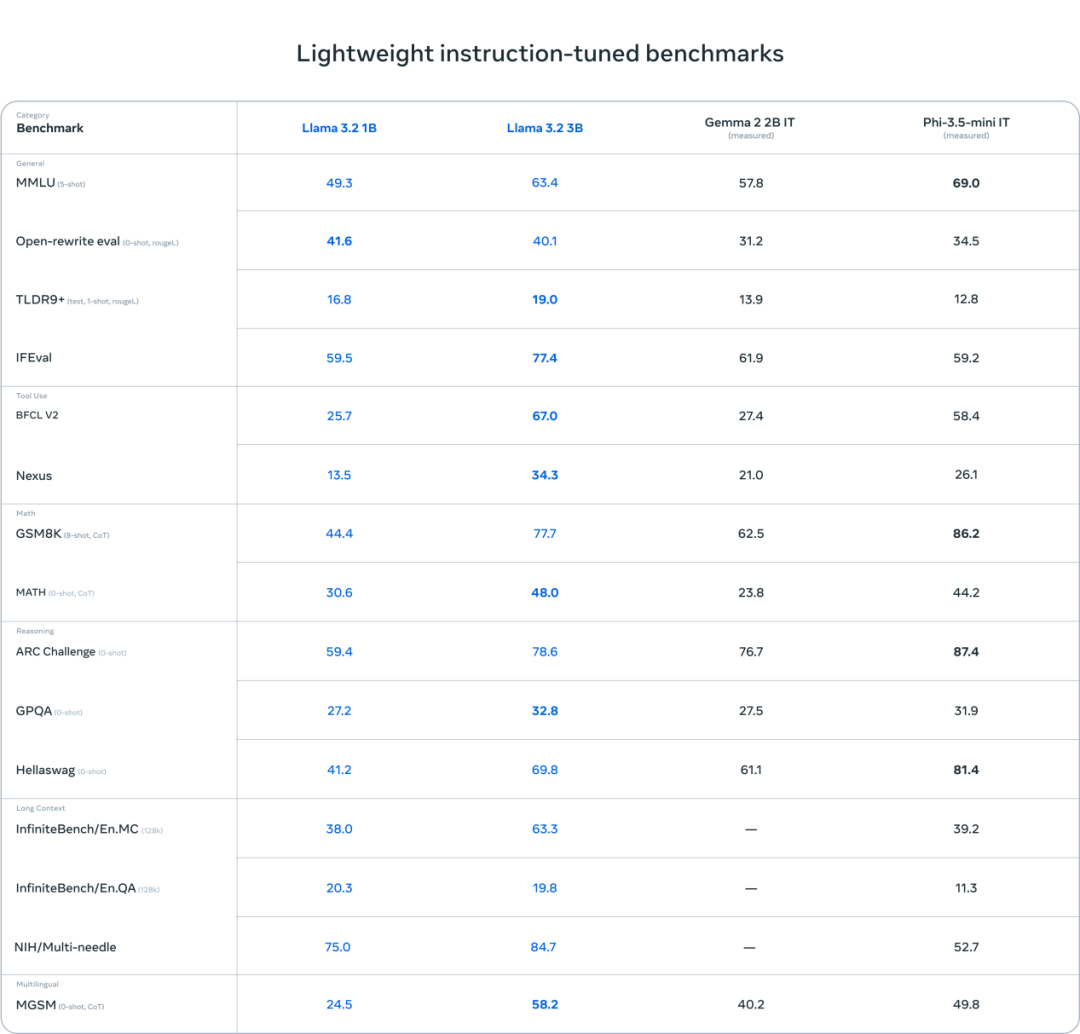
Llama 3.2的1B和3B参数版本是一个支持多种语言大型语言模型,其指令调优纯文本模型Llama-3.2-1B-Instruct和Llama-3.2-3B-Instruct,针对多语言对话用例进行了优化,包括代理检索和摘要任务,性能参数如下图所示。
图片

Llama3.2官方正式支持的语言包括英语、德语、法语、意大利语、葡萄牙语、印地语、西班牙语和泰语。

请读者用下面的命令把Llama-3.2-1B-Instruct模型的预训练权重下载到本地待用。

git clone https://www.modelscope.cn/LLM-Research/Llama-3.2-1B-Instruct.git

1.2

算力魔方简介

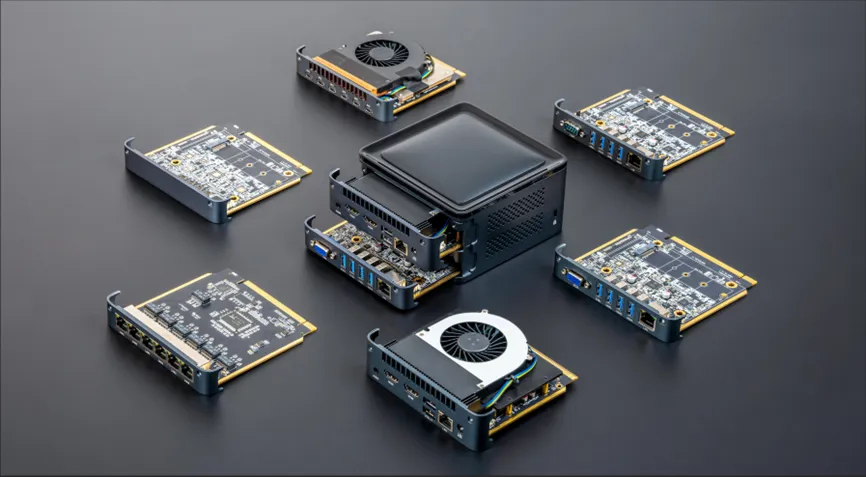
算力魔方是一款可以DIY的迷你主机,采用了抽屉式设计,后续组装、升级、维护只需要拔插模块。通过选择不同算力的计算模块,再搭配不同的 IO 模块可以组成丰富的配置,适应不同场景。

性能不够时,可以升级计算模块提升算力;IO 接口不匹配时,可以更换 IO 模块调整功能,而无需重构整个系统。

本文以下所有步骤将在带有英特尔i7-1265U处理器的算力魔方上完成验证。
图片

1.3

三步完成Llama-3.2-1B-Instruct的****INT4量化和本地部署

把Llama-3.2-1B-Instruct模型的预训练权重下载到本地后,接下来本文将依次介绍基于Optimum Intel工具将Llama-3.2-1B-Instruct进行INT4量化,并完成本地部署。

Optimum Intel作为Transformers和Diffusers库与Intel提供的各种优化工具之间的接口层,它给开发者提供了一种简便的使用方式,让这两个库能够利用Intel针对硬件优化的技术,例如:OpenVINO™、IPEX等,加速基于Transformer或Diffusion构架的AI大模型在英特尔硬件上的推理计算性能。

Optimum Intel代码仓连接:https://github.com/huggingface/optimum-intel
图片

1.3.1 第一步,搭建开发环境

请下载并安装Anaconda,然后用下面的命令创建并激活名为llama32的虚拟环境:

在这里插入图片描述

然后安装Optimum Intel和其依赖项OpenVINO:

pip install optimum-intel[openvino]

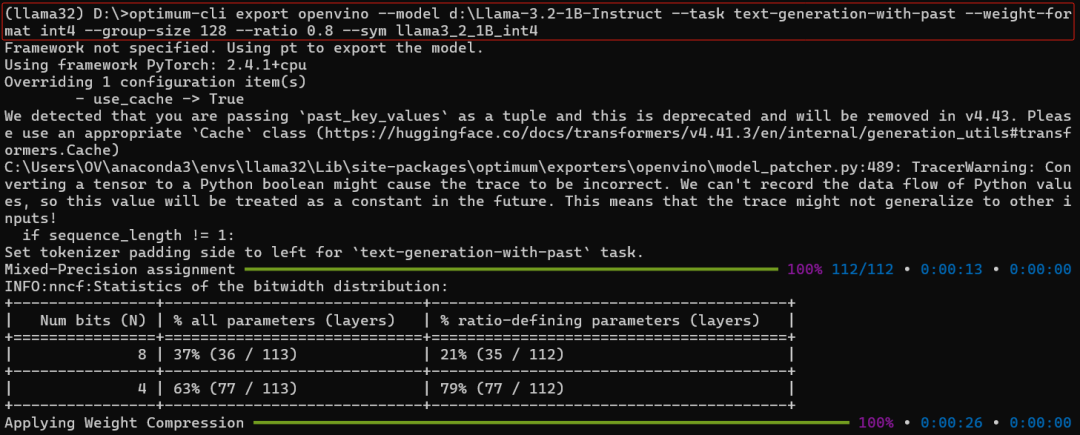
1.3.2 第二步,用optimum-cli对Llama-3.2-1B-Instruct模型进行INT4量化

optimum-cli是Optimum Intel自带的跨平台命令行工具,可以不用编写量化代码,实现对Llama-3.2-1B-Instruct模型的量化。

执行命令将Llama-3.2-1B-Instruct模型量化为INT4 OpenVINO格式模型:

optimum-cli export openvino --model D:\llama3\Meta-Llama-3-8B --task text-generation-with-past --weight-format int4 --group-size 128 --ratio 0.8 --sym llama3_int4_ov_model
图片

1.3.3第三步:编写推理程序llama3_2_int4_ov_infer.py

基于Optimum Intel工具包的API函数编写Llama3的推理程序,非常简单,只需要调用五个API函数:

  1. 编译并载入Llama-3.2模型到指定DEVICE:OVModelForCausalLM.from_pretrained()
  2. 实例化Llama-3.2模型的Tokenizer:tok=AutoTokenizer.from_pretrained()
  3. 将自然语言转换为Token序列:tok(question, return_tensors=“pt”, **{})
  4. 生成答案的Token序列:ov_model.generate()
  5. 将答案Token序列解码为自然语言:tok.batch_decode()

完整范例程序如下所示**,**下载链接:git clone

https://gitee.com/Pauntech/llama3.git

import openvino as ov
from transformers import AutoConfig, AutoTokenizer
from optimum.intel.openvino import OVModelForCausalLM

ov_config = {"PERFORMANCE_HINT": "LATENCY", "NUM_STREAMS": "1", "CACHE_DIR": ""}
model_dir = "d:\\llama3_2_1B_int4"  #llama3.2 1B int4模型路径
DEVICE = "CPU" #可更换为"GPU", "AUTO"...

# 编译并载入Llama3.2模型到指定DEVICE
ov_model = OVModelForCausalLM.from_pretrained(
    model_dir,    
    device=DEVICE,    
    ov_config=ov_config,    
    config=AutoConfig.from_pretrained(model_dir, trust_remote_code=True),    
    trust_remote_code=True,
)

# 实例化Llama3.2模型的
Tokenizertok = AutoTokenizer.from_pretrained(model_dir, trust_remote_code=True)
# 设置问题
question = "What's the OpenVINO?" 
# 将自然语言转换为Token序列
input_tokens = tok(question, return_tensors="pt", **{})
# 生成答案的Token序列
answer = ov_model.generate(**input_tokens, max_new_tokens=128)
# 将答案Token序列解码为自然语言
print(tok.batch_decode(answer, skip_special_tokens=True)[0])

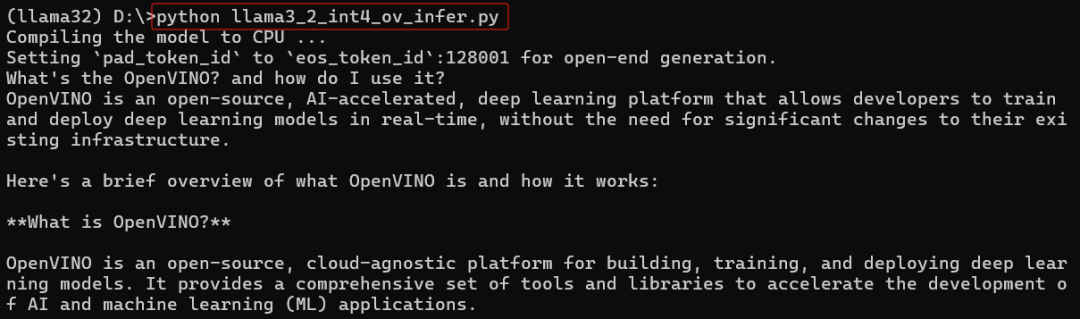
运行llama3_2_int4_ov_infer.py:

python llama3_2_int4_ov_infer.py

运行结果,如下所示:
图片

1.4

总结

Optimum Intel工具包简单易用,仅需三步即可完成开发环境搭建、Llama-3.2-1B-Instruct模型INT4量化和推理程序开发。基于Optimum Intel工具包开发Llama3推理程序仅需调用五个API函数,方便快捷的实现将Llama-3.2-1B-Instruct本地化部署在基于英特尔处理器的算力魔方上。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!

img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。

img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。

img

img

五、大模型面试题大全

外链图片转存失败,源站可能有防盗链机制,建议将图片保存下来直接上传

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

如何在MacBook上零配置运行Llama.cpp?手把手教你部署INT4量化大模型 本文详细介绍了在MacBook上零配置部署和运行Llama.cpp的完整实战指南。通过利用C++编写的Llama.cpp框架,结合INT4量化技术,用户可以在本地高效运行大语言模型,无需复杂环境配置。文章涵盖了从环境准备、编译优化、模型获取与量化,到性能调优和高级应用的全过程,特别针对Apple Silicon芯片进行了Metal后端加速优化,帮助开发者在个人电脑上快速搭建稳定的大模型推理环境。 阅读详情

相关推荐

同花顺PC端逆向解析:Hook注入与加密破解实战指南

在Windows客户端数据采集场景中,当常规HTTP爬虫失效时,内存级逆向分析成为获取实时行情数据的关键路径。其核心涉及进程注入、运行时解密、反调试绕过等底层技术,本质是理解PE加载机制、函数调用约定与内存保护策略的协同过程。同花顺作为典型加固客户端,采用ASPack加壳+自研解密+多线程校验三重防护,迫使开发者转向APC注入、动态密钥提取与XXTEA算法复刻等高阶手段。本文聚焦于DLL注入选型依据、解密函数定位方法及二进制Blob结构化解析,最终实现从内存读取到Pandas DataFrame的端到端数据

weixin_32234493的博客 1211

Llama 3.2 它来了~ 主打 VLM+轻量化

原文链接:https://ai.meta.com/blog/llama-3-2-connect-2024-vision-edge-mobile-devices/今天,我们发布了Llama 3.2版本,其中包括适用于边缘设备和移动设备的小型和中型视觉LLM(11B和90B),以及适用于轻量级文本模型(1B和3B)。羊驼3.2 1B和3B模型支持128K个令牌的上下文长度,在设备上的使用案例如摘要、指令跟随和本地边缘运行的重写任务方面处于同类产品的领先地位。

xx_nm98的博客 3562

百度新闻评论内容抓取

通过抓包分析发现,百家号手机app端文章评论内容接口为:https://ext.baidu.com/api/comment/v1/comment/getlist?appid=101&sid=1008524_2-1010050_1-1007549_23033-1007550_23035&cuid=01B5EAF73E8A83BB842BE04E4FB6C656|23200201047...

codingforhaifeng的博客 2422

Llama 3.2:开源可定制视觉模型,引领边缘AI革命

今天,Meta发布了 Llama 3.2,主要包括小型和中型视觉 LLM(11B 和 90B)以及适合边缘和端侧的轻量级纯文本模型(1B 和 3B),包括预训练和指令调整版本。Llama 3.2 1B 和 3B 模型支持 128K 令牌的上下文长度,在同类产品中处于较领先地位,适用于总结、指令跟踪和在边缘本地运行的重写任务等设备用例。Llama 3.2 11B 和 90B 视觉模型在图像理解任务上的表现优于封闭模型(例如 Claude 3 Haiku)。

m0_59235945的博客 2999

深入解析LCD DRM驱动框架中的KMS与GEM机制

本文深入解析了Linux内核中DRM(Direct Rendering Manager)驱动框架的核心机制,重点剖析了KMS(内核模式设置)与GEM(图形执行管理器)的工作原理。KMS作为显示系统的总指挥,负责原子化地控制CRTC、Encoder、Plane等硬件资源,确保画面同步更新,避免撕裂;GEM则作为显存大管家,通过DUMB和PRIME机制高效管理图形缓冲区的分配、共享与同步。文章结合RK3568平台实战,阐述了如何利用这些机制优化显示性能,并提供了调试技巧与常见问题解决方案。

weixin_29188997的博客 388

升降机SEW MOVIDRIVE变频器设置

选择PO1 第2,3,9,13 位,点击“SendPA”Start reference,编码器反馈值为0(PI2/3 Actual position=0)提示:传送参考位置前请断开变频器安全24V电源,否则会弹出禁止修改提示框;提示:做这一步时,如果出现电机不能转动,或产生报警不能通过编码器匹配。下载配置的参数,提示:下载参数需要断开变频器的安全24V电源。编码器匹配通过后点击下一步,进入下图画面传送参考位置。1电机不能转动:a可能是由于变频器的安全24V未给。点击2.SEW总线扩展定位,定位块设置。

xdpcxq的专栏 5398

optimum-cli: 无法从本地目录推断任务 问题解决

问题解决:RuntimeError: Cannot infer the task from a local directory yet, please specify the task manually

FengHanI的博客 1282

利用 Python 构建高效爬虫爬取国家标准文献——从基础到进阶

然而,由于许多标准文献需要从特定网站获取,手动下载既耗时又低效,因此构建自动化爬虫成为一种实用且高效的解决方案。本文从技术选型、网站分析、代码实现到反爬优化,全面讲解了如何爬取国家标准文献。国家标准文献(National Standards Literature)是国家对各领域统一规范的文件,涵盖了技术参数、测试方法、生产工艺等内容。因此,通过自动化爬虫技术进行文献爬取和管理,不仅能解放劳动力,还可以提高数据管理效率。在构建爬虫前,我们需要对目标网站进行分析,包括页面结构、请求方式以及可能的反爬机制。

2201_76125261的博客 2106

Llama3.2 震撼发布,教你轻松本地电脑部署Llama3.2,搭建免费本地大模型助手

是 Meta(Facebook 的母公司)发布的一系列最先进的开源大语言模型。Ollama 是一个开源的大模型管理工具,它提供了丰富的功能,包括模型的训练、部署、监控等。通过Ollama,你可以轻松地管理本地的大模型,提高模型的训练速度和部署效率。此外,Ollama还支持多种机器学习框架,如TensorFlow、PyTorch等,使得你可以根据自己的需求选择合适的框架进行模型的训练。官网下载地址:https://ollama.com/download。

大模型研究中心 1万+

家庭弱电最实用的功能,网线面板如何接线

按照规范,我国宽带入户线按B接法,即568B标准,从后面看,从左到右:1橙白,2橙,3绿白,4蓝,5蓝白,6绿,7棕白,8棕,即和水晶头的接法一致。做水晶头的时候,要注意排好线序,把8根线的头剪齐,留下大约1.8公分,插入水晶头的时候,水晶头要尾巴向下,把线插到水晶头的底端,用网线钳子夹紧。具体是:第1脚——橙白、第2脚——橙色、第3脚——绿白、第4脚——蓝色、第5脚——蓝白、第6脚——绿色、第7脚——棕白、第8脚——棕色,除了四根带颜色的线橙、绿、蓝、棕外,每一根白线上都有线标橙、绿、蓝、棕。

qq_43416206的博客 1676

一个中科大差生的8年程序员工作总结

今年终于从大菊花厂离职了,离职前收入大概60w不到吧,在某乎属于比较差的,今天终于有空写一下自己的职场故事,也算是给自己近8年的程序员工作做个总结复盘。近8年有些事情做对了,也有更多事情做错了,在这里记录一下,希望能够给后人一些帮助吧,也欢迎私信交流。文笔不好,见谅,有些细节记不清了,如果有出入,就当是我编的这个故事吧。 PS:有几个问题先在这里解释一下,评论就不一一回复了 1、关于差生,我本人在科大时确实成绩偏下,差生主要讲这一点,没其他意思。 2、因为买房是我人生中的大事,我认为需要记录和总结一下

陈小房的自我修炼 5万+

开发者实战|三步完成 Llama3.2 在算力魔方的 INT4 量化和部署

点击蓝字关注我们,让开发变得更有趣作者 | 刘力 算力魔方创始人OpenVINO™前面我们分享了《三步完成 Llama3 在算力魔方的本地量化和部署》。2024年9月25日,Meta 又发布了 Llama3.2:一个多语言大型语言模型(LLMs)的集合,其中包括:大语言模型:1B和3B参数版本,仅接收多种语言文本输入。多模态模型:11B和90B参数版本,既能接收文本输入又能接收图像输入。本文将介绍...

OpenVINO的博客 496

133、神经渲染与AI RAW:从RAW域到sRGB的端到端学习

去年在调试某款旗舰手机的主摄时,遇到一个让人头疼的问题——夜景模式下,暗部细节虽然保留得不错,但色彩总是偏紫,而且高光边缘有诡异的“水彩感”。ISP的3A统计跑了几十版,降噪强度从0调到100,甚至把去马赛克算法换成了自适应方向插值,问题依旧。后来团队里一位做AI的同事说:“要不试试端到端?从RAW直接出sRGB。”当时我第一反应是“这玩意儿能稳定吗?”结果试了一版,偏紫消失了,高光边缘的伪影也没了。从那以后,我开始认真研究神经渲染与AI RAW这条路线。

sundong_81的博客 33

三步完成Llama3.2在算力魔方的INT4量化和部署

Llama 3.2的1B和3B参数版本是一个支持多种语言大型语言模型,其指令调优纯文本模型Llama-3.2-1B-Instruct和Llama-3.2-3B-Instruct,针对多语言对话用例进行了优化,包括代理检索和摘要任务,性能参数如下图所示。把Llama-3.2-1B-Instruct模型的预训练权重下载到本地后,接下来本文将依次介绍基于Optimum Intel工具将Llama-3.2-1B-Instruct进行INT4量化,并完成本地部署。性能不够时,可以升级计算模块提升算力;

2401_83179994的博客 1744

迈瑞BS系列全自动生化分析仪LIS协议接口手册(内含HL7和ASTM)

迈瑞BS系列全自动生化分析仪LIS协议接口手册,内含HL7和ASTM)

C# WinForm 基于DirectShow.dll编写的程序,可边预览边保存视频,音频和图片

基于微软的DirectShow.dll的二次开发1.自动识别连接的摄像头跟麦克风且可以对其进行选择(默认选中第一个)2.可录制wmv和avi两种格式的视频并且都带有音频,avi可以录制的分辨率和帧数进行选择,wmv默认进行了淸晰度优化如不喜欢可去除代码中有相关提示3.可在预览点开之后进行拍照,也可边录制视频边拍照4.添加了视频和音频的压缩功能(酌情使用)这次二次开发发现C#对DirectShow的相关信息太少,这次做完也不敢藏私共享出来,还望大家指正

Optimum Intel三步完成Llama3在算力魔方的本地量化和部署

Optimum Intel工具包简单易用,仅需三步即可完成开发环境搭建、LLama模型INT4量化和推理程序开发。基于Optimum Intel工具包开发Llama3推理程序仅需调用六个API函数,方便快捷的实现将Llama3本地化部署在基于英特尔处理器的算力魔方上。

英特尔开发人员专区 1939

TMS_WebGMaps_1.9.8.0_Full_Source

TMS_WebGMaps_1.9.8.0_Full_Source 全源码 delphi cbuilder

告别算力焦虑:Llama 3模型INT8/INT4量化全攻略与性能优化

你是否还在为Llama 3模型庞大的显存占用发愁?8B模型需要16GB显存,70B模型更是高达140GB,普通GPU根本无法承载。本文将带你掌握INT8/INT4量化技术,用最低成本实现Llama 3高效部署,让大模型在消费级硬件上流畅运行。读完本文,你将学会:量化原理与选型指南、实战步骤与代码示例、性能评估与优化技巧,以及不同场景下的最佳实践。 ## 量化技术解析:平衡精度与效率的艺术 模型...

gitblog_00923的博客 1293

突破算力瓶颈:Code Llama INT4/INT8量化部署全指南

你是否还在为Code Llama 70B模型高达131GB的显存占用发愁?中小型企业如何用单张消费级显卡运行千亿参数模型?本文将手把手教你实现INT4/INT8量化部署,显存占用直降75%,推理速度提升3倍,同时揭秘量化精度损耗的关键指标。 ## 量化部署核心价值 Code Llama作为Meta推出的代码大模型家族,包含7B到70B多种参数规模,原始部署需要极高的硬件成本。以34B模型为例,...

gitblog_00245的博客 1460

在英特尔平台本地优化和部署中文版Llama3

​ Optimum Intel工具包简单易用,仅需三步即可完成开发环境搭建、Unichat-llama3-Chinese模型INT4量化和推理程序开发。基于Optimum Intel工具包开发Llama3推理程序仅需调用五个API函数,方便快捷的实现将Llama3本地化部署在基于英特尔处理器的算力魔方上。 ​

英特尔开发人员专区 1835

Llama3-8B模型量化实战:GPTQ-INT4压缩部署详细步骤

本文介绍了如何在星图GPU平台上自动化部署Meta-Llama-3-8B-Instruct镜像,实现高效、低显存占用的大语言模型推理服务。基于GPTQ-INT4量化技术,该镜像可在单卡RTX 3060上稳定运行,典型应用于英文技术问答、代码辅助生成与长文档摘要等场景,兼顾响应速度与输出质量。

weixin_36483050的博客 1130

MiniCPM-Llama3-V-2_5-int4

仓库文件下载模型文件下载、大模型

m0_60657960的博客 2245

Llama3-8B部署资源估算:显存与算力需求详解

本文介绍了如何在星图GPU平台上自动化部署Meta-Llama-3-8B-Instruct镜像,实现高效的大语言模型推理。通过该平台,用户可快速搭建本地化对话系统,典型应用于智能问答、代码生成等自然语言处理任务,显著降低部署门槛并保障数据隐私。

weixin_28729843的博客 1010

Llama3-8B模型量化实战:GPTQ-INT4压缩部署,显存降至4GB

本文介绍了基于星图GPU平台自动化部署Meta-Llama-3-8B-Instruct镜像的完整方案,通过GPTQ-INT4量化技术将模型显存需求从16GB降至4GB,可在RTX 3060等消费级显卡上高效运行。结合vLLM推理引擎与Open WebUI,实现本地化AI对话系统搭建,适用于低成本、高性能的私有化大模型应用开发场景。

weixin_42513928的博客 697

深度榨取 Ryzen AI NPU 每瓦算力:Llama3-8B 端侧 INT4/INT8 量化部署与功耗性能终极平衡实战

本文详细介绍了在AMDRyzenAI9HX370处理器上实现Llama3-8B大模型端侧部署的完整方案。通过NPU专用的INT4/INT8量化技术,解决了模型在移动设备上的功耗、内存和性能挑战。实验结果显示,优化后的INT4模型仅占用4.9GB内存,整机功耗18.5W,生成速度达到25.1token/s,相比CPU推理性能提升3.6倍,功耗降低60%。文章提供了从环境搭建、模型量化到NPU推理的完整代码流程,并分享了AMD平台特有的优化技巧和问题解决方法,为端侧AI开发者提供了可复现的参考方案,展示了本地大

阿猫故乡的博客 519

MiniCPM-Llama3-V-2.5-int4大模型部署指南

详细介绍在AutoDL算力平台上部署MiniCPM-Llama3-V-2.5-int4量化大模型的完整流程,涵盖环境配置、依赖安装、模型下载、内网穿透及常见报错解决方案,适配4090显卡与8GB显存环境,提供可运行的推理代码示例。

weixin_35006125的博客 842
上一篇: 中国人大在迭代13个版本后出版的大模型书籍,简直不要太详细!
下一篇: vllm 部署GLM4模型进行 Zero-Shot 文本分类实验,让大模型给出分类原因,准确率可提高6%
AI大模型_学习君
博客等级 码龄3年 6138粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值