知识链=知识图谱+大模型+推理-幻觉

Unifying Large Language Models and Knowledge Graphs: A Roadmap综述笔记-入门-知识图谱KG-大模型LLM LLMs,例如chatGPT和GPT4,由于其涌现能力和泛化性,对自然语言理解和人工智能领域产生了新的冲击。然而,LLMs是一个黑箱模型,往往缺乏捕获和获得事实知识。相反,知识图谱,例如维基百科等,是有结构模型。存储着丰富的事实知识。KGs可以通过提供额外的知识去增强大语言模型的推理和解释性。同时,知识图谱也很难去自然构造和进化,对于现有的知识图谱方法来说,生成新的事实和表示未知数据是一个挑战。因此,统一LLMs和KG,同时利用他们的优点是一种补充。在这篇文章中,我们提出了统一LLMs和KG的路线图。 阅读详情

最近由华东师大和香港大学联合提出了一种面向大语言模型推理的幻觉缓解方法Chain-of-Knowledge被ACL2024接收为长文主会。

PDF: https://arxiv.org/pdf/2306.06427

最近这两年,诸如GPT-4、LLaMA3等一系列超百亿规模的大语言模型相继提出,这些大模型以其大规模参数、大规模语料和大规模算力为基础,展现出了极为强大的语义理解和推理生成能力。

为了更好地引导大语言模型完成复杂任务的推理,一些面向大模型提示工程被相继提出,包括Chain-of-Thougt(CoT)、Self-Consistency、Program-of-Thought(PoT)、ReAct等。在这些提示工程的引导下,大模型可以遵循一定的模式完成问题的理解、规划、推理和解答。

不过即便如此,大语言模型在推理过程中依然会存在幻觉,这通常表现在对问题的规划和推理步骤存在事实性错误或逻辑错误。为此,如何能够识别并纠正这些错误对缓解大模型幻觉问题具有重大价值。
图片

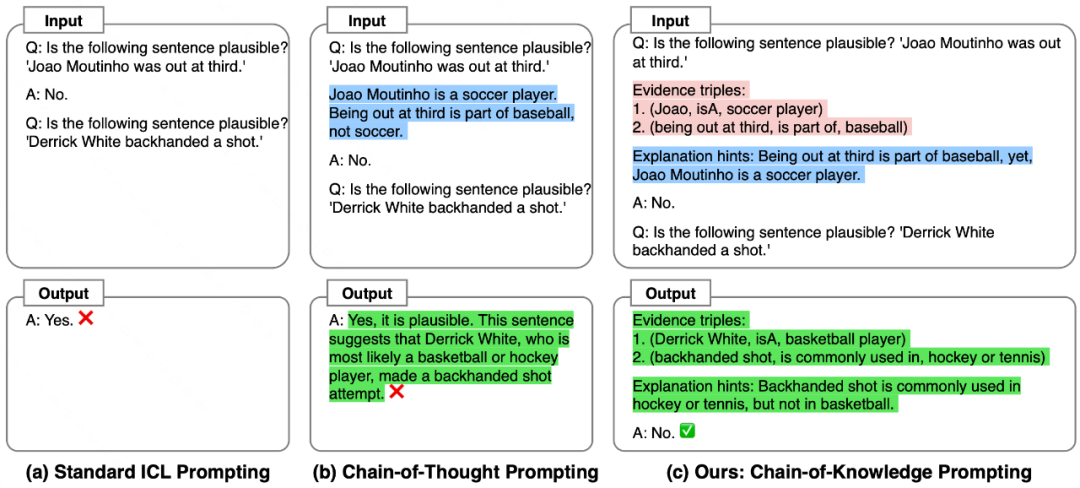
例如如上图所示,传统的推理方法是构造若干Input-Output Pair,从而大模型可以遵循这样的模式进行生成;CoT则在此基础上增加了推理路径,实验和理论发现CoT可以很好地提高大模型的推理能力。不过在实际使用中,依然会存在一些错误,这通常是因为大模型对目标问题存在没有掌握的知识,使得其在某个具体的推理步骤上犯错。

为了提高大模型的推理能力,缓解幻觉问题,本文从三个方面进行了改进。

提示工程:Chain-of-Knowledge Prompting

既然CoT存在一定的不足,那么就先从最简单的提示工程出发。回到刚才的图,我们发现大模型在回答问题时,虽然CoT可以在形式上约束大模型要给出推理步骤,但是由于这种推理步骤是以自然语言形态表达,大模型很有可能会生成出错误的中间结果,而自然语言文本模态的中间步骤很难判断其正确与否。

为此,作者尝试增加一项约束,即让大模型给出明确的推理证据三元组(Evidence Triple)。类似于知识图谱中的三元组,每个三元组由Subject、Relation和Object组成,描述一个推理过程则可以用若干个三元组组成,如以下例子:

假设问题:“乔丹为什么被认为是篮球史上最伟大的球员之一?” 传统的CoT方法可能会生成自然语言的推理步骤,但可能会遗漏关键证据或包含错误信息。使用CoK方法,模型会生成如下证据三元组:

  1. (迈克尔·乔丹,获得,6次NBA总冠军)
  2. (迈克尔·乔丹,获得,5次常规赛MVP)
  3. (迈克尔·乔丹,影响了,篮球的全球推广)

通过这种结构化的表达,我们可以发现可以较好地提高推理能力。因为,大模型产生幻觉通常会因为长篇大论的文本解释从而出错,而显式地给出依据则会间接约束大模型不能用模糊的解释来蒙混过关。

幻觉度量

不过,虽然通过CoK提示工程的引导,还是没有办法100%的避免幻觉问题。为此,我们需要找到这些可能错误错误的推理步骤,并尝试纠正他们。

一般地,不论是常识推理还是符号推理,虽然可以通过最终大模型预测的答案来判断其推理过程中间是否可能出错,但是想具体定位到错误的步骤是比较困难的。为此,我们借助CoK提示的结构,尝试将其与外部知识库进行对齐。

给定一个Prompt和大模型给出的CoK推理路径(包括文本模态的推理路径,和结构化的推理路径)。作者提出两个度量方式:

  • 基于忠实性的幻觉度量:忠实性是指大模型生成的结果与其输入的事实一致性,通常应用在文本摘要、机器翻译等场景。对于推理中,则表示当前推理步骤是否与上下文存在关联。先前一些工程采用类似自然语言推断(NLI)的形式来度量忠实性,作者则采用预训练的SimCSE来作为衡量指标。
  • 基于事实性的幻觉度量:大模型出现错误的另一个原因是某个步骤产生了事实错误,换句话说,其给出的某个推理三元组可能是错误的。为此,作者采用TransR等知识表示学习方法来估计每个证据三元组的正确与否,对于错误的三元组,其对应的得分会低于某个阈值,从而可以推断其是错误的。

Rethinking策略

如果对于一个Prompt,大模型生成的推理步骤经过两个幻觉度量之后被认为存在错误,那么就需要对其进行纠正。作者借鉴了目前的RAG思想,尝试通过对外部知识进行检索增强的形式来提高其在某一个错误的推理步骤上的准确性。

但不同于RAG的是,Rethinking算法则是先基于忠实性和事实性度量指标找到错误的推理三元组,其次对这部分三元组检索外部知识库并实现知识增强,最后基于增强的知识以及原先错误的信息提示大模型进行自我反思,并重新规划和思考当前的问题。整个过程不断迭代直到通过幻觉度量。

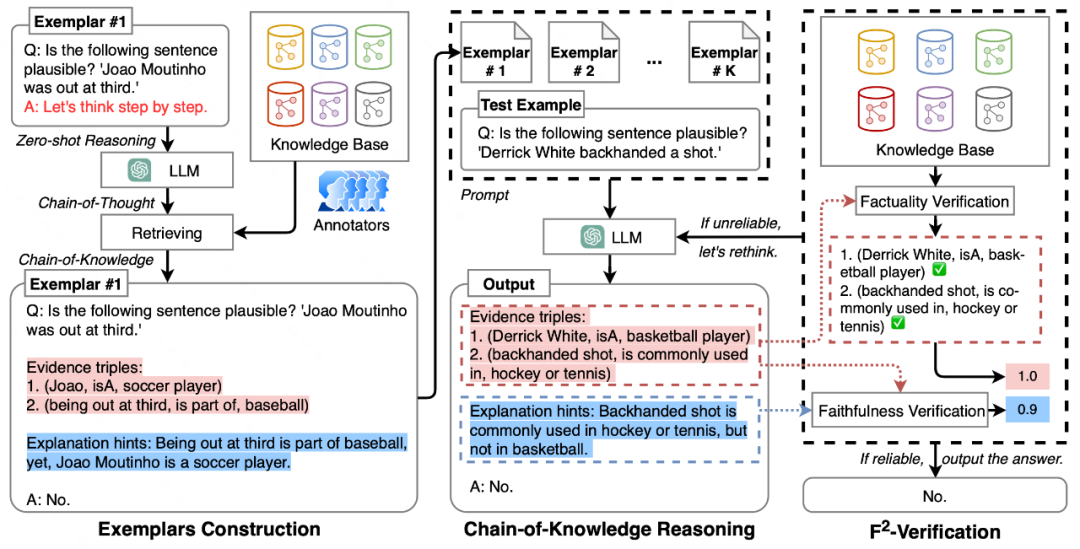
整个框架的结构如下图所示:
图片

(1)提示工程 提示工程中,直接采用CoT编写的提示作为文本模态推理路径。同时也采用Zero-Shot CoT的方法构造一些推理路径。为了得到这些exemplar的结构化证据三元组,作者采用人工标注的方法实现,为了确保证据链的准确性,在标注过程中会参考现有的知识图谱,以保证推理过程是准确无误的。

(2)幻觉度量 幻觉度量的得分范围为0-1。0分表示完全错误,1分表示完全正确。这里针对不同的数据集会在验证集上挑选合适的阈值。

(3)再思考算法 大模型会接收到幻觉度量的反馈结果,包括具体到每个推理步骤的正确与否信息。对于错误的证据三元组,会对其检索外部知识库里寻找最有可能正确的三元组,并以提示的形式在下一轮大模型回答时作为增强。这里需要强调的是,只针对错误的推理步骤进行知识检索,而不会将正确答案泄漏给大模型。以下为一个直观的例子:

设想模型被问到:“爱因斯坦发明了电灯吗?” 初始回答可能是:

  • 证据三元组:(爱因斯坦,发明了,电灯)

    解释: 爱因斯坦发明了电灯,所以答案是“是的”。

经F²验证,发现第一条证据与事实不符。于是,从知识库中检索到正确的证据:

  • (托马斯·爱迪生,发明了,电灯)

将正确的证据注入提示后,模型重新生成回答:

  • 新的证据三元组:

    1. (爱因斯坦,是,物理学家)
    2. (托马斯·爱迪生,发明了,电灯)
  • 解释: 电灯是由托马斯·爱迪生发明的,而爱因斯坦是著名的物理学家,所以答案是“不是”。

新的回答通过了F²验证,成功纠正了模型在常识推理中的错误

实验

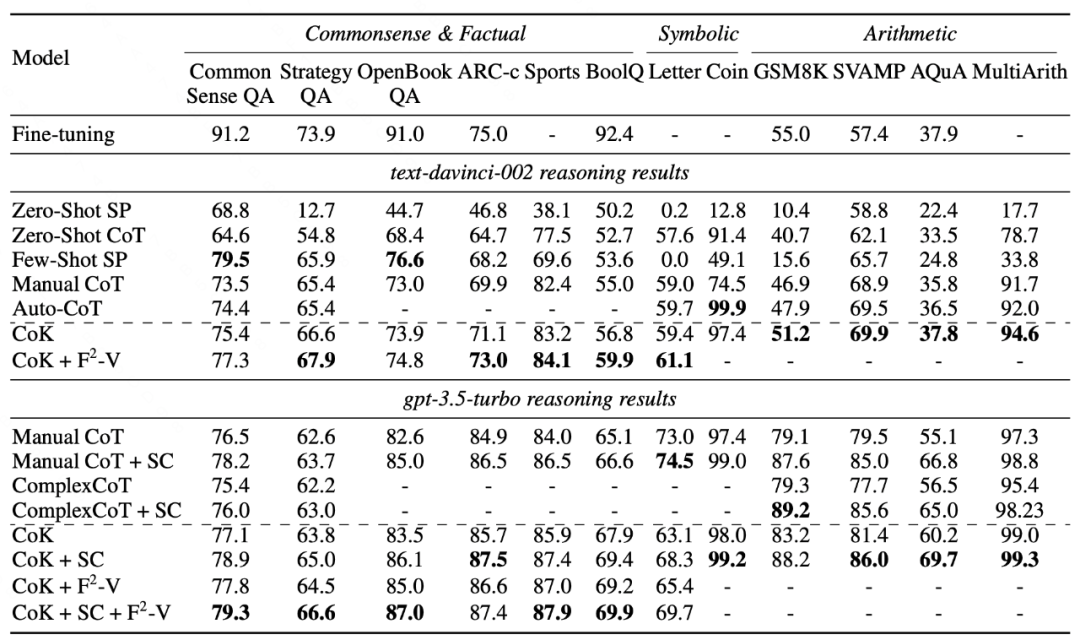
作者在包括常识与事实推理、算术推理和符号推理等任务上进行了实验。挑选了包括text-davinci-002、gpt3.5-turbo和gpt-4作为大模型基座。实验总体结果如下:
图片

实验结果呈现出CoK可以较好地在绝大多数任务上超越基线和SOTA。同时在Self-Consistency的增强下可以提高超过3%的准确率。

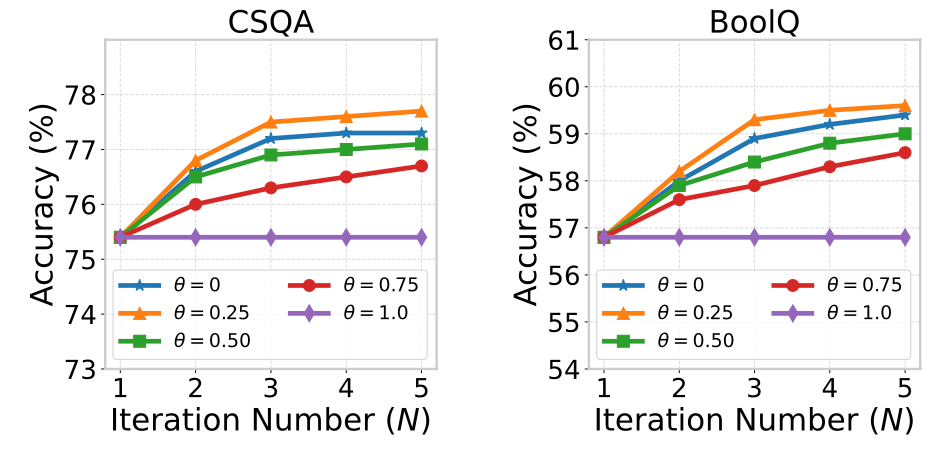
在BoolQ和CSQA上进行实验来验证再思考算法的收敛性,可发现大多数情况下大模型可以在第3轮回答正确。
图片

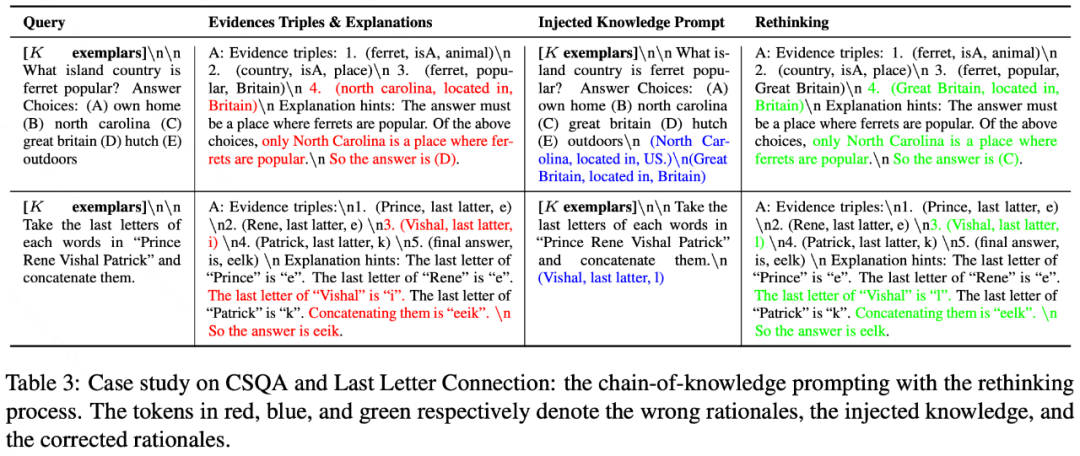
通过观察一些Case,可以发现在CoK的提示下,大模型可以生成出结构化的推理路径,并能够在再思考算法的增强下不断地提高准确性。
图片

未来展望

  • 应用拓展: CoK方法有望应用于法律推理、医学诊断等需要复杂推理的场景,提升模型在专业领域的应用价值。
  • 实时知识更新: 外部知识库可以被扩展为实时的搜索引擎,为模型提供最新的知识支持,进一步提高推理的准确性和时效性。

总结

该研究开创性地将结构化的知识证据引入大语言模型的推理过程中,提供了一种有效缓解幻觉问题的新途径。通过明确的证据三元组和针对幻觉的度量与纠正机制,模型的推理过程变得更加透明和可靠。这一方法不仅适用于当前的大模型,也为未来更复杂的推理任务提供了宝贵的参考。

​

如何学习大模型

现在社会上大模型越来越普及了,已经有很多人都想往这里面扎,但是却找不到适合的方法去学习。

作为一名资深码农,初入大模型时也吃了很多亏,踩了无数坑。现在我想把我的经验和知识分享给你们,帮助你们学习AI大模型,能够解决你们学习中的困难。

我已将重要的AI大模型资料包括市面上AI大模型各大白皮书、AGI大模型系统学习路线、AI大模型视频教程、实战学习,等录播视频免费分享出来,需要的小伙伴可以扫取。
一、AGI大模型系统学习路线

很多人学习大模型的时候没有方向,东学一点西学一点,像只无头苍蝇乱撞,我下面分享的这个学习路线希望能够帮助到你们学习AI大模型。

在这里插入图片描述

二、AI大模型视频教程

在这里插入图片描述

三、AI大模型各大学习书籍

在这里插入图片描述

四、AI大模型各大场景实战案例

在这里插入图片描述

五、结束语

学习AI大模型是当前科技发展的趋势,它不仅能够为我们提供更多的机会和挑战,还能够让我们更好地理解和应用人工智能技术。通过学习AI大模型,我们可以深入了解深度学习、神经网络等核心概念,并将其应用于自然语言处理、计算机视觉、语音识别等领域。同时,掌握AI大模型还能够为我们的职业发展增添竞争力,成为未来技术领域的领导者。

再者,学习AI大模型也能为我们自己创造更多的价值,提供更多的岗位以及副业创收,让自己的生活更上一层楼。

因此,学习AI大模型是一项有前景且值得投入的时间和精力的重要选择。

LLM⊗KG范式下的知识图谱问答实现框架思想阅读 分享一张有趣的图,意思是在分类场景下,使用大模型和fasttext的效果,评论也很逗。这其实背后的逻辑是,在类别众多的分类场景下,尤其是在标注数据量不缺的情况下,大模型的收益是否能够比有监督模型的收益更多。这个例子虽然没有说标注数据量,但估计量不会少。我们继续回到知识图谱与大模型的话题:读到一个大模型和知识图谱融合的有趣工作《 Think-on-Graph: Deep and Responsible Reasoning of Large Language Model on Knowledge Graph》( 阅读详情

相关推荐

LLM与知识图谱的协同与互补

论文地址:Unifying Large Language Models and Knowledge Graphs: A Roadmap自从2017年Transformer提出后,Bert系列、GPT系列及T5等在大规模语料库上预训练的大型语言模型已经可以在一些自然语言处理任务上发挥很好的效果了,如:文本分类,机器翻译,摘要生成,命名实体识别,智能问答等。随着模型规模的急剧增长,如GPT3、PaLM等模型具有数百上千亿的参数量,LLM进一步获得了涌现能力,可以解决更多更加复杂的任务,比如优秀的上下文学习能力,

dzysunshine的博客 4074

ERP专业知识讲座:11.知识链管理

相关链接: ERP专业知识讲座:1.ERP的管理思想         ERP专业知识讲座:2.业务流程重组 ERP专业知识讲座:3.采购管理                     ERP专业知识讲座:4.销售管理 ERP专业知识讲座:5.生产计划                     ERP专业知识讲座:6.人力资源管理 ERP专业知识讲座:7

云中客的专栏 2140

R2-KG:通用双Agent框架,用于知识图谱上的可靠推理

本周阅读的论文题目是《R2-KG: General-Purpose Dual-Agent Framework for Reliable Reasoning on Knowledge Graphs》(《R2-KG:通用双Agent框架,用于知识图谱上的可靠推理》)。近期研究将大型语言模型(LLM)与知识图谱(KG)相结合,以增强推理能力,在不进行额外训练的情况下提高推理准确度,同时减轻幻觉问题。

qq_60040306的博客 1075

知识链:知识图谱提升大模型的推理能力,解决多个知识点结合推理时出错 + 个性化方案

这段描述涉及到的“KNOWREASON”数据集、实体、关系、规则、样本以及跳数的概念都是在描述如何用一个复杂的数据结构来支持和训练大型语言模型(LLMs),尤其是在处理多步骤逻辑推理任务时的性能。结合“知识链”方法和MindMap确实是一个有前景的方向,可以创建一个更强大、更全面的推理系统,特别适合于复杂和动态的应用场景如医疗问诊。在这种情况下,随着“hop”数的增加,所需处理的信息和规则变得更加复杂,需要更精确和具体的规则来确保诊断和治疗的准确性。

Debroon 3169

KG-RAG: 知识图谱增强的检索增强生成技术

在一个具体的测试中,研究人员比较了使用和不使用KG-RAG的GPT-4在回答关于FDA批准药物的问题时的表现。结果显示,使用KG-RAG的GPT-4能够提供更加准确和详细的信息,而没有使用KG-RAG的GPT-4则可能给出不完整或过时的答案。通过将结构化知识与先进的语言理解能力相结合,KG-RAG正在推动AI系统向更智能、更可靠的方向发展,为未来的人工智能应用开辟了新的可能性。: 通过结合知识图谱的结构化信息,KG-RAG能够显著减少LLM的幻觉问题,提供更加准确和可靠的回答。

2401_87458718的博客 1758

大模型幻觉终结者:知识图谱如何让AI原生应用输出更可靠?(实战验证)

大模型(LLM)的“幻觉问题”——生成看似合理但不符合事实的内容——是其在医疗、法律、教育等关键领域应用的致命障碍。本文从第一性原理出发,剖析幻觉的本质(统计概率模型的固有缺陷),论证知识图谱(KG)作为“显式知识载体”的解决方案:通过结构化知识约束大模型的生成空间,实现“概率预测+事实验证”的双轮驱动。文中提出融合知识图谱的AI原生应用架构,结合实战案例(智能医疗问答系统)详细说明实现步骤:从知识图谱构建(实体/关系抽取)、到与大模型的集成(Prompt注入、插件模式)、再到实时事实核查的工程优化。

AI算力网络与通信的博客 1227

知识链(Chain-of-Knowledge):通过对异构来源的动态知识适配实现大语言模型的知识落地

CHAIN-OF-KNOWLEDGE: GROUNDING LARGE LANGUAGE MODELS VIA DYNAMIC KNOWLEDGE ADAPTING OVER HETEROGENEOUS SOURCES》这篇论文介绍了一个名为“chain-of-knowledge”(CoK)的框架,旨在通过动态整合来自异构知识源的信息来增强大型语言模型(LLMs)的性能,减少生成中的幻觉(hallucination)现象,并提高回答的准确性。论文详细描述了CoK框架的设计、实现和实验验证。

weixin_43344118的博客 972

如何让大模型更好地完成知识图谱推理?

该论文探索了如何将知识图谱中的结构知识引入大语言模型中,以更好地完成知识图谱推理,同时提出了一个新的知识前缀适配器,将从知识图谱中提取到的向量化的结构知识注入到大模型中。在未来,作者将进一步探索基于大语言模型的复杂知识图谱推理,同时也将关注如何利用知识图谱使得大语言模型能够在知识感知的情况下完成更多下游任务比如问答、对话等等。关于TechBeat人工智能社区▼TechBeat(www.techbeat.net)隶属于将门创投,是一个荟聚全球华人AI精英的成长社区。

TechBeat人工智能社区博客 1908

技术动态 | 大模型用于知识图谱推理常用范式:兼论基于TransE模型的知识推理实践...

转载公众号 | 老刘说NLP知识推理是从已有的知识出发,得出未知的、隐性的知识,具体到知识图谱中,即利用图谱中现有的知识(三元组),得到一些新的实体间的关系或者实体的属性(三元组)。关于知识推理这一任务,我们已经在《OGB-知识推理概览必读:三大推理评测任务、数据集与现有模型水平概述》、《技术总结:知识图谱推理中的常用方法、关键问题、评测指标与开放数据总结》等文章中进行了理论性的介绍。其中知识图谱...

开放知识图谱 1390

大模型用于知识图谱推理常用范式:兼论基于TransE模型的知识推理实践

本文为了进一步从理论和实践的角度出发,完成一次知识推理的模型训练和推理小任务,增进大家对知识推理的了解,主要从知识推理的三个主流方法与基础任务、基于TransE模型的知识推理的训练、基于TransE模型的知识补全推理实验三个方面进行了介绍。

具身机器人和通用AI 1926

ADS谐波平衡仿真自动优化报错?三步搞定HB控件设置(附常见错误排查)

本文针对ADS谐波平衡仿真在自动优化中常见的报错问题,提供了三步核心排查法。首先检查并禁用HB控件中可能导致冲突的小信号仿真模式,其次合理化仿真频率与扫描参数设置,最后审视优化变量与目标的定义。通过精准配置HB控件以适配自动优化流程,能有效解决大多数仿真失败问题,确保非线性电路设计顺利进行。

c2d3e4f的博客 792

基于图约束的知识推理:利用KG-Trie结构精确控制LLM解码过程,有效解决知识图谱问答中的路径幻觉与跨图泛化问题

确实存在若干“隐性方法”,都是围绕如何检索并管理子图(BFS + Trie 构建)、如何在解码时处理分支搜索、以及多路径归纳所需的 prompt 设计等。将这些步骤提炼为一整套关键实现策略,可以看作是 GCR 的“幕后”技术要点。

Debroon 2102

DSP在线升级方案:TMS320C6678使用网络或者串口输出升级数据进行固件升级

下面这段先引用创龙的说明 IBL 运行后, 将从 NOR FLASH 或 NAND FLASH 的 0x00080000 地址引导 ELF/BBLOB 格式 用户程序。 当引导 ELF 格式用户程序时, IBL 会解析用户程序头部信息,并根据头部信息 拷贝不同的代码段至指定 CPU 内存地址,然后将 PC 指针跳转至_c_int00, 再运行用户程 序。当引导 BBLOB 格式用户程序时,由于无头部信息, IBL 会将用户程序拷贝至 0x9E000000 (该内存地址为 IBL 代码指定),并将 PC..

ToneChip的专栏,一个传统的嵌入式码农,裸机编程 1943

大模型知识图谱推理新范式:图约束推理(GCR)实现零幻觉,附完整代码与实验结果(建议收藏)

本文提出图约束推理(GCR)新框架,通过KG-Trie索引将知识图谱结构融入LLM解码过程,约束生成忠实于KG的推理路径。结合轻量级KG专用LLM与通用LLM协作,实现零幻觉、高精度推理。实验表明,GCR在WebQSP和CWQ等数据集上性能超越现有方法,完全消除幻觉,且能零样本迁移至新KG,效率显著优于智能体式方法。

weixin_55154866的博客 1853

微信聊天记录解密,必须是root的手机

手机上安装x-plore软件,将/data/data目录的相关EnMicroMsg.db auth_info_key_prefs.xml拷贝到/storge/emulated/0目录后才可以拷贝到电脑。路径:/data/data/com.tencent.mm/shared_prefs/auth_info_key_prefs.xml。但是是加密过的 需要解密 解密密码生成规则是手机IMEI+微信UIN md5(32位小写)后的前7位。安卓手机要root测试版本微信要7或者8版本都可以。选择message表。

venus60的专栏 1009

基于YOLOv8和PaddlepaddleOCR的微信截图聊天记录提取

本文提出了一种基于YOLOv8和PaddleOCR的微信聊天记录提取方法。首先使用YOLOv8n模型分割出聊天气泡(针对深浅色模式分别训练),通过合成数据集增强模型鲁棒性,召回率达0.995。随后采用PP-OCRv5进行文本识别,利用坐标匹配将气泡内文本送入识别队列,短长文本平均置信度分别>0.98和>0.95。文中特别强调了PaddleOCR不同版本的输出格式差异及适配方案,建议使用3.0+版本。该方法有效解决了直接OCR识别易受干扰的问题,通过气泡分割+文本定位的两阶段策略显著提升了识别准确

2401_87383958的博客 2358

【万字长文】LLM+KG:大模型与知识图谱融合的黄金时代,技术前景与实现路径全解析!

文章深入探讨LLM与知识图谱融合技术,分析LLM在复杂推理中的幻觉与知识过时痛点,提出从"单向增强"到"双向协同"的技术演进路径。详细介绍了KG作为背景知识、推理指导、优化验证器等角色,以及在医疗、法律等垂直领域的应用价值,并展望了神经符号深度融合、效率优化与知识动态对齐等未来发展方向。

2401_85373396的博客 1666

工创赛智能搬运小车实战:视觉定位、底盘控制与RTOS调度

智能搬运系统是嵌入式控制与机器视觉融合的典型工程实践,其核心在于视觉定位精度、运动控制稳定性与实时任务调度能力。在有限算力(如STM32H7)、低功耗约束和结构化场景下,传统CV方法(如FAST+RANSAC)比轻量级深度学习更具鲁棒性与实时性;而底盘控制需穿透PID表层,直击死区补偿、编码器硬件滤波与负载自适应等物理层细节;RTOS则不是炫技工具,而是保障多模块时序确定性的刚需——尤其在视觉-控制-执行强耦合链路中,任务优先级、事件组通信与栈安全直接影响系统存活。本文聚焦全国大学生工程训练竞赛(工创赛)真

weixin_29194693的博客 276

【收藏必学】图约束推理(GCR):消除大模型幻觉,实现知识图谱零样本迁移的新范式

Graph-constrained Reasoning (GCR)是一种新型框架,通过构建KG-Trie索引将知识图谱结构融入LLM解码过程,约束生成忠实于KG的推理路径,结合轻量级KG专用LLM生成推理路径与假设答案,再利用通用LLM进行归纳推理。该方法实现零幻觉、高精度的KG推理,在WebQSP、CWQ等数据集上表现优异,且能在未见KG上实现零样本迁移,准确率较纯LLM提升5%-8%,推理效率显著提高。

datian1234的博客 1105

在ubuntu20.04上配置VINS_Fusion(亲测有效,一应俱全)

最近在做科研训练的时候配置了HKUST-Aerial-Robotics实验室的VINS_Fusion代码项目,经历了一些编译报错的问题,在网上查找的时候博客内容良莠不齐,且实质针对性意见不多,于是在此记录下自己配置期间遇到的一些共性问题,留作自己日后参考和大家的交流学习。

wyr1849089774的博客 8273

2ED2410-EM:12v / 24v智能模拟高侧MOSFET栅极驱动器

12v / 24v智能模拟高侧MOSFET栅极驱动器。2ED2410-EM具有输入CPP和CPN的电压比较器。该比较器可用于基于任何模拟电压触发SAFESTATE模式,甚至是外部电压2ED2410-EM。CPP为比较器的正输入,CPN为负输入。VcPREF可以通过微控制器进行调节,也可以通过板载电源芯片(如英飞凌SBC)或简单的分压器在限制VcP(REF)内进行固定,以保持稳定性。使用此比较器允许2ED2410-EM进入SAFESTATE并独立于微控制器关闭MOSFET。

让学习成为一种习惯 2200

LLM+KG融合技术全解析:解决大模型幻觉与知识过时问题,必看收藏!

文章深入探讨了大语言模型(LLM)与知识图谱(KG)的融合技术,旨在解决大模型存在的幻觉、知识过时和推理能力不足等核心问题。从技术演进看,正从"单向增强"走向"双向协同"新范式,在医疗、法律等垂直领域展现巨大价值。文章系统分析了多种融合方法、评估体系及未来挑战,为解决多跳推理瓶颈和实现"零幻觉"可追溯生成提供了技术路径,是学习大模型与知识图谱融合的优质指南。

weixin_55154866的博客 1169

前后端面试题【目录】

工作时候扭螺丝,面试时候造火箭,现状就是如此。不管是背八股文,还是掌握了知识的精华,对答如流才是硬道理。本专栏就是要集具前端精华,规范、算法、架构、封装、原理等一并汇集,让前端的小伙伴有个思路。, 欢迎一起交流,并非常期望您能够提供有价值的学习资料。

大剑师兰特的GIS世界 1838

KG-RAG: 跨越大模型智能体AI Agent的知识和创新性的鸿沟

之前深入研究本文主题之前,了解智能系统的历史背景和定义是很有意义的。智能的本质一直是一个研究对象,这反映了数百年来哲学探索和科学探索的成果,如下引用所示:丹尼斯·迪德罗(1746年):“如果他们找到一只能够回答一切的鹦鹉,我会毫不犹豫地认为它是一个有智慧的存在。” 🐦艾伦·图灵(1950年):“如果一台机器可以与人类对话,而不被察觉成为机器,它就展示出了人类的智能。现在,让我们进入有趣的部分,探索当前AI Agent智能体的概念。AI智能体可以被定义为一种能够感知环境、做出决策并执行行动的人工实体。

2401_85343303的博客 3258

华为的C语言编程规范.pdf

华为技术有限公司内部技术规范。本规范制定了编写C语言程序的基本原则、规则和建议。从代码的清晰、简洁、可测试、安全、程序效率、可移植各个方面对C语言编程作出了具体指导。

STM32F407中文手册

STM32f407中文手册 本参考手册面向应用开发人员,提供有关使用 STM32F405xx/07xx、STM32F415xx/17xx、 STM32F42xxx 和 STM32F43xxx 微控制器存储器与外设的完整信息。STM32F405xx/07xx、STM32F415xx/17xx、STM32F42xxx 和 STM32F43xxx 构成一个微 控制器系列,各产品具有不同的存储器大小、封装和外设。有关订购信息以及器件的机械与电气特性,请参见数据手册。有关 ARM Cortex™-M4F 内核的信息,请参见《Cortex™-M4F 技术参考手册》。

上一篇: OpenAI大模型API代码落地实战模拟本地知识库和多轮会话实现
下一篇: 为什么有很多程序员想转产品经理?
AI大模型_学习君
博客等级 码龄3年 6138粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值


