NeurIPS 2023 | 基于 Llama 的单变量时序预测基础模型

时间序列预测基础模型Lag-Llama:零样本预测与微调实战指南 时间序列预测是数据分析与机器学习中的核心任务,旨在基于历史数据推断未来趋势。其基本原理是通过挖掘序列中的自相关、季节性和趋势等模式,构建数学模型进行外推。传统方法如ARIMA和Prophet虽经典,但存在调参复杂、泛化能力弱等局限。随着深度学习发展,基于Transformer架构的预测模型通过注意力机制能更有效地捕捉长期依赖关系,显著提升了预测精度和泛化能力。这类技术的核心价值在于能够自动化地从海量时序数据中学习通用模式,从而降低对领域专家经验和繁琐特征工程的依赖。在实际应用中,时间序列预测广泛支撑着销量预 阅读详情

概率时间序列预测是在广泛应用中出现的一个重要实际问题,包括金融、天气预报、脑成像和计算机系统性能管理等领域。针对这一任务,已经提出了各种方法,从传统的自回归模型到最近基于深度学习架构的神经预测方法。这些以前的方法大多集中在用来自相同领域的数据训练模型,以执行预测任务。

然而,在过去的几年里,由于基础模型的兴起,机器学习正在经历一场范式转变。基础模型是一种大规模、通用的神经网络,以无监督的方式在大量多样化的数据上进行预训练。这些模型在广泛的下游任务上展示出了显著的少量样本泛化能力,通常优于特定于任务的模型。

本文介绍一篇来自摩根士丹利等机构研究者的最新工作,他们的目标是**开发用于时间序列的基础模型,研究它们在大规模上的行为,并突破在不同时间序列领域之间可实现的迁移的极限。**研究者希望通过这项研究,为时间序列预测领域带来与在自然语言和图像处理领域所见到的类似的变革和进步。
图片

论文地址:https://arxiv.org/abs/2310.08278

论文源码:https://github.com/kashif/pytorch-transformer-ts
图片

概述

研究者在大量时间序列数据集上训练了一个Transformer模型,并在一个未见的“分布外”数据集上评估了其性能。具体来说,研究者们研究了使用预训练的时间序列模型进行单变量概率时间序列预测用例,并介绍了在Monash时间序列存储库的大量时间序列上训练的Lag-Llama模型。进而报告了该模型在未见时间序列数据集上的测试集性能,并进行了关于参数数量和训练数据的神经扩展定律研究。

初步结果表明,预训练的时间序列模型可以有效地用于单变量概率时间序列预测,并在未见的数据集上显示出良好的性能。Lag-Llama模型在测试集上的表现尤其出色,这可能是因为该模型在大量多样化的时间序列数据上进行了预训练。此外,研究者的神经扩展定律研究表明,模型的性能和训练数据、参数数量之间存在一定的关系,这为未来的模型改进和优化提供了有价值的指导。

研究者的贡献如下:

  • 提出了Lag-Llama模型,这是一种适用于时间序列基础模型扩展定律分析的单变量概率时间序列预测模型。
  • 在一个时间序列数据集语料库上训练了Lag-Llama,并证明当在未见的时间序列数据集上进行零样本测试时,Lag-Llama的性能优于或与有监督的基线方法相当。研究者确定了一个“稳定”的区域,在该区域内,当模型大小超过某个阈值时,模型的性能始终优于基线方法。
  • 拟合了模型零样本测试性能的实证扩展定律作为模型大小的函数,这使得可能外推和预测本文所用模型之外的泛化能力。

方法介绍

概率时间序列预测是一种预测时间序列未来值的方法,它考虑了预测中的不确定性或随机性。与确定性预测不同,概率预测提供了一种预测未来值的可能范围或概率分布,从而反映了预测的不确定性和风险。

该论文构建了一个通用单变量概率时间预测模型Lag-Llama,在来自Monash Time Series库中的大量时序数据上进行了训练,并表现出良好的零样本预测能力。

Lag-Llama考虑的并不是像Nbeadts或TSMixer中的外部变量,而是来自序列本身的值。通常考虑一定的时间滞后,例如季度、月度、周度、日度、小时和秒级等,选取序列值图片,以匹配时间序列数据的周期性变化。当然研究者也指出可以将单序列分成存在重叠的多个patch作为协变量,但这些patch中的数据点可能不再遵循时间上的因果性,因此研究者更推荐第一种。
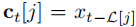
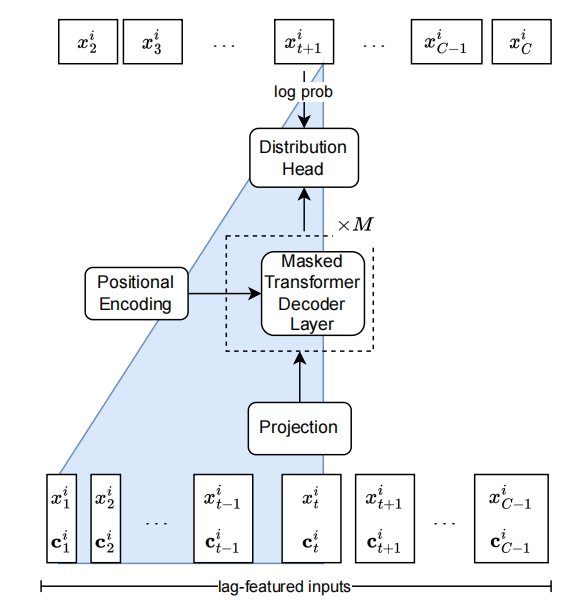
Lag-Llama是基于最近的LlaMA架构构建的,通过RMSNorm实现预归一化,并在每个注意力层的Q和K表示中加入了旋转位置编码(RoPE)。在模型中,输入的单变量序列首先通过滞后操作进行向量化,然后通过共享的线性投影层映射到隐藏维度。接下来,数据经过掩码Transformer层处理,并使用分布头预测所选分布的参数。最后,通过最小化预测窗口上的负对数似然来优化模型的预测性能。
图片

Lag-Llama模型

Lag-Llama模型的最后一层是一个特殊的层,称为分布头(Distribution Head),它将模型的特征投影到概率分布的参数上。我们可以将不同的分布头与模型的表示能力相结合,以输出任何参数化概率分布的参数。在初步实验中,研究者使用了Student’s t-distribution(学生t分布),并输出了与该分布相对应的三个参数,即其自由度、均值和尺度。在后续的工作中,大家或许可以选择更加复杂的分布形式,如规范化流(normalizing flows)和联结函数(copulas)。

为了解决时间序列数据中数值大小的问题,研究者采用了值缩放的方法。对于每个单变量窗口,会计算其均值和方差,并根据这些统计值对窗口中的时间序列进行缩放。同时,还将均值和方差作为与时间无关的实值协变量纳入模型考虑。

在训练和获取似然性的过程中,使用均值和方差对值进行转换,而在采样时,采样的每个时间步的数据都使用相同的均值和方差进行反标准化。这种技术早于最近的相关方法,如RevIN方法和非平稳Transformer。

研究者采用了时间序列增强技术Freq-Mix和Freq-Mask来防止模型过拟合,每个批次有50%的概率应用这些技术,并随机选择10%的数据进行增强。为了确保采样的均衡性,研究者使用了分层抽样方法,并根据数据集中总时间点的数量对数据进行加权处理。

实验数据与结果

研究者使用Monash时间序列存储库和其他常用来源的时间序列数据来训练Lag-Llama模型。这些数据集的频率和应用领域各不相同,包含超过30万个时间序列。为了评估模型的泛化性能,研究者选择了M4 Weekly和Traffic数据集作为测试集,这些测试集在训练期间是不可见的。未来研究者还将探索其他的训练-测试数据分割方式。

训练数据集:

https://arxiv.org/abs/2105.06643

https://arxiv.org/pdf/1906.05264.pdf

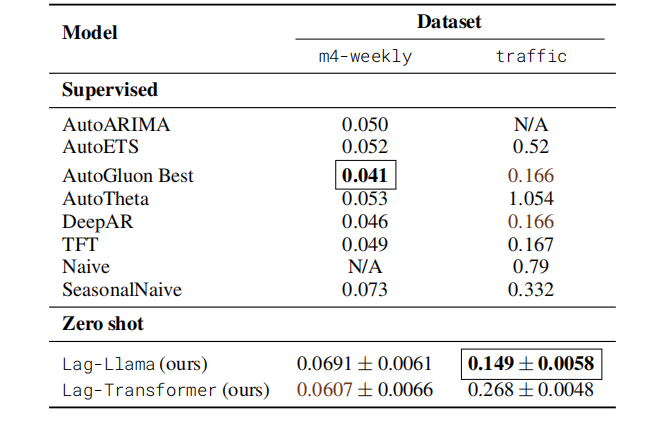
研究者比较了Lag-Llama模型在两个数据集上的零样本性能与在这些数据集上训练的基线模型的性能。最佳性能以粗体突出显示,次佳性能以棕色显示。研究者使用CRPS指标来评估模型性能,数值越低表示性能越好。
图片

零样本数据集测试结果

从上表中可以看出,Lag-Llama在Traffic零样本上取得了更好的性能,超过了所有有监督的基线,而Lag-Transformer在Traffic上的表现不佳。而在m4-weekly数据集上,Lag-Llama和Lag-Transformer都没有超过基线。这表明,对于两种不同的训练和测试分割,这两种架构都有很大的详细分析空间,可以改进数据采样或模型选择。
图片

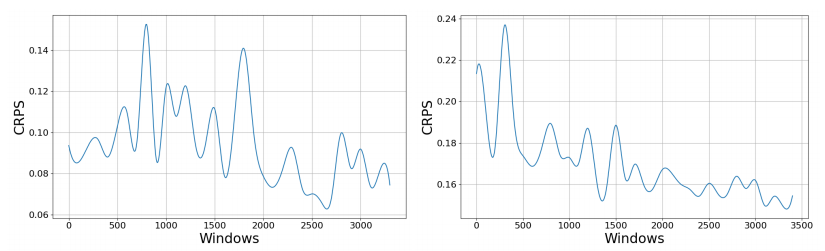
Lag-Llama数据缩放曲线

如上图所示,最佳Lag-Llama相对于在训练期间从数据集的训练语料库中看到的数据窗口数量的零样本CRPS(mean_wQuantileLoss,越低越好)。数据缩放曲线是针对M4 Weekly(左)和Traffic(右)报告的。

这些曲线展示了随着训练期间观察到的数据窗口数量的增加,Lag-Llama在M4 Weekly和Traffic两个数据集上的零样本性能如何变化。通过比较这两个数据集上的曲线,我们可以了解Lag-Llama在不同类型的时间序列数据上的性能差异。同时,这些数据缩放曲线也有助于我们了解模型在不同规模的数据上的性能表现,从而为我们选择合适的训练数据量提供参考。

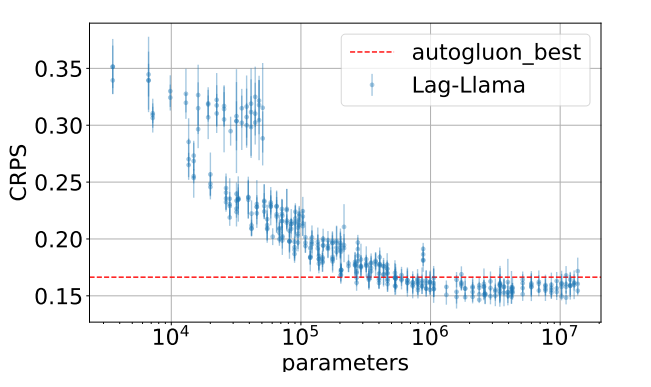
研究者研究了不同大小的模型对性能的影响,训练了一系列大小各异的模型,并测试了它们在不同规模下的性能。结果表明,Lag-Llama在大约10^6个参数后,在没有经过Traffic数据集训练的情况下,性能超过了基线,并在多种可能的超参数配置下实现了稳定的零样本性能。同时,研究者也对Lag-Transformer模型进行了类似的分析。
图片

不同参数量的Lag-Llama模型在traffic数据集上的表现

总结

在这项工作中,研究者提出了提出了一个用于概率时间序列预测的基础模型Lag-Llama。Lag-Llama的零样本性能优于或与监督基线相当,并且随着模型大小的增加,其性能在各种超参数配置下都有所提高并趋于稳定。

研究者进一步拟合了平滑断裂幂律,以模拟模型的测试性能与其大小之间的关系。除了这些初步实验外,研究者计划首先对各种架构设计和模型选择进行消融实验,将以留一法的方式评估模型在其他数据集上的零样本性能,以获得一系列数据集的零样本性能结果,从而进行有趣的分析。研究者还计划在下游数据集的训练分割上对预训练模型进行微调,并评估他们的模型在不同数据集上的少样本和多样本微调性能。最后,研究者计划扩大模型规模和多样化时间序列训练数据的数量,同时比较这种架构和其他候选架构用于时间序列基础模型的缩放定律。

​

如何学习AI大模型?

作为一名热心肠的互联网老兵,我决定把宝贵的AI知识分享给大家。 至于能学习到多少就看你的学习毅力和能力了 。我已将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
一、全套AGI大模型学习路线

AI大模型时代的学习之旅:从基础到前沿,掌握人工智能的核心技能!
img

二、640套AI大模型报告合集

这套包含640份报告的合集,涵盖了AI大模型的理论研究、技术实现、行业应用等多个方面。无论您是科研人员、工程师,还是对AI大模型感兴趣的爱好者,这套报告合集都将为您提供宝贵的信息和启示。
img

三、AI大模型经典PDF籍

随着人工智能技术的飞速发展,AI大模型已经成为了当今科技领域的一大热点。这些大型预训练模型,如GPT-3、BERT、XLNet等,以其强大的语言理解和生成能力,正在改变我们对人工智能的认识。 那以下这些PDF籍就是非常不错的学习资源。
img

四、AI大模型商业化落地方案

img

作为普通人,入局大模型时代需要持续学习和实践,不断提高自己的技能和认知水平,同时也需要有责任感和伦理意识,为人工智能的健康发展贡献力量。

从交换机安全配置,看常见局域网攻击 前言 构建零信任网络,自然离不开网络准入(NAC),这就涉及到交换机的一些安全测试,于是有了此文《从交换机安全配置看常见局域网攻击》。 交换机安全配置 如本文标题所说从交换机安全配置看常见的局域网攻击,那么下面提到的各种攻击方式,自然是建立在交换机安全配置之上来说的。我们通过h3c官方提供的《H3C 交换机安全加固手册》和《安全配置指导》,从这两份手册可以看出交换机支持的安全配置非常多,基本已经覆盖了各种我们熟知局域网攻击。下面就挑几个典型的攻击方式进行演示。 arp欺骗 【一>所有资源获取&lt 阅读详情

相关推荐

用Python实现斗地主游戏(终端版)

马上就要过年了 大家也都放假了吧 过年必不可少的活动 打牌! 今天带大家来写一份斗地主 (又是好多天没怎么更新,忙成狗啊) 那么实现一个斗地主呢 我们肯定要先完善卡牌系统 from collections import Counter import numpy as np import itertools def cmp_to_key(mycmp): 'Convert a cmp= function into a key= function' class K: def _

Miku_wx的博客 9858

【论文笔记 · PFM】Lag-Llama: Towards Foundation Models for Time Series Forecasting

本文提出Lag-Llama,在大量时间序列数据上训练的通用单变量概率时间序列预测模型。模型在分布外泛化能力上取得较好效果。模型使用平滑破坏幂律(smoothly broken power-laws)。目前任务主要集中于在相同域的数据上训练模型。当前已有的大规模通用模型在大规模不同数据上进行训练,展现出了极强的泛化能力。本文训练了一个Transformer模型,使用大量时序数据进行训练并在未见过的数据集上进行测试。文章在Monash时序仓库上训练了Lag-Llama。

lokol.的秘密基地 3381

超详细 Git创建仓库及上传项目至Github操作(Windows系统)

文章目录前言一、Git下载及安装二、创建代码仓库1.配置身份2.创建本地仓库3.提交本地代码三、使用Git上传代码至Github1.创建ssh keys2.在Github中新建仓库3.关联本地仓库与Github仓库4.推送代码至Github仓库总结 前言 本文对于Windows系统上git的安装及基本使用方法进行简单介绍,并介绍如何使用git将仓库中的项目上传至个人的Github中去。内容参考《第一行代码》以及一些博客。 本文适合新手阅读哦~ 一、Git下载及安装 打开网站 git下载 下载安装包(直接

lijianyi0219的博客 2万+

时间序列模型:lag-Llama

这是一个借鉴了Llama模型结构的单变量概率时间预测模型,使用了海量的数据集进行预训练,用户可以根据实际的任务进行模型微调或者直接进行零样本推理。模型从六个领域搜集了27个时序数据,根据不同的频数分为了7965个数据集进行预训练,之后又从其他数据集上进行零样本学习以及微调,使用CRPS评估的结果如图所示,Lag-Llama微调后的平均结果更好,仅2.786左右。

thorn_r的博客 2614

深入解析Flex NOC总线驱动的实时带宽与延迟优化策略

本文深入解析了Flex NOC总线驱动的核心价值与优化策略。通过解读`/proc/noc/real_time`中的实时带宽与延迟数据,并结合`sysfs`接口进行动态QoS调优,可以有效解决芯片内部数据拥堵问题。文章以智能摄像头和算力盒子的实际案例,详细说明了如何通过优先级调整、带宽限制和参数优化,提升系统在复杂任务下的实时性与稳定性。

weixin_29289821的博客 284

攻防世界 web高手进阶区 9分题 Web_python_flask_sql_injection

继续ctf的旅程,开始攻防世界web高手进阶区的9分题,本文是Web_python_flask_sql_injection的writeup

闵行小鱼塘 1477

Lag-Llama:第一个时间序列预测的开源基础模型

lag-llama是为单变量概率预测而构建的。本文主要介绍了关于该模型的零样本预测,对有缺失值的数据处理,处理DataFrame数据集以及如何调整上下文的长度来优化模型。

wuzigege666的博客 3117

Unity地形数据高效转换:从Terrain到3DMAX的OBJ导出实战

本文详细解析了Unity地形数据无法直接导入3DMAX的原因,并提供了高效转换的实战方案。通过编写自定义编辑器脚本,将Unity Terrain的高度图数据“烘焙”为静态网格模型,并以OBJ格式导出。文章重点讲解了核心代码逻辑、分辨率选择对模型精度的影响,以及在3DMAX中导入和优化模型的实用技巧,旨在打通Unity与3DMAX之间的数据协作壁垒。

sky77的博客 449

lag-llama源码解读(Lag-Llama: Towards Foundation Models for Time Series Forecasting)

文章内容:时间序列预测任务,单变量预测单变量,基于Llama大模型,在zero-shot场景下模型表现优异。创新点,引入滞后特征作为协变量来进行预测。

m0_51312071的博客 2385

SAP_SD模块深度解析SAP信用检查中的“未清数量”取值逻辑

确认数量 vs 订单数量:如果系统配置了可用性检查(ATP),并且订单只确认了部分数量,信用检查通常只占用已确认数量的额度(具体取决于信用组的配置)。在SAP中,未清订单数量的计算并非简单读取订单行项目的目标数量(VBAK-KWMENG),而是基于**计划行(Schedule Lines)**层级来汇总的。状态的转换点:当交货单创建(VL01N)并保存时,这部分数量对应订单的“未清订单数量”减少,“未清交货数量”增加。业务人员眼中的未清数量很简单:“我卖了100个,发了30个,未清就是70个”。

我小时候很黑的博客 315

RK3588 平台imx334 驱动调试记录

rk3588调试imx334

xiaoning132的专栏 1791

Lag-Llama:第一个时间序列预测的开源基础模型介绍和性能测试

在尝试了TimeGPT和Lag-Llama之后,Lag-Llama算是构建开源预测模型的第一步,但与TimeGPT相比,它在功能方面存在不足。TimeGPT可以处理多变量时间序列、不规则时间戳,并实现共形预测,与使用laglama等固定分布相比,这是一种更稳健的量化不确定性的方式。laglllama是一个开源的基础模型,只用于单变量概率预测,并且我觉得它训练的数据有点少了。我相信在不久的将来会看到更多的开源预测模型出现。他们的表现可能会得到改善,这代表了该领域的一个重大转变。

deephub 7422

【WRF编译-Lab1】使用自动脚本编译WRF:错误总结

WRF编译过程及错误总结

WW、forever的博客 84

推荐开源项目:Lag-Llama——时间序列预测的先驱模型

![lag-llama-architecture](images/lagllama.webp) Lag-Llama,这个名字听起来既神秘又富有魅力,实际上它是全球首个针对时间序列预测的开源基础模型。这个创新的项目源自于对数据流中未来趋势的精准预测需求,旨在为科研和工业界提供一个强大的工具箱。 ## 项目介绍 Lag-Llama不仅仅是另一个时间序列分析库,它是一个专为概率性时间序列预测设计的...

gitblog_00025的博客 664

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

NTscan扫描工具

ntscan是一个扫描器,可以扫描没有密码和弱密码的共享,先到配置文件中填写猜测的用户名和密码,扫描过程中右侧出现的是扫描日志。

高质量论文中文翻译:Lag-Llama: 朝向基础模型的概率时间序列预测 Lag-Llama: Towards Foundation Models for Probabilistic Time S

arXiv:2310.08278v3 [cs.LG] 2024年2月8日原始论文链接:https://arxiv.org/pdf/2310.08278在过去的几年中,基础模型由于其前所未有的零样本和少样本泛化能力,在机器学习领域引起了一场范式转变。然而,尽管基础模型在自然语言处理和计算机视觉等领域取得了成功,但是在时间序列预测方面,基础模型的发展却滞后了。我们提出了Lag-Llama,一种通用的基础模型,用于基于解码器的变压器架构的单变量概率时间序列预测,该模型使用滞后作为协变量。

数智笔记 2987

lwip-2.0.3

lwip是瑞典计算机科学院(SICS)的Adam Dunkels 开发的一个小型开源的TCP/IP协议栈。实现的重点是在保持TCP协议主要功能的基础上减少对RAM 的占用。

聊聊大模型浪潮下的时间序列预测

这篇文章介绍了大模型浪潮下的时间序列预测研究思路,整体包括直接利用NLP大模型做时间序列预测,以及训练时间序列领域的大模型。无论哪种方法,都向我们展现了大模型+时间序列的潜力,是一个值得深入研究的方向。

机器学习社区 1850

霍尼韦尔SoftMaster使用说明

霍尼韦尔SoftMaster使用说明

Lag-Llama:时间序列大模型开源了!

我们将探讨Lag-Llama的架构、功能以及训练方式。还会通过代码将lagllama应用于一个预测项目中,并将其与其他深度学习方法Temporal Fusion Transformer (TFT) 和DeepAR进行性能比较。

AAI666666的博客 1685

【亲测免费】 Lag-Llama:时间序列预测的开源基础模型中文安装与使用指南

Lag-Llama 的项目结构布局清晰,便于开发者快速上手。下面是其主要的目录结构和内容介绍: - **`.gitignore`**: 控制版本控制系统忽略哪些文件或目录。 - **`LICENSE`**: 项目使用的授权协议,采用 Apache-2.0 许可证。 - **`MANIFEST.in`**: 规定了在构建源码包时应包含的额外文件。 - **`README.md`**: 项目的核心说...

gitblog_00425的博客 1499

Lag-Llama时间序列模型简单实现数据预测

最近在大模型预测,简单了解了lag-llama开源项目,网上也有很多讲解原理的,这里就将如何快速上手使用说一下,只懂得一点点皮毛,有错误的地方欢迎大佬指出。

迷途小书童的博客 885

Lag-Llama:开源时间序列大模型,开启数据预测新纪元

在尝试了TimeGPT和Lag-Llama之后,Lag-Llama算是构建开源预测模型的第一步,但与TimeGPT相比,它在功能方面存在不足。TimeGPT可以处理多变量时间序列、不规则时间戳,并实现共形预测,与使用laglama等固定分布相比,这是一种更稳健的量化不确定性的方式。laglllama是一个开源的基础模型,只用于单变量概率预测,性能表现也比较有限。相信在不久的将来会看到更多的开源预测模型出现,他们的表现可能会得到改善,这代表了该领域的一个重大转变。

h1453586413的博客 1431

探索未来趋势:Lag-Llama——首个开源的时间序列预测基础模型

探索未来趋势:Lag-Llama——首个开源的时间序列预测基础模型 lag-llamaLag-Llama: Towards Foundation Models for Probabilistic Time Series Forecasting项目地址:https://gitcode.com/gh_mirrors/la/lag-llama 在预测未来方面,Lag-Llama引领了创新之路。它是第...

gitblog_00398的博客 929

Lag-Llama 开源项目实战指南

Lag-Llama是专为单变量概率预测设计的开源基础模型. 它采用了一种通用的方法来将时间序列数据转换成token, 不受频率限制. 这个特性使得它在面对未知频率的数据时也能适应良好. 该模型利用了Transformer结构并结合分布头(distribution head), 来解读输入token并与未来预测及其相应的置信区间对齐. 模型还采用了综合标记策略, 包括创建滞后的特征(lagged ...

gitblog_00836的博客 1406

5分钟上手Lag-Llama微调:提升特定领域预测精度的完整工作流

Lag-Llama是一款专注于概率时间序列预测的基础模型,通过微调可以显著提升特定领域的预测精度。本文将带你快速掌握Lag-Llama的微调流程,从环境准备到模型训练,让你在短时间内完成模型优化。 ## 📋 准备工作:环境与数据 ### 1. 克隆项目仓库 首先需要获取Lag-Llama的项目代码,执行以下命令克隆仓库: ```bash git clone https://gitcode.c

gitblog_00370的博客 393

近期值得关注的4个时序大模型研究

梳理了近期几篇时间序列大模型研究文章(后台回复:“论文合集”获取),时间序列大模型的研究正在迅速发展,并且在多个领域和应用中展现出巨大的潜力。基础模型的构建:研究者们正在尝试构建时间序列预测的基础模型,这些模型可以在不同的时间序列数据集上进行预训练,并展示出良好的泛化能力。模型可解释性:通过文本形式提供解释性的时间序列预测结果,帮助用户更好地理解时间序列数据的模式和趋势。特定领域的应用:大模型正在被应用于特定领域的时间序列预测,如金融、医疗、交通等,以解决特定问题并提供可解释的预测。

Python_cocola的博客 3093

【keras】利用LSTM进行单变量时间序列预测和多变量时间序列预测

        对于较为简单的时间序列预测问题,可以使用Exponential Smoothing和ARIMA等传统模型非常方便地求解。然而,对于复杂的时间序列预测问题,LSTM不失为一种很好的选择。因此,本文旨在探讨如何利用LSTM神经网络求解时间序列预测问题。首先,需要明白时间序列预测问题是如何转换为传统的监督学习问题的,即时间窗方法。有关时间序列预测问题转换为监督学习的过程请移步:Time ...

XYZ 3万+

Gloom国际化支持详解:多语言应用开发实战教程

Gloom作为一款采用Material You设计理念重构的GitHub客户端,其强大的国际化支持让全球用户能够获得本地化的使用体验。本文将深入剖析Gloom的国际化架构设计,带你掌握多语言应用开发的核心技术与最佳实践。 ## 国际化架构概览:Gloom的多语言实现方案 Gloom采用Moko Resources作为国际化解决方案的核心框架,通过资源文件分离与自动生成机制,实现了高效的多语言管

gitblog_01064的博客 956
上一篇: 提示词写不好,AI只会帮倒忙!8个常见提示词避雷清单!
下一篇: 3 种自然语言处理(NLP)技术:RNN、Transformers、BERT
AI大模型_学习君
博客等级 码龄3年 6138粉丝 551原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值