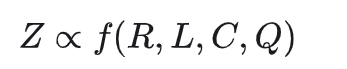LLM模型之高质量数据选择和微调方法

使用 Distilabel 复现 DeepSeek-Prover 详解 本文介绍一个用于合成数据和 AI 反馈的框架 Distilabel 通过构建流水线复现 DeepSeek-Prover 主要步骤的方法 阅读详情

Entropy Law:多数据集组合时的数据筛选方法

Entropy Law: The Story Behind Data Compression and LLM Performance

数据是大型语言模型(LLM)的基石。大多数方法侧重于评价单个样本的质量,而忽略了样本间的组合效应。

受LLMS信息压缩特性的启发,我们发现了一个将LLM性能与数据压缩比和第一个epoch训练损失联系起来的“熵定律”,它们分别反映了数据集的信息冗余度和对该数据集中编码的固有知识的掌握。

基于熵定律的结果,我们提出了一种非常有效和通用的数据选择方法ZIP来训练LLMS,该方法旨在对压缩比较低的数据子集进行优先排序。基于贪婪地选择不同数据的多阶段算法,我们可以得到一个具有满意多样性的良好数据子集。
图片

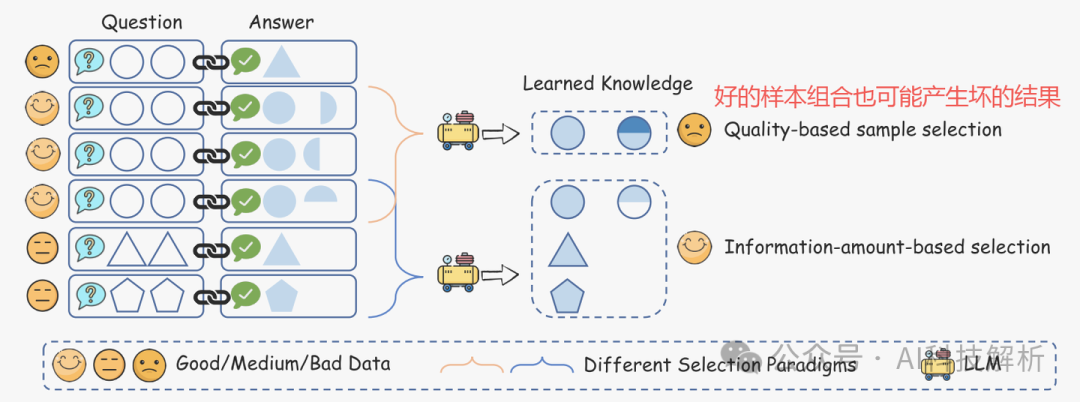
虽然有多个好的样本数据,但它们编码的知识可能是冗余的和相互冲突的。而由几个相对较低质量但不同的样本组成的另一个数据子集可能比上述子集传递更多的信息。(这说明多数据组合时要去重。。。)

在论文《Compression Represents Intelligence Linearly》中提到:LLMS中自回归语言建模的基本机制是信息压缩。(就是训练总数据集的token数/总数据集的char个数,其实并不能完全代表模型的能力,只能说表示了tokenizer的能力)

在这里插入图片描述

使用每条消息的平均编码长度(即比特每字符,BPC)来评估模型的压缩效率。

将LLM的性能表示为Z,它预计会受到以下因素的影响:

  1. 数据压缩比R: 该度量可以通过将压缩前的数据大小除以压缩后的大小得出,该大小可以通过各种现有的压缩算法来计算。直观地说,压缩比较低的数据集表示较高的信息密度。
  2. 训练损失L: 表示数据是否难以被模型记住。在给定相同的基本模型的情况下,高训练损失通常是由于数据集中的噪声或不一致的信息造成的。在实践中,第一个训练周期中少量训练步长的平均损失足以产生指示性的L值,从而使模型不会对数据进行过度拟合。
  3. 数据一致性C: 数据的一致性由给定先前上下文的下一个令牌的概率的熵来反映。较高的数据一致性通常会产生较低的训练损失。
  4. 平均数据质量Q: 这反映了数据的平均样本级质量。

那么有

图片

其中数据一致性C通常和L相关,因此选一个就行。数据质量不会随选择而变化,视为常数,则有
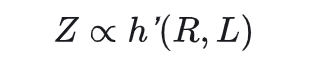
图片

模型的性能与数据压缩比和训练损失有关。将这种关系称为“熵定律”。

ZIP筛选

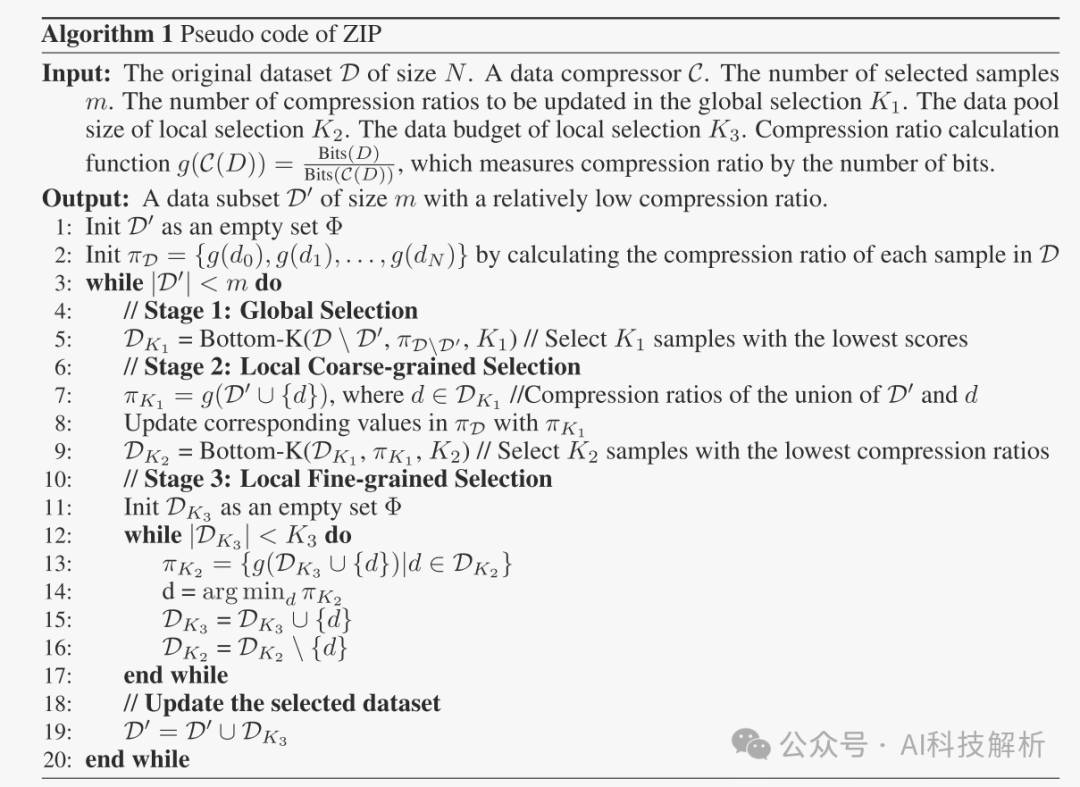
该方法的目标是在有限的训练数据预算下最大化有效信息量。

  • 1、首先全局选择压缩比最低的多个候选样本构建样本池,目的是找到信息密度较高的样本。直观地说,样本内信息冗余度高的数据不太可能具有良好的全局多样性。
  • 2、然后采用粗粒度局部选择阶段,将剩余的每个样本添加进样本池,计算总样本池的压缩比。选择总压缩比较小的样本添加进来。这一步计算了多样本之间的组合效果。
  • 3、从样本池中选择一个局部样本。和其他样本逐个计算压缩比,压缩比低表明差异大,可保留。最终得到信息差异最大的一个子样本池。
图片

ZIP

这个方法本质上就是通过信息压缩率衡量数据集的信息冗余程度,从而选出差异性最大的数据集**(去重)**进行训练。

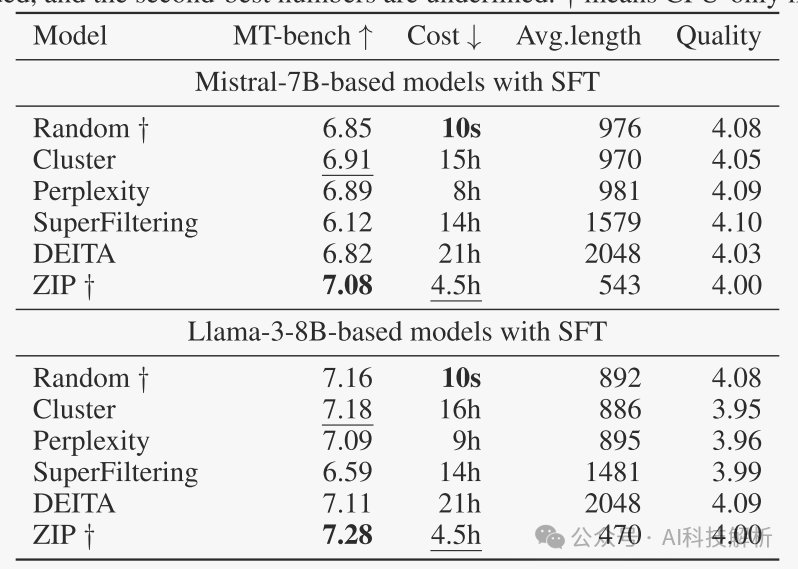
ZIP数据筛选方法比随机选择和其他筛选方法取得了更好的效果。
图片

总结

其实就是去掉重复度高的数据集。但是实际场景中,即使是重复度高的数据集中也会包含大量不重复的内容,这部分内容对拓展模型知识范围有用,因此不如直接对数据去重好用。

类似的还有《Data curation via joint example selection further accelerates multimodal learning》,通过模型loss筛选出最有价值的数据集单独进行训练,减少了训练数据、降低了迭代次数,提高了效率。

高质量微调数据集探索

From Complex to Simple: Enhancing Multi-Constraint Complex Instruction Following Ability of Large Language Models

https://github.com/meowpass/FollowComplexInstruction

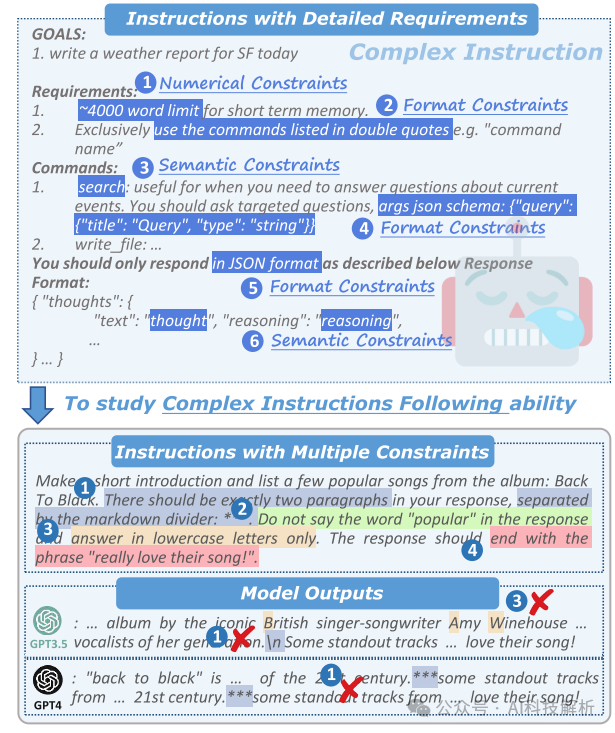
本文提出了三个问题:1:什么样的数据能增强SFT的效果?2:如何得到这类数据?3:如何利用上述数据进行有效微调?
图片

Constraints data

  • 1、什么样的数据能增强SFT的效果?

复杂约束的数据具有更好的微调结果。也就是数据的描述越详细、准确,微调效果越好。

大模型微调并不复杂,数据才是关键:3个实例详解数据准备 今天我们不打算深挖那些复杂的技术细节,而是要告诉你们一个简单的事实:微调其实一点都不复杂,真正的关键在于——数据!在这篇文章里,我们不仅会深入浅出地介绍什么是微调,还会通过三个具体的实例,教你们如何准备高质量的数据集,让你们的模型表现出色。准备好了吗?让我们一起开始吧! 阅读详情

相关推荐

大模型LLM微调方法paper汇总!

本文对高效LLMs研究的发展进行了系统而全面的回顾,并将文献整理成由三个主要类别组成的分类法,从模型中心、数据中心和框架中心的角度涵盖了不同但相互关联的高效LLMs主题,并且从以模型为中心和以数据为中心的角度,回顾了LLMs的算法层面和系统层面的高效技术。本文分析了训练数据因素对对话模型性能的影响,包括数量、质量和语言分布,文中使用1000个样本评估集评估了各种模型,涵盖9个真实场景,目的是通过定量分析提供有价值的见解,推进开源聊天模型的发展,并且还扩展了LLaMA的词汇表,进行了二次预训练。

2401_82426425的博客 1884

深入理解大语言模型微调技术

大模型微调,也称为Fine-tuning,是指在已经预训练好的大型语言模型基础上(一般称为“基座模型”),使用特定的数据集进行进一步的训练,让模型适应特定任务或领域。

产品老A,8年互联网大厂AIPM,专注探索新型人机交互 1万+

大语言模型:LLM的高阶应用「模型微调」

大语言模型模型微调:概念、方法、流程、优势、应用

PMKG知识社交 1177

LLM 微调实现原理及步骤

摘要: LLM微调通过将业务知识库转化为高质量QA对,训练模型根据文档生成精准回答,避免编造和跑题。流程分为六步:1)准备结构化知识库;2)生成训练数据(人工/LLM自动生成);3)使用LoRA等技术微调模型;4)人工/自动评估效果;5)优化数据迭代训练;6)部署为RAG系统,动态结合检索与生成。核心在于通过数据迭代让模型学会"依文档作答",而非记忆固定答案,最终实现可控的智能问答服务。(150字)

qq_35354529的博客 796

【大模型】模型微调(非常详细)从入门到精通,看这一篇就够了

本文结合示例简单讨论如何使用LoRA微调 (FT) 预训练的 LLM。LoRA原理将在接下来的文章里详细讨论。

python_first1的博客 6357

基于Transformers的LLM微调,以及改写模型的一些Tips

这里主要探讨通用的文本生成模型,即指诸如GPT、Bert、Llama等的BaseModel,其最原始的目的为文本生成。

weixin_55471672的博客 1337

LLM基础之大模型常见的微调方法:ptuning v2、lora、qlora 以及微调套路

大模型技术飞速发展,像Rag、Agent以及Moe等,1月份抽空看了蛮多大模型的博客和论文,感觉知识点太多了并且更新速度也贼快,后续就慢慢进行总结输出。这篇文章主要主要围绕ptuning v2、lora、qlora以及全量微调等方法进行介绍,末尾也会分享自己参加的相关大模型比赛的微调心得总结以及一些学习的参考。大模型的训练主要包括预训练阶段、指令微调阶段以及强化学习阶段。不过最近刷到过论文或者博客文章提到,通过高质量的有监督微调数据训练大模型,即使不进行强化学习阶段,也能模仿人类进行输出。

lvaolan123456的博客 1360

分享Embedding 模型微调的实现

1. 当前比较主流的Embedding开源模型有哪些?答:1. m3e(Moka Massive Mixed Embedding) 2. BAAI/bge-large-zh-v1.5。更多的开源模型评测榜单可见:\2. 模型的作用?答:通过词,句子或者上下文的向量生成,从而来实现更高效的语义检索,语言理解的相关任务。\3. 模型是如何捕获语义信息的?答:在训练的过程中,模型学习用来反映语义相似性的方式将向量分配给单词或序列。简言之,通过分析数据中的词共现模式来实现。

python122_的博客 1560

【LLM】self-instruct 构建指令微调数据集

四部曲:指令生成;分类任务识别;实例生成;过滤和后处理。 为了实证评估SELF-INSTRUCT,在GPT3(Brown等人,2020)上运行该框架,在这个模型上的SELF-INSTRUCT迭代过程产出了大约52K条指令,以及大约82K个实例输入和目标输出对。结果数据提供了多种多样的创造性任务,其中50%以上的任务与种子指令的重合度低于0.3 ROUGE-L(§4.2)。可以利用生成的指令数据微调其他大模型。 二、具体过程 1. 指令生成 175个种子任务(每个对应1个指令+1个实例),从该任务池中随机抽取

发现问题,并解决问题,批判性思维 8308

Python 领域 vllm 模型微调的数据选择

本文旨在为Python开发者提供一套完整的vLLM模型微调数据选择方法论。vLLM模型微调的基本原理和特点数据选择的核心原则和评估标准数据预处理和增强的Python实现不同应用场景下的数据选择策略实际案例分析和代码实现本文的范围限定在vLLM模型的微调阶段,特别是数据准备环节,不涉及模型架构设计或训练基础设施搭建等主题。首先介绍vLLM和数据选择的基本概念然后深入分析数据选择的核心原则和方法接着展示Python实现和实际案例最后讨论应用场景和未来趋势vLLM。

AI Python 编程之道的博客 1153

【LLM】sft和pretrain数据处理和筛选方法

# note - 痛点:训练垂直领域模型,sft数据和增量pretrain数据质量把控很重要 - 当数据不够时,通过self-instruct等方法造多样化的数据 - 当数据很多时,需要清洗/筛选出高质量数据 @[toc] # 一、sft数据的筛选策略 内容概要: - 构造sft数据 - 评估sft数据质量和数量 - 自动化筛选高质量sft数据 ## 1.1 使用self-instruct构造sft数据 论文:《Self-Instruct: Aligning Language Model wit

发现问题,并解决问题,批判性思维 9493

LLM、AGI、多模态AI 篇三:微调模型

即:将 LLM 的应用工程化,“无缝” 接入内部的各种平台和工具,持续处理用户对于数据的反馈,以持续迭代软件数据集。例如,将微调后的模型集成到内部的聊天机器人平台中,以提供更好的用户体验,并不断收集用户的反馈,以改进模型的性能。LoRA 的核心思想是通过对模型的权重进行分解,将其表示为一个低秩的矩阵,然后通过对低秩矩阵进行微调,来实现对模型的微调。LoRA(Low-Rank Adaptation)是一种用于微调大型语言模型的技术,它可以在不改变模型结构的情况下,对模型进行微调,以适应新的任务或数据集。

生活在别处 2165

在 MacBook 上训练自己的 LLM:使用 MLX 进行微调指南 在 Apple Silicon Mac 上对自定义数据集进行 LLM 微调的指南

微调代表了模型开发的一种战略方法,我们采用预先训练的 LLM(通过对大量数据集的训练,已经具备了广泛的语言理解能力),并在较小的专业数据集上对其进行进一步训练。该模型在保留其基础知识的同时,还在您的目标领域发展专业知识。对于某些自定义任务,微调可以比仅使用 LLM 模型产生更好的结果。无论您是处理患者医疗记录以生成治疗摘要、分析历史诊断模式,还是想要构建一个能够理解特定医学术语和医院协议的模型以生成标准化报告,您都可以考虑对 LLM 模型进行微调。

iCloudEnd的博客 693

自动化地挑选出大模型所需的高质量指令微调数据

最后基于的大量获得的实验数据,应用统计回归模型来确定推理损失和指标值之间的关系。(可见图5中的公式1,数据集D的质量正比于用D微调后的模型在D_eval上的负损失)。与损失的单变量分析图在Figure2,table4是用规则估计的值与实际微调后的loss的关系,说明了作者用语言指标取代loss的可行性。用各种语言指标来预测推理损失的公式可见图6中的公式2,是一个关于最小损失常数和通过函数F变换后的各种语言指标的值的函数。相比于用未过滤过的数据集上微调的模型,用指令挖掘筛选后的数据集微调的模型在。

具身机器人和通用AI 663

LLM语言模型.zip

语言模型LLM语言模型.zipLLM语言模型

Unity 升级 xLua 版本,编译不同平台链接库

Unity 升级 xLua 详解

LymanCao的专栏 1801

保姆级教程:在mmdetection中手动计算并可视化P、R、F1值(附完整代码)

本文提供了一份详细的mmdetection教程,指导开发者如何手动计算并可视化精确率(P)、召回率(R)和F1值。通过完整的代码示例和清晰的步骤说明,帮助用户深入理解目标检测模型的性能评估方法,特别适合需要精细分析模型表现的计算机视觉研究人员和工程师。

weixin_29038303的博客 400

数字IC设计——功耗分析

功耗是数字IC芯片的一个重要指标

知识,既贵,又便宜。 9362

CANoe LIN一致性测试之干扰测试Test moudle_LIN Disturbance Block

注意:相邻两个显隐性不同的bit不允许干扰,例如我同时选择bit6和bit7,相邻两个同显隐性的bit允许干扰,例如当我选择bit3和bit4,项,这里我选择ID:为0x2F(PID:0x6F)的frame。需按照具体测试规范实施干扰项,帧头和数据段都可以实现干扰。最近发现一个干扰测试模块,下面是一些具体使用方法。选择干扰项:PID的奇偶校验位(一致性测试干扰测试之手动测试。一个待测试frameD。

yuanyikangkang的博客 3410

通达信【雷霆尊者排序】实战指南:高胜率竞价指标解析与优化策略

本文详细解析了通达信【雷霆尊者排序】指标在集合竞价阶段的应用,提供从基础设置到实战解码的完整指南。文章重点剖析了‘雷霆’、‘使者’、‘精选’等核心信号的逻辑与共振策略,并分享了如何结合K线、市场情绪进行综合研判与风险控制,旨在帮助短线交易者提升早盘选股效率与胜率。

pear55的博客 951

工业4.0必备:C#上位机+数字孪生 生产线实时监控与智能预警系统(工业级实战)

数据割裂:PLC、传感器、工业相机的数据散落在不同系统,想看全局生产状态要切换N个软件,“数据孤岛”导致决策滞后;故障难预判:设备突发故障时,只能停机排查,平均故障响应时间超30分钟,一条生产线停工1小时损失超10万;可视化差:传统监控只有冰冷的数字和2D图表,设备运行状态、生产流程、物料流转无法直观感知,新人上手需3个月才能熟悉产线。

这里只有干货:从 Modbus 通信到 MES 对接,从 YOLO 训练到工控机部署,带你搞定工业软件开发全流程。 660

SOC估算方法之(OCV-SOC+安时积分法)

此方法主要参考。

m0_61973119的博客 935

使用verilog实现基于FPGA的TDC设计

verilog实现TDC 高精度时间数字转换器概述(TDC) 简介: TDC被用于测量时间间隔,应用在物理研究、飞行时间测量领域等。 本设计使用verilog实现并在xilinx和altera的FPGA上均可实现! 设计中使用到下述几个模块,包括FIFO,COUNT等,在xilinx下也使用到了一些原语等。下面有实现的代码和仿真截图等。 顶层模块设计如下: module top( input wire start, input wire stop, input wire clk, output wire T

QQ_778132974的博客 6253

win10 跳过U8环境检测的IE WebControls.rar

win10 安装u8的时候 提示IE WebControls 不通过,这个工具可以欺骗u8的检查。 跳过U8环境检测的IE WebControls。提示导入失败后,重新检测通过。

假人有限元模型

假人模型,车辆碰撞假人有限元模型,适合做乘员安全的研究者利用

锂电池充电器电路设计 里面有电路

锂电池充电器电路设计 里面有电路 3.7V升压到5V电路设计。

上一篇: 抓住机遇,迈向高薪:大模型工程师职业指南_大模型工程师的职业规划
下一篇: 一文解析大语言模型LLM的幻觉问题:消除错觉、提高认知
普通网友
博客等级 码龄3年 4493粉丝 309原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值