利用LLMs进行时间序列预测:理解和增强模型时间序列能力

从Si3N4到SiNx:一文搞懂芯片制造中氮化硅的化学式玄机(附工艺参数影响) 本文深入探讨了芯片制造中氮化硅(SiNx)化学式的调控艺术,揭示了从Si3N4到SiNx的转变如何影响材料性能。通过分析PECVD和PVD工艺参数对x值的精确调控,以及x值对电学和机械性能的影响,为半导体制造提供了实用的工艺优化策略。 阅读详情

近年来,大型语言模型在许多领域得到了快速发展和广泛应用。作为一个经典的机器学习任务,时间序列预测最近通过LLMs得到了提升。然而,在这一领域中,关于LLMs的偏好还存在研究空缺。本文通过将LLMs与传统模型进行比较,发现了LLMs在时间序列预测中的许多特性。例如,我们的研究显示LLMs擅长预测具有明确模式和趋势的时间序列,但面对缺乏周期性的数据集时则遇到挑战。我们通过设计提示要求LLMs告知数据集的周期来解释我们的发现。此外,还研究了输入策略,发现结合外部知识和采用自然语言释义对LLMs在时间序列预测性能方面产生了积极影响。总体而言,本研究为在不同条件下LLMs在时间序列预测中的优势和局限性提供了洞察。

图片

论文题目:

Time Series Forecasting with LLMs: Understanding and Enhancing Model Capabilities

论文链接:

https://arxiv.org/abs/2402.10835

图片一、我们要回答的三个问题

1. LLMs在时间序列预测中对输入时间序列有何偏好。 为了回答这个问题,我们对真实和合成的数据集进行了实验。我们的观察揭示了LLMs在趋势或季节性强度较高的时间序列上表现更好。为了进一步辨别LLMs对输入数据特定部分的偏好,我们设计了涉及输入序列系统排列的反事实实验。我们发现LLMs对靠近输出的输入序列段非常敏感。

2. 为什么LLMs能在趋势或季节性强度较高的数据集上预测得很好? 为了解决这个问题,我们设计了需要LLMs告知数据集周期的提示。通过实验,我们让大型语言模型多次告知数据集的周期并取中位数。我们发现大型语言模型可以准确地指出数据集的周期性。这可以解释为什么大型语言模型能够很好地预测具有高趋势或季节性强度的数据集,因为它们已经学习了这类知识。

3. 鉴于这些发现,我们的重点在于如何利用这些洞察来进一步提高模型性能。 为了解决这个问题,我们提出了两种简单的技术来提升模型性能:纳入外部人类知识和将数值序列转换为自然语言对应物。纳入补充信息使大型语言模型能够更有效地把握时间序列数据的周期性特征,而不仅仅是强调时间序列的尾部。将数值数据转换为自然语言格式增强了模型的理解和推理能力,也是一种有益的方法。这两种方法都提高了模型性能,并有助于我们理解LLMs在时间序列预测中的应用。

二、一些基础设定

我们将LLMs作为zero shot 学子者用于时间序列预测,通过将数值视为文本序列来处理。LLMs在时间序列预测中的成功很大程度上取决于数据的正确预处理和处理。我们遵循了他们的方法,这个过程涉及几个关键步骤。在使用LLMs进行时间序列预测的预处理阶段,数值被转换为字符串,这是一个关键步骤,显著影响了模型的理解和数据处理。

例如,一个序列如0.123, 1.23, 12.3, 123.0被重新格式化为"1 2, 1 2 3, 1 2 3 0, 1 2 3 0 0",引入空格分隔数字和逗号以界定时间步骤,而省略小数点以节省令牌空间。令牌化同样至关重要,塑造了模型的模式识别能力。不同于传统方法如字节对编码(BPE),可能会破坏数值连贯性,通过空格分隔数字确保了单独的令牌化,增强了模式辨识。 此外,还采用了重新缩放技术,通过调整值使特定百分位数对齐到1,以高效利用令牌和管理大输入,从而使模型能够接触到不同位数的数字,并支持生成更大的值,这证明了数据准备在利用LLMs进行时间序列分析中的微妙而关键的性质。

时间序列预测在时间序列预测的背景下,主要目标是基于前 K 步观察到的值预测接下来 H 步的值,数学表达式为:

图片

在这里插入图片描述

受到现实世界场景中可解释性要求的激励,时间序列通常可以通过加法模型分解为趋势分量、季节分量和残差分量。趋势分量捕获数据中隐藏的长期变化,如线性或指数模式。季节分量捕获数据中的重复变化,残差分量捕获在去除趋势和季节分量后数据中剩余的变化。这种分解提供了一种量化时间序列属性的方法。

三、实验的发现

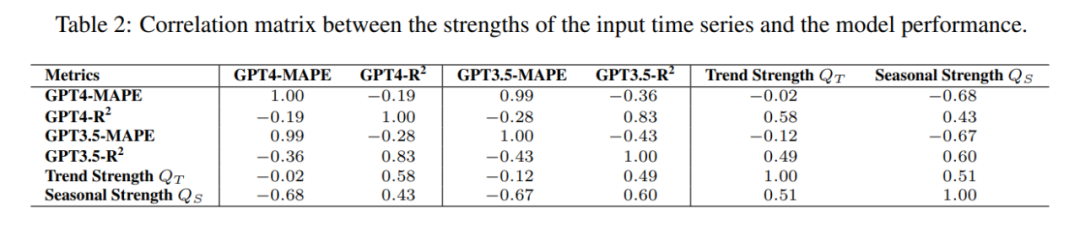
1. 在计算了皮尔逊相关系数(PCC)之后,我们观察到强度和模型性能之间存在几乎强烈的相关性,这表明当输入时间序列具有更高的趋势和季节性强度时,LLMs的表现更好。 值得注意的是,与GPT-3.5-turbo-instruct相比,GPT-4取得了更高的PCC。这可能归因于GPT-4训练期间的人类反馈,因为个体可能更能意识到季节性和趋势数据。有趣的是,与原始测试序列相比,GPT-4生成的输出的QS(质量分数)有所增加。这表明GPT-4倾向于预测具有高季节性强度的时间序列,这可能为进一步的研究提供洞察。在多周期时间序列的背景下,随着周期数的增加,模型性能下降。这表明LLMs可能难以识别此类数据集中固有的多个周期,这在现实中很常见。

在这里插入图片描述

图片

2. 为了探索LLMs在具有较高趋势或季节性强度的数据集上预测良好的现象,我们设计了实验来验证这一现象。我们设计提示,让LLMs在每次序列预测后输出预测值。 实验的目标模型是GPT-3.5-Turbo,我们的提示的主要作用是进行incontext learning并要求输出周期。我们选择了八个时间序列数据集,如AirPassengersDataset,经过十次预测后统计周期值,并将这十个结果的中位数与真实周期进行比较。结果显示在表3中。根据结果,我们发现大型语言模型在一定程度上可以确定数据集的周期性。尽管每次时间序列预测的波动较大,但在AirPassenger、Sunspots和Wooly数据集上的预测相对准确,其他数据集上的预测值也接近我们的真实周期值。我们推测LLMs能够很好地预测具有高趋势或季节性强度的数据集,因为它们已经掌握了一些关于场景和数据集内容的知识。
图片

3. 为了提高大型语言模型(LLMs)在时间序列预测方面的性能和稳定性,我们引入了一种新方法。这部分的核心思想是利用大型语言模型预训练获得的知识来帮助预测。 我们将在提示中提供有关当前数据集的一些基本信息,如数据集的名称,这一过程不涉及数据泄露(不会告诉大型语言模型关于周期或预测值等信息)。

主要发现 在外部知识增强方面,GPT-4通常在MSE、MAE和MAPE上表现优于GPT-3.5,尤其是在AirPassengers、AusBeer等数据集上。Llama-2在某些数据集(例如Wooly、ETTh1、ETTm2)上的MSE和MAE指标上显著优于GPT-3.5和GPT-4,表明它能更准确地捕捉数据特征。R平方值在某些数据集上如ETTh1、ETTm2和Turkey Power展示,所有模型都能提供相对准确的预测,R平方值接近1。

在这里插入图片描述

图片

在这里插入图片描述

图片

Illustration From IconScout By Delesign Graphics

如何学习大模型 AI ?

由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。

但是具体到个人,只能说是:

“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。

这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。

我在一线互联网企业工作十余年里,指导过不少同行后辈。帮助很多人得到了学习和成长。

我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在人工智能学习中的很多困惑,所以在工作繁忙的情况下还是坚持各种整理和分享。但苦于知识传播途径有限,很多互联网行业朋友无法获得正确的资料得到学习提升,故此将并将重要的AI大模型资料包括AI大模型入门学习思维导图、精品AI大模型学习书籍手册、视频教程、实战学习等录播视频免费分享出来。

在这里插入图片描述

第一阶段(10天):初阶应用

该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

  • 大模型 AI 能干什么?
  • 大模型是怎样获得「智能」的?
  • 用好 AI 的核心心法
  • 大模型应用业务架构
  • 大模型应用技术架构
  • 代码示例:向 GPT-3.5 灌入新知识
  • 提示工程的意义和核心思想
  • Prompt 典型构成
  • 指令调优方法论
  • 思维链和思维树
  • Prompt 攻击和防范
  • …

第二阶段(30天):高阶应用

该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。

  • 为什么要做 RAG
  • 搭建一个简单的 ChatPDF
  • 检索的基础概念
  • 什么是向量表示(Embeddings)
  • 向量数据库与向量检索
  • 基于向量检索的 RAG
  • 搭建 RAG 系统的扩展知识
  • 混合检索与 RAG-Fusion 简介
  • 向量模型本地部署
  • …

第三阶段(30天):模型训练

恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。

到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?

  • 为什么要做 RAG
  • 什么是模型
  • 什么是模型训练
  • 求解器 & 损失函数简介
  • 小实验2:手写一个简单的神经网络并训练它
  • 什么是训练/预训练/微调/轻量化微调
  • Transformer结构简介
  • 轻量化微调
  • 实验数据集的构建
  • …

第四阶段(20天):商业闭环

对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。

  • 硬件选型
  • 带你了解全球大模型
  • 使用国产大模型服务
  • 搭建 OpenAI 代理
  • 热身:基于阿里云 PAI 部署 Stable Diffusion
  • 在本地计算机运行大模型
  • 大模型的私有化部署
  • 基于 vLLM 部署大模型
  • 案例:如何优雅地在阿里云私有部署开源大模型
  • 部署一套开源 LLM 项目
  • 内容安全
  • 互联网信息服务算法备案
  • …

学习是一个过程,只要学习就会有挑战。天道酬勤,你越努力,就会成为越优秀的自己。

如果你能在15天内完成所有的任务,那你堪称天才。然而,如果你能完成 60-70% 的内容,你就已经开始具备成为一名大模型 AI 的正确特征了。

这份完整版的大模型 AI 学习资料已经上传优快云,朋友们如果需要可以微信扫描下方优快云官方认证二维码免费领取【保证100%免费】
【史上最全面esp32教程】网络篇和tcp/ip的使用 ESP32史上最全面wifi和tcp/ip连接及示例程序 阅读详情

相关推荐

从5V降到3.3V,你的LDO到底有多烫?手把手算功耗、选散热,避开这些坑

本文详细解析了LDO在5V转3.3V电路中的发热问题,提供了精确的功耗计算公式和散热设计方法。通过对比不同封装的热阻参数和优化PCB布局,帮助工程师有效降低LDO温度,避免热保护触发。文章还探讨了替代方案的技术拐点,为电源系统优化设计提供实用指导。

weixin_30304375的博客 436

时序基础模型综述:用大型语言模型泛化时序表示 A Survey of Time Series Foundation Models: Generalizing Time Series Represent

论文名称:A Survey of Time Series Foundation Models: Generalizing Time Series Representation with Large Language Model论文地址:https://arxiv.org/pdf/2405.02358时序数据在各个领域中无处不在,因此时序分析具有至关重要的意义。传统的时序模型是任务特定的,具有单一功能和有限的泛化能力。

数智笔记 1135

超详细YOLOv8目标检测全程概述:环境、训练、验证与预测详解

这篇博文提供了一个关于使用YOLOv8进行目标检测的全面指南,包括环境搭建、模型训练、验证和预测的详细步骤,以及如何解释训练过程中生成的各种图表和数据。整篇文章为读者提供了一个关于如何利用YOLOv8进行目标检测的实践指南,从环境搭建到模型部署,再到结果分析,每一部分都给出了详细的步骤和解释。此外,还有对于模型输出的解释,帮助读者更好地理解和使用YOLOv8模型。

CDBmax的博客 10万+

时间序列卷到大模型了!最新10种前沿方法汇总

当前人工智能领域一个极具潜力和创新性的研究方向,它融合了两者的优势,能够在处理多种类型时间序列数据的同时,适应数据的变化和异常情况,显著提高预测的准确性和稳定性。想发顶会的同学们抓紧啦!本文提出了一种名为FedTime的联邦学习框架,专门用于长期时间序列预测。该框架通过在边缘设备上使用本地数据训练大型语言模型(LLM),并采用K-means聚类、通道独立性和补丁技术来优化模型训练,从而在确保数据隐私的同时提高预测精度和通信效率。

weixin_72959097的博客 1931

Podman修改镜像源教程(附最新docker镜像源)

Podman修改镜像源教程(附最新docker镜像源)

道长的博客 4141

STM32F103C8T6心电采集实战:从PCB设计到上位机开发的完整指南(附TI杯开源资料)

本文详细介绍了基于STM32F103C8T6的心电采集系统开发全流程,从PCB设计到上位机开发,特别适合大学生电子设计大赛参赛者参考。内容涵盖硬件设计精要、软件算法优化及上位机开发技巧,并附TI杯开源资料,帮助开发者低成本实现医疗级心电信号采集。

kafka6courier的博客 194

2024 年 8 个顶级开源 LLM(大语言模型)

选择开源 LLM 的公司将可以访问 LLM 的工作原理,包括它们的源代码、架构、训练数据以及训练和推理机制。这种透明度是审查的第一步,也是定制的第一步。由于每个人都可以访问开源 LLM,包括它们的源代码,因此使用它们的公司可以针对其特定用例对其进行自定义。

一览无遗 5万+

复现YOLOv8语义分割和目标检测训练自己的数据集

训练过程首先会显示你所使用的训练的硬件设备信息,然后下一段话则是你的参数配置,紧接着是backbone信息,最后是加载信息,并告知你训练的结果会保存在runs\segment\trainxx。(1)修改数据加载配置文件,在E:\project\MODEL\YOLO\yolov8-8.2.76\ultralytics-8.2.76\ultralytics\cfg\datasets。三、训练自己的数据集,segment数据集是json格式的。如果想使用多卡训练,device='\0,1,2,xxx\'

m0_56182552的博客 2764

多序列比对要多久时间_多周期的时间序列建模

论文题目:Multi-period Time Series Modeling with Sparsity via Bayesian Variational Inference(由于论文放在 arXiv 上有多个版本,每个版本的论文标题不一样,在 google scholar 中需要搜索“Time series forecasting based on augmented long short-te...

weixin_34632251的博客 463

概念解析 | 事件相机的原理 (含仿真代码)

在我们熟悉的世界里,传统相机就像一个勤勉的绘画师,每隔固定的时间就为我们勾勒出一幅完整的画面。但是,大自然中有太多瞬息万变的精彩场景,这种"定时绘画"的方式往往难以捕捉。于是,一种全新的"观察者"应运而生 -事件相机(Event Camera)。事件相机,就像是一群极其敏感的"像素哨兵",它们不再按部就班地等待指令,而是主动感知周围的变化,只有在光线强度发生显著变化时才会发出信号。这种革命性的设计,让事件相机拥有了传统相机难以企及的优势:超高的时间分辨率、极低的延迟、宽广的动态范围,以及出色的能效比。

NLOS的博客 1422

第五章 TTM 后备管理:5.6系统内存域

系统内存域由 TTM 内置资源管理器管理,通过 ttm_tt 承载页信息,依赖 ttm_pool 提供物理页。ttm_tt 管理页数组、缓存属性与状态标志,支持外部页与换出机制。初始化分 ttm_tt_init 与 ttm_sg_tt_init,生命周期包括创建、填充、释放与销毁。页池针对 write-combined、uncached 及一致性 DMA 分配的页进行缓存,提升性能并减少 TLB 刷新。分配时高阶优先、批量设置缓存属性,回收时清零后归还池中,确保高效复用。

图形/计算GPU的驱动与虚拟化技术分享园地 2568

ICLR 2025 | LLMS能理解时间序列异常吗?

在本文中,我们对大型语言模型(LLMs)对时间序列数据的理解及其异常检测能力进行了全面调查。我们的研究结果对当前文献中普遍存在的若干假设提出了挑战,强调了对有关 LLM 行为假设进行严格实证验证的必要性。我们的主要发现包括 LLM 的视觉优势、有限的推理能力、非人类般的处理方式以及模型特定的能力。这些见解对未来 LLM 的设计以及异常检测系统的开发具有重要意义。例如,我们的结果表明 LLM 无法有效检测视觉频率异常,因此基于视觉-LLM 的异常检测系统在将数据输入 LLM 之前应利用傅里叶分析来提高性能。

2501_91070801的博客 1044

C#与欧姆龙PLC 通信——fins udp协议

该调试助手专门为了帮助大家学习以及测试Fins-Udp通信,下面进行详细介绍。

qq_34059233的博客 2874

大语言模型对时间序列预测真的有用吗?

这项研究表明,最好还是让传统的时间序列预测方法继续使用它们习惯的方式,而不是尝试使用大型语言模型来处理时间序列任务。但是这并不意味着不做任何事情;在时间序列和大型语言模型的交叉领域,还有一些新的、可能值得探索的有趣方向。作者:Reza Yazdanfar。

deephub 5138

Devexpress16.2.6破解工具

Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具Devexpress16.2.6破解工具

大中型超市收银系统(可直接运行)

光步前台收银系统系统功能:商品销售、商品退货、挂单、收银员权限、会员销售、单品取消、整单取消、商品查询、脱机销售、脱机数据上传,基本资料下载,开钱箱、小票打印、收款结算,支持多币种付款方式(现金、储值卡、礼券、微信等),支持多种促销。运行环境:.net 4.0登陆信息用户名:1001 密码:123456内置商品信息,商品编码可输入00001000 - 00010000,测试效果相关功能键F5 结算 F9挂单 F11商品查询 F8退货 Insert单品取消 Del整单取消 F12开钱箱F2 会员 Ctrl+Z退出系统 Home 锁屏 相关源码待公开

ChatGPT能预测时间序列?基于大模型的时间序列预测中的迭代事件推理

这主要是因为大量不相关的新闻会引入过多的标记,增加了LLM的处理负担,且可能引入噪声和错误的因果信息,导致误导性的预测。这种方法将庞大的新闻数据集浓缩为精炼的相关文章。我们的方法在依赖新闻所体现的事件对预测有重大影响的领域(如电力需求、汇率和比特币市场)中,显著优于仅依赖历史时间序列数据的传统方法。该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

m0_59235945的博客 1421

精雕软件(JDpaint) 5.5 绿色版

精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版精雕软件(JDpaint) 5.5 绿色版

Coggle数据科学 | ICLR 2025:LLMs能否理解时间序列异常?

大型语言模型(LLMs)在时间序列预测领域已经受到广泛关注,但它们在异常检测方面的潜力尚未得到充分探索。本研究旨在调查LLMs是否能够理解和检测时间序列数据中的异常,重点关注零样本(zero-shot)和少样本(few-shot)场景。

csdn_xmj的博客 1455

jdk-8u144-linux-x64.tar.gz.

该资源为搭建Linux系统Java环境用,资源的后缀为tar.gz格式的压缩包

AI论文速读 | 立场观点:利用多模态大模型增强时间序列推理能力

理解时间序列数据对于多种实际应用至关重要。虽然大型语言模型 (LLM) 在时间序列任务中大有可为,但当前的方法通常仅依赖数值数据,而忽略了时间相关信息(例如文本描述、视觉数据和音频信号)的多模态性质。此外,这些方法未充分利用 LLM 的推理能力,将分析限制在表面层面的解释,而不是更深层次的时间和多模态推理。在这篇立场观点论文中,作者们认为多模态 LLM (MLLM) 可以为时间序列分析提供更强大、更灵活的推理,从而增强决策和实际应用。

suzukiwudi的博客 1527

ChatGPT能预测时间序列?基于大模型的时间序列预测中的迭代事件推理_chatgpt能预测时间序列

这主要是因为大量不相关的新闻会引入过多的标记,增加了LLM的处理负担,且可能引入噪声和错误的因果信息,导致误导性的预测。这种方法将庞大的新闻数据集浓缩为精炼的相关文章。我们的方法在依赖新闻所体现的事件对预测有重大影响的领域(如电力需求、汇率和比特币市场)中,显著优于仅依赖历史时间序列数据的传统方法。该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。

HUANGXIN9898的博客 1296

大模型在时间序列预测领域的最新15篇论文

大模型可以处理不同类型的时间序列数据,例如文本、图像、音频等,也可以适应不同的时间序列数据的变化和异常情况,有助于提高时间序列预测的准确性和稳定性。另外,大模型还可以通过文本形式提供解释性的时间序列预测结果,从而帮助我们更好地理解时间序列数据的模式和趋势。为了方便想发论文的同学,我今天就来分享该领域的,这些文章主要涉及论文原文及模型代码都整理好了,需要的同学看文末。

学姐带你玩AI的博客 5932

Time-LLM :超越了现有时间序列预测模型的学习器

Time-LLM 被展示为一个强大的时间序列学习器,其性能超越了现有的、专门的预测模型。输入补丁化:首先,将输入的时间序列数据分割成一系列“补丁”(patches),这些补丁是通过在时间序列上滑动窗口来创建的,每个补丁包含了一定数量的时间步长。实验与优化:在实践中,可能需要进行多次实验,调整模型参数,如补丁长度、步长、模型层数等,以及优化提示前缀的设计,来提高预测的准确性。解决方案:进行多次实验,调整模型参数,如补丁长度、步长、模型层数等,以及优化提示前缀的设计来提高预测的准确性。

2282

TimeReasoner:让大模型慢慢“思考”—时间序列预测的新范式

在**时间序列预测 (Time Series Forecasting, TSF)** 这一重要领域,传统方法往往侧重于模式提取和直接数值映射,而可能忽略了对时序动态和上下文依赖的显式推理过程。近期,中国科学技术大学的研究团队通过一项名为 **TimeReasoner** 的广泛实证研究,探索了新兴的“慢思考”大语言模型(LLMs)在时间序列预测任务中的推理能力,尤其是在零样本(zero-shot)场景下的潜力。这项研究为理解和利用LLMs进行结构化时序推理开辟了新视角。

m0_59235699的博客 1005

AI论文速读 | 立场观点:时间序列分析,大模型能告诉我们什么?

时间序列分析对于理解各种现实世界系统和应用程序固有的复杂性至关重要。尽管大型语言模型(LLM)最近取得了重大进展,但配备时间序列分析功能的通用人工智能(AGI)的发展仍处于起步阶段。大多数现有时间序列模型严重依赖领域知识和广泛的模型调整,主要关注预测任务。本文认为当前的LLM有可能彻底改变时间序列分析,从而促进高效的决策并朝着更通用的时间序列分析智能形式迈进。这种进步可以释放广泛的可能性,包括模态转换和时间序列问答。

suzukiwudi的博客 1429

COLING 2024 | AlphaFin:基于LLM的股票预测大模型,显著提高预测能力

在这项工作中,研究者正式定义了财务分析的任务,并提出用 AlphaFin 数据集来增强大型语言模型(LLMs)的能力,并在其基础上对 StockGPT 进行了微调。研究者在提出的 AlphaFin 数据集上进行了广泛的实验,以及一些补充实验,如消融研究、GPT4 与人类偏好评估以及案例研究,以揭示 Stock-Chain 在所有基线方法中的卓越表现,并展示了其在财务分析任务中的有效性。然而,ML&DL 算法的性能有限,只能提供不确定的结果,并且无法处理复杂的文本数据。部分,即股票趋势预测和相应的金融问答。

AI生成式技术曾小健 5119
上一篇: 阿里音频生成大模型一次发俩还开源!50种语言快速理解+5种语言语音生成,带情感的那种
下一篇: RAG系统中答案无关的片段对LLMs生成结果有何影响?
普通网友
博客等级 码龄3年 4493粉丝 309原创
评论
成就一亿技术人!
拼手气红包6.0元
还能输入1000个字符
 
 条评论被折叠 查看
添加红包

请填写红包祝福语或标题

个

红包个数最小为10个

元

红包金额最低5元

当前余额3.43元 前往充值 >
需支付:10.00元
成就一亿技术人!
领取后你会自动成为博主和红包主的粉丝 规则
hope_wisdom
发出的红包
实付元
使用余额支付
点击重新获取
扫码支付
钱包余额 0

抵扣说明:

1.余额是钱包充值的虚拟货币,按照1:1的比例进行支付金额的抵扣。
2.余额无法直接购买下载,可以购买VIP、付费专栏及课程。

余额充值